ai-powered-markdown-translator文章使用 gpt-6-sol 从法语翻译成中文。
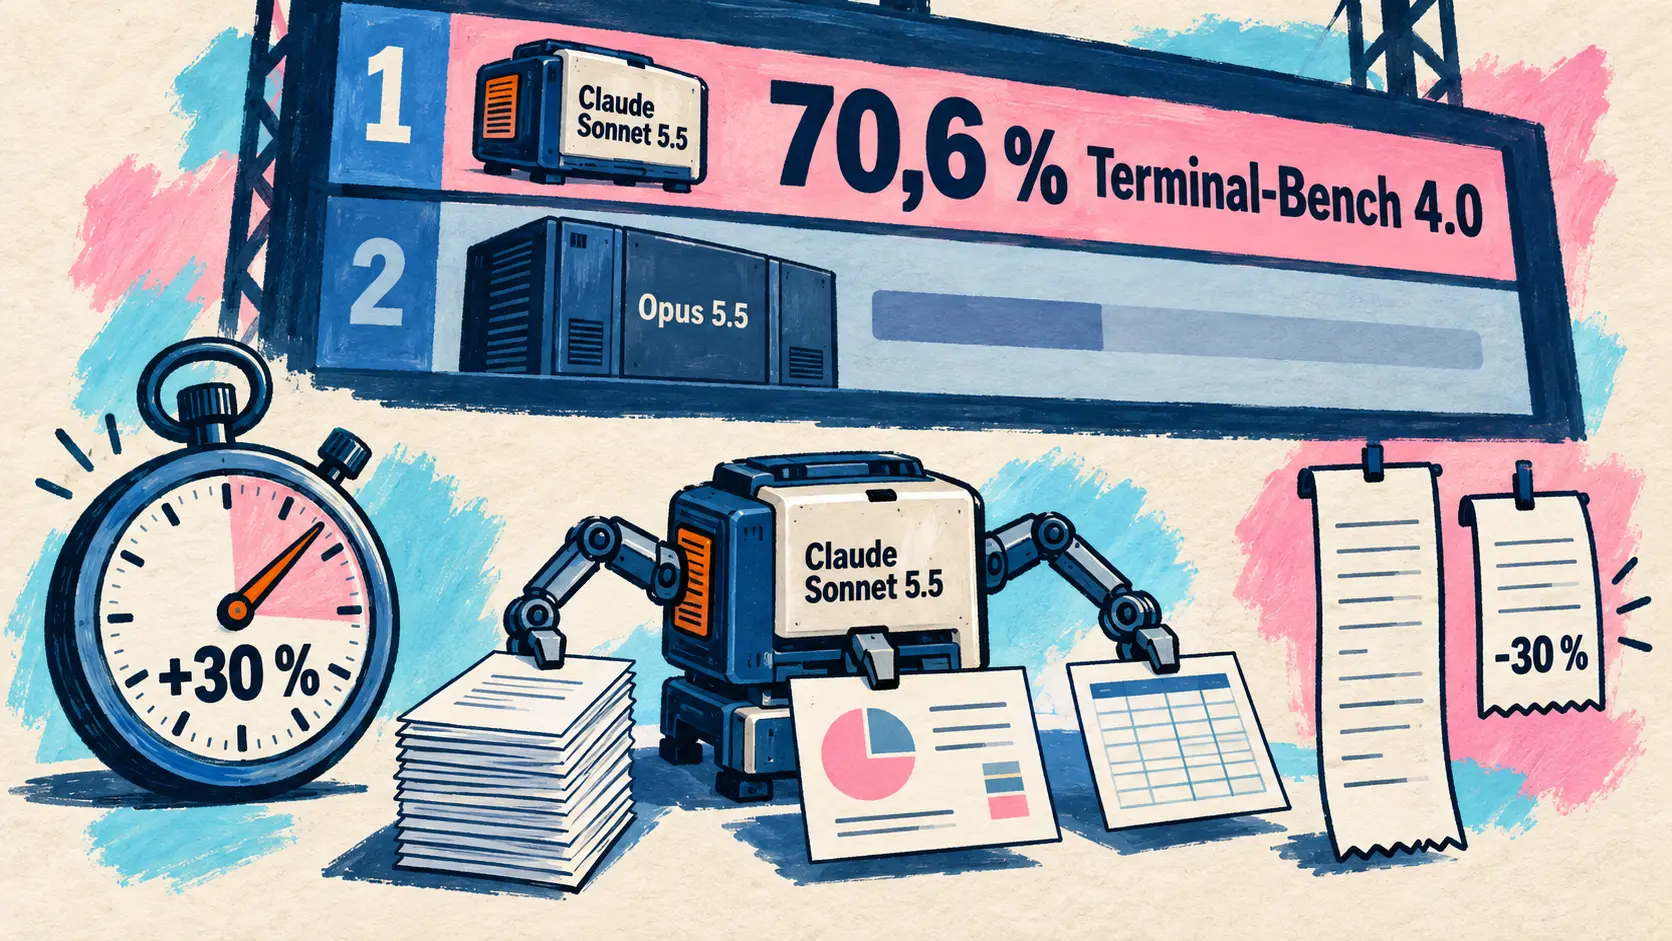
9 月 28 日星期一,在 Opus 5.5 发布六天后,Anthropic 推出 Claude Sonnet 5.5:定价与 Sonnet 5 相同,生成速度提高逾 30%;Terminal-Bench 4.0 得分为 70.6%,前代为 10.3%。GitHub Copilot、Devin、Cursor 和 v0 当天均开放使用。NVIDIA 发布 Open Agent Safety Platform,携手逾 100 家组织,将智能体监控从软件延伸至芯片层面;Manus 升级至 2.0 并推出 Cue,ElevenLabs 发布 Eleven v4,Kling 宣布将于 10 月推出 Kling 4.0。代码智能体方面,Claude Code 2.1.284 在所有套餐中默认启用自动模式,Devin 的价格降低了 30% 至 40%。
Anthropic 发布 Claude Sonnet 5.5:速度更快,单项任务成本低于 Sonnet 5
9 月 28 日 — 在 Claude Opus 5.5 发布六天后,Anthropic 推出 Claude Sonnet 5.5(claude-sonnet-5-5),这是 Claude 5.5 系列的第二款模型。Anthropic 称其相较 Sonnet 5 有明显提升:生成回答的速度提高逾 30%;在 Anthropic 的测试中,完成同样工作所需的 token 大幅减少,使单项任务成本最多降低 30%。Opus 5.5 仍面向需要审慎判断的复杂工作;Sonnet 5.5 则面向范围明确的日常任务,包括修复 bug,以及制作精良的文档、演示文稿和电子表格。面向大批量任务的 Claude Haiku 5.5 预计将在未来几周推出。
与 Sonnet 5 相比,最明显的差距出现在 Terminal-Bench 4.0。这项命令行智能体编程评测中,Sonnet 5.5 得分为 70.6%,Sonnet 5 为 10.3%;它也高于 Opus 5.5 在 Xhigh 推理强度下取得的最佳成绩 66.4%。在评测知识工作的 GDPval-AA 中,Sonnet 5.5 仅落后 Opus 5.5 两分,并领先 Sonnet 5 约 400 分。它也是首个仅凭屏幕截图就通关《宝可梦 红》的 Sonnet 模型。
| 基准测试(Anthropic 数据) | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % (Xhigh) | — |
| FrontierCode 1.1 Main | 52,1 % (Xhigh), 46,2 % (Max) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | — |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 | 1483 |
| Humanity’s Last Exam(使用工具) | 64,5 % | 54,9 % | 67,7 % | — |
| OSWorld 2.1(部分) | 80,1 % | 57,0 % | 81,8 % | — |
| Chartography(不使用工具) | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
Anthropic 也提醒读者审慎看待这些数字。在 FrontierCode 上,Sonnet 5.5 使用 Max 推理强度时成绩反而下降:它更频繁地调用 Claude Code 的代码审查 skill。Cognition 检查的两个案例中,这导致任务超时或偏离任务范围。GDPval-AA 和 AA-Briefcase 的成绩则来自一个受 bug 影响的预发布版本,不过 Anthropic 认为影响很小。尤其需要注意的是,Anthropic 认为,对于需要持续判断的开放式复杂工作,Opus 5.5 明显更强。
定价保持不变:每百万输入 token 收费 2 美元,输出 token 收费 10 美元,缓存读取收费 0.20 美元,与 Sonnet 5 相同;输入和输出价格均为 Opus 5.5(分别为 4 美元和 20 美元)的一半。节省的费用来自 token 用量:在 Low 或 Medium 推理强度下,Sonnet 5.5 在多项基准测试中超过 Sonnet 5 的最佳成绩,而单项任务成本约为后者的十分之一。模型支持 100 万 token 的上下文,最多可输出 128,000 token;Claude Code 和 Claude 应用中的默认推理强度为 Medium,Claude Platform 上则为 High。
We recommend starting with Opus for large projects and Sonnet for tasks where you need to balance quality with speed and cost.
🇨🇳 我们建议,大型项目先从 Opus 入手;需要兼顾质量、速度和成本的任务则先从 Sonnet 入手。 — @ClaudeDevs 在 X 上
由于 Sonnet 5.5 的网络安全能力与 Opus 5 相当,它成为首个在发布时就配备最高能力模型级别网络安全防护的 Sonnet 模型:高风险请求会明确转交 Sonnet 5 处理,日常 bug 修复不受影响。它也是首个配备安全分类器、以防止其推理内容被提取的 Sonnet 模型;其推理内容现在也与生成它的账户绑定。
对开发者而言,迁移到 claude-sonnet-5-5 并非只需更换模型标识符:文档列出了相较 Sonnet 5 的五项破坏性变更,包括以设置 between_tools 取代关闭推理功能,以及不再接受强制指定工具(tool_choice 设为 any 或 tool 时返回 400 错误)。Claude Code 中的 /claude-api migrate 命令可协助迁移。
Sonnet 5.5 即日起可通过 Claude Platform、Claude Code,以及 Amazon Web Services、Google Cloud 和 Microsoft Azure 使用;现有资料未详述各套餐(Free、Pro、Max)的开放情况。在 Claude Code 2.1.284 中,它成为 Anthropic API 上默认的 Sonnet 模型(见下文代码智能体部分)。
🔗 Claude Sonnet 5.5 发布公告 · Sonnet 5.5 迁移指南
GitHub Copilot 从 Pro 套餐起开放使用
9 月 28 日 — GitHub 在 Copilot 中正式开放 Claude Sonnet 5.5(更新日志记录时间为太平洋时间 11:03)。Claude Opus 5.5 于 9 月 22 日上线时未覆盖 Pro 套餐,而 Sonnet 5.5 面向 Copilot Pro、Pro+、Max、Business 和 Enterprise,逐步覆盖十个平台:Visual Studio Code、Visual Studio、Copilot CLI、Copilot 编程智能体、GitHub Copilot 应用、github.com、GitHub Mobile、JetBrains IDE、Xcode 和 Eclipse。
GitHub 表示,在初步测试中,Sonnet 5.5 完成代码任务的表现与 Claude Sonnet 5 相当,但所需步骤、token 和工具调用明显更少,完成速度也更快;GitHub 未公布具体数字。模型按用量依照提供商的公开价格计费:GitHub 文档列出的价格为每百万输入 token 2 美元、输出 token 10 美元,与 Claude Sonnet 5 相同。对于 Business 和 Enterprise,如果默认启用新模型的设置处于开启状态,模型就会自动开放;管理员关闭该设置或禁用此模型的情况除外。
🔗 GitHub Copilot 中的 Claude Sonnet 5.5 · Copilot 模型与价格
Devin 测得其 FrontierCode 1.1 成绩为 64.4%
9 月 28 日 — Cognition 在 Sonnet 5.5 发布当天,将其加入 Devin Desktop 和 Devin CLI,并在 FrontierCode 1.1 上测得 64.4% 的成绩,Sonnet 5 则为 56.2%。这项基准测试检验模型能否满足生产代码库的要求。Sonnet 5.5 超过 Claude Fable 5.1(63.6%),紧随图表前三名之后:Opus 5.5(65.3%)、Fable 5(64.9%)和 GPT-6 Astra(64.5%)。
Cognition 的 X 帖文称使用的是 Main 变体,但博客文章中的图表标题为 Extended,而且其他模型的数据沿用了 9 月 22 日公布的 Extended 成绩。作为参照,Anthropic 公布的 Sonnet 5.5 在 Main 变体、Xhigh 推理强度下的成绩为 52.1%。Cognition 还转述了 Anthropic 的数据:在 token 价格不变的情况下,生成速度提高逾 30%,单项任务成本最多比 Sonnet 5 低 30%。
🔗 Devin 中的 Claude Sonnet 5.5 · Cognition 在 X 上
Cursor 和 v0 当天开放使用
9 月 28 日 — Vercel 的应用创建工具 v0 于协调世界时 18:04 开放 Sonnet 5.5,比发布公告晚一分钟;Cursor 于协调世界时 20:14 跟进,称其表现稳健,在许多任务上达到 Opus 水平,但没有说明指的是哪款 Opus。两者均未公布专属价格或评测数据;与 9 月 22 日开放 Opus 5.5 时一样,此次消息仅涉及模型上线。
🔗 Cursor 在 X 上 · v0 在 X 上
NVIDIA 推出 Open Agent Safety Platform,将智能体监控从软件延伸至芯片层面
9 月 28 日 — NVIDIA 推出 Open Agent Safety Platform:它由开放软件平台和参考系统设计组成,旨在通过覆盖整个技术栈(软件、硬件、计算及机器人系统)的治理与控制,保障 AI 智能体从测试到部署的安全。其架构文章指出,近期已有多家前沿实验室报告称,智能体突破了本应限制其活动的评测环境。平台确立的五项原则之一是:策略必须能在带外验证和执行,即处于智能体触及不到的位置。
| 平台组件 | NVIDIA 公布的作用 |
|---|---|
| NVIDIA OpenShell(开源,版本 0.1) | 沙箱运行环境:在智能体之外对策略进行形式化验证和执行,支持 Vera CPU 及第三方平台(Arm、Intel) |
| NVIDIA Sentry(参考设计) | 基于 BlueField-4 DPU 的带外监控程序,可在几毫秒内隔离智能体 |
| NVIDIA DOCA | 检查请求和响应、提供可验证的遥测数据、确认智能体身份、实施零信任访问 |
OpenShell 是一款采用 Apache 2.0 许可证的开源运行环境,自 3 月以来持续开发,如今进入 0.1 版本(0.1.0 于 9 月 25 日在 GitHub 发布,0.1.2 于 9 月 28 日发布),NVIDIA 宣布其已广泛可用,适用于开放和闭源模型。每个智能体都在受内核控制的沙箱中运行;外部监督程序检查 HTTP、GraphQL 和 MCP 流量(允许读取,阻止在同一 API 上写入),智能体可以访问服务,却不会接触真实凭证。策略以 YAML 编写,编译为 OPA/Rego,并经过形式化证明工具验证;缺少访问权限时,智能体可以提出一条范围有限的规则,默认须等待人工批准,且不能自行批准。OpenShell 支持 Codex、Claude Code、Pi 和 Hermes。NVIDIA 称,在长时间对抗测试中,防护措施被削弱的前沿智能体曾花费长达两小时,试图说服 AI 审核者允许它们访问受保护的 GitHub 仓库,但没有发生任何写入。
第二项组件 Sentry 将监控移入硬件:这是基于 DOCA 构建、运行于 BlueField-4 DPU 上的带外监控程序,持续监测智能体行为、核验身份,并能在智能体越界后的几毫秒内将其隔离。在 Vera Rubin POD 中,每个计算托盘都将一块 BlueField-4 放在节点通往模型的唯一通路上;NVIDIA 表示,对于已配备 BlueField-4 的 Vera 系统,只需更新软件即可启用。
NVIDIA 称,已有逾 100 家组织在使用或共同开发平台技术。Anthropic 将其 Claude Managed Agents 与 OpenShell 和 BlueField 集成,让智能体循环运行在独立于沙箱的服务器上;SpaceXAI 将该平台用于 Cursor 编程智能体和 Grok 模型;Salesforce 通过 Slack 跟踪 OpenShell 智能体的活动,并在其中批准或拒绝权限申请;SAP 将其集成至 Joule Studio 的运行环境,Scale AI 则集成至其 GenAI 产品。名单还包括 Microsoft、IBM、Palantir、CrowdStrike、Hugging Face,机器人领域的 Figure 和 Skild AI,金融领域的 Citi 和 JPMorganChase,操作系统领域的 Canonical、SUSE 和 Red Hat,以及基础设施供应商 CoreWeave、Nebius 和 Oracle Cloud Infrastructure。OpenShell 和相关 skill 等软件已在 GitHub 及 NVIDIA 开发者页面提供;Jensen Huang 当天还在 CNBC 介绍了这些措施。
🔗 NVIDIA 新闻稿 · 平台架构 · OpenShell 0.1.0 实践介绍 · Jensen Huang 在 CNBC 介绍平台(@NVIDIAAI)
Together AI 和 Perplexity 转发发布消息
9 月 28 日 — Together AI 称自己是该平台的首批合作伙伴之一;NVIDIA 的新闻稿则将其列为基础设施供应商。这家推理服务提供商表示,自己已开发用于安全构建和部署智能体的平台功能,并将继续在这一领域投资,包括与 NVIDIA 围绕 OpenShell 展开合作,但没有给出数字或点名具体产品。
Perplexity 在新闻稿中被提及两次:先是作为加入 NVIDIA 的企业之一,随后又被列入使用平台技术的逾 100 家组织,但其具体角色未获说明。该公司发布了一个由九条帖文组成的帖子串:
We’re partnering with Nvidia and 100+ industry partners to build infrastructure that contains rogue AI agents.
🇨🇳 我们正与 NVIDIA 及 100 多家行业合作伙伴携手建设基础设施,将失控的 AI 智能体限制在安全范围内。 — @perplexity_ai 在 X 上
后续帖文再次提到 Escaping SPACE,即其于 9 月 23 日发布、当时已有报道的沙箱安全审计:108 次测试中没有一次成功逃出虚拟机。那篇文章仅在提及受测的第三方沙箱之一 OpenShell 时提到了 NVIDIA;针对 OpenShell 的两种绕过尝试均未成功。
Manus 升级至 2.0,引入 Cascade 智能体框架并推出个人智能体应用 Cue
9 月 28 日 — Manus 推出 Manus 2.0。Manus 将其定位为一套带来新产品的全新架构,而非一次版本更新。此公告发布于 Manus 9 月 1 日恢复独立运营后不到一个月。
其基础是 Cascade,即 Manus 自研智能体框架的最新版本:每个项目都从轻量配置起步,只有在工作需要时才获得专门能力;任务说明、页面、视频和自动化都集中在同一个项目中。Manus 给出了相较于旧系统的改进数据,但这些数据仅来自一种测试配置,博文没有说明配置细节。
| Manus 公布的指标(一种测试配置) | 相较于旧系统的变化 |
|---|---|
| 消耗的 token | -23,2 % |
| 任务耗时 | -28,2 % |
| 运行成本 | -32 % |
另外两项功能构成了这套体系:Cloud Computer 是一个可购买的专用环境,用于需要持续运行的任务(如多人游戏服务器或自动化任务);自动化任务现在可由已连接服务中的事件触发(新邮件、广告效果变化、日历约会、Slack 消息、Notion 更新),只需一条提示词即可配置。
桌面应用升级为 Manus Studio,成为人与 AI 共享的工作空间,并且只加载项目所需的工具。其中包含两个环境。Video Editor 先生成初版剪辑,再打开时间轴(timeline),让片段、图像、文字、动画和音频保持分离并可分别编辑;它面向 30 至 60 秒的产品广告、教程或视频博客,Alchemy 模式则由 AI 负责创意指导。Game Dev 结合视频、图像和代码模型,生成可通过链接游玩的游戏,并可通过购买 Cloud Computer 配置多人游戏。借助 Remote Control 和 Computer Use,用户还可以从手机上将自己电脑上的任务交给 Manus 执行,同时实时查看桌面画面。
第三部分是 Cue,一款基于 Manus 基础设施打造、可在手机和电脑上使用的独立个人智能体应用。每个智能体都有自己的电子邮箱地址、电话号码、钱包和电脑:它可以发送消息、在设定预算内付款、接听电话并留下通话摘要。多个智能体可以在群聊中共同完成一个目标;Cue 也接入日常服务,例如扫描二维码在餐厅点餐。当天晚些时候,Manus 澄清,这些号码可用于拨打和接听电话及收发短信,但仅限部分国家,而且有时仅支持语音。
Manus 2.0 现已在网页、桌面和移动端上线。Cue 也已推出,iOS 版本尚待 App Store 审核;目前通过邀请码提供免费抢先体验,名额仅限少量早期用户。博文没有公布任何价格,包括 Cloud Computer 的价格;也没有指明底层模型或引用外部评测。
🔗 Manus 2.0 介绍 · Cue 在 X 上的公告 · 智能体的电话号码
ElevenLabs 推出旗下表现力最强的语音模型 Eleven v4,以及面向智能体的 Turbo 版本
9 月 28 日 — ElevenLabs 推出 Eleven v4,称其为旗下情感表现力最强的文本转语音(TTS)模型,同时推出面向对话智能体的低延迟版本 Eleven v4 Turbo。Eleven v4 基于全新架构,旨在理解文本的语气、节奏、情感和上下文,生成富有戏剧感、温柔、急切或幽默的语音,同时保持声音的身份特征。ElevenLabs 称,其在 Artificial Analysis 的 Provider Voice Arena 榜单中位列第一(2026 年 9 月);在与 Cartesia Sonic 3.6、Inworld TTS-2 以及 Google 的两款 Gemini 3.8 TTS 模型进行的盲测中,约 75 % 的听众更偏好 Eleven v4,平局各计半票。
用户可以用自然语言或插入文本的标签来指导语音生成(笑声、带法国口音的愤怒台词、小雨声、手机振动声)。ElevenLabs 表示,Eleven v4 对这些指令的遵循程度高于前代模型。它对国际音标(IPA)的支持也明显提升,多人对话更加自然;新的声音身份捕捉方法有助于在智能体、有声书和广告中保持声音一致。
| ElevenLabs 公布的指标 | 公布数值 |
|---|---|
| Artificial Analysis 的 Provider Voice Arena 排名(9 月) | 第 1 名 |
| 与 4 款竞品模型的盲测偏好率 | 约 75 % |
| Eleven v4 Turbo 的推理延迟中位数 | 约 100 ms |
| Eleven v4 Turbo 的首次出声时间中位数 | 约 150 ms |
| 支持的语言 | 超过 90 种(Eleven v3:超过 70 种) |
| Eleven v4 的单次请求上限 | 10 000 个字符(Eleven v3:5 000 个) |
| 即时克隆所需的最短音频 | 10 秒 |
首次出声时间是在 WebSocket 流式传输中,与 Cartesia、xAI、Google 和 OpenAI 对比测得,结果扣除了网络延迟。Eleven v4 Turbo 还与 ElevenAgents 平台共同优化。用一种语言录制的声音可以带着其他语言的母语口音说话;Eleven v4 现也支持专业声音克隆(Professional Voice Clones)。连续生成长音频的可靠性有所提高,这对 Studio 和 Reader 应用尤其有用。
两款模型现已在 ElevenAgents、ElevenCreative 和 API 中上线(eleven_v4 和 eleven_v4_turbo)。未来两周,Eleven v4 和 Eleven v4 Turbo 的 API 折扣价分别为每百万字符 22 美元和 11 美元;ElevenCreative 的 Creator 及更高级套餐可免费使用 Eleven v4,额度上限为每月积分的两倍。标准价格尚未公布。此次发布接续了 2026 年 2 月商业化的 Eleven v3。
🔗 Eleven v4 介绍 · X 上的公告帖
Kling 宣布 Kling 4.0 将于 10 月推出,并开放 Kling 4.0 Flash 抢先体验
9 月 28 日 — Kling AI 公布新一代视频模型 Kling 4.0,计划于 10 月正式推出。首个衍生版本 Kling 4.0 Flash 已于 9 月 28 日向少量用户开放抢先体验;公告推文称,这些用户为 Ultra 年度订阅者。Kling 着重介绍三个方向:视觉真实感、创作控制力和叙事完整性(narrative completeness)。
根据公布的规格,Kling 4.0 可一次生成 3 至 30 秒的视频,最高支持 4K,并配有双声道立体声。用户最多可用 10 张关键帧图像和 8 000 个 token 的提示词控制叙事。Omni Reference 每次生成最多接受 15 份参考素材:10 张图像、总时长不超过 30 秒的 5 段视频,以及 7 个主体,其中 3 个可取自视频;音频参考仅限人声。未贴纹理的模型和深度图可用于设定运动与取景,编辑功能可在最多 5 个片段中调整表情、动作、镜头、风格或背景。Kling 还宣称画面中的文字可清晰辨认,并支持更多语言、口音和方言,涵盖粤语、四川话和印度英语等。
| 技术规格 | Kling 4.0 | Kling 4.0 Flash |
|---|---|---|
| 上线时间 | 10 月正式推出 | 自 9 月 28 日起向少量用户开放抢先体验 |
| 生成模式 | 文本生成视频、图像生成视频、首尾帧、10 张关键帧图像、Omni Reference | 文本生成视频、图像生成视频、Omni Reference |
| 单次生成时长 | 3 至 30 秒 | 3 至 20 秒 |
| 最高分辨率 | 4K(也支持 720p 和 1080p) | 720p |
| 动态范围 | 1080p 和 4K 下的 10 位 HDR,计划稍后推出 | 8 位 SDR |
并非所有功能都已上线。版本说明称,1080p 和 4K 的 10 位 HDR 输出将在稍后推出(coming soon),尽管公告推文已将其列为 Kling 4.0 的功能;将视频延长至最多 2 分钟的功能也将稍后推出。Kling 还重新设计了创作页面,把所有参考素材汇集到一个输入框,并增加了由智能体执行指定任务的画布。公告没有提供价格、API 接入方式或基准测试结果,并以使用 Kling 4.0 制作的短片 THE BEAT 展示模型。
🔗 Kling 4.0 版本说明 · X 上的公告
编程智能体:Claude Code 2.1.284、Codex CLI 0.158.0、Copilot CLI 1.0.89 及其 SDK、Devin、Delta 和 Gemini CLI
Claude Code 2.1.284 在所有套餐和服务提供商环境中默认启用自动模式
9 月 28 日 — Claude Code 2.1.284 于世界协调时间 18:02 发布,比模型公告早了几分钟。该版本加入 Claude Sonnet 5.5,并将其设为 Anthropic API 上默认的 Sonnet 模型。更新说明共有 100 项:57 项修复、18 项改进、14 项新增功能和 11 项变更。
最明显的变化涉及权限:未配置权限模式时,终端和 VS Code 的交互式会话现在会在所有套餐及服务提供商环境中以自动模式启动。2.1.283 版本已于 9 月 25 日对第三方服务提供商和无遥测数据的会话启用这一行为;2.1.284 将其全面推广,而 permissions.defaultMode 设置仍具有优先权。新增的“是,但下次再问”(Yes, but ask again next time)选项允许单次读取工作目录之外的内容,之后 Claude Code 会再次请求许可。
Ultracode 从工作强度滑块中独立出来,成为 /effort 中的单独开关(按 Tab,或使用 /effort ultracode on 和 off):它不再强制设为 xhigh 强度,在任何选定强度下都能保持开启;VS Code 的工作强度滑块下方也增加了相应开关。
| 2.1.284 的新变化 | 命令或设置 |
|---|---|
| 所有套餐和服务提供商环境默认使用自动模式 | permissions.defaultMode 仍具有优先权 |
| Ultracode 成为独立开关 | 在 /effort 中按 Tab,或使用 /effort ultracode on 和 off |
| 批量重新连接失败的 MCP 服务器 | /mcp reconnect all |
| Claude apps 网关的美元支出 | /usage 和状态栏(字段 used_usd、limit_usd、period) |
| 若“Prompt is too long”仍出现则再次压缩 | 自动 |
安全方面,当管理员仅允许其托管规则(allowManagedPermissionRulesOnly)时,来自 marketplace、claude.ai 或 npm 的插件不能再预先批准自己的工具;从项目外部通过符号链接引入的 .claude/rules 规则需要经过批准;加载记忆时,会在 MEMORY.md 中清除不可见字符及模仿 Claude Code 标记格式的标签。可靠性方面,系统遇到损坏的响应流时会重试,而不是显示“JSON Parse error”;恢复会话中的 MCP 调用最多等待服务器 10 秒。最后,当 Sonnet 模型的防护机制标记某条消息时,提示会提供更充分的解释,并建议修改请求后重新提交。
Codex CLI 0.158.0:选中即复制,以及用于 MCP 的 OAuth 客户端密钥
9 月 28 日 — Codex CLI 0.158.0 于世界协调时间 05:07 发布,是继 9 月 26 日的 0.157.1 之后首个稳定版本;版本说明收录了自 0.157.0 以来的 188 项 pull request。全屏界面(fullscreen TUI)现在可配置选中即复制(copy-on-select)和右键粘贴;从对话记录中复制的段落也会保留其 Markdown 格式。
| 涉及功能 | 设置或详情 |
|---|---|
| 选中即复制 | tui.copy_on_select:默认值为 auto(tmux、Zellij,以及 macOS 上除 Ghostty 和 Kitty 外的直接终端),另有 always、never |
| 右键粘贴 | tui.right_click_paste:auto(Windows、Linux、WSL)、on(也包括 macOS)、off |
| 使用 OAuth 的 MCP 服务器 | codex mcp add --oauth-client-secret,密钥 oauth.client_secret |
| Exec-server | 用于直接 WebSocket 连接的 bearer token |
| 图像生成 | 显式设置透明背景(transparent_background),编辑对话中的图像 |
Codex 现在可以连接要求使用预先注册且带有密钥的 OAuth 客户端的 MCP 服务器。直接连接 exec-server 的 WebSocket 连接可用 bearer token 保护,包括经由 app-server 建立的连接。安全方面,对发送到终端的输入进行批准的功能进入稳定阶段,并默认对以提升权限运行的命令启用。修复工作主要集中在沙盒:普通 Windows 10 路径、被拒绝的已存储凭据、Linux 上存在嵌套可写根目录时的启动问题,以及 Linux 和 macOS 上 Git 元数据的保护。
Copilot CLI 1.0.89 发布稳定版,Copilot SDK 1.0.15 支持类型化输出
9 月 28 日 — GitHub 于 UTC 19:20 发布 Copilot CLI 稳定版 1.0.89。9 月 27 日介绍的预览版 1.0.89-5 已支持 .claude/rules 文件;在发布说明的 35 项内容中,还有多项首次亮相。Auto 路由现在会推荐一个级别,用户可通过快捷键或点击切换;不受支持的 Fast 配置已移除,已保存的 Fast 偏好设置会回退到 Balance。创建 pull request 时会遵循仓库模板,包括必填章节和检查清单。在本地会话中,于空白输入框连续按两次 Esc,可以恢复尚未开始执行的提示词;直接安装的插件也可以启用和禁用(copilot plugin enable)。在沙箱中,经过包装(timeout 60 gh …)的 gh 和 git 命令可以运行;在 Windows 上启用本地网络访问后,也可以访问 localhost。
随后(UTC 19:38),将 Copilot 智能体运行环境嵌入应用的 GitHub Copilot SDK 在经历五个预览版后发布 1.0.15。主要新功能是六种 SDK(TypeScript、Python、Go、Java、C# 和 Rust)均支持结构化类型输出:开发者提供 JSON Schema 或符合相应语言习惯的类型,模型返回经过验证的类型化输出,而非自由文本。一个实验性管理器还允许应用要求在安装 MCP 服务器或 skill 前进行人工审核,并明确作出确认、拒绝或取消的决定。此外,在 Rust 中,安装该运行环境所占用的内存减少了约 99%。
🔗 Copilot CLI v1.0.89 · Copilot SDK v1.0.15
Devin 降价 30% 至 40%,Devin Fusion 在 FrontierCode 1.1 Extended 中领先
9 月 28 日 — Cognition 宣布 Devin 的使用成本显著降低:Fusion 和 Normal 模式降价 30% 至 40%,Ultra 模式降价 15% 至 20%,代码审查工具 Devin Review 的降幅最高达 70%。公司将这些收益归因于整合最新模型(包括自研 SWE-2),以及改进 Devin 的云端运行框架(cloud harness):在一次工具调用中完成更多组合操作(一次完成格式化、分析和测试)、并行发起独立调用,并提高提示词缓存的复用率。公司给出的框架改进幅度来自说明性示例,并非实测结果。
Cognition 表示,各模式的智能水平得以维持或提升。Fusion 将一个能力较强的主模型与一个成本较低的辅助模型(sidekick)配合使用;文章中的图表显示,它在 FrontierCode 1.1 Extended 中排名第一。
| Cognition 评估的配置 | FrontierCode 1.1 Extended 得分 | 每项任务平均成本 |
|---|---|---|
| Devin Fusion | 68,8 | 0,60 美元 |
| Opus 5.5 (high) | 65,2 | 0,90 美元 |
| Fable 5.1 (medium) | 63,6 | 2,68 美元 |
| GPT-6 Astra (high) | 63,1 | 2,62 美元 |
| SWE-2 (high) | 60,1 | 0,64 美元 |
| GPT-6 Sol (high) | 59,6 | 0,87 美元 |
这里给出的 Opus 5.5(65,2)和 GPT-6 Astra(63,1)数值采用 high 推理力度,与同一天发布的 Sonnet 5.5 图表中的数值(65,3 和 64,5)不同;后者没有注明推理力度。成本更低的 Devin 即日起可用,但尚未公布新的价目表。
Devin 9 月 25 日版本说明及 Devin Mobile 测试版
9 月 25 日 — 此前未受关注的 Devin 9 月 25 日版本说明显示,Marketplace 新增 57 个托管 MCP(hosted MCP)集成,包括 Buildkite、Brex、Expo、Vanta、WorkOS 和 Wix。当用户要求生成适合交互呈现的报告(如图表、表格或示意图)而未指定格式时,Devin 也会生成交互式 HTML 报告。子会话启动时会收到父会话摘要,并以可移除标签的形式显示在输入区;如果会话所在机器进入休眠,打开预览 URL 或通过 SSH 连接便会将其唤醒。自动化任务可以在共享 Outpost 上运行,Devin 也能读取 Azure DevOps pull request 中失败检查对应的 Azure Pipelines 日志。
9 月 28 日,Cognition 还开放了 Devin Mobile 测试版候补名单。注册页面用一句话概括它:Devin 可在云端或用户的机器上运行,在自己的浏览器中测试,直到 pull request 准备好合并才会停止。官方尚未公布全面开放日期或价格。
🔗 Devin 版本说明 · X 上的 Devin Mobile
Zed 预告 Delta 0.18,Gemini CLI 发布无变更 nightly 版本
9 月 28 日 — Zed 预告,其用于与智能体协作编程的多人环境 Delta 将在 0.18 版本中允许 Delta 会话线程(threads)在已有的 Git worktree 中运行,但未给出发布日期。9 月 23 日发布的 0.17 版本已将每项并行任务隔离在各自的工作区中。Google 方面,9 月 28 日发布的 Gemini CLI nightly 版本没有任何变更:它与 26 日的 nightly 版本基于同一个 commit;稳定版 v0.61.0 和预览版 v0.62.0-preview.0 也维持不变。
🔗 Zed 在 X 上的公告 · Gemini CLI v0.63.0-nightly.20260928
Perplexity Agent API 支持复用:Profiles、版本化 Skills 和共享连接器
9 月 28 日 — Perplexity 为 Agent API 增加了面向团队、可复用且带版本管理的配置层。核心资源 Profile 使用一个唯一的版本化标识符,保存定义智能体所需的一切:模型、指令、工具、Skills、连接器和运行设置。项目管理员只需配置一次智能体,便可供获授权的开发者使用;各应用只需提供自己的数据。
自定义 Skills 将指令、流程和辅助文件打包并进行版本管理:平台团队可以在其中保存部署检查、回滚(rollback)标准和报告格式,之后发布新版本,无须逐一修改应用。8 月底推出的托管连接器(managed connectors)现在成为管理员可向整个项目共享的资源:应用可以引用它们,无须分别存储凭据或工具定义。
| 新增资源 | 在 Agent API 中的作用 | 公布的可用状态 |
|---|---|---|
| Profiles | 以版本化标识符保存模型、指令、工具、Skills、连接器和运行设置 | 已可用 |
| 自定义 Skills | 供项目成员调用的版本化指令、流程和辅助文件 | 已可用 |
| 托管连接器 | 管理员共享的获批集成(GitHub、Slack、Google Drive、Datadog、Linear、Notion) | 预览版 |
所有设置均可在 API Console 中完成,项目成员使用同一项目的 API 密钥调用这些资源;文章没有公布价格。同一天,API 更新日志中的一项记录显示,Agent API 的 xhigh 预设从 GPT-5.6 Sol(openai/gpt-5.6-sol)切换至 Claude Opus 5.5(anthropic/claude-opus-5-5),提示词、推理力度、工具、token 预算和步骤上限均保持不变。三天前,low、medium 和 high 预设已切换至 GPT-6。
🔗 Agent API 现支持可复用智能体 · Perplexity API 更新日志
SpaceXAI 推出 Team Bots,供整个团队共享的 Grok Bots
9 月 28 日 — SpaceXAI 推出 Team Bots:围绕团队角色或工作流程构建、供全体成员共享的 Grok Bots。每位成员也可以单独与 Bot 协作。Bot 由团队共用,但对话保持私密:上下文和记忆按用户隔离,skills 则由团队共享。每个 Team Bot 在 Slack 中都有自己的身份标识,可以受邀加入频道,供整个团队提问。
| Bot 组成部分 | SpaceXAI 描述的作用 |
|---|---|
| 上下文 | 文件、指令和 skills |
| 插件 | 在 Salesforce、Notion 或 GitHub 中工作,由个人或团队连接 |
| 凭据 | 访问没有插件的第三方 API |
| 记忆 | Bot 为更好履行职责而保留的信息,按用户隔离 |
SpaceXAI 还介绍了内部用法。每个大型企业客户都有一个 Team Bot,夜间分析客户新闻、Gong 通话、Notion 文档和 Slack 讨论串,早上再于 Slack 发布简报。连接 Notion、Linear、Hex、Datadog 和 Cursor 的工程 Bot 协调了数百个 Cloud Agents:一个五人团队因此每天交付超过 100 个 pull request,并在数周内推出 Team Bots。客户案例方面,保险公司 Harper 表示,它在 24 小时内构建了一个帮助客户恢复失效保单的 Team Bot;据其首席执行官称,该工具为客户节省了超过 120,000 美元。
Team Bots 即日起面向 Teams 和 Enterprise 套餐开放公开测试,并提供针对销售、产品管理、营销和数据分析预配置的 Team Bots。SpaceXAI 尚未公布价格或配额。
🔗 Team Bots(SpaceXAI) · @bot 在 X 上的公告
H Company 发布 Holo4:27B 与 35B-A3B 开放权重智能体模型
9 月 28 日 — H Company 发布新一代智能体模型系列 Holo4,包含两种规模:拥有 270 亿参数的稠密模型,以及 35B-A3B 混合专家模型(Mixture of Experts)。两者均通过 H Models API 提供服务,并以 BF16、FP8、NVFP4 和 4 位 GGUF 格式发布在 Hugging Face 上。H 还推出 Holotron4 Nano,它是在 NVIDIA 的 Nemotron 3 Nano Omni 上应用其后训练方法得到的。同一个模型可通过图形界面、代码、MCP 或 API 执行操作,适用环境包括桌面、网页、Android 和代码沙箱。H 先以监督学习、再以强化学习训练该模型,其中包括约 10,000 项可验证任务,由其 Agentic Task Factory 根据普通文档生成。
| 评估模型 | 基础模型与许可证 | 公布的成绩 |
|---|---|---|
| Holo4 27B | Qwen3.8-27B,CC-BY-NC-4.0(非商业用途) | OSWorld 2.0:61,7%;OSWorld:85,2%,每项任务 0,08 美元 |
| Holo4 35B-A3B | Qwen3.6-35B-A3B,Apache-2.0 | OSWorld 2.0:30,9% |
| Holotron4 Nano (Holotron4-30B-A3B) | Nemotron 3 Nano Omni,NVIDIA Open Model Agreement | 相较基础模型的提升仅以图表呈现 |
| Claude Opus 5.5(H 引用的参照模型) | 闭源模型 | OSWorld 2.0:81,8% |
H 说明了评估条件:Holo4 在自有运行框架中测得,OSWorld 2.0 仅运行一次,并与使用其他运行框架和推理力度得到的公开成绩比较。在 AutomationBench 中,600 项公开任务里有 480 项属于曾用于收集训练数据的任务划分。H 公开了其成绩背后的全部执行轨迹,可逐步查看或从 Hugging Face 下载,并表示将在未来几天发布用于加速推理的 DSpark 草案。
🔗 Hugging Face 上的 Holo4 文章 · H Company 公告
机器人技术:Sakana AI 的 SAIL 将成功率从 25% 提升至 73%,ProjectSim 探讨仿真测量
9 月 28 日 — Sakana AI 介绍了与东京大学合作的 SAIL(Scaling In-Context Imitation Learning)研究,该研究已被 IROS 2026 会议接收。论文的 arXiv 标识符可追溯至 2026 年 3 月,当天的新进展是公开介绍这项研究。它探讨的问题是:不重新训练现有视觉语言模型(VLM),只增加推理阶段的计算量,能否让它生成可靠的机器人动作?
SAIL 将少量成功示范放入上下文,据此生成完整轨迹并在仿真中执行;随后,第二个 VLM 根据视频估计任务进度,利用这一反馈引导蒙特卡洛树搜索(MCTS)。只有最终选中的轨迹会交给真实机器人执行。Gemini Robotics-ER 1.5 同时承担这两个角色,其权重没有改动。
| 评估方法 | 搜索节点数 | 六项仿真任务的平均成功率 |
|---|---|---|
| 单次生成 | 1 | 25 % |
| 深度优先搜索 | 15 | 37 % |
| 广度优先搜索 | 15 | 51 % |
| SAIL | 6 | 55 % |
| SAIL | 15 | 65 % |
| SAIL | 45 | 73 % |
这些成功率统计的是在预算内找到成功轨迹的配置比例:每项任务在 ALOHA 模拟器中有 20 种配置,成功与否由模拟器而非 VLM 验证。在 LeRobot SO-101 机械臂上,以 15 条候选轨迹为预算,SAIL 在将积木放进碗里的任务中成功了 6 次中的 5 次;使用所找到的轨迹训练的模仿策略也取得 6 次中的 5 次成功,且执行速度更快。Sakana 承认其局限:开环执行、搜索带来的额外计算量,以及真实环境评估仅涵盖一项任务且每种方法只进行了六次试验。
ProjectSim 盘点机器人技术基准测试
9 月 28 日 — 模拟成绩与真实成绩之间的差距,正是 ProjectSim 首项实验研究的问题。在一篇尚未给出自身实验结果的综述文章中,Luca Cilio 回顾了从 MetaWorld、LIBERO 等操作任务基准测试,到 RoboChallenge 等共享实体测试的各类基准。他还援引 RoboCasa365 的数据指出:GR00T N1.5 经 30,000 次演示数据微调后,单项技能成功率为 43%,但在微调中未出现过的技能组合上降至 4.4%。ProjectSim 的实验旨在检验,更逼真的模拟场景(重建几何形状、外观和物理属性)能否让模拟成绩更接近真实机器人上的测量结果;目前尚未公布结果。
Mistral 在慕尼黑设立专注于工业 AI 和物理 AI 的中心
9 月 28 日 — Mistral 在慕尼黑设立一处中心。这里将汇集物理 AI(Physics AI)和工业 AI(Industrial AI)研究团队,以及直接为合作企业工作的应用工程师。Mistral 将自身定位为长期技术合作伙伴,而非软件供应商。
| Mistral 提及的合作伙伴 | 公布的工作 |
|---|---|
| BMW | 碰撞模拟与工程 AI |
| Siemens Energy | 工业 AI 应用 |
| 慕尼黑工业大学(TUM) | 用于汽车空气动力学的风洞数字孪生 |
这一中心延续了 Mistral 于 2026 年 5 月收购 Emmi AI 后的布局。该收购为 Mistral 带来了 30 多名专攻计算流体力学(CFD)、结构力学和多物理场模拟的物理学家、研究人员及工程师。Mistral 将与 TUM 及 Nikolaus A. Adams 教授合作开发汽车空气动力学数字孪生,融合实时风洞传感器数据和离线计算的 CFD 模拟,以实时给出精确的空气动力学预测。
博文重申了其技术自主主张:客户可获取模型权重,在自身基础设施上、依据欧洲法律运行模型,数据无需离开企业。文中还称,Mistral 将在 2030 年前建设 1 吉瓦的欧洲算力。博文引用了德国联邦数字化转型部长 Karsten Wildberger 和巴伐利亚州总理府负责人 Florian Herrmann 的发言。Mistral 正在慕尼黑地区招聘,但未公布招聘人数或投资金额。
NVIDIA 与 Nscale 测试 DSX MaxLPS:在相同电力预算下,GPU 数量增加 37%,吞吐量提高 49%
9 月 27 日 — NVIDIA 发布了与 Nscale 联合开展的 DSX MaxLPS 量化评估。该软件依据运营商的策略,在 AI 工厂的资源之间分配电力。NVIDIA 称,在相同的已批准电力预算下,它最多可额外部署 40% 的 GPU。博文强调,这依靠的是协调分配,并未提高场站的供电量。
测试在冰岛凯夫拉维克的 Nscale Verne 园区数据中心进行,使用 GB300 NVL72、以 FP4 精度运行的 Kimi K2.5,以及 NVIDIA Dynamo 和 TensorRT LLM。该数据中心完全使用可再生能源。在相同的 264.4 kW 预留电力预算下,GPU 数量从 140 增至 192,现有实例的吞吐量没有下降。
| 测量指标 | 静态基线 | 使用 DSX MaxLPS | 测得变化 |
|---|---|---|---|
| 管理的 GPU 数量 | 140 | 192 | +37,1 % |
| 归一化总吞吐量 | 1 084 503 tokens/s | 1 618 443 tokens/s | +49,2 % |
| 实测总功率 | 166,2 kW | 198,9 kW | +19,7 % |
| 电力预算利用率 | 62,9 % | 75,2 % | +12,3 个百分点 |
| 每瓦预留功率的吞吐量 | 4,10 tokens/s/W | 6,12 tokens/s/W | +49,2 % |
博文也说明了代价:延迟的中位数和 P75 与基线相比仍在 5% 以内,但首次生成 token 的等待时间在 P99 上增加了 17%,其基线为 15.7 秒。NVIDIA 建议运营商分五步验证,从界定电力范围到设定生产环境限制。这项评估此前,Lambda 已在 HGX B200 上完成验证,并于 9 月 15 日公布结果:在原本容纳 16 个节点的预算内运行了 19 个节点。关于 Vera Rubin 在入口水温 45 °C 的液冷条件下的预测则单独列出。
简讯
- DeepSeek Harness 0.2.0-rc.1 — 这是 0.2.0 系列的首个候选发布版,也是 DeepSeek 智能体运行框架的第 23 个预发布版,目前仍无稳定版。使用 DeepSeek 账户模型的对话无需额外 API 密钥即可联网搜索;自动化任务则移入可选插件包。🔗 来源
- Vercel AI Gateway 上的 Pixel Canary — 自 9 月 25 日起,Vercel 在该模型的隐匿测试期内免费提供这款来自未具名厂商的代码模型。在 31 项 Next.js 任务中,它以 pass@4 完成 28 项,与 GPT-6 Astra (high) 持平;通过 AGENTS.md 提供文档后完成 30 项。该服务不提供零数据保留。🔗 来源
- GitHub Actions 自托管运行器 — 在 GitHub Enterprise Cloud 上,最低版本要求将从 9 月 29 日起全面执行:低于 2.329.0 的运行器将无法注册,低于最低执行版本的运行器将停止接收任务。一项新的 REST API 提供支持终止日期。GitHub Enterprise Server 不受影响。🔗 来源
- NexteraBERT — Rikka Botan 发布了一款拥有 2.126 亿参数的双向编码器,使用 1300 亿个 token 进行预训练,训练量约为 ModernBERT 的十五分之一。按其自身测量,GLUE 得分为 87.90,ModernBERT-base 为 87.97;MTEB v2 得分为 54.70,对照值为 53.63;在 65,536 个 token 的长度下,吞吐量达到对照模型的 5.22 倍。代码采用 MIT 许可证。🔗 来源
- 实时 LTX-2.5 — 一篇社区博文将这款拥有 220 亿参数的音视频模型,从每段视频需要 90 秒推进到生成速度快于播放速度:在一张 96 GB 显卡上,生成 5 秒片段仅需 1.83 秒。这得益于将步骤从 8 步减至 4 步,并采用 NVFP4 计算和 CUDA Graph。代码采用 Apache-2.0 许可证。🔗 来源
- SCRIBE — 为印度法院开发语音识别技术的 Adalat AI,在 PyPI 发布了这款开源评估工具,相关论文发表于 Interspeech 2026。它分别评估词语、数字、标点和专业术语;相比之下,传统词错误率会将一句任何校对员都不会修改的马拉雅拉姆语句子评为 100% 错误。🔗 来源
- 228 个 JEV 项目 — Awesome JEV 列表维护者 Eric Kang,从 GitHub 搜索“jev”返回的 13,473 个仓库中,选出 228 个开源项目,涵盖 10 种类型,每个项目至少有 50 颗星,并固定在一个提交版本。搜索结果也混杂了无关项目,因此这是一份人工筛选名单,并非独立普查。🔗 来源
- HeyGen 与 Jev — HeyGen 在 X 上发布指南,将 TypeSafe AI 的决策模型 Jev 放在其 MCP 服务器之前。Jev 对约 40 个潜在客户进行分类,判断是否适合视频、切入角度、语言及匹配程度;Claude 编写脚本,随后由 HeyGen MCP 批量生成视频。只有最后一步消耗额度,并需要审批。🔗 来源
- 使用 Gemini 3.8 Flash 创作的四个项目 — Google 博客展示了四个用 9 月 2 日发布的模型制作的项目:借助 Antigravity 构建的实时卫星追踪、动态青海波纹样、霸王龙 3D 骨架,以及带 10 个摄像机视角的自动变速箱。博文没有提供数据,也未发布新产品。🔗 来源
- 布鲁克林餐饮店主与 Gemini — Google 博客讲述了 Greenpoint 的 Edy’s Grocer 店主 Edy Massih 如何使用 Gemini:将食谱调整至适合 200 位宾客的分量、生成购物清单,并按饮食需求调整菜单。文中没有发布新功能。🔗 来源
- Lenfest Institute — OpenAI 将投入 500 万美元,另提供最高价值 500 万美元的软件额度和工程支持,用于 Lenfest Institute 的 AI 研究员项目下一阶段。该项目于 2024 年在美国 11 家新闻编辑室启动;此次支持力度是此前的两倍。🔗 来源
- ChatGPT 的 Health 标签页 — 如今,在 Health 标签页选中图表、指标或记录,即可获得个性化解释,有时还会附带交互式图表,无需编写提示词。Health 仍仅向美国用户开放,要求年满 18 岁,适用于 Free、Go、Plus 和 Pro 套餐的网页端及 iOS 端。🔗 来源
- WebMCP Challenge 获奖项目 — OpenAI Developers 介绍了八月底启动的黑客松中获奖的十个项目:MASIL、Alza、ArchMorph、Aisle、Roque Nights、Mandate、Observatory、Bouquet Studio、Faraday 和 JupyterLite WebMCP;未公布排名或各项目奖金金额。🔗 来源
- macOS 安全修复 — 9 月 25 日,macOS 桌面应用的 26.924.20706 版本修复了由 Patrick Wardle(Objective-See Foundation)报告的 CVE-2026-100754 漏洞。该版本被列在 ChatGPT 与 Codex 更新日志的 Codex 应用栏目下;更新日志未描述漏洞细节。🔗 来源
这意味着什么
每个 token 的价格不再变化,下降的是所需 token 的数量。Sonnet 5.5 维持 Sonnet 5 的定价,但据 Anthropic 称,由于消耗的 token 更少,单项任务成本最多降低 30%;Devin 通过集成包括 SWE-2 在内的最新模型,并将工具调用分组,使成本降低 30% 至 40%;Manus 则称,其新运行框架在受测配置中将执行成本降低了 32%。如今影响成本的关键,是模型和运行框架完成任务时消耗的资源量,而非标价;中档模型也在追赶高端模型:在 Terminal-Bench 4.0 上,Sonnet 5.5 超过了以 Xhigh 推理强度测得的 Opus 5.5 成绩。
智能体默认获得更多自主权,安全控制则被移到它们无法触及的地方。Claude Code 现已在所有套餐中默认以自动模式启动;与此同时,NVIDIA 将监控部署在智能体无法访问的 DPU 中,并默认要求由人工批准智能体提出的每条访问规则。工具也沿着同一方向发展:Codex CLI 对需要较高权限的命令所输入的终端内容要求审批;Copilot SDK 则允许在安装 MCP 服务器或 skill 前强制进行人工审核。智能体越能独立行动,控制机制就越需要部署在智能体自身之外。
智能体也正在成为拥有身份的团队成员。Perplexity 的 Profiles 让智能体成为整个项目都能复用的版本化配置;SpaceXAI 的 Team Bots 拥有各自的 Slack 标识,并为每位用户分别保存记忆;Cue 的智能体则获得电子邮件地址、电话号码和钱包。当智能体能够代表他人付款、打电话或发消息时,NVIDIA 当天提出的控制问题就变得十分具体。
最后,当天的数据需要仔细解读。Devin 在 FrontierCode 的某个变体上测量 Sonnet 5.5,但其推文和图表对该变体的命名并不一致;Cognition 同日发布的两张图表,也给出了不同的 Opus 5.5 成绩。Holo4 的成绩是在 H 的运行框架中,以 OSWorld 2.0 上的一次运行测得;SAIL 的 73% 是模拟环境中的结果,而模拟与现实之间的差距正是 ProjectSim 首项实验研究的问题。媒体模型方面,Eleven v4 有外部排名和盲测作为依据;Kling 4.0 发布时则没有基准测试或定价,部分功能还要等到日后推出。
来源
- Claude Sonnet 5.5 发布介绍(Anthropic)
- Claude Sonnet 5.5 迁移指南
- @ClaudeDevs:Sonnet 5.5 的推理强度建议
- GitHub Copilot 中的 Claude Sonnet 5.5
- GitHub Copilot 模型与定价
- Devin 中的 Claude Sonnet 5.5
- @cognition:Sonnet 5.5 在 FrontierCode 1.1 Main 上的成绩
- @cursor_ai:Cursor 中的 Sonnet 5.5
- @v0:v0 中的 Sonnet 5.5
- NVIDIA 发布 Open Agent Safety Platform(新闻稿)
- Open Agent Safety Platform 架构(NVIDIA)
- 使用 NVIDIA OpenShell 为 AI 智能体添加运行时控制
- @NVIDIAAI:Jensen Huang 在 CNBC 上的访谈
- @togethercompute:首发合作伙伴
- @perplexity_ai:与 NVIDIA 的合作
- Manus 2.0 发布介绍
- @ManusAI:Cue 发布消息
- @ManusAI:智能体电话号码
- Eleven v4 发布介绍(ElevenLabs)
- @ElevenLabs:Eleven v4 发布帖串
- Kling 4.0 版本说明
- @Kling_ai:Kling 4.0 发布消息
- Claude Code v2.1.284
- Codex CLI 0.158.0
- Copilot CLI v1.0.89
- Copilot SDK v1.0.15
- Devin 的成本效率现已提升最高 40%
- Devin 9 月 25 日版本说明
- @cognition:Devin Mobile 测试版
- @zeddotdev:Delta 0.18
- Gemini CLI v0.63.0-nightly.20260928
- Agent API 现支持可复用的智能体(Perplexity)
- Perplexity API 更新日志
- Team Bots(SpaceXAI)
- @bot:Team Bots 发布消息
- Hugging Face 博客上的 Holo4
- Holo4(H Company)
- SAIL(Sakana AI)
- SAIL 项目页面
- 机器人技术基准测试:现状与未来方向(ProjectSim)
- 你好,德国!(Mistral AI)
- NVIDIA DSX MaxLPS 如何最大化 AI 工厂的吞吐量和效率
- DeepSeek Harness 0.2.0-rc.1
- Vercel AI Gateway 上的 Pixel Canary
- 自托管运行器版本强制执行日期已调整(GitHub)
- NexteraBERT 技术报告
- 基于 220 亿参数视频扩散模型的实时会说话角色
- SCRIBE(Adalat AI)
- JEV:入选的 228 个项目(Eric Kang)
- @HeyGen:Jev 与 HeyGen MCP 指南
- 看看四位开发者用 Gemini 3.8 Flash 创作了什么(Google)
- 这位店主用 Gemini 为 200 位宾客做饭的三种方式(Google)
- Lenfest AI Collaborative:新阶段(OpenAI)
- ChatGPT 版本说明
- @OpenAIDevs:WebMCP Challenge 获奖项目
- ChatGPT 与 Codex 更新日志:CVE-2026-100754