ai-powered-markdown-translatorArtikel översatt från franska till svenska med gpt-6-sol.
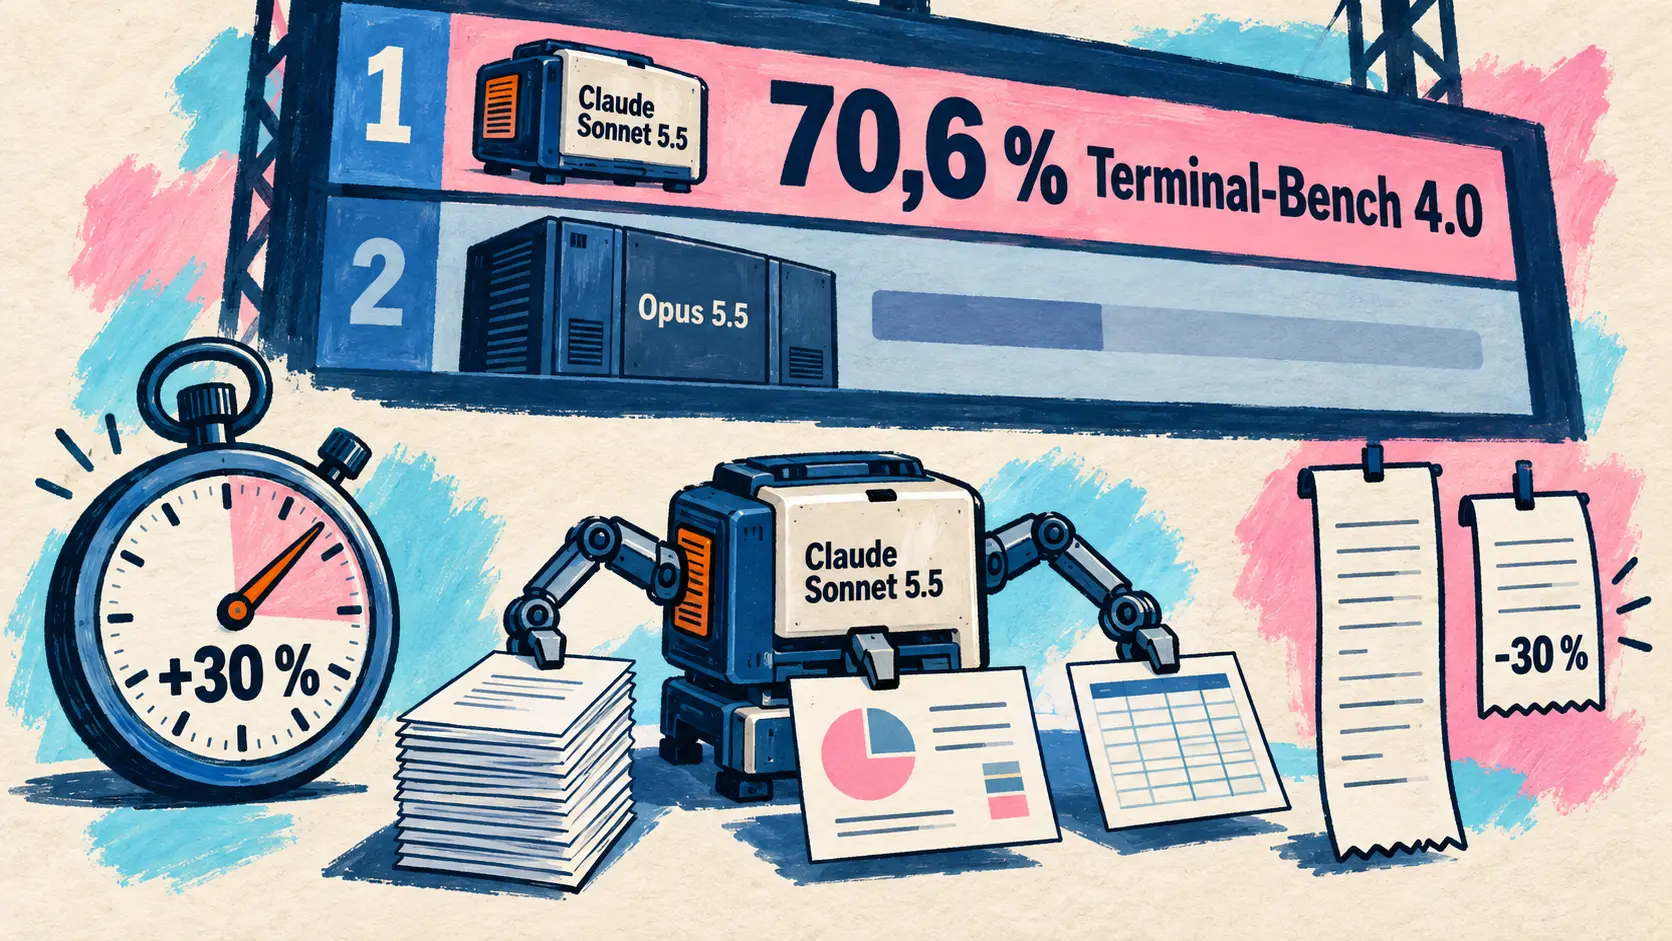
Måndagen den 28 september, sex dagar efter Opus 5.5, lanserar Anthropic Claude Sonnet 5.5: samma pris som Sonnet 5, generering som är mer än 30 % snabbare och 70,6 % på Terminal-Bench 4.0, jämfört med 10,3 % för föregångaren. GitHub Copilot, Devin, Cursor och v0 gör modellen tillgänglig samma dag. NVIDIA presenterar Open Agent Safety Platform, som övervakar agenter från programvara ner till kiselchippen tillsammans med fler än 100 organisationer. Manus går över till 2.0 och lanserar Cue, ElevenLabs släpper Eleven v4 och Kling aviserar Kling 4.0 till oktober. Bland kodagenterna aktiverar Claude Code 2.1.284 autoläge för alla abonnemang och Devin blir 30–40 % billigare.
Anthropic lanserar Claude Sonnet 5.5, snabbare och billigare per uppgift än Sonnet 5
28 september — Sex dagar efter Claude Opus 5.5 lanserar Anthropic Claude Sonnet 5.5 (claude-sonnet-5-5), den andra modellen i Claude 5.5-familjen. Den beskrivs som en tydlig förbättring (clear upgrade) av Sonnet 5, genererar svar mer än 30 % snabbare och kostar enligt Anthropics tester upp till 30 % mindre per uppgift, eftersom den behöver betydligt färre token för samma arbete. Opus 5.5 förblir modellen för komplext arbete som kräver noggranna bedömningar. Sonnet 5.5 riktar sig till tydligt avgränsade vardagsuppgifter: att rätta buggar och skapa välgjorda dokument, presentationer och kalkylblad. Claude Haiku 5.5, avsedd för stora volymer, ska följa under de kommande veckorna.
Den tydligaste skillnaden mot Sonnet 5 syns på Terminal-Bench 4.0, ett test av agentbaserad programmering på kommandoraden: 70,6 % mot 10,3 %, även över Opus 5.5:s 66,4 %, uppmätt med ansträngningsnivån Xhigh, dess bästa resultat. På GDPval-AA, som gäller kvalificerat kunskapsarbete, slutar Sonnet 5.5 två poäng efter Opus 5.5 och omkring 400 poäng över Sonnet 5. Det är också den första Sonnet-modellen som klarar Pokémon Röd genom att enbart utgå från skärmbilder.
| Benchmark (Anthropics siffror) | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % (Xhigh) | — |
| FrontierCode 1.1 Main | 52,1 % (Xhigh), 46,2 % (Max) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | — |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 | 1483 |
| Humanity’s Last Exam (med verktyg) | 64,5 % | 54,9 % | 67,7 % | — |
| OSWorld 2.1 (delvis) | 80,1 % | 57,0 % | 81,8 % | — |
| Chartography (utan verktyg) | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
Anthropic anger flera förbehåll till siffrorna. På FrontierCode får Sonnet 5.5 ett lägre resultat med ansträngningsnivån Max, där den oftare startar Claude Codes skill för kodgranskning. I två fall som Cognition undersökte ledde det till att modellen överskred tidsgränsen eller gick utanför uppgiftens ramar. GDPval-AA och AA-Briefcase mättes på en förhandsversion med en bugg vars effekt bedöms som liten. Framför allt anser Anthropic att Opus 5.5 är klart starkare på öppna och komplexa uppgifter som kräver uthålligt omdöme.
Priset är oförändrat: 2 dollar per miljon token för indata, 10 dollar för utdata och 0,20 dollar för läsning från cache, precis som för Sonnet 5. För indata och utdata är det hälften av priset för Opus 5.5 (4 respektive 20 dollar). Besparingen kommer från antalet token som används: med ansträngningsnivån Low eller Medium överträffar Sonnet 5.5 Sonnet 5:s bästa resultat på flera benchmarktester till omkring en tiondel av kostnaden per uppgift. Modellen har ett kontextfönster på 1 miljon token och kan generera upp till 128 000 token som utdata. Standardnivån för ansträngning är Medium i Claude Code och Claude-apparna, och High på Claude Platform.
We recommend starting with Opus for large projects and Sonnet for tasks where you need to balance quality with speed and cost.
🇸🇪 Vi rekommenderar att börja med Opus för stora projekt och med Sonnet för uppgifter där kvalitet, hastighet och kostnad behöver balanseras. — @ClaudeDevs på X
Eftersom Sonnet 5.5:s förmåga inom cybersäkerhet är jämförbar med Opus 5:s är den den första Sonnet-modellen som lanseras med cybersäkerhetsskydd på samma nivå som de mest kapabla modellerna: förfrågningar med hög risk styrs synligt över till Sonnet 5, utan att påverka vanlig buggfixning. Det är också den första Sonnet-modellen med säkerhetsklassificerare som förhindrar att dess resonemang extraheras, och resonemanget är nu knutet till kontot där det skapades.
För utvecklare räcker det inte att byta identifierare för att gå över till claude-sonnet-5-5: dokumentationen listar fem ändringar som bryter kompatibiliteten med Sonnet 5. Dit hör att möjligheten att stänga av resonemang ersätts med inställningen between_tools och att ett påtvingat verktygsval avvisas (tool_choice till any eller tool, fel 400). Kommandot /claude-api migrate hjälper till med migreringen i Claude Code.
Sonnet 5.5 finns tillgänglig från och med i dag på Claude Platform, i Claude Code samt hos Amazon Web Services, Google Cloud och Microsoft Azure. Källorna anger inga detaljer per abonnemang (Free, Pro, Max). I Claude Code gör version 2.1.284 den till standardmodell för Sonnet på Anthropics API (se avsnittet om kodagenter).
🔗 Lanseringen av Claude Sonnet 5.5 · Migreringsguide till Sonnet 5.5
GitHub Copilot gör den tillgänglig från och med Pro
28 september — GitHub gör Claude Sonnet 5.5 allmänt tillgänglig i Copilot (post i ändringsloggen kl. 11.03 PT). Till skillnad från Claude Opus 5.5, som kom den 22 september utan Pro-abonnemanget, erbjuds den för Copilot Pro, Pro+, Max, Business och Enterprise på tio plattformar: Visual Studio Code, Visual Studio, Copilot CLI, kodagenten Copilot, GitHub Copilot-appen, github.com, GitHub Mobile, JetBrains IDE:er, Xcode och Eclipse. Utrullningen sker stegvis.
GitHub uppger att Sonnet 5.5 i de första testerna presterar lika bra som Claude Sonnet 5 på koduppgifter med betydligt färre steg, token och verktygsanrop, och blir klar snabbare, men publicerar inga siffror. Modellen debiteras efter användning enligt leverantörens offentliga prislista: GitHubs dokumentation anger 2 dollar för indata och 10 dollar för utdata per miljon token, samma pris som för Claude Sonnet 5. För Business och Enterprise blir modellen automatiskt tillgänglig om nya modeller är aktiverade som standard, såvida inte en administratör har stängt av den inställningen eller modellen.
🔗 Claude Sonnet 5.5 i GitHub Copilot · Modeller och priser för Copilot
Devin mäter den till 64,4 % på FrontierCode 1.1
28 september — Cognition gör Sonnet 5.5 tillgänglig i Devin Desktop och Devin CLI på lanseringsdagen och mäter den till 64,4 % på FrontierCode 1.1, företagets test av hur väl modeller uppfyller krav i kodbaser som används i produktion, jämfört med 56,2 % för Sonnet 5. Den går om Claude Fable 5.1 (63,6 %) och hamnar precis bakom de tre översta i diagrammet: Opus 5.5 (65,3 %), Fable 5 (64,9 %) och GPT-6 Astra (64,5 %).
Cognitions inlägg på X talar om varianten Main, men diagrammet i blogginlägget har rubriken Extended och använder för de andra modellerna de värden som publicerades den 22 september för den varianten. Som jämförelse anger Anthropic 52,1 % för Sonnet 5.5 på varianten Main med ansträngningsnivån Xhigh. Cognition återger också Anthropics siffror: generering som är mer än 30 % snabbare och en kostnad per uppgift som är upp till 30 % lägre än för Sonnet 5, medan priset per token är oförändrat.
🔗 Claude Sonnet 5.5 i Devin · Cognition på X
Cursor och v0 gör den tillgänglig samma dag
28 september — v0, Vercels verktyg för att skapa appar, gör Sonnet 5.5 tillgänglig kl. 18.04 UTC, en minut efter tillkännagivandet. Cursor följer kl. 20.14 UTC och beskriver den som en stark modell, i nivå med Opus på många uppgifter, utan att ange vilken Opus-modell som avses. Inga priser eller mätningar för respektive verktyg anges: liksom för Opus 5.5 den 22 september handlar det enbart om att modellen blir tillgänglig.
🔗 Cursor på X · v0 på X
NVIDIA lanserar Open Agent Safety Platform för att övervaka agenter från programvara ner till kiselchippen
28 september — NVIDIA lanserar Open Agent Safety Platform, en öppen programvaruplattform med en referensdesign för system, för att säkra AI-agenter från test till driftsättning genom styrning och kontroll i hela teknikstacken (programvara, hårdvara, beräkning och robotsystem). Utgångspunkten i arkitekturinlägget är att flera ledande laboratorier nyligen har rapporterat att agenter tagit sig ut ur de utvärderingsmiljöer som skulle hålla dem på plats. En av de fem principerna är att policyn ska kunna verifieras och tillämpas via en separat kanal, utom räckhåll för agenten.
| Plattformskomponent | Funktion enligt NVIDIA |
|---|---|
| NVIDIA OpenShell (open source, version 0.1) | Sandlådemiljö för körning (runtime): policy som verifieras formellt och tillämpas utanför agenten, på Vera CPU och tredjepartsplattformar (Arm, Intel) |
| NVIDIA Sentry (referensdesign) | Övervakare via en separat kanal på BlueField-4 DPU, som sätter en agent i karantän inom några millisekunder |
| NVIDIA DOCA | Granskning av förfrågningar och svar, verifierad telemetri, agentidentitet, åtkomst enligt zero trust |
OpenShell, en exekveringsmiljö med öppen källkod (Apache 2.0) som har följts sedan mars, når version 0.1 (0.1.0 publicerades på GitHub den 25 september och 0.1.2 den 28 september) och uppges nu vara brett tillgänglig för både öppna och slutna modeller. Varje agent körs i en sandlåda (sandbox) med kontroller på kärnnivå. En extern övervakare granskar HTTP-, GraphQL- och MCP-trafik (en läsning tillåts, medan en skrivning via samma API blockeras), och agenten får åtkomst till tjänster utan att de verkliga inloggningsuppgifterna exponeras för den. Policyer skrivs i YAML, kompileras till OPA/Rego och passerar en formell verifierare. Om en åtkomstbehörighet saknas kan agenten föreslå en snävt avgränsad regel, som som standard kräver mänskligt godkännande utan att agenten själv kan godkänna den. OpenShell stöder Codex, Claude Code, Pi och Hermes. Vid långvariga adversariella tester tillbringade ledande agenter med reducerade skydd enligt NVIDIA upp till två timmar med att försöka övertala en AI-granskare att ge dem åtkomst till ett skyddat GitHub-repositorium, utan att någon skrivning där ägde rum.
Sentry, den andra komponenten, flyttar övervakningen till hårdvaran: en övervakare via en separat kanal (out-of-band watchdog) på BlueField-4 DPU, byggd på DOCA, som kontinuerligt följer agenternas beteende, verifierar deras identitet och inom några millisekunder kan sätta en agent som överskrider sina gränser i karantän. I en Vera Rubin-POD placerar varje beräkningsmodul en BlueField-4 på den enda vägen från noden till modellen. På ett Vera-system som redan har BlueField-4 krävs enligt NVIDIA bara en programuppdatering för att aktivera funktionen.
NVIDIA uppger att fler än 100 organisationer arbetar med plattformens teknik. Anthropic integrerar sina Claude Managed Agents med OpenShell och BlueField; de kör agentens arbetsloop på en server som är skild från sandlådorna. SpaceXAI använder plattformen för kodagenter i Cursor och för Grok-modeller. Salesforce följer OpenShell-agenternas aktivitet från Slack, där deras behörighetsförfrågningar kan godkännas eller avslås. SAP integrerar den i Joule Studios exekveringsmiljö och Scale AI i sitt GenAI-erbjudande. Listan sträcker sig från Microsoft, IBM, Palantir, CrowdStrike och Hugging Face till robotik (Figure, Skild AI), finans (Citi, JPMorganChase), operativsystem (Canonical, SUSE, Red Hat) och infrastrukturleverantörer (CoreWeave, Nebius, Oracle Cloud Infrastructure). Programvaran, däribland OpenShell och olika skills, finns på GitHub och NVIDIAs utvecklarsida. Jensen Huang presenterade också åtgärderna på CNBC samma dag.
🔗 NVIDIAs pressmeddelande · Plattformens arkitektur · OpenShell 0.1.0 i praktiken · Jensen Huang på CNBC (@NVIDIAAI)
Together AI och Perplexity uppmärksammar lanseringen
28 september — Together AI beskriver sig som lanseringspartner för plattformen, medan NVIDIAs pressmeddelande listar företaget bland infrastrukturleverantörerna. Leverantören av inferenstjänster påminner om att den har byggt plattformsfunktioner för att utveckla och driftsätta agenter på ett säkert sätt och säger sig fortsätta investera på området, bland annat tillsammans med NVIDIA kring OpenShell, utan att ange några siffror eller namnge en produkt.
Perplexity nämns två gånger i pressmeddelandet (först bland aktörerna som ansluter sig till NVIDIA, sedan bland de fler än 100 organisationer som använder plattformens teknik), men utan någon närmare angiven roll. Företaget publicerar en tråd med nio inlägg:
We’re partnering with Nvidia and 100+ industry partners to build infrastructure that contains rogue AI agents.
🇸🇪 Vi samarbetar med NVIDIA och fler än 100 branschpartner för att bygga infrastruktur som håller okontrollerade AI-agenter inom sina gränser. — @perplexity_ai på X
Resten av tråden tar upp Escaping SPACE, säkerhetsgranskningen av företagets sandlåda som publicerades den 23 september och uppmärksammades då (ingen lyckades ta sig ut ur den virtuella maskinen vid 108 försök). Det inlägget nämnde NVIDIA endast genom OpenShell, en av de testade sandlådorna från tredje part, där inget av de två försöken att kringgå skyddet lyckades.
Manus går över till 2.0 med agentramverket Cascade och lanserar Cue, en app för personliga agenter
28 september — Manus lanserar Manus 2.0, som företaget beskriver som en ny arkitektur med nya produkter snarare än en vanlig versionsuppdatering. Tillkännagivandet kommer mindre än en månad efter att Manus återupptog sin självständiga verksamhet den 1 september.
Grunden heter Cascade och är den senaste versionen av Manus eget agentramverk: varje projekt börjar med en lätt uppsättning funktioner och får specialiserade förmågor först när arbetet kräver det. Briefen, sidan, videon och automatiseringen hålls samlade i samma projekt. Manus anger hur stora förbättringarna är jämfört med sitt tidigare system, men bara för en testad konfiguration som inte beskrivs närmare i blogginlägget.
| Mått som Manus redovisar (en testad konfiguration) | Skillnad mot det tidigare systemet |
|---|---|
| Förbrukade tokens | -23,2 % |
| Uppgifternas längd | -28,2 % |
| Kostnad för körning | -32 % |
Två delar kompletterar helheten: Cloud Computer, en dedikerad miljö som kan köpas för sådant som behöver köras hela tiden (en server för ett flerspelarspel eller en automatisering), och automatiseringar som nu utlöses av en händelse i en ansluten tjänst (ett nytt mejl, förändrade annonsresultat, en kalenderbokning, ett Slack-meddelande eller en Notion-uppdatering) och ställs in med en enda prompt.
Datorappen blir Manus Studio, en gemensam arbetsyta för människor och AI som bara läser in de verktyg projektet behöver. Där finns två miljöer. Video Editor skapar en första klippning och öppnar sedan en tidslinje (timeline) där klipp, bilder, texter, animationer och ljud ligger separat och kan redigeras. Den är tänkt för produktannonser på 30 till 60 sekunder, handledningar och vloggar, medan läget Alchemy låter AI:n sköta den kreativa ledningen. Game Dev kombinerar video-, bild- och kodmodeller, publicerar ett spel som kan spelas via en enkel länk och ordnar flerspelarläge genom köp av en Cloud Computer. Med Remote Control och Computer Use kan man från telefonen ge Manus en uppgift att utföra på den egna datorn och följa skrivbordet i realtid.
Den tredje delen, Cue, är en ny fristående app för personliga agenter på telefon och dator, byggd på Manus infrastruktur. Varje agent har en egen mejladress, ett eget telefonnummer, en egen plånbok och en egen dator: den skickar meddelanden, betalar inom en fastställd budget, tar emot samtal och lämnar en sammanfattning av dem. Flera agenter kan arbeta mot samma mål i en gruppchatt, och Cue kan användas för vardagstjänster, som att beställa på restaurang genom att skanna en QR-kod. Senare under dagen förtydligade Manus att numren kan användas för att ringa och ta emot samtal och SMS, men bara i vissa länder och ibland enbart för röstsamtal.
Manus 2.0 finns tillgängligt nu på webben, datorn och mobilen. Cue finns också tillgängligt, medan iOS-versionen väntar på granskning i App Store. Den kostnadsfria förhandsåtkomsten kräver en inbjudningskod och är begränsad till ett mindre antal tidiga användare. Blogginlägget anger inga priser, inte ens för Cloud Computer, namnger inga underliggande modeller och hänvisar inte till några externa utvärderingar.
🔗 Introducing Manus 2.0 · Tillkännagivande av Cue på X · Agenternas telefonnummer
ElevenLabs lanserar Eleven v4, sin mest uttrycksfulla röstmodell, och en Turbo-variant för agenter
28 september — ElevenLabs lanserar Eleven v4, som presenteras som företagets mest känslouttryckande modell för talsyntes (TTS), och Eleven v4 Turbo, en variant med låg latens för samtalsagenter. Eleven v4 bygger på en helt ny arkitektur och ska tolka tonfall, rytm, känslor och sammanhang i en text för att kunna leverera ett dramatiskt, ömt, angeläget eller komiskt framförande utan att röstens identitet går förlorad. ElevenLabs uppger att modellen ligger etta i Artificial Analysis rankning Provider Voice Arena (september 2026) och att omkring 75 % av lyssnarna föredrog den i blindtester mot Cartesia Sonic 3.6, Inworld TTS-2 och två TTS-modeller i Google Gemini 3.8, där oavgjorda resultat räknades som en halv röst.
Framförandet styrs med naturligt språk eller med markörer i texten (skratt, en arg replik med fransk accent, lätt regn, en vibrerande telefon), som Eleven v4 enligt företaget följer mer troget än sina föregångare. Stödet för det internationella fonetiska alfabetet (IPA) förbättras tydligt, och dialoger med flera röster blir naturligare tack vare en ny metod för att fånga rösternas identitet och hålla dem konsekventa i agenter, ljudböcker och annonser.
| Mått publicerat av ElevenLabs | Angivet värde |
|---|---|
| Placering i Artificial Analysis Provider Voice Arena (sept.) | 1:a |
| Preferens i blindtester mot 4 konkurrerande modeller | omkring 75 % |
| Medianlatens för inferens med Eleven v4 Turbo | omkring 100 ms |
| Mediantid till första tal med Eleven v4 Turbo | omkring 150 ms |
| Språk som stöds | över 90 (Eleven v3: över 70) |
| Gräns per begäran för Eleven v4 | 10 000 tecken (Eleven v3: 5 000) |
| Minsta ljudmängd för en omedelbar röstklon | 10 sekunder |
Tiden till första tal mättes vid strömning via WebSocket i jämförelse med Cartesia, xAI, Google och OpenAI, med nätverkslatensen borträknad. Eleven v4 Turbo har också optimerats tillsammans med plattformen ElevenAgents. En röst som spelats in på ett språk talar de andra med naturlig accent, och Eleven v4 stöder nu professionella röstkloner (Professional Voice Clones). Det blir också mer tillförlitligt att länka samman långa genereringar, vilket är användbart i Studio och appen Reader.
Båda modellerna finns nu i ElevenAgents, ElevenCreative och via API:et (eleven_v4 och eleven_v4_turbo). Under två veckor är det rabatterade API-priset för Eleven v4 22 dollar och för Eleven v4 Turbo 11 dollar per miljon tecken. Eleven v4 är också gratis för abonnemanget Creator och högre nivåer i ElevenCreative, upp till två gånger de månatliga krediterna. Listpriset har inte publicerats. Lanseringen följer på Eleven v3, som började säljas i februari 2026.
🔗 Introducing Eleven v4 · Tillkännagivandetråd på X
Kling aviserar Kling 4.0 till oktober och öppnar Kling 4.0 Flash för förhandsåtkomst
28 september — Kling AI presenterar Kling 4.0, nästa generation av företagets videomodell, med officiell lansering planerad till oktober. Den första varianten, Kling 4.0 Flash, har sedan den 28 september varit tillgänglig i förhandsåtkomst för en begränsad grupp användare: enligt tillkännagivandet på X gäller det årsabonnenter på Ultra. Kling lyfter fram tre områden: visuell realism, kreativ kontroll och ett fullständigt berättande (narrative completeness).
Enligt specifikationerna genererar Kling 4.0 sammanhängande videor på 3 till 30 sekunder i upp till 4K, med tvåkanaligt stereoljud. Berättelsen kan styras med upp till 10 nyckelbilder och promptar på högst 8 000 tokens. Systemet Omni Reference tar emot upp till 15 referenser per generering: 10 bilder, 5 videor på sammanlagt högst 30 sekunder och 7 motiv, varav 3 hämtas från videor. Ljudreferensen är begränsad till röster. Modeller utan texturer och djupkartor kan användas för att styra rörelser och bildutsnitt, och redigeringen kan ändra ansiktsuttryck, gester, kamera, stil eller bakgrund i upp till 5 klipp. Kling uppger också att modellen kan återge läsbar text i bild och stöder fler språk, accenter och dialekter, från kantonesiska och sichuanesiska till indisk engelska.
| Teknisk specifikation | Kling 4.0 | Kling 4.0 Flash |
|---|---|---|
| Tillgänglighet | Officiell lansering i oktober | Begränsad förhandsåtkomst sedan 28 september |
| Genereringslägen | Text till video, bild till video, första och sista bild, 10 nyckelbilder, Omni Reference | Text till video, bild till video, Omni Reference |
| Längd per generering | 3 till 30 sekunder | 3 till 20 sekunder |
| Högsta upplösning | 4K (även 720p och 1080p) | 720p |
| Dynamiskt omfång | 10-bitars HDR i 1080p och 4K, aviserat till senare | 8-bitars SDR |
Alla funktioner finns ännu inte på plats. Versionsinformationen anger att 10-bitars HDR i 1080p och 4K kommer senare (coming soon), trots att inlägget på X räknar upp det bland funktionerna i Kling 4.0. Detsamma gäller möjligheten att förlänga en video till upp till 2 minuter. Kling gör också om sin skapandesida: alla referenser samlas i ett enda inmatningsfält och en arbetsyta läggs till där en agent utför de begärda uppgifterna. Tillkännagivandet innehåller inga priser, ingen information om API-åtkomst och inga benchmarkresultat. Det illustreras med kortfilmen THE BEAT, skapad med Kling 4.0.
🔗 Versionsinformation för Kling 4.0 · Tillkännagivande på X
Kodagenter: Claude Code 2.1.284, Codex CLI 0.158.0, Copilot CLI 1.0.89 och dess SDK, Devin, Delta och Gemini CLI
Claude Code 2.1.284 startar i autoläge för alla abonnemang och leverantörer
28 september — Claude Code 2.1.284 publicerades kl. 18.02 UTC, några ögonblick före tillkännagivandet av modellen, och lägger till Claude Sonnet 5.5, som blir den förvalda Sonnet-modellen i Anthropics API. Versionen har 100 poster: 57 buggfixar, 18 förbättringar, 14 tillägg och 11 ändringar.
Den mest märkbara ändringen gäller behörigheter: när inget läge har ställts in startar interaktiva sessioner i terminalen och VS Code nu i autoläge, för alla abonnemang och hos alla leverantörer. Version 2.1.283 införde detta redan den 25 september för tredjepartsleverantörer och sessioner utan telemetri; 2.1.284 utökar det till alla, och inställningen permissions.defaultMode har fortsatt företräde. Ett nytt svar, ”Ja, men fråga igen nästa gång” (Yes, but ask again next time), tillåter en enstaka läsning utanför arbetskatalogerna och låter Claude Code fråga på nytt vid senare läsningar.
Ultracode flyttas från reglaget för arbetsnivå till en egen växel i /effort (Tab-tangenten eller /effort ultracode on och off): läget tvingar inte längre fram nivån xhigh och förblir aktivt oavsett vald nivå. En motsvarande växel finns under reglaget för arbetsnivå i VS Code.
| Nyhet i 2.1.284 | Kommando eller inställning |
|---|---|
| Autoläge som standard för alla abonnemang och leverantörer | permissions.defaultMode har företräde |
| Ultracode som fristående växel | Tab i /effort eller /effort ultracode on och off |
| Samlad återanslutning av MCP-servrar som fallerat | /mcp reconnect all |
| Utgifter i dollar för Claude apps-gatewayen | /usage och statusrad (fälten used_usd, limit_usd, period) |
| En andra kompaktering om ”Prompt is too long” kvarstår | automatisk |
På säkerhetssidan kan plugins från marketplaces, claude.ai eller npm inte längre förhandsgodkänna sina egna verktyg när administratören endast tillåter sina hanterade regler (allowManagedPermissionRulesOnly). Regler i .claude/rules som är symboliskt länkade från en plats utanför projektet kräver godkännande, och när minnet läses in neutraliseras osynliga tecken och taggar i MEMORY.md som härmar Claude Codes märkning. För bättre tillförlitlighet görs ett nytt försök när en svarsström är skadad i stället för att visa ”JSON Parse error”, och MCP-anrop i en återupptagen session väntar upp till 10 sekunder på sin server. När skyddsmekanismerna i en Sonnet-modell flaggar ett meddelande ger meddelandet nu mer förklaring och föreslår att begäran ändras och skickas igen.
Codex CLI 0.158.0: kopiering vid markering och OAuth-klienthemligheter för MCP
28 september — Codex CLI 0.158.0 publicerades kl. 05.07 UTC och är den första stabila versionen sedan 0.157.1 den 26 september. Versionsinformationen listar 188 pull requests sedan 0.157.0. Helskärmsgränssnittet (fullscreen TUI) gör kopiering vid markering (copy-on-select) och inklistring med högerklick konfigurerbara. Ett textstycke som kopieras från transkriptionen behåller sin Markdown-formatering.
| Berörd funktion | Inställning eller detalj |
|---|---|
| Kopiering vid markering | tui.copy_on_select: auto som standard (tmux, Zellij, direkta macOS-terminaler utom Ghostty och Kitty), always, never |
| Inklistring med högerklick | tui.right_click_paste: auto (Windows, Linux, WSL), on (även macOS), off |
| MCP-servrar med OAuth | codex mcp add --oauth-client-secret, nyckel oauth.client_secret |
| Exec-server | Bärartoken för direkta WebSocket-anslutningar |
| Bildgenerering | Uttryckligen transparent bakgrund (transparent_background), redigering av bilder från konversationen |
Codex kan nu ansluta till MCP-servrar som kräver en förregistrerad OAuth-klient med en klienthemlighet. Direkta WebSocket-anslutningar till exec-server kan skyddas med bärartoken (bearer tokens), även när de går via app-server. På säkerhetssidan blir godkännande av inmatning som skickas till en terminal en stabil funktion och aktiveras som standard för kommandon som körs med utökade behörigheter. Korrigeringarna rör främst sandlådor: vanliga sökvägar i Windows 10, lagrade autentiseringsuppgifter som avvisas, uppstart i Linux med nästlade skrivbara rotkataloger samt skydd av Git-metadata i Linux och macOS.
Copilot CLI 1.0.89 blir stabil, Copilot SDK 1.0.15 får typade utdata
28 september — GitHub släpper Copilot CLI 1.0.89 som stabil version (19.20 UTC). Förhandsversionen 1.0.89-5, som beskrevs den 27 september, hade redan stöd för .claude/rules-filer; flera av de 35 punkterna i versionsinformationen är nya. Auto-routningen föreslår nu en nivå som kan ändras med ett kortkommando eller ett klick, och Fast-profilen tas bort eftersom den saknade stöd: en sparad Fast-inställning återgår till Balance. När en pull request skapas följs lagringsplatsens mallar, inklusive obligatoriska avsnitt och checklistor. I en lokal session återupptar två tryck på Escape i ett tomt inmatningsfält en prompt vars tur ännu inte har börjat, och direkt installerade plugins kan aktiveras och inaktiveras (copilot plugin enable). I sandlådan fungerar inneslutna gh- och git-kommandon (timeout 60 gh …), och localhost blir tillgängligt i Windows när åtkomst till det lokala nätverket är aktiverad.
Kort därefter (19.38 UTC) når GitHub Copilot SDK, som bäddar in Copilots agentkörmiljö i en applikation, version 1.0.15 efter fem förhandsversioner. Den viktigaste nyheten är strukturerade, typade utdata i alla sex SDK:erna (TypeScript, Python, Go, Java, C# och Rust). Utvecklaren anger ett JSON-schema eller en typ som är idiomatisk för språket, och modellen returnerar typade och validerade utdata i stället för fri text. En experimentell hanterare låter också applikationen kräva mänsklig granskning innan en MCP-server eller ett skill installeras, med ett uttryckligt beslut (bekräfta, neka eller avbryta). I Rust minskar dessutom minnesanvändningen vid installation av körmiljön med omkring 99 %.
🔗 Copilot CLI v1.0.89 · Copilot SDK v1.0.15
Devin blir 30–40 % billigare, Devin Fusion toppar FrontierCode 1.1 Extended
28 september — Cognition meddelar att Devin blir betydligt billigare att använda: 30–40 % billigare i lägena Fusion och Normal, 15–20 % i Ultra och upp till 70 % för kodgranskningsverktyget Devin Review. Företaget tillskriver besparingarna integrationen av de senaste modellerna, däribland den egna SWE-2, och arbetet med Devins molnbaserade agentramverk (cloud harness): fler åtgärder samlas i samma verktygsanrop (formatering, analys och testning på en gång), oberoende anrop körs parallellt och promptcachen återanvänds bättre. De storleksordningar som anges för agentramverket kommer från illustrativa exempel, inte mätningar.
Cognition uppger att kapaciteten i varje läge har bibehållits eller förbättrats. Fusion kombinerar en kapabel huvudmodell med en billigare hjälpare (sidekick), och diagrammet i inlägget placerar den högst i FrontierCode 1.1 Extended.
| Konfiguration utvärderad av Cognition | Poäng i FrontierCode 1.1 Extended | Genomsnittlig kostnad per uppgift |
|---|---|---|
| Devin Fusion | 68,8 | 0,60 dollar |
| Opus 5.5 (high) | 65,2 | 0,90 dollar |
| Fable 5.1 (medium) | 63,6 | 2,68 dollar |
| GPT-6 Astra (high) | 63,1 | 2,62 dollar |
| SWE-2 (high) | 60,1 | 0,64 dollar |
| GPT-6 Sol (high) | 59,6 | 0,87 dollar |
Värdena för Opus 5.5 (65,2) och GPT-6 Astra (63,1), angivna för ansträngningsnivån high, skiljer sig från värdena i diagrammet som publicerades samma dag för Sonnet 5.5 (65,3 och 64,5), där ansträngningsnivån inte anges. Den billigare Devin-versionen är tillgänglig från och med i dag, men ingen ny prislista har publicerats.
🔗 Devin är nu upp till 40 % mer kostnadseffektiv
Devins versionsinformation från den 25 september och betaversionen av Devin Mobile
25 september — Devins versionsinformation från den 25 september, som hittills har gått obemärkt förbi, lägger till 57 driftade MCP-integrationer (hosted MCP) i Marketplace, däribland Buildkite, Brex, Expo, Vanta, WorkOS och Wix. Devin skapar också en interaktiv HTML-rapport när användaren ber om en rapport som lämpar sig för det (diagram, tabeller, scheman) utan att ange format. En underordnad session startar med en sammanfattning av sin överordnade session, som visas som en borttagbar etikett i inmatningsfältet. En session vars dator har gått i viloläge väcks när någon öppnar en förhandsgransknings-URL eller ansluter till den via SSH. Automatiseringar kan köras på en delad Outpost, och Devin kan läsa Azure Pipelines-loggar för kontroller som misslyckats på pull requests i Azure DevOps.
Den 28 september öppnar Cognition också en väntelista för betaversionen av Devin Mobile. Registreringssidan sammanfattar den i en mening: Devin körs i molnet eller på din dator, testar i sin egen webbläsare och slutar inte förrän pull requesten är redo att slås samman. Varken datum för en allmän lansering eller pris har publicerats.
🔗 Devins versionsinformation · Devin Mobile på X
Zed aviserar Delta 0.18, Gemini CLI släpper en nightly utan ändringar
28 september — Zed meddelar, utan att ange något datum, att version 0.18 av Delta, företagets samarbetsmiljö för att koda med agenter, kommer att köra Delta-trådar (threads) i befintliga Git-worktrees. Version 0.17, som släpptes den 23 september, isolerade redan varje parallell uppgift i en egen arbetsyta. Hos Google innehåller den Gemini CLI-nightly som släpptes den 28 september inga ändringar: den bygger på samma commit som versionen från den 26 september, medan den stabila v0.61.0 och förhandsversionen v0.62.0-preview.0 ligger kvar.
🔗 Zed på X · Gemini CLI v0.63.0-nightly.20260928
Perplexitys Agent API får återanvändbara Profiles, versionshanterade Skills och delade anslutningar
28 september — Perplexity lägger till ett återanvändbart och versionshanterat konfigurationslager för team i sitt Agent API. Kärnan är en Profile, som under en enda versionshanterad identifierare lagrar allt som definierar en agent: modell, instruktioner, verktyg, Skills, anslutningar och körinställningar. En projektadministratör konfigurerar agenten en gång och gör den tillgänglig för behöriga utvecklare. Varje applikation behöver sedan bara tillföra sina egna data.
Anpassade Skills paketerar instruktioner, procedurer och stödfiler i versionshanterad form. Ett plattformsteam kan lägga sina driftsättningskontroller, kriterier för återställning (rollback) och rapportformat där och sedan publicera en ny version i stället för att ändra varje applikation. Hanterade anslutningar (managed connectors), som lanserades i slutet av augusti, blir en resurs som administratören delar med hela projektet. Applikationerna kan referera till dem utan att var och en lagrar egna inloggningsuppgifter eller verktygsdefinitioner.
| Tillagd resurs | Funktion i Agent API | Angiven tillgänglighet |
|---|---|---|
| Profiles | Modell, instruktioner, verktyg, Skills, anslutningar och körinställningar under en versionshanterad identifierare | Tillgänglig |
| Anpassade Skills | Versionshanterade instruktioner, procedurer och stödfiler som projektmedlemmar anropar | Tillgängliga |
| Hanterade anslutningar | Godkända integrationer som administratören delar (GitHub, Slack, Google Drive, Datadog, Linear, Notion) | Förhandsversion |
Allt konfigureras i API Console, och medlemmarna anropar resurserna med en API-nyckel från samma projekt. Inlägget anger inga priser. Samma dag ändras Agent API:s xhigh-förinställning enligt en post i API:ets ändringslogg från GPT-5.6 Sol (openai/gpt-5.6-sol) till Claude Opus 5.5 (anthropic/claude-opus-5-5). Prompter, resonemangsnivå, verktyg, tokenbudgetar och gränser för antal steg förblir oförändrade. Tre dagar tidigare hade förinställningarna low, medium och high flyttats till GPT-6.
🔗 Agent API stöder nu återanvändbara agenter · Ändringslogg för Perplexitys API
SpaceXAI lanserar Team Bots, Grok Bots som delas av ett helt team
28 september — SpaceXAI lanserar Team Bots, Grok Bots som byggs kring en teamroll eller ett arbetsflöde och delas av alla teammedlemmar. Var och en kan också arbeta enskilt med boten. Boten är gemensam, men konversationerna förblir privata: kontext och minnen hålls åtskilda per användare, medan skills delas inom teamet. Varje Team Bot har en egen identitet i Slack och kan bjudas in till en kanal där hela teamet kan ställa frågor till den.
| Botkomponent | Funktion enligt SpaceXAI |
|---|---|
| Kontext | Filer, instruktioner och skills |
| Plugins | Arbete i Salesforce, Notion eller GitHub, anslutna av varje användare eller för teamet |
| Inloggningsuppgifter | Åtkomst till tredjeparts-API:er som saknar plugin |
| Minnen | Det boten kommer ihåg för att utvecklas i sin roll, åtskilt per användare |
SpaceXAI beskriver hur företaget självt använder botarna. Varje stor företagskund har en egen Team Bot som under natten analyserar nyheter om kunden, Gong-samtal, Notion-dokument och Slack-trådar och sedan publicerar en uppdatering i Slack på morgonen. Teknikteamets bot, som är kopplad till Notion, Linear, Hex, Datadog och Cursor, har styrt hundratals Cloud Agents. Ett team på fem personer har därmed levererat över 100 pull requests per dag och lanserat Team Bots på några veckor. Bland kunderna uppger försäkringsbolaget Harper att det på 24 timmar byggde en Team Bot som hjälper kunder att återaktivera utgångna försäkringar. Enligt bolagets vd har kunderna sparat över 120 000 dollar.
Team Bots finns från och med i dag som offentlig beta för abonnemangen Teams och Enterprise, med förkonfigurerade Team Bots för försäljning, produktledning, marknadsföring och dataanalys. SpaceXAI anger varken priser eller kvoter.
🔗 Team Bots (SpaceXAI) · Tillkännagivande från @bot på X
H Company publicerar Holo4, agentmodeller med öppna vikter på 27B och 35B-A3B
28 september — H Company publicerar Holo4, sin nya serie agentmodeller, i två storlekar: en tät modell med 27 miljarder parametrar och en blandning av experter (Mixture of Experts) på 35B-A3B. Båda erbjuds via H Models API och publiceras på Hugging Face i BF16, FP8, NVFP4 och 4-bitars GGUF. H lägger också till Holotron4 Nano, framtagen genom att tillämpa företagets metod för efterträning på NVIDIA:s Nemotron 3 Nano Omni. Samma modell kan agera via grafiska gränssnitt, kod, MCP eller API:er, på datorer, på webben, på Android eller i en kodsandslåda. H har tränat den med övervakad inlärning och därefter förstärkningsinlärning, bland annat på cirka 10 000 verifierbara uppgifter som företagets Agentic Task Factory genererar utifrån enbart dokumentation.
| Utvärderad modell | Bas och licens | Publicerat resultat |
|---|---|---|
| Holo4 27B | Qwen3.8-27B, CC-BY-NC-4.0 (icke-kommersiell) | 61,7 % på OSWorld 2.0; 85,2 % på OSWorld för 0,08 dollar per uppgift |
| Holo4 35B-A3B | Qwen3.6-35B-A3B, Apache-2.0 | 30,9 % på OSWorld 2.0 |
| Holotron4 Nano (Holotron4-30B-A3B) | Nemotron 3 Nano Omni, NVIDIA Open Model Agreement | förbättringar jämfört med basmodellen visas endast i diagram |
| Claude Opus 5.5 (referens angiven av H) | sluten modell | 81,8 % på OSWorld 2.0 |
H redovisar villkoren för mätningarna: Holo4 mäts i företagets eget agentramverk, med en enda körning på OSWorld 2.0, och jämförs med offentliga resultat som uppnåtts med andra agentramverk och ansträngningsnivåer. På AutomationBench ingår 480 av de 600 offentliga uppgifterna i den fördelning som användes för att samla in träningsdata. H publicerar alla körförlopp bakom sina offentliga resultat, som kan granskas steg för steg eller laddas ned från Hugging Face, och aviserar DSpark-utkast för att påskynda inferensen under de närmaste dagarna.
🔗 Inlägg om Holo4 på Hugging Face · Tillkännagivande från H Company
Robotik: Sakana AI:s SAIL ökar träffsäkerheten från 25 till 73 %, ProjectSim ifrågasätter mätning i simulering
28 september — Sakana AI presenterar SAIL (Scaling In-Context Imitation Learning), ett arbete som genomförts tillsammans med Tokyos universitet och antagits till konferensen IROS 2026. Artikeln har en arXiv-identifierare från mars 2026; dagens nyhet är den offentliga presentationen. Frågan är om man kan få en befintlig vision-språkmodell (VLM) att ta fram tillförlitliga robotrörelser utan att träna om den, genom att ge den mer beräkningskraft vid inferens.
SAIL genererar en fullständig rörelsebana utifrån några lyckade demonstrationer som lagts i kontexten och kör den i simulering. En andra VLM bedömer sedan utifrån videon hur långt uppgiften har kommit, och återkopplingen styr en Monte Carlo-trädsökning (MCTS). Endast den utvalda rörelsebanan skickas till den verkliga roboten. Gemini Robotics-ER 1.5 fyller båda rollerna utan att dess vikter ändras.
| Utvärderad metod | Söknoder | Genomsnittlig framgång för sex simulerade uppgifter |
|---|---|---|
| Enstaka generering | 1 | 25 % |
| Djupet-först-sökning | 15 | 37 % |
| Bredden-först-sökning | 15 | 51 % |
| SAIL | 6 | 55 % |
| SAIL | 15 | 65 % |
| SAIL | 45 | 73 % |
Andelarna avser de konfigurationer (20 per uppgift i ALOHA-simulatorn) där en lyckad rörelsebana hittas inom budgeten. Det är simulatorn, inte VLM-modellen, som verifierar om uppgiften lyckas. Med en LeRobot SO-101-arm lyckas SAIL i 5 av 6 försök att lägga ett block i en skål, med en budget på 15 kandidater. En imitationspolicy som tränats på de hittade rörelsebanorna lyckas också i 5 av 6 försök och körs snabbare. Sakana medger begränsningarna: körning utan återkoppling, extra beräkningar för sökningen och en utvärdering på verklig robot som begränsats till en uppgift och sex försök per metod.
🔗 Inlägg från Sakana AI · SAIL:s projektsida
ProjectSim sammanfattar läget för testmiljöer inom robotik
28 september — Skillnaden mellan simulerade resultat och resultat i verkligheten är ämnet för ProjectSims första experiment. I ett översiktsinlägg utan egna resultat går Luca Cilio igenom testmiljöer för manipulation, från MetaWorld och LIBERO till gemensamma fysiska tester som RoboChallenge. Med siffror från RoboCasa365 påminner han om att GR00T N1.5, som finjusterats med 30 000 demonstrationer, klarar 43 % av de enskilda färdigheterna men bara 4,4 % av kombinationer som inte ingick i finjusteringen. ProjectSims experiment ska undersöka om mer verklighetstrogna simulerade miljöer, med återskapad geometri, utseende och fysikaliska egenskaper, gör att resultaten i simulering närmar sig dem som mäts på en verklig robot. Inga resultat har publicerats ännu.
Mistral öppnar ett nav för industriell AI och AI för fysik i München
28 september — Mistral öppnar ett nav i München. Där ska forskargrupper inom AI för fysik (Physics AI) och industriell AI (Industrial AI) arbeta tillsammans med tillämpningsingenjörer som arbetar direkt för partnerföretagen. Mistral beskriver sig där som en långsiktig teknikpartner snarare än en programvaruleverantör.
| Partner som Mistral nämner | Planerat arbete |
|---|---|
| BMW | Krocksimulering och AI för ingenjörsarbete |
| Siemens Energy | Tillämpningar av industriell AI |
| Münchens tekniska universitet (TUM) | Digitala tvillingar i vindtunnel för fordonsaerodynamik |
Navet bygger vidare på förvärvet av Emmi AI i maj 2026, då mer än 30 fysiker, forskare och ingenjörer med expertis inom beräkningsströmningsmekanik (CFD), strukturmekanik och multifysiksimuleringar kom till Mistral. Tillsammans med TUM och professor Nikolaus A. Adams ska Mistral utveckla digitala tvillingar för fordonsaerodynamik. Genom att kombinera mätningar från vindtunnelns sensorer i realtid med CFD-simuleringar beräknade i förväg ska de ge exakta aerodynamiska förutsägelser i realtid.
Inlägget upprepar argumentet om suveränitet: kunderna får tillgång till modellvikterna, modellerna körs på deras egen infrastruktur och under europeisk lagstiftning, och data lämnar inte organisationen. Det uppger också att Mistral ska bygga upp en gigawatt europeisk beräkningskapacitet till 2030. Inlägget citerar Tysklands förbundsminister för digital omställning, Karsten Wildberger, och chefen för Bayerns statskansli, Florian Herrmann. Mistral rekryterar i Münchenområdet men anger varken antal tjänster eller investeringsbelopp.
🔗 Hallo, Deutschland! (Mistral AI)
NVIDIA och Nscale mäter DSX MaxLPS: 37 % fler GPU:er och 49 % högre genomströmning inom samma effektbudget
27 september — NVIDIA publicerar en utvärdering med siffror för DSX MaxLPS, dess programvara som fördelar effekt mellan resurserna i en AI-fabrik enligt operatörens regler. Utvärderingen genomfördes tillsammans med Nscale. Enligt NVIDIA gör programvaran det möjligt att driftsätta upp till 40 % fler GPU:er inom samma godkända effektbudget. Inlägget betonar att det handlar om samordnad fördelning, inte om att öka anläggningens elförsörjning.
Testet kördes på GB300 NVL72 i Nscales datacenter på Verne-anläggningen i Keflavík på Island, som drivs helt med förnybar energi, med Kimi K2.5 i FP4, NVIDIA Dynamo och TensorRT LLM. Inom samma tilldelade effektbudget på 264,4 kW växte flottan från 140 till 192 GPU:er utan att genomströmningen för de befintliga instanserna minskade.
| Uppmätt mått | Statisk basnivå | Med DSX MaxLPS | Uppmätt skillnad |
|---|---|---|---|
| Hanterade GPU:er | 140 | 192 | +37,1 % |
| Normaliserad sammanlagd genomströmning | 1 084 503 tokens/s | 1 618 443 tokens/s | +49,2 % |
| Uppmätt total effekt | 166,2 kW | 198,9 kW | +19,7 % |
| Utnyttjande av effektbudgeten | 62,9 % | 75,2 % | +12,3 procentenheter |
| Genomströmning per tilldelad watt | 4,10 tokens/s/W | 6,12 tokens/s/W | +49,2 % |
Inlägget redovisar också nackdelen: medianlatensen och P75 ligger inom 5 % från referensvärdet, men P99 för tiden till första token ökar med 17 % från en basnivå på 15,7 sekunder. NVIDIA rekommenderar att operatörer validerar i fem steg, från att avgränsa effektbudgeten till att fastställa produktionsgränser. Utvärderingen följer på Lambdas validering med HGX B200, som presenterades den 15 september (19 noder inom budgeten för 16). Prognoserna för Vera Rubin, med vätskekylning vid 45 °C inloppstemperatur, redovisas separat.
Kortfattat
- DeepSeek Harness 0.2.0-rc.1 — Den första releasekandidaten i 0.2.0-serien och den 23:e förhandsversionen av DeepSeeks agentramverk, fortfarande utan stabil version: konversationer om modeller på DeepSeek-kontot kan söka på webben utan extra API-nyckel, och automatiserade uppgifter flyttas till ett valfritt pluginpaket. 🔗 källa
- Pixel Canary på Vercel AI Gateway — Sedan den 25 september erbjuder Vercel denna kodmodell från en icke namngiven utvecklare gratis under dess dolda testperiod: 28 av 31 Next.js-uppgifter i pass@4, samma resultat som GPT-6 Astra (high), och 30 av 31 när dokumentation tillhandahålls via AGENTS.md. Ingen nollagring av data erbjuds. 🔗 källa
- GitHub Actions med egna runners — På GitHub Enterprise Cloud börjar minimiversionerna tillämpas fullt ut den 29 september: en runner äldre än version 2.329.0 kan inte längre registreras, och en runner under minimiversionen för körning slutar ta emot jobb. Ett nytt REST-API anger slutdatum för stöd. GitHub Enterprise Server berörs inte. 🔗 källa
- NexteraBERT — Rikka Botan publicerar en dubbelriktad encoder med 212,6 miljoner parametrar, förtränad på 130 miljarder tokens (ungefär 15 gånger färre än ModernBERT): 87,90 på GLUE mot 87,97 för ModernBERT-base, 54,70 mot 53,63 på MTEB v2 och 5,22 gånger högre genomströmning vid 65 536 tokens, enligt egna mätningar. Koden har MIT-licens. 🔗 källa
- LTX-2.5 i realtid — Ett inlägg från användargruppen får denna ljud- och videomodell med 22 miljarder parametrar att gå från 90 sekunder per klipp till generering snabbare än uppspelning: 1,83 sekunder för ett klipp på 5 sekunder på ett kort med 96 Go, tack vare 4 steg i stället för 8, NVFP4-beräkning och CUDA Graph. Koden har Apache-2.0-licens. 🔗 källa
- SCRIBE — Adalat AI, som utvecklar taligenkänning för indiska domstolar, publicerar detta verktyg för utvärdering med öppen källkod på PyPI (med en artikel till Interspeech 2026). Det bedömer ord, tal, skiljetecken och facktermer var för sig, medan felfrekvensen per ord ger 100 % för en mening på malayalam som ingen korrekturläsare skulle ändra. 🔗 källa
- 228 JEV-projekt — Eric Kang, som håller listan Awesome JEV, väljer ut 228 projekt med öppen källkod (10 typer, minst 50 stjärnor, vart och ett låst till en commit) bland de 13 473 arkiv som en sökning efter ”jev” på GitHub ger, en siffra som även omfattar orelaterade projekt. Det är ett manuellt urval, inte en oberoende kartläggning. 🔗 källa
- HeyGen och Jev — HeyGen publicerar en guide på X där Jev, TypeSafe AI:s beslutsmodell, placeras framför företagets MCP-server: Jev sorterar ett fyrtiotal potentiella kunder (video eller inte, infallsvinkel, språk, lämplighet), Claude skriver manusen och därefter producerar HeyGen MCP hela omgången. Bara det sista steget förbrukar krediter och kräver godkännande. 🔗 källa
- Fyra skapelser med Gemini 3.8 Flash — Googles blogg visar fyra projekt byggda med modellen som lanserades den 2 september: en livespårning av satelliter byggd med Antigravity, animerade Seigaiha-vågor, ett 3D-skelett av en tyrannosaurus och en automatisk växellåda med 10 kameravyer. Inga siffror eller produktnyheter presenteras. 🔗 källa
- En cateringföretagare i Brooklyn och Gemini — Googles blogg berättar hur Edy Massih, ägare till matbutiken Edy’s Grocer i Greenpoint, använder Gemini för att skala upp sina recept till 200 gäster, skapa inköpslistor och anpassa menyer efter olika kostbehov. Ingen ny funktion presenteras. 🔗 källa
- Lenfest Institute — OpenAI satsar 5 miljoner dollar, samt upp till 5 miljoner dollar i programvarukrediter och tekniskt stöd, på nästa fas av Lenfest Institutes AI-stipendieprogram, som lanserades 2024 på 11 amerikanska redaktioner. Det är dubbelt så mycket som det tidigare stödet. 🔗 källa
- ChatGPT:s flik Hälsa — Den som väljer ett diagram, ett mätvärde eller en journal i fliken Health får nu personliga förklaringar, ibland med ett interaktivt diagram, utan att skriva en prompt. Health är fortfarande begränsat till USA (18 år och äldre, abonnemangen Free, Go, Plus och Pro, webb och iOS). 🔗 källa
- Vinnare i WebMCP Challenge — OpenAI Developers presenterar de tio vinnande projekten från hackathonet som startade i slutet av augusti (MASIL, Alza, ArchMorph, Aisle, Roque Nights, Mandate, Observatory, Bouquet Studio, Faraday, JupyterLite WebMCP), utan rangordning eller belopp per projekt. 🔗 källa
- Säkerhetsrättning för macOS — Den 25 september rättade version 26.924.20706 av skrivbordsappen för macOS sårbarheten CVE-2026-100754, som rapporterats av Patrick Wardle (Objective-See Foundation). Versionen finns under Codex-appen i ändringsloggen för ChatGPT och Codex; någon beskrivning av sårbarheten ges inte. 🔗 källa
Vad det betyder
Priset per token står stilla; det är antalet tokens som minskar. Sonnet 5.5 behåller priset för Sonnet 5 men kostar enligt Anthropic upp till 30 % mindre per uppgift eftersom den förbrukar färre tokens. Devin blir 30 till 40 % billigare genom att integrera sina senaste modeller, däribland SWE-2, och samla sina verktygsanrop. Manus uppger att körkostnaden minskar med 32 % med dess nya agentramverk i en testad konfiguration. Det som nu gör skillnad är mängden arbete som förbrukas, både av modellen och agentramverket, snarare än listpriset. Mellanklassen närmar sig toppklassen: på Terminal-Bench 4.0 överträffar Sonnet 5.5 Opus 5.5:s resultat uppmätt vid ansträngningsnivån Xhigh.
Agenterna får som standard större självständighet, och skyddsmekanismerna flyttas utom räckhåll för dem. Claude Code startar numera i automatiskt läge på alla abonnemang, samtidigt som NVIDIA placerar övervakningen i en DPU som agenten inte kan nå och kräver mänskligt godkännande som standard för varje åtkomstregel som agenten föreslår. Verktygen följer samma linje: Codex CLI kräver godkännande för terminalinmatning vid kommandon med förhöjda behörigheter, och Copilot SDK gör det möjligt att kräva mänsklig granskning innan en MCP-server eller en skill installeras. Ju mer agenten agerar själv, desto viktigare är det att kontrollen ligger utanför agenten.
Agenten blir också en teammedlem med en egen identitet. Perplexitys Profiles gör en agent till en versionshanterad konfiguration som ett helt projekt kan återanvända. SpaceXAI:s Team Bots har egna Slack-ID:n och håller separata minnen för varje användare. Cues agenter får en e-postadress, ett telefonnummer och en plånbok. När en agent kan betala, ringa eller skriva för någon annans räkning blir de kontrollfrågor som NVIDIA tar upp samma dag mycket konkreta.
Dagens siffror kräver också noggrann läsning. Devin mäter Sonnet 5.5 på en variant av FrontierCode som benämns på olika sätt i dess inlägg på X och diagram. Två diagram från Cognition som publicerades samma dag ger olika resultat för Opus 5.5. Holo4 mäts i H:s agentramverk, i en enda körning på OSWorld 2.0. SAIL:s 73 % uppnås i simulering, och skillnaden mellan simulering och verklighet är just ämnet för ProjectSims första experiment. På mediesidan stöder sig Eleven v4 på en extern rankning och blindtester, medan Kling 4.0 kommer utan benchmark eller prisuppgift och med vissa funktioner uppskjutna till senare.
Källor
- Vi presenterar Claude Sonnet 5.5 (Anthropic)
- Guide för migrering till Claude Sonnet 5.5
- @ClaudeDevs: rekommendationer om ansträngningsnivå för Sonnet 5.5
- Claude Sonnet 5.5 i GitHub Copilot
- Modeller och priser för GitHub Copilot
- Claude Sonnet 5.5 i Devin
- @cognition: Sonnet 5.5 på FrontierCode 1.1 Main
- @cursor_ai: Sonnet 5.5 i Cursor
- @v0: Sonnet 5.5 i v0
- NVIDIA lanserar Open Agent Safety Platform (pressmeddelande)
- Arkitekturen för Open Agent Safety Platform (NVIDIA)
- Lägg till kontroller under körning för AI-agenter med NVIDIA OpenShell
- @NVIDIAAI: Jensen Huang på CNBC
- @togethercompute: lanseringspartner
- @perplexity_ai: partnerskap med NVIDIA
- Vi presenterar Manus 2.0
- @ManusAI: lanseringen av Cue
- @ManusAI: telefonnummer för agenter
- Vi presenterar Eleven v4 (ElevenLabs)
- @ElevenLabs: inläggstråd om lanseringen av Eleven v4
- Versionsinformation för Kling 4.0
- @Kling_ai: tillkännagivandet av Kling 4.0
- Claude Code v2.1.284
- Codex CLI 0.158.0
- Copilot CLI v1.0.89
- Copilot SDK v1.0.15
- Devin är nu upp till 40 % mer kostnadseffektivt
- Versionsinformation för Devin den 25 september
- @cognition: betaversion av Devin Mobile
- @zeddotdev: Delta 0.18
- Gemini CLI v0.63.0-nightly.20260928
- Agent API stöder nu återanvändbara agenter (Perplexity)
- Ändringslogg för Perplexitys API
- Team Bots (SpaceXAI)
- @bot: tillkännagivandet av Team Bots
- Holo4 på Hugging Face-bloggen
- Holo4 (H Company)
- SAIL (Sakana AI)
- SAIL:s projektsida
- Testning av robotik: var vi står och vad som väntar (ProjectSim)
- Hallo, Deutschland! (Mistral AI)
- Så maximerar NVIDIA DSX MaxLPS AI-fabrikers genomströmning och effektivitet
- DeepSeek Harness 0.2.0-rc.1
- Pixel Canary på Vercel AI Gateway
- Datumet för tillämpning av versionskrav för egna runners har flyttats (GitHub)
- Teknisk rapport om NexteraBERT
- Talande figurer i realtid med en videodiffusionsmodell på 22B
- SCRIBE (Adalat AI)
- JEV: 228 utvalda projekt (Eric Kang)
- @HeyGen: guide till Jev och HeyGen MCP
- Se vad fyra utvecklare skapar med Gemini 3.8 Flash (Google)
- Tre sätt som denna matbutiksägare lagar mat åt 200 gäster med Gemini (Google)
- Lenfest AI Collaborative: nästa fas (OpenAI)
- Versionsinformation för ChatGPT
- @OpenAIDevs: vinnarna i WebMCP Challenge
- Ändringslogg för ChatGPT och Codex: CVE-2026-100754