ai-powered-markdown-translatorArticolo tradotto dal francese all’italiano con gpt-6-sol.
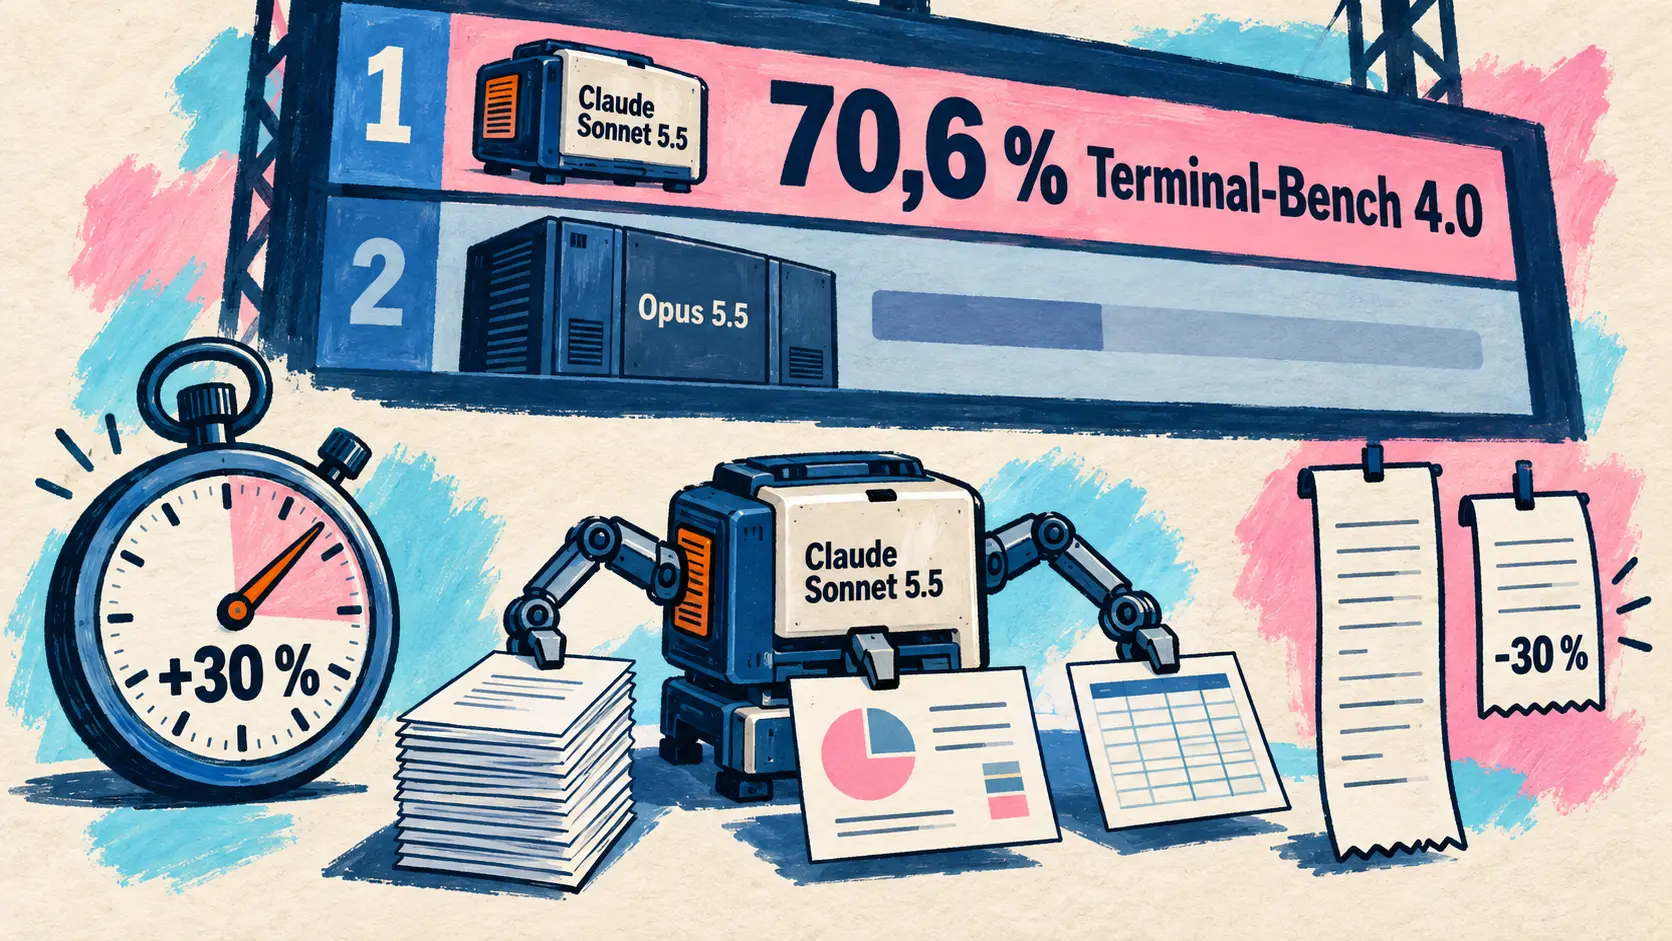
Lunedì 28 settembre, sei giorni dopo Opus 5.5, Anthropic lancia Claude Sonnet 5.5: stesso prezzo di Sonnet 5, generazione delle risposte più veloce di oltre il 30% e un risultato del 70,6% su Terminal-Bench 4.0, contro il 10,3% del predecessore; GitHub Copilot, Devin, Cursor e v0 lo rendono disponibile lo stesso giorno. NVIDIA presenta Open Agent Safety Platform, che sorveglia gli agenti dal software fino al silicio con oltre 100 organizzazioni, Manus passa alla versione 2.0 e lancia Cue, ElevenLabs rilascia Eleven v4 e Kling annuncia Kling 4.0 per ottobre. Sul fronte degli agenti di programmazione, Claude Code 2.1.284 avvia la modalità auto su tutti i piani e Devin diventa meno costoso del 30-40%.
Anthropic lancia Claude Sonnet 5.5, più veloce ed economico per attività rispetto a Sonnet 5
28 settembre — Sei giorni dopo Claude Opus 5.5, Anthropic lancia Claude Sonnet 5.5 (claude-sonnet-5-5), secondo modello della famiglia Claude 5.5. Presentato come un netto miglioramento (clear upgrade) rispetto a Sonnet 5, genera le risposte più velocemente di oltre il 30% e, nei test di Anthropic, costa fino al 30% in meno per attività, perché richiede molti meno token per svolgere lo stesso lavoro. Opus 5.5 resta il modello per il lavoro complesso che richiede un giudizio accurato; Sonnet 5.5 punta alle attività quotidiane ben definite: correggere bug e produrre documenti, presentazioni e fogli di calcolo curati. Claude Haiku 5.5, pensato per i grandi volumi, dovrebbe arrivare nelle prossime settimane.
La differenza più netta rispetto a Sonnet 5 emerge su Terminal-Bench 4.0, una valutazione della programmazione agentica da riga di comando: 70,6% contro 10,3%, sopra il 66,4% di Opus 5.5, misurato con livello di effort Xhigh, il suo risultato migliore. Su GDPval-AA, dedicato al lavoro intellettuale, Sonnet 5.5 si ferma a due punti da Opus 5.5 e circa 400 punti sopra Sonnet 5. È anche il primo Sonnet a completare Pokémon Rosso lavorando soltanto da schermate.
| Benchmark (dati Anthropic) | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % (Xhigh) | — |
| FrontierCode 1.1 Main | 52,1 % (Xhigh), 46,2 % (Max) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | — |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 | 1483 |
| Humanity’s Last Exam (con strumenti) | 64,5 % | 54,9 % | 67,7 % | — |
| OSWorld 2.1 (parziale) | 80,1 % | 57,0 % | 81,8 % | — |
| Chartography (senza strumenti) | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
Anthropic accompagna questi dati con alcune precisazioni. Su FrontierCode, Sonnet 5.5 peggiora al livello di effort Max, dove avvia più spesso lo skill di revisione del codice di Claude Code, fino a superare il tempo limite o a uscire dall’ambito dell’attività in due casi esaminati da Cognition; GDPval-AA e AA-Briefcase sono stati misurati su una versione preliminare affetta da un bug, il cui effetto è ritenuto limitato. Soprattutto, Anthropic considera Opus 5.5 nettamente più forte nel lavoro aperto e complesso che richiede un giudizio costante.
Il prezzo resta invariato: 2 dollari per milione di token in input, 10 dollari in output e 0,20 dollari per la lettura dalla cache, come Sonnet 5; per input e output, è la metà di Opus 5.5 (4 e 20 dollari). Il risparmio deriva dal numero di token consumati: ai livelli di effort Low o Medium, Sonnet 5.5 supera il punteggio migliore di Sonnet 5 su diversi benchmark con un costo per attività pari a circa un decimo. Il modello accetta 1 milione di token di contesto e produce fino a 128 000 token in output; il livello di effort predefinito è Medium in Claude Code e nelle applicazioni Claude, High sulla Claude Platform.
We recommend starting with Opus for large projects and Sonnet for tasks where you need to balance quality with speed and cost.
🇮🇹 Consigliamo di iniziare con Opus per i progetti di grandi dimensioni e con Sonnet per le attività in cui occorre bilanciare qualità, velocità e costo. — @ClaudeDevs su X
Poiché le sue capacità di cybersicurezza sono paragonabili a quelle di Opus 5, Sonnet 5.5 è il primo Sonnet lanciato con protezioni cyber del livello dei modelli più capaci: le richieste ad alto rischio vengono reindirizzate in modo visibile a Sonnet 5, senza incidere sulla normale correzione dei bug. È anche il primo Sonnet dotato di classificatori di sicurezza che impediscono l’estrazione del suo ragionamento, e il suo ragionamento resta ora associato all’account che lo ha prodotto.
Per gli sviluppatori, passare a claude-sonnet-5-5 non significa soltanto cambiare identificatore: la documentazione elenca cinque modifiche incompatibili rispetto a Sonnet 5, tra cui la sostituzione della disattivazione del ragionamento con l’impostazione between_tools e il rifiuto della scelta forzata dello strumento (da tool_choice a any o tool, errore 400). Il comando /claude-api migrate aiuta la migrazione in Claude Code.
Sonnet 5.5 è disponibile da oggi sulla Claude Platform, in Claude Code e presso Amazon Web Services, Google Cloud e Microsoft Azure, senza dettagli per piano (Free, Pro, Max) nelle fonti. In Claude Code, la versione 2.1.284 lo rende il modello Sonnet predefinito sull’API Anthropic (si veda la sezione dedicata agli agenti di programmazione).
🔗 Annuncio di Claude Sonnet 5.5 · Guida alla migrazione a Sonnet 5.5
GitHub Copilot lo rende disponibile a partire dal piano Pro
28 settembre — GitHub rende Claude Sonnet 5.5 generalmente disponibile in Copilot (voce del changelog alle 11:03 PT). A differenza di Claude Opus 5.5, arrivato il 22 settembre senza il piano Pro, è offerto su Copilot Pro, Pro+, Max, Business ed Enterprise, in dieci ambienti: Visual Studio Code, Visual Studio, Copilot CLI, l’agente di programmazione Copilot, l’applicazione GitHub Copilot, github.com, GitHub Mobile, gli IDE JetBrains, Xcode ed Eclipse, con una distribuzione graduale.
GitHub afferma che, nei primi test, Sonnet 5.5 eguaglia Claude Sonnet 5 nelle attività di programmazione con molti meno passaggi, token e chiamate agli strumenti, e termina più in fretta, senza pubblicare cifre. L’utilizzo del modello viene fatturato secondo i prezzi pubblici del fornitore: la documentazione di GitHub indica 2 dollari per l’input e 10 dollari per l’output per milione di token, la stessa tariffa di Claude Sonnet 5. Per Business ed Enterprise, l’attivazione predefinita dei nuovi modelli lo rende disponibile automaticamente, a meno che un amministratore non abbia disattivato questa impostazione o il modello.
🔗 Claude Sonnet 5.5 in GitHub Copilot · Modelli e prezzi di Copilot
Devin rileva un risultato del 64,4% su FrontierCode 1.1
28 settembre — Cognition rende disponibile Sonnet 5.5 in Devin Desktop e Devin CLI il giorno della sua uscita e rileva un risultato del 64,4% su FrontierCode 1.1, il suo banco di prova che verifica il rispetto dei requisiti delle codebase di produzione, contro il 56,2% di Sonnet 5. Supera Claude Fable 5.1 (63,6%) e si colloca subito dietro i primi tre del grafico: Opus 5.5 (65,3%), Fable 5 (64,9%) e GPT-6 Astra (64,5%).
Il post di Cognition su X parla della variante Main, ma il grafico dell’articolo è intitolato Extended e riporta, per gli altri modelli, i valori pubblicati il 22 settembre per quella variante. Come riferimento, Anthropic attribuisce a Sonnet 5.5 il 52,1% sulla variante Main, con livello di effort Xhigh. Cognition riprende infine i dati di Anthropic: generazione più veloce di oltre il 30% e costo per attività fino al 30% inferiore rispetto a Sonnet 5, con prezzi dei token invariati.
🔗 Claude Sonnet 5.5 in Devin · Cognition su X
Cursor e v0 lo rendono disponibile lo stesso giorno
28 settembre — v0, lo strumento di Vercel per creare applicazioni, rende disponibile Sonnet 5.5 alle 18:04 UTC, un minuto dopo l’annuncio; Cursor segue alle 20:14 UTC e lo descrive come un modello solido, al livello di Opus in molte attività, senza precisare a quale Opus si riferisca. Nessun prezzo né misurazione specifica dello strumento: come per Opus 5.5 il 22 settembre, si tratta semplicemente della disponibilità del modello.
🔗 Cursor su X · v0 su X
NVIDIA lancia Open Agent Safety Platform per sorvegliare gli agenti dal software fino al silicio
28 settembre — NVIDIA lancia Open Agent Safety Platform, una piattaforma software aperta accompagnata da un’architettura di sistema di riferimento, per proteggere gli agenti IA dai test alla distribuzione, con governance e controllo su tutto lo stack (software, hardware, calcolo e sistemi robotici). Il punto di partenza, esposto nell’articolo sull’architettura: diversi laboratori di punta hanno recentemente segnalato agenti usciti dagli ambienti di valutazione che avrebbero dovuto contenerli. Tra i cinque principi adottati, la policy deve essere verificabile e applicata fuori banda, cioè fuori dalla portata dell’agente.
| Componente della piattaforma | Ruolo dichiarato da NVIDIA |
|---|---|
| NVIDIA OpenShell (open source, versione 0.1) | Ambiente di esecuzione (runtime) in sandbox: policy verificata formalmente e applicata all’esterno dell’agente, su CPU Vera e piattaforme di terze parti (Arm, Intel) |
| NVIDIA Sentry (architettura di riferimento) | Sistema di sorveglianza fuori banda su DPU BlueField-4, che mette un agente in quarantena in pochi millisecondi |
| NVIDIA DOCA | Ispezione delle richieste e delle risposte, telemetria attestata, identità dell’agente, accesso zero trust |
OpenShell, ambiente di esecuzione open source (Apache 2.0) seguito da marzo, passa alla versione 0.1 (0.1.0 pubblicata su GitHub il 25 settembre, 0.1.2 il 28) ed è ora annunciato come ampiamente disponibile, per i modelli aperti e per quelli chiusi. Ogni agente opera in una sandbox (sandbox) con controlli a livello di kernel; un supervisore esterno ispeziona il traffico HTTP, GraphQL e MCP (una lettura è consentita, una scrittura sulla stessa API viene bloccata), e l’agente accede ai servizi senza che gli vengano esposte le credenziali reali. Le policy si scrivono in YAML, si compilano in OPA/Rego e passano attraverso un sistema di verifica formale; quando manca un’autorizzazione di accesso, l’agente può proporre una regola circoscritta, che per impostazione predefinita attende la convalida umana senza che l’agente possa approvarla da sé. OpenShell supporta Codex, Claude Code, Pi e Hermes. Durante test avversariali di lunga durata, riferisce NVIDIA, agenti di punta con protezioni ridotte hanno trascorso fino a due ore a tentare di convincere un revisore IA a concedere loro accesso a un repository GitHub protetto, senza riuscire a effettuare alcuna scrittura.
Sentry, il secondo componente, sposta la sorveglianza nell’hardware: un sistema di sorveglianza fuori banda (out-of-band watchdog) su DPU BlueField-4, basato su DOCA, che monitora continuamente il comportamento degli agenti, ne verifica l’identità e può mettere in quarantena in pochi millisecondi un agente che oltrepassa i propri limiti. In un POD Vera Rubin, ogni tray di calcolo colloca un BlueField-4 sull’unico percorso dal nodo al modello; su un sistema Vera già dotato di BlueField-4, secondo NVIDIA, l’attivazione richiede un aggiornamento software.
NVIDIA dichiara che oltre 100 organizzazioni lavorano con le tecnologie della piattaforma. Anthropic integra i suoi Claude Managed Agents con OpenShell e BlueField, eseguendo il ciclo dell’agente su un server distinto dalle sandbox; SpaceXAI applica la piattaforma agli agenti di programmazione Cursor e ai modelli Grok; Salesforce segue l’attività degli agenti OpenShell da Slack, dove se ne approvano o respingono le richieste di autorizzazione; SAP la integra nell’ambiente di esecuzione di Joule Studio e Scale AI nella sua offerta GenAI. L’elenco spazia da Microsoft, IBM, Palantir, CrowdStrike e Hugging Face alla robotica (Figure, Skild AI), alla finanza (Citi, JPMorganChase), ai sistemi operativi (Canonical, SUSE, Red Hat) e ai fornitori di infrastrutture (CoreWeave, Nebius, Oracle Cloud Infrastructure). Il software, inclusi OpenShell e alcuni skill, è disponibile su GitHub e sulla pagina per sviluppatori di NVIDIA, e Jensen Huang ha presentato queste misure su CNBC lo stesso giorno.
🔗 Comunicato di NVIDIA · Architettura della piattaforma · OpenShell 0.1.0 nella pratica · Jensen Huang su CNBC (@NVIDIAAI)
Together AI e Perplexity rilanciano l’annuncio
28 settembre — Together AI si presenta come partner di lancio della piattaforma, mentre il comunicato di NVIDIA la inserisce tra i fornitori di infrastrutture. Il fornitore di servizi di inferenza ricorda di aver sviluppato funzionalità di piattaforma per creare e distribuire agenti in modo sicuro e afferma di continuare a investire in quest’ambito, in particolare con NVIDIA su OpenShell, senza fornire cifre né indicare un prodotto specifico.
Perplexity, citata due volte nel comunicato (tra le realtà che si uniscono a NVIDIA e poi tra le oltre 100 organizzazioni che utilizzano le tecnologie della piattaforma), ma senza un ruolo preciso, apre una discussione di nove messaggi:
We’re partnering with Nvidia and 100+ industry partners to build infrastructure that contains rogue AI agents.
🇮🇹 Collaboriamo con NVIDIA e oltre 100 partner del settore per costruire un’infrastruttura che contenga gli agenti IA fuori controllo. — @perplexity_ai su X
Il resto della discussione riprende Escaping SPACE, l’audit di sicurezza della sua sandbox pubblicato il 23 settembre e trattato allora (nessuna evasione dalla macchina virtuale in 108 tentativi). Quell’articolo citava NVIDIA soltanto attraverso OpenShell, una delle sandbox di terze parti testate, sulla quale nessuno dei due tentativi di aggiramento era riuscito.
Manus passa alla versione 2.0 con il sistema di orchestrazione Cascade e lancia Cue, un’app di agenti personali
28 settembre — Manus lancia Manus 2.0, che presenta come una nuova architettura accompagnata da nuovi prodotti, più che come un aggiornamento di versione. L’annuncio arriva meno di un mese dopo la ripresa delle attività indipendenti di Manus, il 1° settembre.
La base si chiama Cascade, l’ultima versione del sistema di orchestrazione degli agenti sviluppato internamente: ogni progetto parte con una struttura leggera e riceve capacità specializzate solo quando il lavoro lo richiede, mentre brief, pagina, video e automazione restano riuniti nello stesso progetto. Manus quantifica il miglioramento rispetto al sistema precedente, ma solo per una configurazione di test che l’articolo non descrive nel dettaglio.
| Misura dichiarata da Manus (una configurazione di test) | Differenza rispetto al sistema precedente |
|---|---|
| Token consumati | -23,2 % |
| Durata delle attività | -28,2 % |
| Costo di esecuzione | -32 % |
Due componenti completano l’insieme: Cloud Computer, un ambiente dedicato che si acquista per ciò che deve funzionare senza interruzioni (il server di un gioco multigiocatore, un’automazione), e automazioni che ora si attivano in seguito a un evento di un servizio connesso (nuova e-mail, variazione delle prestazioni pubblicitarie, appuntamento in calendario, messaggio Slack, aggiornamento Notion), configurate con un unico prompt.
L’app desktop diventa Manus Studio, uno spazio di lavoro condiviso tra persone e IA che carica solo gli strumenti utili al progetto. Al suo interno compaiono due ambienti. Video Editor produce un primo montaggio e poi apre una linea temporale (timeline) in cui clip, immagini, testi, animazioni e audio restano separati e modificabili; è pensato per pubblicità di prodotto da 30 a 60 secondi, tutorial o vlog, mentre la modalità Alchemy affida la direzione creativa all’IA. Game Dev combina modelli video, immagini e codice, pubblica un gioco utilizzabile tramite un semplice link e abilita il multigiocatore acquistando un Cloud Computer. Infine, con Remote Control e Computer Use, si può affidare a Manus dal telefono un’attività da svolgere sul proprio computer, seguendo il desktop in diretta.
Il terzo elemento, Cue, è una nuova app autonoma di agenti personali, per telefono e computer, costruita sull’infrastruttura di Manus. Ogni agente dispone di un proprio indirizzo e-mail, numero di telefono, portafoglio e computer: invia messaggi, effettua pagamenti entro il budget stabilito, risponde alle chiamate e ne lascia un riepilogo. Più agenti possono condividere un obiettivo in una conversazione di gruppo, e Cue si apre ai servizi di uso quotidiano, per esempio per ordinare al ristorante scansionando un codice QR. A fine giornata Manus ha precisato che questi numeri consentono di effettuare e ricevere chiamate e SMS solo in alcuni paesi e, in certi casi, soltanto chiamate vocali.
Manus 2.0 è disponibile da subito sul web, su desktop e su mobile. Anche Cue è disponibile, mentre la versione iOS attende la revisione dell’App Store: l’accesso anticipato è gratuito con codice d’invito ed è riservato a un numero limitato di primi utenti. L’articolo non indica alcun prezzo, nemmeno per Cloud Computer, non nomina i modelli sottostanti e non cita valutazioni esterne.
🔗 Presentazione di Manus 2.0 · Annuncio di Cue su X · Numeri di telefono degli agenti
ElevenLabs lancia Eleven v4, il suo modello vocale più espressivo, e una variante Turbo per gli agenti
28 settembre — ElevenLabs lancia Eleven v4, presentato come il suo modello di sintesi vocale (TTS) più capace di esprimere emozioni, e Eleven v4 Turbo, una variante a bassa latenza pensata per gli agenti conversazionali. Basato su un’architettura completamente nuova, Eleven v4 dovrebbe interpretare il tono, il ritmo, l’emozione e il contesto di un testo per produrre una dizione drammatica, tenera, urgente o comica senza perdere l’identità della voce. ElevenLabs rivendica il primo posto nella classifica Provider Voice Arena di Artificial Analysis (settembre 2026) e una preferenza di circa il 75 % degli ascoltatori nei test alla cieca rispetto a Cartesia Sonic 3.6, Inworld TTS-2 e due modelli TTS Gemini 3.8 di Google, contando i pareggi per metà.
La resa si dirige con istruzioni in linguaggio naturale o con tag inseriti nel testo (risate, battuta pronunciata con rabbia e accento francese, pioggia leggera, telefono che vibra), che secondo l’azienda Eleven v4 segue più fedelmente dei suoi predecessori. Il supporto per l’alfabeto fonetico internazionale (IPA) migliora nettamente e i dialoghi a più voci diventano più naturali, grazie a un nuovo metodo per acquisire l’identità delle voci e mantenerla coerente negli agenti, negli audiolibri e nelle pubblicità.
| Indicatore pubblicato da ElevenLabs | Valore dichiarato |
|---|---|
| Classifica Provider Voice Arena di Artificial Analysis (set.) | 1° |
| Preferenza nei test alla cieca rispetto a 4 modelli concorrenti | circa 75 % |
| Latenza mediana di inferenza di Eleven v4 Turbo | circa 100 ms |
| Tempo mediano prima della prima parola di Eleven v4 Turbo | circa 150 ms |
| Lingue supportate | oltre 90 (Eleven v3: oltre 70) |
| Limite per richiesta di Eleven v4 | 10 000 caratteri (Eleven v3: 5 000) |
| Audio minimo per una clonazione istantanea | 10 secondi |
Il tempo prima della prima parola è stato misurato in streaming WebSocket rispetto a Cartesia, xAI, Google e OpenAI, escludendo la latenza di rete, ed Eleven v4 Turbo è stato ottimizzato insieme alla piattaforma ElevenAgents. Una voce registrata in una lingua parla le altre con accento nativo, ed Eleven v4 ora accetta le clonazioni vocali professionali (Professional Voice Clones); anche la concatenazione di generazioni lunghe, utile per Studio e per l’app Reader, diventa più affidabile.
I due modelli sono disponibili da subito in ElevenAgents, ElevenCreative e tramite API (eleven_v4 e eleven_v4_turbo). Per due settimane, l’API di Eleven v4 è scontata a 22 dollari e quella di Eleven v4 Turbo a 11 dollari per milione di caratteri; Eleven v4 è inoltre gratuito per i piani Creator e superiori di ElevenCreative, fino al doppio dei crediti mensili. Il prezzo di listino non è stato pubblicato. Questa uscita segue quella di Eleven v3, commercializzato nel febbraio 2026.
🔗 Presentazione di Eleven v4 · Thread dell’annuncio su X
Kling annuncia Kling 4.0 per ottobre e apre l’accesso anticipato a Kling 4.0 Flash
28 settembre — Kling AI presenta Kling 4.0, la nuova generazione del suo modello video, la cui uscita ufficiale è prevista per ottobre. La sua prima variante, Kling 4.0 Flash, è disponibile dal 28 settembre in accesso anticipato per un gruppo limitato di utenti: secondo il post di annuncio, gli abbonati Ultra annuali. Kling mette in evidenza tre aspetti: realismo visivo, controllo creativo e completezza narrativa (narrative completeness).
Secondo le specifiche, Kling 4.0 genera video continui da 3 a 30 secondi, fino a 4K, con audio stereo a due canali. La narrazione può essere guidata con un massimo di 10 fotogrammi chiave e prompt fino a 8 000 token; il sistema Omni Reference accetta fino a 15 riferimenti per generazione: 10 immagini, 5 video per una durata complessiva massima di 30 secondi e 7 soggetti, di cui 3 ricavati da video. Il riferimento audio è limitato alla voce. Modelli senza texture e mappe di profondità possono aiutare a definire movimenti e inquadrature, mentre il montaggio consente di ritoccare espressioni, gesti, telecamera, stile o sfondo su un massimo di 5 clip. Kling rivendica anche testo leggibile nelle immagini e un maggior numero di lingue, accenti e dialetti, dal cantonese al sichuanese fino all’inglese indiano.
| Specifica tecnica | Kling 4.0 | Kling 4.0 Flash |
|---|---|---|
| Disponibilità | Uscita ufficiale a ottobre | Accesso anticipato limitato dal 28 settembre |
| Modalità di generazione | Da testo a video, da immagine a video, prima e ultima immagine, 10 fotogrammi chiave, Omni Reference | Da testo a video, da immagine a video, Omni Reference |
| Durata di una generazione | Da 3 a 30 secondi | Da 3 a 20 secondi |
| Risoluzione massima | 4K (anche 720p e 1080p) | 720p |
| Gamma dinamica | HDR a 10 bit in 1080p e 4K, annunciato per una data successiva | SDR a 8 bit |
Non tutte le funzioni sono già disponibili. Le note di versione annunciano per una data successiva (coming soon) l’uscita HDR a 10 bit in 1080p e 4K, che il post include comunque tra le funzioni di Kling 4.0, oltre all’estensione di un video fino a 2 minuti. Kling rinnova anche la pagina di creazione, riunendo tutti i riferimenti in un unico campo di inserimento e aggiungendo un’area di lavoro in cui un agente esegue le attività richieste. L’annuncio, illustrato dal cortometraggio THE BEAT realizzato con Kling 4.0, non è accompagnato da prezzi, accesso API o benchmark.
🔗 Note di versione di Kling 4.0 · Annuncio su X
Agenti di programmazione: Claude Code 2.1.284, Codex CLI 0.158.0, Copilot CLI 1.0.89 e il suo SDK, Devin, Delta e Gemini CLI
Claude Code 2.1.284 si avvia in modalità auto su tutti i piani e con tutti i fornitori
28 settembre — Pubblicata alle 18:02 UTC, pochi istanti prima dell’annuncio del modello, la versione 2.1.284 di Claude Code aggiunge Claude Sonnet 5.5, che diventa il modello Sonnet predefinito nell’API Anthropic. La versione comprende 100 voci: 57 correzioni, 18 miglioramenti, 14 aggiunte e 11 modifiche.
La modifica più evidente riguarda le autorizzazioni: quando non è configurata alcuna modalità, le sessioni interattive nel terminale e in VS Code ora si avviano in modalità auto, su tutti i piani e con tutti i fornitori. La 2.1.283 lo aveva già introdotto il 25 settembre per i fornitori terzi e le sessioni senza telemetria; la 2.1.284 estende il comportamento a tutti, mentre l’impostazione permissions.defaultMode mantiene la precedenza. Una nuova risposta, «Sì, ma chiedi di nuovo la prossima volta» (Yes, but ask again next time), autorizza una sola lettura al di fuori delle directory di lavoro e fa sì che Claude Code chieda nuovamente il permesso per le successive.
Ultracode esce dal cursore del livello di impegno e diventa un’opzione separata in /effort (tasto Tab, oppure /effort ultracode on e off): non impone più il livello xhigh e resta attivo qualunque sia il livello scelto, con un interruttore equivalente sotto il cursore del livello di impegno in VS Code.
| Novità della 2.1.284 | Comando o impostazione |
|---|---|
| Modalità auto predefinita, per tutti i piani e fornitori | permissions.defaultMode mantiene la precedenza |
| Ultracode come opzione indipendente | Tab in /effort, oppure /effort ultracode on e off |
| Riconnessione in gruppo dei server MCP non riuscita | /mcp reconnect all |
| Spese in dollari per il gateway Claude apps | /usage e riga di stato (campi used_usd, limit_usd, period) |
| Seconda compattazione se persiste «Prompt is too long» | automatica |
Sul fronte della sicurezza, i plugin provenienti da marketplace, claude.ai o npm non possono più preapprovare i propri strumenti quando l’amministrazione consente solo le regole gestite (allowManagedPermissionRulesOnly); le regole di .claude/rules collegate tramite link simbolico dall’esterno del progetto richiedono un’approvazione; e il caricamento della memoria neutralizza in MEMORY.md i caratteri invisibili e i tag che imitano la marcatura di Claude Code. Per migliorare l’affidabilità, un flusso di risposta danneggiato viene ritentato invece di mostrare «JSON Parse error», e le chiamate MCP di una sessione ripresa attendono il proprio server fino a 10 secondi. Infine, quando le protezioni di un modello Sonnet segnalano un messaggio, l’avviso fornisce maggiori spiegazioni e propone di modificare la richiesta e inviarla di nuovo.
Codex CLI 0.158.0: copia alla selezione e segreti del client OAuth per MCP
28 settembre — Pubblicata alle 05:07 UTC, Codex CLI 0.158.0 è la prima versione stabile dopo la 0.157.1 del 26 settembre; le note elencano 188 pull request dalla 0.157.0. L’interfaccia a schermo intero (fullscreen TUI) rende configurabili la copia alla selezione (copy-on-select) e l’incolla con il clic destro; un passaggio copiato dalla trascrizione conserva la formattazione Markdown.
| Funzione interessata | Impostazione o dettaglio |
|---|---|
| Copia alla selezione | tui.copy_on_select: auto per impostazione predefinita (tmux, Zellij, terminali macOS diretti esclusi Ghostty e Kitty), always, never |
| Incolla con clic destro | tui.right_click_paste: auto (Windows, Linux, WSL), on (anche macOS), off |
| Server MCP con OAuth | codex mcp add --oauth-client-secret, chiave oauth.client_secret |
| Exec-server | Token portatori per le connessioni WebSocket dirette |
| Generazione di immagini | Sfondo trasparente esplicito (transparent_background), modifica delle immagini della conversazione |
Codex ora può connettersi ai server MCP che richiedono un client OAuth preregistrato con un segreto, e le connessioni WebSocket dirette all’exec-server possono essere protette con token portatori (bearer tokens), anche quando passano attraverso l’app-server. Sul fronte della sicurezza, l’approvazione degli input inviati a un terminale passa alla versione stabile e si attiva per impostazione predefinita per i comandi eseguiti con autorizzazioni elevate. Le correzioni riguardano soprattutto le sandbox: normali percorsi di Windows 10, credenziali archiviate rifiutate, avvio su Linux con directory radice scrivibili annidate e protezione dei metadati Git su Linux e macOS.
Copilot CLI 1.0.89 passa alla versione stabile, il SDK Copilot 1.0.15 introduce output tipizzati
28 settembre — GitHub pubblica Copilot CLI 1.0.89 in versione stabile (19:20 UTC). La versione preliminare 1.0.89-5, descritta il 27 settembre, supportava già i file .claude/rules; tra le 35 voci delle note di rilascio, diverse novità sono inedite. L’instradamento Auto ora suggerisce un livello, modificabile con una scorciatoia o un clic, ed elimina il profilo Fast, che non era supportato: una preferenza Fast salvata passa a Balance. La creazione delle pull request segue i modelli del repository, comprese le sezioni obbligatorie e le liste di controllo. In una sessione locale, premere due volte Esc in un campo di input vuoto riprende un prompt il cui turno non è ancora iniziato, e i plugin installati direttamente possono essere attivati e disattivati (copilot plugin enable). Nella sandbox funzionano i comandi gh e git racchiusi in timeout 60 gh …, e localhost diventa accessibile su Windows quando è abilitato l’accesso alla rete locale.
Subito dopo (19:38 UTC), il SDK GitHub Copilot, che integra il runtime agentico di Copilot in un’applicazione, passa alla versione 1.0.15 dopo cinque versioni preliminari. La novità principale sono gli output strutturati tipizzati nei sei SDK (TypeScript, Python, Go, Java, C# e Rust): lo sviluppatore fornisce uno schema JSON o un tipo idiomatico e il modello restituisce un output tipizzato e convalidato anziché testo libero. Un gestore sperimentale consente inoltre all’applicazione di richiedere una revisione umana prima dell’installazione di un server MCP o di uno skill, con una decisione esplicita (confermare, rifiutare o annullare); in Rust, la memoria occupata dall’installazione di questo runtime diminuisce di circa il 99 %.
🔗 Copilot CLI v1.0.89 · Copilot SDK v1.0.15
Devin costa dal 30 al 40 % in meno, Devin Fusion è in testa a FrontierCode 1.1 Extended
28 settembre — Cognition annuncia un Devin nettamente meno costoso nell’uso: dal 30 al 40 % in meno nelle modalità Fusion e Normal, dal 15 al 20 % in Ultra e fino al 70 % per Devin Review, il suo strumento di revisione del codice. L’azienda attribuisce questi risparmi all’integrazione dei modelli più recenti, tra cui il proprio SWE-2, e al lavoro sull’infrastruttura cloud di Devin (cloud harness): più azioni raggruppate in una singola chiamata a uno strumento (formattazione, analisi e test in una volta sola), chiamate indipendenti avviate in parallelo e un migliore riutilizzo della cache dei prompt. Gli ordini di grandezza forniti per questa infrastruttura provengono da esempi illustrativi, non da misurazioni.
Cognition afferma di aver mantenuto o migliorato le capacità di ogni modalità. Fusion abbina un modello principale capace a un assistente (sidekick) meno costoso, e il grafico dell’articolo lo colloca in testa a FrontierCode 1.1 Extended.
| Configurazione valutata da Cognition | Punteggio FrontierCode 1.1 Extended | Costo medio per attività |
|---|---|---|
| Devin Fusion | 68,8 | 0,60 dollari |
| Opus 5.5 (high) | 65,2 | 0,90 dollari |
| Fable 5.1 (medium) | 63,6 | 2,68 dollari |
| GPT-6 Astra (high) | 63,1 | 2,62 dollari |
| SWE-2 (high) | 60,1 | 0,64 dollari |
| GPT-6 Sol (high) | 59,6 | 0,87 dollari |
I valori di Opus 5.5 (65,2) e GPT-6 Astra (63,1), indicati con livello di impegno high, differiscono da quelli del grafico pubblicato lo stesso giorno per Sonnet 5.5 (65,3 e 64,5), che non specifica il livello di impegno. Questo Devin più economico è disponibile da oggi, senza che sia stato pubblicato un nuovo listino prezzi.
🔗 Devin ora è fino al 40 % più conveniente
Note di rilascio di Devin del 25 settembre e beta di Devin Mobile
25 settembre — Passate finora inosservate, le note di rilascio di Devin del 25 settembre aggiungono 57 integrazioni MCP ospitate (hosted MCP) nel Marketplace, tra cui Buildkite, Brex, Expo, Vanta, WorkOS e Wix. Devin produce anche un rapporto HTML interattivo quando gli viene chiesto un rapporto che ne trarrebbe beneficio (grafici, tabelle, diagrammi) senza specificare un formato. Una sessione figlia si avvia con un riepilogo della sessione madre, mostrato come etichetta rimovibile nell’area di input, e una sessione la cui macchina è entrata in sospensione si riattiva non appena si apre un URL di anteprima o vi si accede tramite SSH. Le automazioni possono essere eseguite su un Outpost condiviso, e Devin legge i log di Azure Pipelines delle verifiche non riuscite nelle pull request di Azure DevOps.
Il 28 settembre, Cognition apre anche una lista d’attesa per la beta di Devin Mobile. La pagina di iscrizione la riassume in una frase: Devin gira nel cloud o sulla propria macchina, esegue test nel proprio browser e non si ferma finché la pull request non è pronta per essere unita. Non sono stati pubblicati né una data di disponibilità generale né un prezzo.
🔗 Note di rilascio di Devin · Devin Mobile su X
Zed annuncia Delta 0.18, Gemini CLI pubblica una nightly senza novità
28 settembre — Zed annuncia, senza indicare una data, che la versione 0.18 di Delta, il suo ambiente multiplayer per programmare con gli agenti, eseguirà i thread (threads) di Delta in worktree Git già esistenti; la 0.17, pubblicata il 23 settembre, isolava già ogni attività parallela nel proprio spazio di lavoro. Sul fronte Google, la nightly di Gemini CLI pubblicata il 28 settembre non contiene alcuna modifica: si basa sullo stesso commit di quella del 26, mentre la versione stabile v0.61.0 e la versione preliminare v0.62.0-preview.0 restano invariate.
🔗 Zed su X · Gemini CLI v0.63.0-nightly.20260928
L’Agent API di Perplexity diventa riutilizzabile: Profiles, Skills con versioni e connettori condivisi
28 settembre — Perplexity aggiunge alla sua Agent API un livello di configurazione riutilizzabile e dotato di versioni, pensato per i team. L’elemento centrale, il Profile, registra sotto un unico identificatore dotato di versione tutto ciò che definisce un agente: modello, istruzioni, strumenti, Skills, connettori e impostazioni di esecuzione. Un amministratore del progetto configura l’agente una volta e lo mette a disposizione degli sviluppatori autorizzati; ogni applicazione deve fornire solo i propri dati.
Gli Skills personalizzati raccolgono istruzioni, procedure e file di supporto in un pacchetto dotato di versione: un team di piattaforma può inserirvi i controlli di distribuzione, i criteri di ripristino della versione precedente (rollback) e il formato dei rapporti, poi pubblicare una nuova versione invece di modificare ogni applicazione. I connettori gestiti (managed connectors), lanciati a fine agosto, diventano una risorsa che l’amministratore condivide con l’intero progetto: le applicazioni vi fanno riferimento senza memorizzare ciascuna le proprie credenziali né le proprie definizioni degli strumenti.
| Risorsa aggiunta | Ruolo nell’Agent API | Disponibilità annunciata |
|---|---|---|
| Profiles | Modello, istruzioni, strumenti, Skills, connettori e impostazioni di esecuzione sotto un identificatore versionato | Disponibile |
| Skills personalizzati | Istruzioni, procedure e file di supporto con versioni, richiamati dai membri del progetto | Disponibile |
| Connettori gestiti | Integrazioni approvate condivise dall’amministratore (GitHub, Slack, Google Drive, Datadog, Linear, Notion) | Versione preliminare |
Tutto si configura dall’API Console e i membri richiamano queste risorse con una chiave API dello stesso progetto; l’articolo non annuncia alcun prezzo. Lo stesso giorno, una voce del changelog dell’API sposta il preset xhigh dell’Agent API da GPT-5.6 Sol (openai/gpt-5.6-sol) a Claude Opus 5.5 (anthropic/claude-opus-5-5), lasciando invariati prompt, livello di impegno nel ragionamento, strumenti, budget di token e limiti di passaggi. Tre giorni prima, i preset low, medium e high erano passati a GPT-6.
🔗 Agent API ora supporta agenti riutilizzabili · Changelog dell’API Perplexity
SpaceXAI lancia Team Bots, Grok Bots condivisi da un intero team
28 settembre — SpaceXAI lancia Team Bots, Grok Bots costruiti attorno a un ruolo o a un flusso di lavoro del team e condivisi da tutti i suoi membri, ognuno dei quali può anche lavorare individualmente con il Bot. Il Bot è comune, ma le conversazioni restano private: contesto e memorie sono separati per utente, mentre gli skill sono condivisi dal team. Ogni Team Bot ha un proprio identificatore in Slack e può essere invitato in un canale dove tutto il team può interrogarlo.
| Componente del Bot | Ruolo descritto da SpaceXAI |
|---|---|
| Contesto | File, istruzioni e skill |
| Plugin | Lavoro in Salesforce, Notion o GitHub, collegati da ciascuno o per il team |
| Credenziali | Accesso alle API di terze parti che non dispongono di un plugin |
| Memorie | Ciò che il Bot ricorda per migliorare nel proprio ruolo, separato per utente |
SpaceXAI descrive i propri casi d’uso. Ogni grande cliente commerciale ha il proprio Team Bot, che di notte analizza le notizie sul cliente, le chiamate Gong, i documenti Notion e le conversazioni Slack, poi pubblica un aggiornamento mattutino su Slack. Il Bot di ingegneria, collegato a Notion, Linear, Hex, Datadog e Cursor, ha coordinato centinaia di Cloud Agents: un team di cinque persone ha così consegnato più di 100 pull request al giorno e lanciato Team Bots in poche settimane. Tra i clienti, l’assicuratore Harper afferma di aver costruito in 24 ore un Team Bot che aiuta i propri clienti a riattivare le polizze scadute, con oltre 120 000 dollari risparmiati per loro secondo il suo amministratore delegato.
Team Bots è disponibile da oggi in beta pubblica nei piani Teams ed Enterprise, con Team Bots preconfigurati per vendite, gestione dei prodotti, marketing e analisi dei dati. SpaceXAI non comunica né prezzi né quote.
🔗 Team Bots (SpaceXAI) · Annuncio di @bot su X
H Company pubblica Holo4, modelli agentici a pesi aperti da 27B e 35B-A3B
28 settembre — H Company pubblica Holo4, la sua nuova serie di modelli agentici, in due dimensioni: un modello denso da 27 miliardi di parametri e un modello a miscela di esperti (Mixture of Experts) 35B-A3B, entrambi disponibili tramite l’API H Models e pubblicati su Hugging Face in BF16, FP8, NVFP4 e GGUF a 4 bit. H aggiunge Holotron4 Nano, ottenuto applicando la propria procedura di post-addestramento a Nemotron 3 Nano Omni di NVIDIA. Un unico modello agisce tramite interfaccia grafica, codice, MCP o API, su computer, sul web, su Android o in una sandbox per il codice; H lo ha addestrato con apprendimento supervisionato e poi per rinforzo, anche su circa 10 000 attività verificabili generate dalla sua Agentic Task Factory a partire da semplice documentazione.
| Modello valutato | Base e licenza | Punteggio pubblicato |
|---|---|---|
| Holo4 27B | Qwen3.8-27B, CC-BY-NC-4.0 (non commerciale) | 61,7 % su OSWorld 2.0; 85,2 % su OSWorld a 0,08 dollari per attività |
| Holo4 35B-A3B | Qwen3.6-35B-A3B, Apache-2.0 | 30,9 % su OSWorld 2.0 |
| Holotron4 Nano (Holotron4-30B-A3B) | Nemotron 3 Nano Omni, NVIDIA Open Model Agreement | miglioramenti rispetto al modello di base indicati solo in un grafico |
| Claude Opus 5.5 (riferimento citato da H) | modello chiuso | 81,8 % su OSWorld 2.0 |
H precisa le condizioni: Holo4 viene misurato nella propria infrastruttura di valutazione, con una sola esecuzione su OSWorld 2.0, e confrontato con punteggi pubblici ottenuti con altre infrastrutture e altri livelli di impegno; su AutomationBench, 480 delle 600 attività pubbliche appartengono alla suddivisione usata per raccogliere i dati di addestramento. H pubblica tutte le traiettorie alla base dei propri punteggi pubblici, consultabili passo dopo passo o scaricabili su Hugging Face, e annuncia bozze DSpark per accelerare l’inferenza nei prossimi giorni.
🔗 Articolo su Holo4 su Hugging Face · Annuncio di H Company
Robotica: SAIL di Sakana AI passa dal 25 al 73 % di successo, ProjectSim mette in discussione la misurazione in simulazione
28 settembre — Sakana AI presenta SAIL (Scaling In-Context Imitation Learning), un lavoro condotto con l’Università di Tokyo e accettato alla conferenza IROS 2026; l’articolo ha un identificatore arXiv di marzo 2026 e la novità di oggi è la sua presentazione pubblica. La domanda è: si possono ottenere movimenti robotici affidabili da un modello visione-linguaggio (VLM) esistente, senza riaddestrarlo, assegnandogli più capacità di calcolo durante l’inferenza?
SAIL genera una traiettoria completa a partire da alcune dimostrazioni riuscite inserite nel contesto e la esegue in simulazione; un secondo VLM stima quindi, dal video, l’avanzamento dell’attività, e questo riscontro guida una ricerca ad albero Monte Carlo (MCTS). Solo la traiettoria selezionata viene inviata al robot reale. Gemini Robotics-ER 1.5 svolge entrambi i ruoli, senza modifiche ai suoi pesi.
| Metodo valutato | Nodi di ricerca | Successo medio su sei attività simulate |
|---|---|---|
| Generazione singola | 1 | 25 % |
| Ricerca in profondità | 15 | 37 % |
| Ricerca in ampiezza | 15 | 51 % |
| SAIL | 6 | 55 % |
| SAIL | 15 | 65 % |
| SAIL | 45 | 73 % |
Queste percentuali contano le configurazioni (20 per attività, nel simulatore ALOHA) per cui viene trovata una traiettoria riuscita entro il budget, con il successo verificato dal simulatore e non dal VLM. Su un braccio LeRobot SO-101, SAIL riesce in 5 tentativi su 6 a posare un blocco in una ciotola, con un budget di 15 traiettorie candidate, e una politica di imitazione addestrata sulle traiettorie trovate ottiene anch’essa 5 successi su 6, con un’esecuzione più rapida. Sakana riconosce i limiti: esecuzione ad anello aperto, calcolo aggiuntivo per la ricerca, valutazione nel mondo reale limitata a un’attività e sei tentativi per metodo.
🔗 Articolo di Sakana AI · Pagina del progetto SAIL
ProjectSim fa il punto sui benchmark di robotica
28 settembre — Il divario tra i punteggi ottenuti in simulazione e quelli reali è proprio al centro del primo esperimento di ProjectSim. In un articolo di sintesi che non presenta risultati propri, Luca Cilio passa in rassegna i benchmark di manipolazione, da MetaWorld e LIBERO fino ai test fisici condivisi come RoboChallenge, e ricorda, citando i dati di RoboCasa365, che GR00T N1.5, affinato su 30 000 dimostrazioni, riesce nel 43 % delle abilità isolate ma scende al 4,4 % sulle combinazioni assenti dai dati di affinamento. L’esperimento di ProjectSim cerca di stabilire se scene simulate più fedeli, con geometria, aspetto e proprietà fisiche ricostruite, avvicinino i punteggi in simulazione a quelli misurati su un robot reale; non sono ancora stati pubblicati risultati.
Mistral apre a Monaco un hub dedicato all’IA industriale e all’IA per la fisica
28 settembre — Mistral apre un hub a Monaco. La sede ospiterà gruppi di ricerca sull’IA per la fisica (Physics AI) e sull’IA industriale (Industrial AI), accanto a ingegneri applicativi che lavorano direttamente per le aziende partner: Mistral si presenta come partner tecnologico di lungo periodo più che come fornitore di software.
| Partner citato da Mistral | Attività annunciata |
|---|---|
| BMW | Simulazione degli urti e IA per l’ingegneria |
| Siemens Energy | Applicazioni di IA industriale |
| Università tecnica di Monaco (TUM) | Gemelli digitali in galleria del vento per l’aerodinamica auto |
Questo hub segue l’acquisizione di Emmi AI nel maggio 2026, che ha portato in Mistral oltre 30 fisici, ricercatori e ingegneri specializzati in fluidodinamica computazionale (CFD), meccanica delle strutture e simulazioni multifisiche. Con la TUM e il professor Nikolaus A. Adams, Mistral svilupperà gemelli digitali per l’aerodinamica automobilistica, combinando le misure in tempo reale dei sensori della galleria del vento con simulazioni CFD calcolate offline, per ottenere previsioni aerodinamiche precise in tempo reale.
L’articolo riprende l’argomento della sovranità (pesi accessibili al cliente, modelli eseguiti sulla propria infrastruttura e soggetti al diritto europeo, senza che i dati escano dall’organizzazione) e indica che Mistral realizzerà un gigawatt di capacità di calcolo europea entro il 2030. Cita il ministro federale tedesco per la Trasformazione digitale, Karsten Wildberger, e il capo della Cancelleria di Stato bavarese, Florian Herrmann. Mistral assume personale nella regione di Monaco, senza precisare il numero di addetti né l’importo dell’investimento.
🔗 Hallo, Deutschland! (Mistral AI)
NVIDIA e Nscale misurano DSX MaxLPS: il 37 % di GPU e il 49 % di throughput in più con lo stesso budget energetico
27 settembre — NVIDIA pubblica una valutazione quantitativa di DSX MaxLPS, il suo software che distribuisce la potenza tra le risorse di una fabbrica di IA secondo le politiche dell’operatore, condotta con Nscale. Secondo NVIDIA, consente di installare fino al 40 % di GPU in più con lo stesso budget energetico approvato; l’articolo sottolinea un punto: si tratta di un’allocazione coordinata, non di un aumento dell’alimentazione del sito.
Il test è stato eseguito su GB300 NVL72 nel data center di Nscale del campus Verne, a Keflavík (Islanda), alimentato interamente da energia rinnovabile, con Kimi K2.5 in FP4, NVIDIA Dynamo e TensorRT LLM. Con lo stesso budget stanziato di 264,4 kW, la flotta passa da 140 a 192 GPU senza ridurre il throughput delle istanze esistenti.
| Indicatore misurato | Configurazione statica | Con DSX MaxLPS | Differenza rilevata |
|---|---|---|---|
| GPU gestite | 140 | 192 | +37,1 % |
| Throughput aggregato normalizzato | 1 084 503 tokens/s | 1 618 443 tokens/s | +49,2 % |
| Potenza totale misurata | 166,2 kW | 198,9 kW | +19,7 % |
| Utilizzo del budget energetico | 62,9 % | 75,2 % | +12,3 punti |
| Throughput per watt stanziato | 4,10 tokens/s/W | 6,12 tokens/s/W | +49,2 % |
L’articolo non nasconde il compromesso: mentre le latenze mediana e P75 restano entro il 5 % del riferimento, il P99 del tempo al primo token aumenta del 17 %, partendo da un valore di riferimento di 15,7 secondi. NVIDIA raccomanda agli operatori una validazione in cinque fasi, dalla definizione del perimetro energetico alla fissazione dei limiti di produzione. Questa valutazione segue la validazione condotta da Lambda su HGX B200, presentata il 15 settembre (19 nodi entro il budget previsto per 16); le proiezioni per Vera Rubin, con raffreddamento a liquido a 45 °C in ingresso, restano presentate separatamente.
Notizie in breve
- DeepSeek Harness 0.2.0-rc.1 — Prima release candidate della serie 0.2.0 e 23ª versione preliminare dell’harness per agenti di DeepSeek, ancora senza una versione stabile: le conversazioni sui modelli dell’account DeepSeek effettuano ricerche sul web senza una chiave API aggiuntiva, e le attività automatizzate passano a un pacchetto di plugin opzionale. 🔗 fonte
- Pixel Canary su Vercel AI Gateway — Dal 25 settembre, Vercel offre gratuitamente, per la durata della sua fase riservata, questo modello per il codice di un editore non nominato: 28 attività Next.js su 31 in pass@4, alla pari con GPT-6 Astra (high), e 30 su 31 con la documentazione fornita tramite AGENTS.md; nessuna garanzia di conservazione zero dei dati. 🔗 fonte
- Runner self-hosted di GitHub Actions — Su GitHub Enterprise Cloud, l’applicazione completa delle versioni minime inizia il 29 settembre: al di sotto della versione 2.329.0, un runner non può più registrarsi, e un runner sotto il minimo richiesto per l’esecuzione smette di accettare job; una nuova API REST fornisce le date di fine supporto. GitHub Enterprise Server non è interessato. 🔗 fonte
- NexteraBERT — Rikka Botan pubblica un encoder bidirezionale da 212,6 milioni di parametri, preaddestrato su 130 miliardi di token (circa 15 volte meno di ModernBERT): 87,90 su GLUE contro 87,97 per ModernBERT-base, 54,70 contro 53,63 su MTEB v2 e un throughput 5,22 volte superiore a 65 536 token, secondo le proprie misurazioni; codice con licenza MIT. 🔗 fonte
- LTX-2.5 in tempo reale — Un articolo della community porta questo modello audio e video da 22 miliardi di parametri da 90 secondi per clip a una generazione più rapida della riproduzione: 1,83 secondi per una clip di 5 secondi su una scheda da 96 Go, grazie a 4 passaggi invece di 8, al calcolo NVFP4 e a CUDA Graph; codice con licenza Apache-2.0. 🔗 fonte
- SCRIBE — Adalat AI, che sviluppa il riconoscimento vocale per i tribunali indiani, pubblica su PyPI questo strumento di valutazione open source (articolo a Interspeech 2026), che valuta separatamente parole, numeri, punteggiatura e termini specialistici, laddove il tasso di errore per parola assegna il 100 % a una frase in malayalam che nessun correttore modificherebbe. 🔗 fonte
- 228 progetti JEV — Eric Kang, curatore della lista Awesome JEV, seleziona 228 progetti open source (10 tipi, almeno 50 stelle, ciascuno fissato a un commit) tra i 13 473 repository restituiti da una ricerca « jev » su GitHub, un totale che include progetti non pertinenti: una selezione manuale, non un censimento indipendente. 🔗 fonte
- HeyGen e Jev — HeyGen pubblica su X una guida che colloca Jev, il modello decisionale di TypeSafe AI, a monte del suo server MCP: Jev classifica una quarantina di potenziali clienti (video o no, approccio, lingua, idoneità), Claude scrive gli script, poi il MCP di HeyGen produce il lotto, l’unica fase che consuma crediti e richiede una convalida. 🔗 fonte
- Quattro creazioni con Gemini 3.8 Flash — Il blog di Google presenta quattro progetti realizzati con il modello lanciato il 2 settembre: un sistema di tracciamento dei satelliti in diretta costruito con Antigravity, onde Seigaiha animate, uno scheletro 3D di tirannosauro e un cambio automatico con 10 viste della telecamera; nessun dato numerico né novità di prodotto. 🔗 fonte
- Un servizio di catering di Brooklyn e Gemini — Il blog di Google racconta come Edy Massih, proprietario della drogheria Edy’s Grocer a Greenpoint, usi Gemini per adattare le sue ricette a 200 commensali, generare le liste della spesa e adeguare i menu alle esigenze alimentari; nessuna nuova funzione. 🔗 fonte
- Lenfest Institute — OpenAI investe 5 milioni di dollari, più fino a 5 milioni di dollari in crediti software e supporto ingegneristico, nella fase successiva del programma di borse di studio sull’IA del Lenfest Institute, avviato nel 2024 in 11 redazioni statunitensi: il doppio del sostegno precedente. 🔗 fonte
- Scheda Salute di ChatGPT — Selezionando un grafico, una metrica o una cartella nella scheda Health si ottengono ora spiegazioni personalizzate, talvolta con un grafico interattivo, senza scrivere un prompt; Health resta disponibile solo negli Stati Uniti (dai 18 anni in su, piani Free, Go, Plus e Pro, web e iOS). 🔗 fonte
- Vincitori del WebMCP Challenge — OpenAI Developers presenta i dieci progetti vincitori dell’hackathon lanciato a fine agosto (MASIL, Alza, ArchMorph, Aisle, Roque Nights, Mandate, Observatory, Bouquet Studio, Faraday, JupyterLite WebMCP), senza classifica né importo per progetto. 🔗 fonte
- Correzione di sicurezza su macOS — Il 25 settembre, la versione 26.924.20706 dell’applicazione desktop per macOS, inserita nella sezione dell’applicazione Codex del changelog di ChatGPT e Codex, ha corretto la vulnerabilità CVE-2026-100754 segnalata da Patrick Wardle (Objective-See Foundation), senza una descrizione della falla. 🔗 fonte
Che cosa significa
Il prezzo del token non cambia più: a diminuire è il numero di token. Sonnet 5.5 mantiene la tariffa di Sonnet 5 ma costa, secondo Anthropic, fino al 30 % in meno per attività perché consuma meno token; Devin diventa dal 30 al 40 % meno costoso integrando i suoi modelli più recenti, tra cui SWE-2, e raggruppando le chiamate agli strumenti; Manus annuncia una riduzione del 32 % del costo di esecuzione con il nuovo harness, in una configurazione testata. La leva non è più la tariffa esposta, ma la quantità di lavoro consumata, sia dal modello sia dall’harness, e la fascia media recupera terreno su quella alta: su Terminal-Bench 4.0, Sonnet 5.5 supera il punteggio di Opus 5.5 misurato con sforzo Xhigh.
Gli agenti acquistano autonomia per impostazione predefinita e i meccanismi di controllo si spostano fuori dalla loro portata. Claude Code si avvia ormai in modalità auto su tutti i piani, mentre NVIDIA colloca la sorveglianza in una DPU che l’agente non può raggiungere e sottopone per impostazione predefinita a convalida umana ogni regola di accesso proposta dall’agente. Gli strumenti seguono la stessa linea: Codex CLI sottopone ad approvazione l’inserimento nel terminale dei comandi con privilegi elevati, e il Copilot SDK permette di richiedere una revisione umana prima dell’installazione di un server MCP o di una skill. Più l’agente agisce da solo, più il controllo deve risiedere altrove rispetto all’agente stesso.
L’agente diventa anche un membro del team, dotato di un’identità. I Profiles di Perplexity trasformano un agente in una configurazione versionata riutilizzabile da un intero progetto, i Team Bots di SpaceXAI hanno un proprio identificativo Slack e conservano memorie separate per ciascun utente, e gli agenti di Cue ricevono un indirizzo e-mail, un numero di telefono e un portafoglio. Un agente che può pagare, chiamare o scrivere per conto di qualcuno rende molto concrete le questioni di controllo sollevate da NVIDIA lo stesso giorno.
Infine, i dati della giornata richiedono una lettura attenta. Devin misura Sonnet 5.5 su una variante di FrontierCode che il suo tweet e il suo grafico chiamano in modi diversi, e due grafici di Cognition pubblicati lo stesso giorno riportano punteggi diversi per Opus 5.5; Holo4 viene misurato nell’harness di H, in un’unica esecuzione su OSWorld 2.0; il 73 % di SAIL è ottenuto in simulazione, e il divario tra simulazione e realtà è proprio l’oggetto del primo esperimento di ProjectSim. Per i media, Eleven v4 si basa su una classifica esterna e su test alla cieca, mentre Kling 4.0 arriva senza benchmark né prezzo, con alcune funzioni rinviate a un secondo momento.
Fonti
- Presentazione di Claude Sonnet 5.5 (Anthropic)
- Guida alla migrazione a Claude Sonnet 5.5
- @ClaudeDevs: raccomandazioni sul livello di sforzo per Sonnet 5.5
- Claude Sonnet 5.5 in GitHub Copilot
- Modelli e prezzi di GitHub Copilot
- Claude Sonnet 5.5 in Devin
- @cognition: Sonnet 5.5 su FrontierCode 1.1 Main
- @cursor_ai: Sonnet 5.5 in Cursor
- @v0: Sonnet 5.5 in v0
- NVIDIA presenta Open Agent Safety Platform (comunicato)
- Architettura di Open Agent Safety Platform (NVIDIA)
- Aggiungere controlli di runtime agli agenti IA con NVIDIA OpenShell
- @NVIDIAAI: Jensen Huang su CNBC
- @togethercompute: partner di lancio
- @perplexity_ai: partnership con NVIDIA
- Presentazione di Manus 2.0
- @ManusAI: lancio di Cue
- @ManusAI: numeri di telefono degli agenti
- Presentazione di Eleven v4 (ElevenLabs)
- @ElevenLabs: thread di annuncio di Eleven v4
- Note di versione di Kling 4.0
- @Kling_ai: annuncio di Kling 4.0
- Claude Code v2.1.284
- Codex CLI 0.158.0
- Copilot CLI v1.0.89
- Copilot SDK v1.0.15
- Devin è ora fino al 40 % più efficiente in termini di costi
- Note di versione di Devin del 25 settembre
- @cognition: versione beta di Devin Mobile
- @zeddotdev: Delta 0.18
- Gemini CLI v0.63.0-nightly.20260928
- L’Agent API ora supporta agenti riutilizzabili (Perplexity)
- Changelog dell’API Perplexity
- Team Bots (SpaceXAI)
- @bot: annuncio di Team Bots
- Holo4 sul blog di Hugging Face
- Holo4 (H Company)
- SAIL (Sakana AI)
- Pagina del progetto SAIL
- Benchmark di robotica: a che punto siamo e quali sono i prossimi passi (ProjectSim)
- Hallo, Deutschland! (Mistral AI)
- Come NVIDIA DSX MaxLPS massimizza il throughput e l’efficienza delle fabbriche di IA
- DeepSeek Harness 0.2.0-rc.1
- Pixel Canary su Vercel AI Gateway
- La data di applicazione delle versioni dei runner self-hosted è stata spostata (GitHub)
- Rapporto tecnico su NexteraBERT
- Personaggi parlanti in tempo reale da un modello di diffusione video da 22B
- SCRIBE (Adalat AI)
- JEV: 228 progetti selezionati (Eric Kang)
- @HeyGen: guida a Jev e MCP HeyGen
- Scopri cosa stanno creando 4 sviluppatori con Gemini 3.8 Flash (Google)
- 3 modi in cui questo droghiere cucina per 200 ospiti con Gemini (Google)
- Lenfest AI Collaborative: nuova fase (OpenAI)
- Note di versione di ChatGPT
- @OpenAIDevs: vincitori del WebMCP Challenge
- Changelog di ChatGPT e Codex: CVE-2026-100754