ai-powered-markdown-translatorgpt-6-sol로 프랑스어에서 한국어로 번역한 기사.
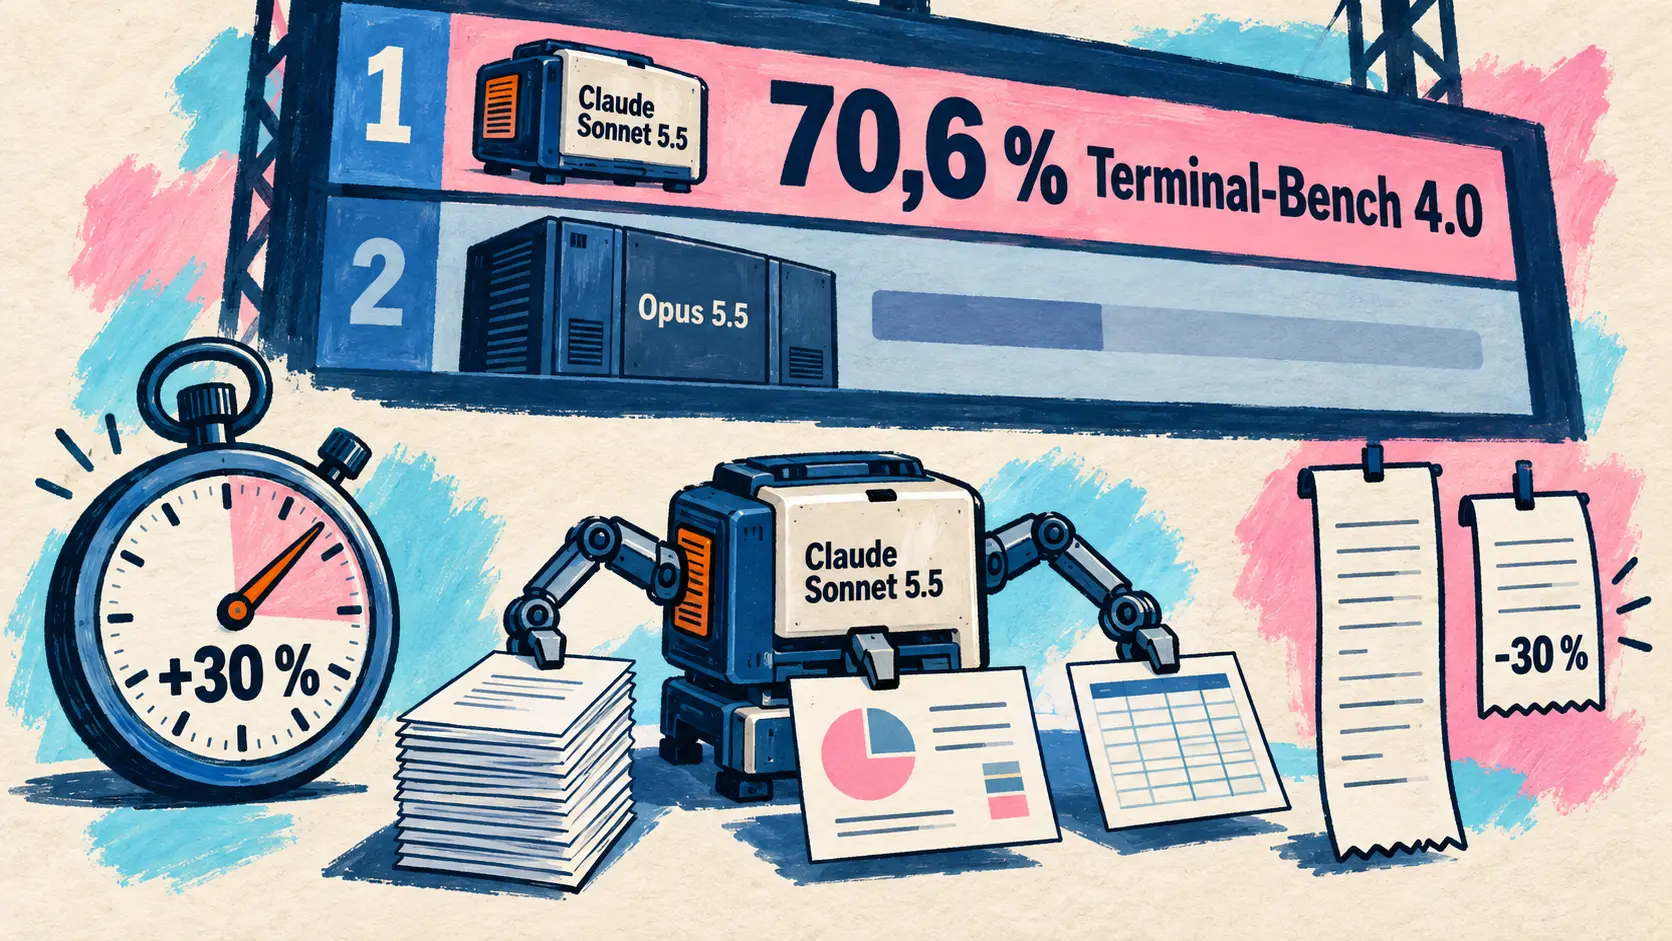
9월 28일 월요일, Opus 5.5 출시 6일 만에 Anthropic가 Claude Sonnet 5.5를 출시했다. 가격은 Sonnet 5와 같지만 생성 속도는 30% 이상 빠르고, Terminal-Bench 4.0 점수는 이전 모델의 10.3%에서 70.6%로 올랐다. GitHub Copilot, Devin, Cursor, v0도 같은 날 이 모델을 제공하기 시작했다. NVIDIA는 100곳이 넘는 조직과 함께 소프트웨어부터 실리콘까지 에이전트를 감시하는 Open Agent Safety Platform을 공개했고, Manus는 2.0으로 전환하며 Cue를 출시했다. ElevenLabs는 Eleven v4를 내놓았고 Kling은 10월 출시 예정인 Kling 4.0을 발표했다. 코드 에이전트 분야에서는 Claude Code 2.1.284가 모든 요금제에서 자동 모드로 시작하며, Devin의 가격은 30~40% 낮아졌다.
Anthropic, Sonnet 5보다 빠르고 작업당 비용이 낮은 Claude Sonnet 5.5 출시
9월 28일 — Claude Opus 5.5 출시 6일 만에 Anthropic가 Claude 5.5 제품군의 두 번째 모델인 Claude Sonnet 5.5(claude-sonnet-5-5)를 출시했다. Sonnet 5보다 확연히 개선된 모델로 소개된 이 모델은 응답 생성 속도가 30% 이상 빠르다. Anthropic의 테스트에서는 같은 작업에 필요한 토큰이 훨씬 적어 작업당 비용이 최대 30% 낮았다. Opus 5.5는 신중한 판단이 필요한 복잡한 작업용 모델로 남고, Sonnet 5.5는 버그 수정과 완성도 높은 문서·프레젠테이션·스프레드시트 작성처럼 범위가 명확한 일상 업무를 겨냥한다. 대량 작업을 위해 설계된 Claude Haiku 5.5는 앞으로 몇 주 안에 뒤따를 예정이다.
Sonnet 5와의 차이가 가장 뚜렷한 곳은 명령줄 기반 에이전트 프로그래밍 평가인 Terminal-Bench 4.0이다. Sonnet 5.5는 70.6%를 기록해 Sonnet 5의 10.3%를 크게 앞섰으며, Opus 5.5가 Xhigh 노력 수준에서 기록한 최고 점수 66.4%도 넘었다. 지식 노동을 평가하는 GDPval-AA에서는 Opus 5.5에 2점 뒤졌고 Sonnet 5보다 약 400점 높았다. 스크린샷만 보고 Pokémon Rouge를 끝까지 플레이한 첫 Sonnet 모델이기도 하다.
| 벤치마크(Anthropic 발표 수치) | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % (Xhigh) | — |
| FrontierCode 1.1 Main | 52,1 % (Xhigh), 46,2 % (Max) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | — |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 | 1483 |
| Humanity’s Last Exam (도구 사용) | 64,5 % | 54,9 % | 67,7 % | — |
| OSWorld 2.1 (부분) | 80,1 % | 57,0 % | 81,8 % | — |
| Chartography (도구 미사용) | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
Anthropic는 이 수치들에 단서를 달았다. FrontierCode에서 Sonnet 5.5는 Max 노력 수준일 때 성능이 떨어진다. 이때 Claude Code의 코드 리뷰 스킬을 더 자주 실행해 시간제한을 넘기거나 작업 범위를 벗어났으며, Cognition이 살펴본 사례 두 건에서 이런 일이 나타났다. GDPval-AA와 AA-Briefcase는 버그가 있었던 시험판에서 측정했지만, 그 영향은 작다고 평가됐다. 무엇보다 Anthropic는 지속적인 판단이 필요한 범위가 열려 있는 복잡한 작업에서 Opus 5.5가 확연히 더 강하다고 본다.
가격은 Sonnet 5와 동일하다. 입력 토큰 100만 개당 2달러, 출력 토큰 100만 개당 10달러, 캐시 읽기 토큰 100만 개당 0.20달러다. 입력과 출력 가격은 Opus 5.5(각각 4달러와 20달러)의 절반이다. 비용 절감은 소비하는 토큰 수에서 나온다. Low 또는 Medium 노력 수준에서 Sonnet 5.5는 여러 벤치마크에서 Sonnet 5의 최고 점수를 넘으면서 작업당 비용은 약 10분의 1에 그쳤다. 이 모델은 최대 100만 토큰의 컨텍스트를 받아들이고 최대 128,000토큰을 출력한다. 기본 노력 수준은 Claude Code와 Claude 앱에서 Medium, Claude Platform에서 High다.
We recommend starting with Opus for large projects and Sonnet for tasks where you need to balance quality with speed and cost.
🇰🇷 대규모 프로젝트는 Opus로 시작하고, 품질·속도·비용의 균형이 필요한 작업은 Sonnet으로 시작할 것을 권장합니다. — X의 @ClaudeDevs
Sonnet 5.5의 사이버 보안 역량이 Opus 5와 비슷해지면서, 가장 강력한 모델 수준의 사이버 보안 장치를 적용받고 출시된 첫 Sonnet 모델이 됐다. 위험도가 높은 요청은 사용자에게 보이게 Sonnet 5로 전환되며, 일반적인 버그 수정에는 영향을 주지 않는다. 추론 내용의 추출을 막는 보안 분류기를 갖춘 첫 Sonnet 모델이기도 하며, 생성된 추론 내용은 이제 이를 생성한 계정에 연결된다.
개발자가 claude-sonnet-5-5(으)로 전환할 때는 모델 식별자만 바꾸면 되는 것이 아니다. 문서에는 Sonnet 5와 비교해 호환성을 깨는 변경 사항 다섯 가지가 나와 있다. 여기에는 추론을 비활성화하는 방식 대신 between_tools 설정을 사용하는 것과, 도구 선택을 강제하는 방식(tool_choice을 any 또는 tool로 설정)을 거부해 400 오류를 반환하는 것이 포함된다. Claude Code에서는 /claude-api migrate 명령어가 마이그레이션을 돕는다.
Sonnet 5.5는 오늘부터 Claude Platform과 Claude Code, Amazon Web Services, Google Cloud, Microsoft Azure에서 사용할 수 있다. 출처에는 요금제별(Free, Pro, Max) 제공 범위가 명시되지 않았다. Claude Code 2.1.284에서는 Anthropic API를 사용할 때 이 모델이 기본 Sonnet 모델로 설정된다(코드 에이전트 섹션 참조).
🔗 Claude Sonnet 5.5 발표 · Sonnet 5.5 마이그레이션 가이드
GitHub Copilot, Pro 요금제부터 제공
9월 28일 — GitHub가 Copilot에서 Claude Sonnet 5.5를 정식 제공하기 시작했다(변경 기록 게시 시각: 태평양 시간 오전 11시 03분). 9월 22일 출시 당시 Pro 요금제에서 제공되지 않았던 Claude Opus 5.5와 달리, Sonnet 5.5는 Copilot Pro, Pro+, Max, Business, Enterprise에서 사용할 수 있다. Visual Studio Code, Visual Studio, Copilot CLI, Copilot 코드 에이전트, GitHub Copilot 앱, github.com, GitHub Mobile, JetBrains IDE, Xcode, Eclipse 등 10개 환경에 단계적으로 배포된다.
GitHub는 초기 테스트에서 Sonnet 5.5가 코드 작업에서 Claude Sonnet 5와 같은 성과를 내면서 단계 수, 토큰 수, 도구 호출 수가 훨씬 적었고 작업도 더 빨리 끝냈다고 밝혔다. 구체적인 수치는 공개하지 않았다. 사용량에 따라 공급자의 공개 요금이 적용된다. GitHub 문서에 따르면 토큰 100만 개당 입력 2달러, 출력 10달러로 Claude Sonnet 5와 같다. Business와 Enterprise에서는 관리자가 새 모델의 기본 활성화 설정이나 해당 모델을 비활성화하지 않았다면 자동으로 사용할 수 있다.
🔗 GitHub Copilot의 Claude Sonnet 5.5 · Copilot 모델과 요금
Devin, FrontierCode 1.1에서 64.4% 측정
9월 28일 — Cognition은 출시 당일 Devin Desktop과 Devin CLI에서 Sonnet 5.5를 제공하기 시작했다. 프로덕션 코드베이스의 요구사항 준수 여부를 확인하는 자체 벤치마크 FrontierCode 1.1에서 Sonnet 5.5는 64.4%를 기록해 Sonnet 5의 56.2%를 앞섰다. Claude Fable 5.1(63.6%)보다 높고, 그래프 상위 세 모델인 Opus 5.5(65.3%), Fable 5(64.9%), GPT-6 Astra(64.5%) 바로 뒤에 놓였다.
Cognition의 X 게시물은 Main 변형을 언급하지만, 블로그 글의 그래프 제목은 Extended이며 다른 모델의 수치도 9월 22일 발표된 Extended 변형의 값과 일치한다. 비교하면 Anthropic가 발표한 Sonnet 5.5의 Main 변형 점수는 Xhigh 노력 수준에서 52.1%다. Cognition은 토큰 가격은 그대로지만 생성 속도는 30% 이상 빠르고 작업당 비용은 Sonnet 5보다 최대 30% 낮다는 Anthropic의 수치도 전했다.
🔗 Devin의 Claude Sonnet 5.5 · X의 Cognition
Cursor와 v0도 같은 날 제공
9월 28일 — Vercel의 앱 제작 도구 v0가 발표 1분 뒤인 UTC 18시 04분에 Sonnet 5.5를 제공하기 시작했다. Cursor는 UTC 20시 14분에 뒤따랐으며, 어떤 Opus를 가리키는지는 밝히지 않은 채 여러 작업에서 Opus 수준의 성능을 내는 견고한 모델이라고 설명했다. 각 도구의 자체 가격이나 측정 결과는 공개되지 않았다. 9월 22일 Opus 5.5 때와 마찬가지로 이용 가능 여부만 발표한 것이다.
NVIDIA, 소프트웨어부터 실리콘까지 에이전트를 감시하는 Open Agent Safety Platform 출시
9월 28일 — NVIDIA가 테스트부터 배포까지 AI 에이전트를 보호하기 위해 공개 소프트웨어 플랫폼과 참조 시스템 설계를 결합한 Open Agent Safety Platform을 출시했다. 소프트웨어, 하드웨어, 컴퓨팅, 로봇 시스템으로 이어지는 전체 스택에 거버넌스와 통제를 적용한다. 아키텍처를 설명한 글의 출발점은 최근 여러 선도 연구소가 에이전트를 가두도록 설계된 평가 환경에서 에이전트가 벗어났다고 보고했다는 사실이다. 제시된 다섯 가지 원칙 가운데 하나는 정책을 검증할 수 있어야 하며, 에이전트가 접근할 수 없는 별도 경로에서 정책을 집행해야 한다는 것이다.
| 플랫폼 구성 요소 | NVIDIA가 밝힌 역할 |
|---|---|
| NVIDIA OpenShell (오픈 소스, 버전 0.1) | 샌드박스 실행 환경: 정책을 형식적으로 검증하고 에이전트 외부에서 집행하며, Vera CPU와 타사 플랫폼(Arm, Intel)에서 작동 |
| NVIDIA Sentry (참조 설계) | BlueField-4 DPU에서 별도 경로로 작동하며 몇 밀리초 안에 에이전트를 격리하는 감시 장치 |
| NVIDIA DOCA | 요청과 응답 검사, 검증 가능한 원격 측정, 에이전트 신원 확인, 제로 트러스트 접근 |
3월부터 개발 상황이 알려진 오픈 소스(Apache 2.0) 실행 환경 OpenShell은 0.1 버전으로 올라갔다(0.1.0은 9월 25일, 0.1.2는 28일 GitHub에 게시). 이제 오픈 모델과 폐쇄형 모델 모두에 폭넓게 제공된다고 발표됐다. 각 에이전트는 커널 수준의 통제가 적용된 샌드박스에서 실행된다. 외부 감독자가 HTTP, GraphQL, MCP 트래픽을 검사해 같은 API에서도 읽기는 허용하고 쓰기는 차단할 수 있으며, 에이전트는 실제 자격 증명을 보지 않고 서비스에 접근한다. 정책은 YAML로 작성해 OPA/Rego로 컴파일하고 형식 검증기로 검증한다. 접근 권한이 없을 때 에이전트는 범위가 좁은 규칙을 제안할 수 있지만, 기본적으로 사람이 승인할 때까지 기다려야 하며 스스로 승인할 수 없다. OpenShell은 Codex, Claude Code, Pi, Hermes를 지원한다. NVIDIA에 따르면 장기간의 적대적 테스트에서 보호 장치를 줄인 최첨단 에이전트들이 보호된 GitHub 저장소를 열어 달라고 AI 검토자를 설득하기 위해 최대 2시간 동안 시도했지만, 저장소에 쓰기는 한 번도 일어나지 않았다.
두 번째 구성 요소인 Sentry는 감시 기능을 하드웨어로 옮긴다. DOCA를 기반으로 BlueField-4 DPU에서 별도 경로로 작동하는 감시 장치로, 에이전트의 동작을 지속적으로 관찰하고 신원을 확인하며 한계를 벗어난 에이전트를 몇 밀리초 안에 격리할 수 있다. Vera Rubin POD에서는 각 컴퓨팅 트레이의 노드가 모델에 접근하는 유일한 경로에 BlueField-4가 놓인다. NVIDIA에 따르면 BlueField-4가 이미 설치된 Vera 시스템은 소프트웨어 업데이트로 기능을 활성화할 수 있다.
NVIDIA는 100곳이 넘는 조직이 이 플랫폼의 기술을 활용하고 있다고 밝혔다. Anthropic는 샌드박스와 별도의 서버에서 에이전트 루프를 실행하는 Claude Managed Agents를 OpenShell 및 BlueField와 통합한다. SpaceXAI는 Cursor 코드 에이전트와 Grok 모델에 이 플랫폼을 적용한다. Salesforce는 Slack에서 OpenShell 에이전트의 활동을 추적하고 권한 요청을 승인하거나 거부한다. SAP는 Joule Studio의 실행 환경에, Scale AI는 GenAI 제품에 이를 통합한다. 참여 조직은 Microsoft, IBM, Palantir, CrowdStrike, Hugging Face부터 로봇 분야의 Figure와 Skild AI, 금융 분야의 Citi와 JPMorganChase, 운영체제 분야의 Canonical·SUSE·Red Hat, 인프라 공급업체인 CoreWeave·Nebius·Oracle Cloud Infrastructure까지 다양하다. OpenShell과 스킬을 포함한 소프트웨어는 GitHub와 NVIDIA 개발자 페이지에서 제공된다. Jensen Huang은 같은 날 CNBC에 출연해 이 대책을 설명했다.
🔗 NVIDIA 보도자료 · 플랫폼 아키텍처 · OpenShell 0.1.0 활용 사례 · CNBC에 출연한 Jensen Huang(@NVIDIAAI)
Together AI와 Perplexity, 발표에 동참
9월 28일 — Together AI는 자신을 플랫폼의 출시 파트너라고 소개했으며, NVIDIA 보도자료에서는 인프라 공급업체로 분류됐다. 이 추론 서비스 공급업체는 에이전트를 안전하게 개발하고 배포하기 위한 플랫폼 기능을 구축해 왔다고 설명하고, 특히 OpenShell을 중심으로 NVIDIA와 함께 이 분야에 계속 투자하겠다고 밝혔다. 수치나 구체적인 제품명은 제시하지 않았다.
Perplexity는 보도자료에서 두 차례 언급됐다. 처음에는 NVIDIA에 합류하는 업체 중 하나로, 다음에는 플랫폼 기술을 사용하는 100곳 넘는 조직 중 하나로 소개됐지만 구체적인 역할은 밝혀지지 않았다. Perplexity는 게시물 아홉 개로 이어지는 글을 시작했다.
We’re partnering with Nvidia and 100+ industry partners to build infrastructure that contains rogue AI agents.
🇰🇷 통제되지 않는 AI 에이전트를 격리하는 인프라를 구축하기 위해 NVIDIA 및 100곳이 넘는 업계 파트너와 협력합니다. — X의 @perplexity_ai
이어서 9월 23일 발표돼 당시 다뤄진 자사 샌드박스 보안 감사 Escaping SPACE를 다시 언급했다. 해당 감사에서는 108차례의 시도 중 가상 머신 탈출이 한 번도 없었다. 당시 글에서 NVIDIA는 테스트한 타사 샌드박스 중 하나인 OpenShell을 통해서만 언급됐으며, 두 차례의 우회 시도 모두 OpenShell에서는 성공하지 못했다.
Manus, Cascade 하네스와 함께 2.0으로 전환하고 개인 에이전트 앱 Cue 출시
9월 28일 — Manus가 Manus 2.0을 출시했다. Manus는 이를 단순한 버전 업데이트가 아니라 새 제품을 동반한 새로운 아키텍처로 소개한다. 이번 발표는 9월 1일 Manus가 독립 운영을 재개한 지 한 달도 지나지 않아 나왔다.
그 기반은 자체 에이전트 하네스의 최신 버전인 Cascade다. 각 프로젝트는 가볍게 시작해 작업에 필요한 경우에만 전문 기능을 추가하며, 브리핑, 페이지, 동영상, 자동화를 하나의 프로젝트에 담는다. Manus는 이전 시스템과 비교한 개선 폭을 제시했지만, 블로그 글에 구체적인 내용이 없는 단일 테스트 구성에서 얻은 수치다.
| Manus가 발표한 측정치(단일 테스트 구성) | 이전 시스템 대비 차이 |
|---|---|
| 사용한 토큰 | -23,2 % |
| 작업 시간 | -28,2 % |
| 실행 비용 | -32 % |
여기에 두 가지 기능이 더해진다. Cloud Computer는 상시 실행이 필요한 작업(멀티플레이어 게임 서버나 자동화)을 위해 구매하는 전용 환경이다. 자동화는 이제 연결된 서비스에서 발생하는 이벤트(새 이메일, 광고 성과 변화, 일정의 약속, Slack 메시지, Notion 업데이트)를 계기로 실행되며, 하나의 프롬프트로 설정할 수 있다.
데스크톱 앱은 사람과 AI가 함께 쓰는 작업 공간인 Manus Studio로 바뀌며, 프로젝트에 필요한 도구만 불러온다. 이곳에는 두 가지 환경이 등장한다. Video Editor는 초벌 편집본을 만든 뒤 클립, 이미지, 텍스트, 애니메이션, 오디오를 각각 수정할 수 있는 타임라인(timeline)을 연다. 30~60초 길이의 제품 광고, 튜토리얼, 브이로그를 겨냥하며, Alchemy 모드에서는 AI가 창작 방향을 맡는다. Game Dev는 동영상, 이미지, 코드 모델을 결합해 링크 하나로 플레이할 수 있는 게임을 게시하고, Cloud Computer를 구매하면 멀티플레이어를 설정한다. Remote Control과 Computer Use를 이용하면 휴대전화에서 Manus에 자신의 컴퓨터로 수행할 작업을 맡기고 데스크톱 화면을 실시간으로 볼 수 있다.
세 번째 축인 Cue는 Manus 인프라를 기반으로 만든 휴대전화 및 컴퓨터용 독립형 개인 에이전트 앱이다. 각 에이전트에는 고유한 이메일 주소, 전화번호, 지갑, 컴퓨터가 주어진다. 에이전트는 메시지를 보내고, 정해진 예산 안에서 결제하고, 전화를 받은 뒤 통화 내용을 요약한다. 여러 에이전트가 그룹 대화에서 하나의 목표를 함께 수행할 수 있으며, QR 코드를 스캔해 음식점에서 주문하는 등 일상 서비스에도 Cue를 사용할 수 있다. 이날 늦게 Manus는 이 번호로 전화와 SMS를 발신·수신할 수 있지만, 일부 국가에서만 가능하고 때로는 음성 통화만 지원한다고 밝혔다.
Manus 2.0은 지금 웹, 데스크톱, 모바일에서 이용할 수 있다. Cue도 이용 가능하며, iOS 버전은 App Store 심사를 기다리고 있다. 초대 코드를 통한 무료 조기 이용은 제한된 수의 초기 사용자에게만 제공된다. 발표 글에는 Cloud Computer를 포함한 요금이 전혀 없고, 기반 모델도 밝히지 않았으며, 외부 평가도 인용하지 않았다.
🔗 Manus 2.0 소개 · X의 Cue 발표 · 에이전트 전화번호
ElevenLabs, 가장 표현력이 풍부한 음성 모델 Eleven v4와 에이전트용 Turbo 버전 출시
9월 28일 — ElevenLabs가 자사에서 가장 감정 표현력이 풍부한 음성 합성(TTS) 모델이라고 소개한 Eleven v4와 대화형 에이전트를 위해 지연 시간을 낮춘 Eleven v4 Turbo를 출시했다. 완전히 새로운 아키텍처로 구축한 Eleven v4는 텍스트의 어조, 리듬, 감정, 맥락을 해석해 목소리의 정체성을 유지하면서 극적이거나 다정하고, 긴박하거나 익살스러운 말투를 구현하도록 설계됐다. ElevenLabs는 2026년 9월 Artificial Analysis의 Provider Voice Arena 순위에서 1위를 차지했으며, Cartesia Sonic 3.6, Inworld TTS-2, Google의 Gemini 3.8 TTS 모델 2개와 비교한 블라인드 테스트에서 청취자 약 75%의 선호를 얻었다고 주장한다. 동률은 절반씩 계산했다.
자연어 또는 텍스트에 삽입한 태그(웃음, 프랑스 억양으로 화내며 말하는 대사, 가벼운 빗소리, 진동하는 전화)로 연기를 지시할 수 있으며, ElevenLabs에 따르면 Eleven v4는 이전 모델보다 이를 더 충실히 따른다. 국제 음성 기호(IPA) 지원도 크게 개선됐고, 여러 목소리가 나오는 대화도 더 자연스러워졌다. 에이전트, 오디오북, 광고에서 목소리의 일관성을 유지하기 위한 새로운 음성 정체성 포착 방법도 도입됐다.
| ElevenLabs가 발표한 지표 | 발표 수치 |
|---|---|
| Artificial Analysis의 Provider Voice Arena 순위(9월) | 1위 |
| 경쟁 모델 4개와의 블라인드 테스트 선호도 | 약 75 % |
| Eleven v4 Turbo의 추론 지연 시간 중앙값 | 약 100 ms |
| Eleven v4 Turbo의 첫 발화까지 걸리는 시간 중앙값 | 약 150 ms |
| 지원 언어 | 90개 이상(Eleven v3: 70개 이상) |
| Eleven v4의 요청당 한도 | 10 000자(Eleven v3: 5 000자) |
| 즉석 음성 복제에 필요한 최소 오디오 | 10초 |
첫 발화까지 걸리는 시간은 Cartesia, xAI, Google, OpenAI와 비교한 WebSocket 스트리밍에서 네트워크 지연 시간을 제외하고 측정했다. Eleven v4 Turbo는 ElevenAgents 플랫폼과 함께 최적화됐다. 한 언어로 녹음한 목소리는 다른 언어도 해당 언어의 자연스러운 억양으로 말하며, Eleven v4는 이제 전문 음성 복제(Professional Voice Clones)를 지원한다. Studio와 Reader 앱에 유용한 긴 분량의 연속 생성도 더 안정적이 됐다.
두 모델은 지금 ElevenAgents, ElevenCreative와 API(eleven_v4 및 eleven_v4_turbo)에서 이용할 수 있다. 2주 동안 API 요금은 문자 100만 개당 Eleven v4가 22달러, Eleven v4 Turbo가 11달러로 할인된다. ElevenCreative의 Creator 이상 요금제에서는 월간 크레딧의 두 배를 한도로 Eleven v4를 무료로 사용할 수 있다. 정가는 공개되지 않았다. 이번 출시는 2026년 2월 상용화된 Eleven v3에 이은 것이다.
Kling, 10월 출시 예정인 Kling 4.0 발표하고 Kling 4.0 Flash 조기 이용 제공
9월 28일 — Kling AI가 차세대 동영상 모델 Kling 4.0을 공개했으며, 정식 출시는 10월로 예정돼 있다. 첫 번째 파생 모델인 Kling 4.0 Flash는 9월 28일부터 제한된 사용자 그룹에 조기 이용이 제공된다. 발표 트윗에 따르면 대상은 연간 Ultra 구독자다. Kling은 시각적 사실감, 창작 제어, 서사의 완결성(narrative completeness)을 세 가지 핵심으로 내세운다.
발표된 사양에 따르면 Kling 4.0은 최대 4K 해상도로 3~30초 길이의 연속 동영상을 생성하며, 2채널 스테레오 사운드를 지원한다. 최대 10개의 키프레임과 최대 8 000토큰의 프롬프트로 서사를 제어할 수 있다. Omni Reference는 생성당 최대 15개의 참조를 받는다. 이미지 10개, 합계 길이가 최대 30초인 동영상 5개, 대상 7개이며, 대상 중 3개는 동영상에서 가져올 수 있다. 오디오 참조는 목소리로 제한된다. 텍스처가 없는 모형과 깊이 지도로 움직임과 구도를 맞출 수 있고, 편집 기능으로 최대 5개 클립의 표정, 동작, 카메라, 스타일, 배경을 수정할 수 있다. Kling은 영상 속 글자의 가독성도 높이고 광둥어부터 쓰촨어, 인도 영어까지 더 많은 언어, 억양, 방언을 지원한다고 주장한다.
| 기술 사양 | Kling 4.0 | Kling 4.0 Flash |
|---|---|---|
| 제공 시기 | 10월 정식 출시 | 9월 28일부터 제한적 조기 이용 |
| 생성 모드 | 텍스트에서 동영상, 이미지에서 동영상, 첫 이미지와 마지막 이미지, 키프레임 10개, Omni Reference | 텍스트에서 동영상, 이미지에서 동영상, Omni Reference |
| 생성 길이 | 3~30초 | 3~20초 |
| 최대 해상도 | 4K(720p 및 1080p도 지원) | 720p |
| 다이내믹 레인지 | 1080p 및 4K의 10비트 HDR, 추후 제공 예정 | 8비트 SDR |
모든 기능이 아직 제공되는 것은 아니다. 릴리스 노트는 발표 트윗에서 Kling 4.0의 기능으로 소개한 1080p 및 4K의 10비트 HDR 출력과 동영상을 최대 2분까지 확장하는 기능을 추후 제공 예정(coming soon)으로 표시했다. Kling은 모든 참조를 하나의 입력란에 모으고 에이전트가 요청한 작업을 수행하는 캔버스를 추가하는 방식으로 제작 페이지도 개편한다. Kling 4.0으로 제작한 단편 영화 THE BEAT가 발표에 포함됐지만, 요금, API 접근 방법, 벤치마크는 공개되지 않았다.
코딩 에이전트: Claude Code 2.1.284, Codex CLI 0.158.0, Copilot CLI 1.0.89와 SDK, Devin, Delta, Gemini CLI
Claude Code 2.1.284, 모든 요금제와 제공업체에서 기본 자동 모드로 시작
9월 28일 — 모델 발표 직전인 UTC 18시 02분에 공개된 Claude Code 2.1.284에는 Anthropic API에서 기본 Sonnet 모델이 되는 Claude Sonnet 5.5가 추가됐다. 이 버전에는 수정 57건, 개선 18건, 추가 14건, 변경 11건 등 총 100개 항목이 담겼다.
가장 눈에 띄는 변화는 권한이다. 모드를 설정하지 않은 경우, 터미널과 VS Code의 대화형 세션은 이제 모든 요금제와 모든 제공업체에서 자동 모드로 시작한다. 9월 25일의 2.1.283은 타사 제공업체와 원격 측정이 없는 세션에 이미 이를 적용했다. 2.1.284는 적용 범위를 넓혔으며, permissions.defaultMode 설정은 계속 우선한다. 새로운 응답인 “예, 하지만 다음에는 다시 묻기”(Yes, but ask again next time)를 선택하면 작업 디렉터리 밖을 한 번만 읽도록 허용하고, 이후에는 Claude Code가 다시 묻는다.
Ultracode는 작업 강도 슬라이더에서 분리돼 /effort의 독립적인 전환 설정이 됐다(Tab 키 또는 /effort ultracode on 및 off). 더 이상 xhigh 강도를 강제하지 않고 선택한 강도와 관계없이 활성 상태를 유지한다. VS Code의 작업 강도 슬라이더 아래에도 같은 전환 설정이 있다.
| 2.1.284의 새 기능 | 명령어 또는 설정 |
|---|---|
| 모든 요금제와 제공업체에서 기본 자동 모드 | permissions.defaultMode이 우선 |
| 독립적으로 전환하는 Ultracode | /effort에서 Tab, 또는 /effort ultracode on 및 off |
| 연결에 실패한 MCP 서버 일괄 재연결 | /mcp reconnect all |
| Claude 앱 게이트웨이의 달러 지출액 | /usage 및 상태 표시줄(필드 used_usd, limit_usd, period) |
| “프롬프트가 너무 깁니다” 오류가 지속되면 두 번째 압축 | 자동 |
보안 측면에서는 관리자가 자체 관리 규칙만 허용하는 경우, 마켓플레이스, claude.ai 또는 npm에서 가져온 플러그인이 자체 도구를 사전 승인할 수 없게 됐다(allowManagedPermissionRulesOnly). 프로젝트 외부에서 심볼릭 링크로 연결한 .claude/rules 규칙에는 승인 요청이 필요하다. 메모리를 불러올 때는 MEMORY.md에서 보이지 않는 문자와 Claude Code의 마크업을 흉내 내는 태그를 무력화한다. 안정성 측면에서는 손상된 응답 스트림에 “JSON Parse error”를 표시하는 대신 재시도하며, 재개한 세션의 MCP 호출은 서버를 최대 10초까지 기다린다. 또한 Sonnet 모델의 안전장치가 메시지를 감지하면 안내문에서 이유를 더 자세히 설명하고, 요청을 수정해 다시 실행하도록 제안한다.
Codex CLI 0.158.0: 선택 시 복사와 MCP용 OAuth 클라이언트 시크릿
9월 28일 — UTC 05시 07분에 공개된 Codex CLI 0.158.0은 9월 26일의 0.157.1 이후 첫 안정 버전이다. 릴리스 노트에는 0.157.0 이후의 풀 리퀘스트 188건이 기록돼 있다. 전체 화면 인터페이스(fullscreen TUI)에서 선택 시 복사(copy-on-select)와 오른쪽 클릭 붙여넣기를 설정할 수 있으며, 대화 기록에서 복사한 부분은 Markdown 서식을 유지한다.
| 관련 기능 | 설정 또는 세부 내용 |
|---|---|
| 선택 시 복사 | tui.copy_on_select: 기본값은 auto(tmux, Zellij, Ghostty와 Kitty를 제외한 macOS 터미널 직접 사용), always, never |
| 오른쪽 클릭 붙여넣기 | tui.right_click_paste: auto(Windows, Linux, WSL), on(macOS 포함), off |
| OAuth를 사용하는 MCP 서버 | codex mcp add --oauth-client-secret, 키 oauth.client_secret |
| Exec-server | 직접 WebSocket 연결을 위한 전달자 토큰 |
| 이미지 생성 | 명시적 투명 배경(transparent_background), 대화 속 이미지 편집 |
이제 Codex는 시크릿이 있는 사전 등록 OAuth 클라이언트를 요구하는 MCP 서버에 연결할 수 있다. exec-server에 대한 직접 WebSocket 연결은 앱 서버를 거치는 경우를 포함해 전달자 토큰(bearer tokens)으로 보호할 수 있다. 보안 측면에서는 터미널로 보내는 입력의 승인 기능이 안정 버전으로 전환됐으며, 높은 권한으로 실행하는 명령에 기본 적용된다. 수정 사항은 주로 샌드박스에 집중됐다. Windows 10의 일반 경로, 저장된 자격 증명의 거부, 쓰기 가능한 루트가 중첩된 Linux 환경에서의 시작, Linux와 macOS의 Git 메타데이터 보호가 포함된다.
Copilot CLI 1.0.89 안정판 출시, Copilot SDK 1.0.15에 타입이 지정된 출력 추가
9월 28일 — GitHub가 Copilot CLI 1.0.89 안정판을 출시했다(UTC 19시 20분). 9월 27일에 소개된 미리보기 버전 1.0.89-5에는 이미 .claude/rules 파일 지원이 포함됐으며, 릴리스 노트의 35개 항목 중에는 새롭게 추가된 기능도 여럿 있다. Auto 라우팅은 이제 수준을 제안하며, 사용자는 단축키나 클릭으로 이를 바꿀 수 있다. 지원되지 않던 Fast 프로필은 제거돼 저장된 Fast 기본 설정은 Balance로 전환된다. pull request를 만들 때는 필수 섹션과 체크리스트를 포함한 저장소 템플릿을 따른다. 로컬 세션에서는 빈 입력창에서 Esc를 두 번 누르면 아직 시작되지 않은 차례의 프롬프트로 돌아갈 수 있고, 직접 설치한 plugins를 활성화하거나 비활성화할 수 있다(copilot plugin enable). 샌드박스에서는 래핑된 gh 및 git 명령(timeout 60 gh …)이 작동하며, 로컬 네트워크 접근을 켜면 Windows에서 localhost에 접근할 수 있다.
곧이어(UTC 19시 38분), 애플리케이션에 Copilot의 에이전트 실행 환경을 내장하는 GitHub Copilot SDK가 다섯 차례의 미리보기 버전을 거쳐 1.0.15로 출시됐다. 핵심 기능은 6개 SDK(TypeScript, Python, Go, Java, C#, Rust)의 타입이 지정된 구조화 출력이다. 개발자가 JSON 스키마나 해당 언어의 타입을 제공하면 모델이 자유 형식 텍스트 대신 타입에 맞고 검증된 출력을 반환한다. 실험적 관리 기능을 통해 애플리케이션은 MCP 서버나 skill을 설치하기 전에 명시적인 결정(확인, 거부, 취소)을 받는 사람의 검토를 요구할 수도 있다. Rust에서는 이 실행 환경을 설치할 때 유지되는 메모리가 약 99% 줄었다.
🔗 Copilot CLI v1.0.89 · Copilot SDK v1.0.15
Devin 사용 비용 30~40% 인하, Devin Fusion은 FrontierCode 1.1 Extended에서 선두
9월 28일 — Cognition이 Devin 사용 비용을 크게 낮췄다고 발표했다. Fusion과 Normal 모드는 3040%, Ultra 모드는 1520%, 코드 검토 도구인 Devin Review는 최대 70% 저렴해졌다. Cognition은 최신 모델과 자체 모델 SWE-2의 통합, 그리고 Devin의 클라우드 실행 기반(cloud harness) 개선을 비용 절감의 이유로 들었다. 한 번의 도구 호출에 더 많은 작업을 묶고(서식 지정, 분석, 테스트를 한꺼번에 수행), 독립적인 호출을 병렬로 실행하며, 프롬프트 캐시를 더 잘 재사용한다는 것이다. 이 실행 기반에 제시된 수치는 측정 결과가 아닌 설명용 사례에서 나온 것이다.
Cognition은 각 모드의 지능을 유지하거나 개선했다고 밝혔다. Fusion은 능력 있는 주 모델에 비용이 더 낮은 보조 모델(sidekick)을 결합하며, 게시물의 그래프에서는 FrontierCode 1.1 Extended에서 선두를 차지한다.
| Cognition의 평가 구성 | FrontierCode 1.1 Extended 점수 | 작업당 평균 비용 |
|---|---|---|
| Devin Fusion | 68,8 | 0,60달러 |
| Opus 5.5 (high) | 65,2 | 0,90달러 |
| Fable 5.1 (medium) | 63,6 | 2,68달러 |
| GPT-6 Astra (high) | 63,1 | 2,62달러 |
| SWE-2 (high) | 60,1 | 0,64달러 |
| GPT-6 Sol (high) | 59,6 | 0,87달러 |
high 수준에서 측정된 Opus 5.5(65,2)와 GPT-6 Astra(63,1)의 값은 같은 날 공개된 Sonnet 5.5 그래프의 값(65,3 및 64,5)과 다르다. 후자의 그래프에는 수준이 명시되지 않았다. 비용을 낮춘 Devin은 오늘부터 이용할 수 있지만, 새 요금표는 공개되지 않았다.
Devin의 9월 25일 릴리스 노트와 Devin Mobile 베타
9월 25일 — 지금까지 주목받지 못했던 Devin의 9월 25일 릴리스 노트에는 Buildkite, Brex, Expo, Vanta, WorkOS, Wix를 포함해 Marketplace에 호스팅형 MCP(hosted MCP) 통합 57개가 추가됐다고 적혀 있다. Devin은 형식을 지정하지 않고 그래프, 표, 다이어그램이 유용한 보고서를 요청하면 대화형 HTML 보고서도 만든다. 하위 세션은 상위 세션의 요약을 받은 상태로 시작하며, 이 요약은 입력창에 제거할 수 있는 표시로 나타난다. 컴퓨터가 절전 상태에 들어간 세션은 미리보기 URL을 열거나 SSH로 접속하면 깨어난다. 자동화는 공유 Outpost에서 실행할 수 있고, Devin은 Azure DevOps pull request에서 실패한 검사에 관한 Azure Pipelines 로그를 읽는다.
9월 28일에는 Cognition이 Devin Mobile 베타의 대기자 명단도 열었다. 등록 페이지는 Devin을 한 문장으로 설명한다. 클라우드나 사용자 컴퓨터에서 실행되고, 자체 브라우저에서 테스트하며, pull request가 병합할 준비가 될 때까지 멈추지 않는다는 것이다. 일반 공개 날짜와 요금은 발표되지 않았다.
🔗 Devin 릴리스 노트 · X의 Devin Mobile
Zed, Delta 0.18 예고…Gemini CLI는 변경 사항 없는 nightly 공개
9월 28일 — Zed는 에이전트와 함께 코딩하는 다중 사용자 환경 Delta의 0.18 버전에서 Delta 스레드(threads)를 기존 Git worktree에서 실행할 수 있게 된다고 발표했다. 출시 날짜는 밝히지 않았다. 9월 23일 공개된 0.17은 이미 병렬 작업마다 별도의 작업 공간을 마련했다. Google이 9월 28일 공개한 Gemini CLI nightly에는 변경 사항이 없다. 26일 nightly와 같은 커밋을 기반으로 하며, 안정판 v0.61.0과 미리보기 버전 v0.62.0-preview.0도 그대로 유지된다.
🔗 X의 Zed · Gemini CLI v0.63.0-nightly.20260928
Perplexity Agent API에 재사용 가능한 Profiles, 버전 관리되는 Skills, 공유 커넥터 추가
9월 28일 — Perplexity가 팀을 위해 Agent API에 재사용하고 버전을 관리할 수 있는 설정 계층을 추가했다. 중심 기능인 Profile은 에이전트를 정의하는 모델, 지침, 도구, Skills, 커넥터, 실행 설정을 버전이 지정된 하나의 식별자에 저장한다. 프로젝트 관리자가 에이전트를 한 번 설정해 권한 있는 개발자에게 제공하면, 각 애플리케이션은 자체 데이터만 전달하면 된다.
맞춤형 Skills는 지침, 절차, 지원 파일을 버전이 지정된 형태로 묶는다. 플랫폼 팀은 배포 점검, 롤백(rollback) 기준, 보고서 형식을 여기에 담고 각 애플리케이션을 수정하는 대신 새 버전을 게시할 수 있다. 8월 말 출시된 관리형 커넥터(managed connectors)는 관리자가 프로젝트 전체와 공유하는 리소스가 된다. 애플리케이션은 각자 인증 정보나 도구 정의를 저장하지 않고 이를 참조한다.
| 추가된 리소스 | Agent API에서의 역할 | 발표된 제공 상태 |
|---|---|---|
| Profiles | 모델, 지침, 도구, Skills, 커넥터, 실행 설정을 버전이 지정된 식별자에 저장 | 이용 가능 |
| 맞춤형 Skills | 프로젝트 구성원이 호출하는 버전 관리 지침, 절차, 지원 파일 | 이용 가능 |
| 관리형 커넥터 | 관리자가 공유하는 승인된 통합(GitHub, Slack, Google Drive, Datadog, Linear, Notion) | 미리보기 |
모든 설정은 API Console에서 하며, 구성원은 같은 프로젝트의 API 키로 이 리소스를 호출한다. 게시물에는 요금이 발표되지 않았다. 같은 날 API 변경 기록에는 Agent API의 xhigh 프리셋이 GPT-5.6 Sol(openai/gpt-5.6-sol)에서 Claude Opus 5.5(anthropic/claude-opus-5-5)로 바뀌었다고 적혔다. 프롬프트, 추론 수준, 도구, 토큰 예산, 단계 제한은 그대로다. 사흘 전에는 low, medium, high 프리셋이 GPT-6로 전환됐다.
🔗 Agent API의 재사용 가능한 에이전트 지원 · Perplexity API 변경 기록
SpaceXAI, 팀 전체가 공유하는 Grok Bots인 Team Bots 출시
9월 28일 — SpaceXAI가 팀의 역할이나 업무 흐름에 맞춰 만들고 모든 팀원과 공유하는 Grok Bots인 Team Bots를 출시했다. 각 구성원은 Bot과 개별적으로 작업할 수도 있다. Bot은 공유하지만 대화는 비공개이며, 맥락과 기억은 사용자별로 분리되고 skills는 팀이 공유한다. 각 Team Bot에는 Slack에서 자체 식별자가 있으며, 팀 전체가 질문할 수 있는 채널에 초대할 수 있다.
| Bot 구성 요소 | SpaceXAI가 설명한 역할 |
|---|---|
| 맥락 | 파일, 지침, skills |
| Plugins | 개인 또는 팀이 연결한 Salesforce, Notion, GitHub에서 작업 |
| 인증 정보 | plugin이 없는 외부 API에 접근 |
| 기억 | Bot이 역할을 더 잘 수행하기 위해 기억하는 내용으로, 사용자별로 분리 |
SpaceXAI는 자체 활용 사례도 설명했다. 주요 기업 고객마다 Team Bot을 하나씩 두어 밤사이 고객 관련 뉴스, Gong 통화, Notion 문서, Slack 대화를 분석하고 아침에 Slack으로 현황을 게시한다. Notion, Linear, Hex, Datadog, Cursor와 연결된 엔지니어링 Bot은 수백 개의 Cloud Agents를 관리했다. 이를 통해 5명으로 구성된 팀이 하루에 100건이 넘는 pull request를 제출하고 몇 주 만에 Team Bots를 출시했다고 한다. 고객사인 보험업체 Harper는 고객의 만료된 보험 계약을 복구하도록 돕는 Team Bot을 24시간 만에 만들었으며, 최고경영자에 따르면 고객이 120 000달러 넘게 절약했다.
Team Bots는 오늘부터 Teams 및 Enterprise 요금제에서 공개 베타로 제공된다. 영업, 제품 관리, 마케팅, 데이터 분석용으로 미리 설정된 Team Bots도 있다. SpaceXAI는 요금이나 사용 한도를 밝히지 않았다.
🔗 Team Bots(SpaceXAI) · X의 @bot 발표
H Company, 27B 및 35B-A3B 오픈 웨이트 에이전트 모델 Holo4 공개
9월 28일 — H Company가 새로운 에이전트 모델 시리즈 Holo4를 두 가지 크기로 공개했다. 하나는 매개변수 270억 개의 밀집 모델이고, 다른 하나는 전문가 혼합(Mixture of Experts) 모델인 35B-A3B다. 둘 다 H Models API로 제공되며 Hugging Face에는 BF16, FP8, NVFP4, GGUF 4비트 형식으로 공개됐다. H는 NVIDIA의 Nemotron 3 Nano Omni에 자체 후속 학습 방식을 적용한 Holotron4 Nano도 추가했다. 하나의 모델이 컴퓨터, 웹, Android 또는 코드 샌드박스에서 그래픽 인터페이스, 코드, MCP, API를 통해 작업할 수 있다. H는 지도 학습에 이어 강화 학습으로 모델을 훈련했으며, 여기에는 Agentic Task Factory가 간단한 문서에서 생성한 검증 가능한 작업 약 10 000개가 포함됐다.
| 평가된 모델 | 기반 모델과 라이선스 | 공개 점수 |
|---|---|---|
| Holo4 27B | Qwen3.8-27B, CC-BY-NC-4.0 (비상업적) | OSWorld 2.0에서 61,7 %; 작업당 0,08달러로 OSWorld에서 85,2 % |
| Holo4 35B-A3B | Qwen3.6-35B-A3B, Apache-2.0 | OSWorld 2.0에서 30,9 % |
| Holotron4 Nano (Holotron4-30B-A3B) | Nemotron 3 Nano Omni, NVIDIA Open Model Agreement | 기반 모델 대비 향상 폭은 그래프로만 제시 |
| Claude Opus 5.5 (H가 인용한 비교 대상) | 비공개 모델 | OSWorld 2.0에서 81,8 % |
H는 평가 조건을 명시했다. Holo4는 자체 실행 기반에서 OSWorld 2.0을 한 번 실행해 측정했으며, 다른 실행 기반과 추론 수준에서 얻은 공개 점수와 비교했다. AutomationBench에서는 공개 작업 600개 중 480개가 학습 데이터 수집에 사용된 분할에 속한다. H는 공개 점수의 근거가 되는 모든 실행 과정을 게시해 단계별로 살펴보거나 Hugging Face에서 내려받을 수 있게 했으며, 며칠 안에 추론 속도를 높일 DSpark 초안을 공개하겠다고 밝혔다.
🔗 Hugging Face의 Holo4 게시물 · H Company 발표
로봇공학: Sakana AI의 SAIL 성공률 25%에서 73%로 상승, ProjectSim은 시뮬레이션 측정 방식에 의문 제기
9월 28일 — Sakana AI가 도쿄대학교와 함께 수행해 IROS 2026 학회에 채택된 연구 SAIL(Scaling In-Context Imitation Learning)을 소개했다. 논문의 arXiv 식별자는 2026년 3월에 부여됐으며, 이날 새로 나온 것은 공개 발표다. 연구가 던지는 질문은 기존 시각 언어 모델(VLM)을 재훈련하지 않고 추론 시 계산량을 늘려 신뢰할 수 있는 로봇 동작을 얻을 수 있는가 하는 것이다.
SAIL은 맥락으로 제공한 소수의 성공 사례에서 전체 동작 경로를 생성해 시뮬레이션에서 실행한다. 그러면 두 번째 VLM이 영상을 보고 작업 진행도를 추정하며, 이 피드백이 몬테카를로 트리 탐색(MCTS)을 이끈다. 선택된 동작 경로만 실제 로봇에 전달된다. Gemini Robotics-ER 1.5가 가중치 변경 없이 두 역할을 모두 맡는다.
| 평가 방법 | 탐색 노드 수 | 시뮬레이션 작업 6개의 평균 성공률 |
|---|---|---|
| 단일 생성 | 1 | 25 % |
| 깊이 우선 탐색 | 15 | 37 % |
| 너비 우선 탐색 | 15 | 51 % |
| SAIL | 6 | 55 % |
| SAIL | 15 | 65 % |
| SAIL | 45 | 73 % |
이 비율은 주어진 예산 안에서 성공적인 동작 경로를 찾은 설정을 센 것이다. ALOHA 시뮬레이터에서 작업마다 설정 20개를 사용했고, 성공 여부는 VLM이 아닌 시뮬레이터가 검증했다. LeRobot SO-101 로봇팔에서 SAIL은 후보 경로 15개를 허용했을 때 블록을 그릇에 넣는 작업을 6번 중 5번 성공했다. 찾은 경로로 학습한 모방 정책도 더 빠르게 실행하면서 6번 중 5번 성공했다. Sakana는 개방 루프 실행, 탐색에 필요한 추가 계산, 한 가지 작업과 방법당 6번의 시도로 제한된 실제 로봇 평가를 한계로 인정한다.
🔗 Sakana AI 게시물 · SAIL 프로젝트 페이지
ProjectSim, 로봇공학 벤치마크 현황을 짚다
9월 28일 — 시뮬레이션 점수와 실제 점수 사이의 격차가 바로 ProjectSim의 첫 실험 주제다. 자체 실험 결과를 제시하지 않는 개괄 글에서 Luca Cilio는 MetaWorld와 LIBERO부터 RoboChallenge 같은 공동 물리 테스트까지 로봇 조작 벤치마크를 살펴본다. 또한 RoboCasa365의 수치를 들어, 시연 데이터 30,000개로 미세 조정한 GR00T N1.5가 개별 기술에서는 43%의 성공률을 보이지만 미세 조정 과정에 없던 기술 조합에서는 4.4%로 떨어진다고 지적한다. ProjectSim은 기하 구조, 외관, 물리적 특성을 재구성해 더 충실하게 만든 시뮬레이션 장면이 시뮬레이션 점수를 실제 로봇에서 측정한 점수에 가깝게 만드는지 확인하려 한다. 결과는 아직 발표되지 않았다.
Mistral, 뮌헨에 산업용 AI 및 물리학용 AI 허브 개설
9월 28일 — Mistral이 뮌헨에 허브를 연다. 이곳에는 물리학용 AI(Physics AI)와 산업용 AI(Industrial AI) 연구팀, 협력 기업과 직접 일하는 응용 엔지니어들이 들어선다. Mistral은 이곳에서 소프트웨어 공급업체보다 장기 기술 파트너로 자리매김한다.
| Mistral이 언급한 협력사 | 발표된 작업 |
|---|---|
| BMW | 충돌 시뮬레이션 및 엔지니어링 AI |
| Siemens Energy | 산업용 AI 응용 |
| 뮌헨 공과대학교(TUM) | 자동차 공기역학을 위한 풍동 디지털 트윈 |
이 허브는 2026년 5월 Emmi AI 인수의 연장선에 있다. 당시 Mistral에는 전산유체역학(CFD), 구조역학, 다중물리 시뮬레이션을 전문으로 하는 물리학자, 연구자, 엔지니어 30여 명이 합류했다. Mistral은 TUM 및 Nikolaus A. Adams 교수와 함께 풍동 센서의 실시간 측정값과 오프라인으로 계산한 CFD 시뮬레이션을 결합해, 정확한 실시간 공기역학 예측을 제공하는 자동차 공기역학용 디지털 트윈을 개발할 예정이다.
게시글은 데이터가 조직 밖으로 나가지 않는 가운데 고객이 가중치에 접근하고 자체 인프라에서 유럽 법률의 적용을 받으며 모델을 실행할 수 있다는 데이터 주권 주장을 되풀이한다. 또한 Mistral이 2030년까지 유럽에 1기가와트의 컴퓨팅 용량을 구축하겠다고 밝힌다. 독일 연방 디지털전환부 장관 Karsten Wildberger와 바이에른주 총리실장 Florian Herrmann의 발언도 인용한다. Mistral은 뮌헨 지역에서 채용 중이지만 채용 규모나 투자 금액은 밝히지 않았다.
NVIDIA와 Nscale이 측정한 DSX MaxLPS: 같은 전력 예산에서 GPU 37%, 처리량 49% 증가
9월 27일 — NVIDIA가 Nscale과 함께 수행한 DSX MaxLPS의 정량 평가를 발표했다. DSX MaxLPS는 운영자의 정책에 따라 AI 팩토리의 자원 간 전력을 배분하는 소프트웨어다. NVIDIA에 따르면 승인된 동일 전력 예산에서 GPU를 최대 40% 더 배치할 수 있다. 게시글은 이것이 시설의 전력 공급을 늘린 결과가 아니라 전력 배분을 조율한 결과라고 강조한다.
테스트는 아이슬란드 케플라비크의 Verne 캠퍼스에 있는 Nscale 데이터센터에서 GB300 NVL72로 진행됐다. 이 데이터센터는 전적으로 재생에너지로 가동된다. 테스트에는 FP4 형식의 Kimi K2.5, NVIDIA Dynamo, TensorRT LLM이 사용됐다. 동일하게 할당된 전력 예산 264.4 kW에서 GPU 수는 140개에서 192개로 늘었고, 기존 인스턴스의 처리량은 떨어지지 않았다.
| 측정 지표 | 고정 기준 | DSX MaxLPS 적용 | 측정된 차이 |
|---|---|---|---|
| 관리되는 GPU | 140 | 192 | +37,1 % |
| 정규화된 총처리량 | 1 084 503 tokens/s | 1 618 443 tokens/s | +49,2 % |
| 측정된 총전력 | 166,2 kW | 198,9 kW | +19,7 % |
| 전력 예산 사용률 | 62,9 % | 75,2 % | +12,3%포인트 |
| 할당된 전력 와트당 처리량 | 4,10 tokens/s/W | 6,12 tokens/s/W | +49,2 % |
게시글은 대가도 숨기지 않는다. 지연 시간의 중앙값과 P75는 기준치에서 5% 이내를 유지하지만, 첫 토큰까지 걸리는 시간의 P99는 기준값 15.7초에서 17% 증가한다. NVIDIA는 운영자에게 전력 범위 설정부터 운영 한도 확정까지 5단계 검증을 권고한다. 이번 평가는 9월 15일 발표된 Lambda의 HGX B200 검증에 이은 것이다. 당시에는 GPU 노드 16개분의 예산으로 19개를 운영했다. 유입 냉각수 온도 45 °C를 전제로 한 Vera Rubin 전망치는 별도로 제시된다.
단신
- DeepSeek Harness 0.2.0-rc.1 — 0.2.0 시리즈의 첫 출시 후보이자 DeepSeek 에이전트 하네스의 23번째 사전 출시 버전으로, 안정 버전은 여전히 없다. DeepSeek 계정의 모델과 나누는 대화에서는 추가 API 키 없이 웹 검색을 사용할 수 있고, 자동화 작업은 선택형 플러그인 패키지로 옮겨졌다. 🔗 출처
- Vercel AI Gateway의 Pixel Canary — Vercel은 9월 25일부터 비공개 시험 기간 동안 이름을 밝히지 않은 한 개발사의 이 코드 모델을 무료로 제공한다. Next.js 작업 31개 중 28개를 pass@4에서 해결해 GPT-6 Astra (high)와 동률을 기록했고, AGENTS.md를 통해 문서를 제공하면 31개 중 30개를 해결한다. 데이터 무보존 옵션은 없다. 🔗 출처
- GitHub Actions의 자체 호스팅 러너 — GitHub Enterprise Cloud에서는 9월 29일부터 최소 버전 요구 사항이 전면 적용된다. 2.329.0 미만 버전의 러너는 등록할 수 없고, 실행에 필요한 최소 버전보다 낮은 러너는 작업을 받지 않는다. 새로운 REST API는 지원 종료일을 제공한다. GitHub Enterprise Server에는 적용되지 않는다. 🔗 출처
- NexteraBERT — Rikka Botan이 매개변수 2억 1,260만 개의 양방향 인코더를 공개했다. 사전 학습에 사용한 토큰은 1,300억 개로 ModernBERT보다 약 15배 적다. 자체 측정에 따르면 GLUE 점수는 87.90으로 ModernBERT-base의 87.97과 비슷하고, MTEB v2에서는 54.70으로 53.63을 앞서며, 토큰 65,536개에서 처리량은 5.22배 높다. 코드는 MIT 라이선스로 공개됐다. 🔗 출처
- 실시간 LTX-2.5 — 커뮤니티 게시글에서 매개변수 220억 개의 이 오디오·비디오 모델은 클립당 90초가 걸리던 상태에서 재생보다 빠르게 생성하는 수준에 도달했다. 96 Go 카드에서 5초짜리 클립을 1.83초에 생성하며, 8단계 대신 4단계, NVFP4 연산, CUDA Graph를 활용한다. 코드는 Apache-2.0으로 공개됐다. 🔗 출처
- SCRIBE — 인도 법원용 음성 인식 기술을 만드는 Adalat AI가 이 오픈소스 평가 도구를 PyPI에 공개했다. 관련 논문은 Interspeech 2026에 발표됐다. 일반적인 단어 오류율이 교정자라면 손대지 않을 말라얄람어 문장에 100%의 오류율을 부여하는 반면, SCRIBE는 단어, 숫자, 문장부호, 업무 전문 용어를 각각 평가한다. 🔗 출처
- JEV 프로젝트 228개 — Awesome JEV 목록을 관리하는 Eric Kang은 GitHub에서 « jev »를 검색했을 때 나오는 저장소 13,473개 가운데 오픈소스 프로젝트 228개를 추렸다. 관련 없는 프로젝트도 섞인 검색 결과에서 10개 유형별로 별 50개 이상인 프로젝트를 골라 각각 특정 커밋으로 고정한 것으로, 독립적인 전수조사가 아닌 수작업 선별 결과다. 🔗 출처
- HeyGen과 Jev — HeyGen이 X에 공개한 가이드에서는 TypeSafe AI의 의사결정 모델 Jev를 자사 MCP 서버 앞단에 배치한다. Jev가 약 40명의 잠재 고객을 동영상 제작 여부, 접근 방식, 언어, 적합성에 따라 분류하면 Claude가 대본을 쓰고 HeyGen MCP가 묶음으로 제작한다. 크레딧을 소비하고 승인을 기다리는 단계는 마지막 단계뿐이다. 🔗 출처
- Gemini 3.8 Flash로 만든 작품 네 가지 — Google 블로그가 9월 2일 출시한 모델로 만든 사례 네 가지를 소개한다. Antigravity로 만든 실시간 위성 추적기, 움직이는 세이가이하 파도 무늬, 티라노사우루스 3D 골격, 카메라 시점 10개로 볼 수 있는 자동변속기다. 수치나 새로운 제품 기능은 제시하지 않았다. 🔗 출처
- 브루클린 출장요리 업체와 Gemini — Google 블로그는 Greenpoint의 식료품점 Edy’s Grocer 소유주 Edy Massih가 Gemini를 사용해 조리법을 200인분으로 조정하고, 장보기 목록을 만들고, 식단 제한에 맞춰 메뉴를 바꾸는 방법을 소개한다. 새로운 기능은 없다. 🔗 출처
- Lenfest Institute — OpenAI는 2024년 미국 뉴스룸 11곳에서 시작한 Lenfest Institute의 AI 펠로 프로그램 다음 단계에 500만 달러를 투입하고, 소프트웨어 크레딧과 엔지니어링 지원으로 최대 500만 달러를 추가 제공한다. 이전 지원액의 두 배다. 🔗 출처
- ChatGPT 건강 탭 — 이제 Health 탭에서 그래프, 지표 또는 기록을 선택하면 프롬프트를 작성하지 않아도 맞춤형 설명을 볼 수 있으며, 경우에 따라 대화형 그래프도 제공된다. Health는 여전히 미국에서만 이용할 수 있다. 대상은 18세 이상이며 Free, Go, Plus, Pro 요금제의 웹 및 iOS 사용자다. 🔗 출처
- WebMCP Challenge 수상작 — OpenAI Developers가 8월 말 시작한 해커톤의 수상 프로젝트 10개(MASIL, Alza, ArchMorph, Aisle, Roque Nights, Mandate, Observatory, Bouquet Studio, Faraday, JupyterLite WebMCP)를 소개했다. 순위나 프로젝트별 상금은 밝히지 않았다. 🔗 출처
- macOS 보안 수정 — 9월 25일 출시된 macOS 데스크톱 앱 버전 26.924.20706은 Patrick Wardle(Objective-See Foundation)이 신고한 CVE-2026-100754 취약점을 수정했다. 이 항목은 ChatGPT와 Codex 변경 기록의 Codex 앱 항목에 실렸으며, 취약점 자체에 대한 설명은 없다. 🔗 출처
이것이 의미하는 것
토큰 단가는 그대로지만 작업에 필요한 토큰 수가 줄고 있다. Sonnet 5.5의 요금은 Sonnet 5와 같지만 Anthropic에 따르면 토큰을 덜 소비해 작업당 비용이 최대 30% 낮다. Devin은 SWE-2를 포함한 최신 모델을 통합하고 도구 호출을 묶어 비용을 30~40% 낮췄다. Manus는 시험한 구성에서 새 하네스로 실행 비용을 32% 줄였다고 발표했다. 이제 비용을 좌우하는 것은 표시된 단가보다 모델과 하네스가 작업에 소비하는 양이다. 중간급 모델도 상위 모델을 따라잡고 있다. Terminal-Bench 4.0에서 Sonnet 5.5는 Xhigh 노력 수준으로 측정한 Opus 5.5의 점수를 넘어섰다.
에이전트는 기본적으로 더 자율적으로 움직이고, 안전장치는 에이전트가 접근할 수 없는 곳으로 옮겨지고 있다. Claude Code는 이제 모든 요금제에서 자동 모드로 시작한다. 한편 NVIDIA는 에이전트가 접근할 수 없는 DPU에 감시 기능을 두고, 에이전트가 제안하는 모든 접근 규칙에 기본적으로 사람의 승인을 요구한다. 다른 도구도 같은 흐름을 따른다. Codex CLI는 높은 권한이 필요한 명령의 터미널 입력에 승인을 요구하고, Copilot SDK는 MCP 서버나 skill을 설치하기 전에 사람의 검토를 요구하도록 설정할 수 있다. 에이전트가 단독으로 하는 일이 늘수록 통제 기능은 에이전트 외부에 있어야 한다.
에이전트는 고유한 정체성을 가진 팀원이 되어가기도 한다. Perplexity의 Profiles는 프로젝트 전체에서 재사용할 수 있는 버전 관리형 에이전트 설정을 제공한다. SpaceXAI의 Team Bots는 각자의 Slack 식별자를 가지고 사용자별로 별도의 기억을 유지한다. Cue의 에이전트에는 이메일 주소, 전화번호, 지갑이 주어진다. 누군가를 대신해 결제하고 전화하고 글을 쓸 수 있는 에이전트는 같은 날 NVIDIA가 제기한 통제 문제를 구체적인 현실로 만든다.
마지막으로 이날 나온 수치는 주의 깊게 읽어야 한다. Devin은 트윗과 그래프에서 이름이 서로 다르게 적힌 FrontierCode 변형으로 Sonnet 5.5를 측정했고, 같은 날 Cognition이 발표한 두 그래프는 Opus 5.5에 서로 다른 점수를 부여한다. Holo4는 H의 하네스에서 OSWorld 2.0을 단 한 차례 실행해 측정했다. SAIL의 73%는 시뮬레이션에서 얻은 수치이며, 시뮬레이션과 현실의 격차가 바로 ProjectSim의 첫 실험 주제다. 미디어 모델에서는 Eleven v4가 외부 순위와 블라인드 테스트를 근거로 내세우는 반면, Kling 4.0은 벤치마크나 요금 정보 없이 출시됐고 일부 기능은 추후 제공될 예정이다.
출처
- Claude Sonnet 5.5 소개 (Anthropic)
- Claude Sonnet 5.5로의 이전 가이드
- @ClaudeDevs: Sonnet 5.5의 노력 수준 권장 사항
- GitHub Copilot의 Claude Sonnet 5.5
- GitHub Copilot 모델과 요금
- Devin의 Claude Sonnet 5.5
- @cognition: FrontierCode 1.1 Main에서의 Sonnet 5.5
- @cursor_ai: Cursor의 Sonnet 5.5
- @v0: v0의 Sonnet 5.5
- NVIDIA, Open Agent Safety Platform 출시 (보도자료)
- Open Agent Safety Platform의 구조 (NVIDIA)
- NVIDIA OpenShell로 AI 에이전트에 런타임 제어 기능 추가
- @NVIDIAAI: CNBC에 출연한 Jensen Huang
- @togethercompute: 출시 협력사
- @perplexity_ai: NVIDIA와의 협력
- Manus 2.0 소개
- @ManusAI: Cue 출시
- @ManusAI: 에이전트 전화번호
- Eleven v4 소개 (ElevenLabs)
- @ElevenLabs: Eleven v4 발표 게시물 모음
- Kling 4.0 출시 노트
- @Kling_ai: Kling 4.0 발표
- Claude Code v2.1.284
- Codex CLI 0.158.0
- Copilot CLI v1.0.89
- Copilot SDK v1.0.15
- Devin의 비용 효율 최대 40% 향상
- 9월 25일 Devin 출시 노트
- @cognition: Devin Mobile 베타
- @zeddotdev: Delta 0.18
- Gemini CLI v0.63.0-nightly.20260928
- Agent API, 재사용 가능한 에이전트 지원 (Perplexity)
- Perplexity API 변경 기록
- Team Bots (SpaceXAI)
- @bot: Team Bots 발표
- Hugging Face 블로그의 Holo4
- Holo4 (H Company)
- SAIL (Sakana AI)
- SAIL 프로젝트 페이지
- 로봇공학 벤치마크: 현재 위치와 다음 단계 (ProjectSim)
- 안녕하세요, 독일! (Mistral AI)
- NVIDIA DSX MaxLPS가 AI 팩토리 처리량과 효율을 극대화하는 방법
- DeepSeek Harness 0.2.0-rc.1
- Vercel AI Gateway의 Pixel Canary
- 자체 호스팅 러너 버전 적용일 변경 (GitHub)
- NexteraBERT 기술 보고서
- 220억 매개변수 비디오 확산 모델로 만든 실시간 대화형 캐릭터
- SCRIBE (Adalat AI)
- JEV: 선정된 프로젝트 228개 (Eric Kang)
- @HeyGen: Jev 및 HeyGen MCP 가이드
- 제작자 4명이 Gemini 3.8 Flash로 만든 것들 (Google)
- 이 식료품점이 Gemini로 손님 200명의 음식을 준비하는 세 가지 방법 (Google)
- Lenfest AI Collaborative: 새 단계 (OpenAI)
- ChatGPT 출시 노트
- @OpenAIDevs: WebMCP Challenge 수상작
- ChatGPT와 Codex 변경 기록: CVE-2026-100754