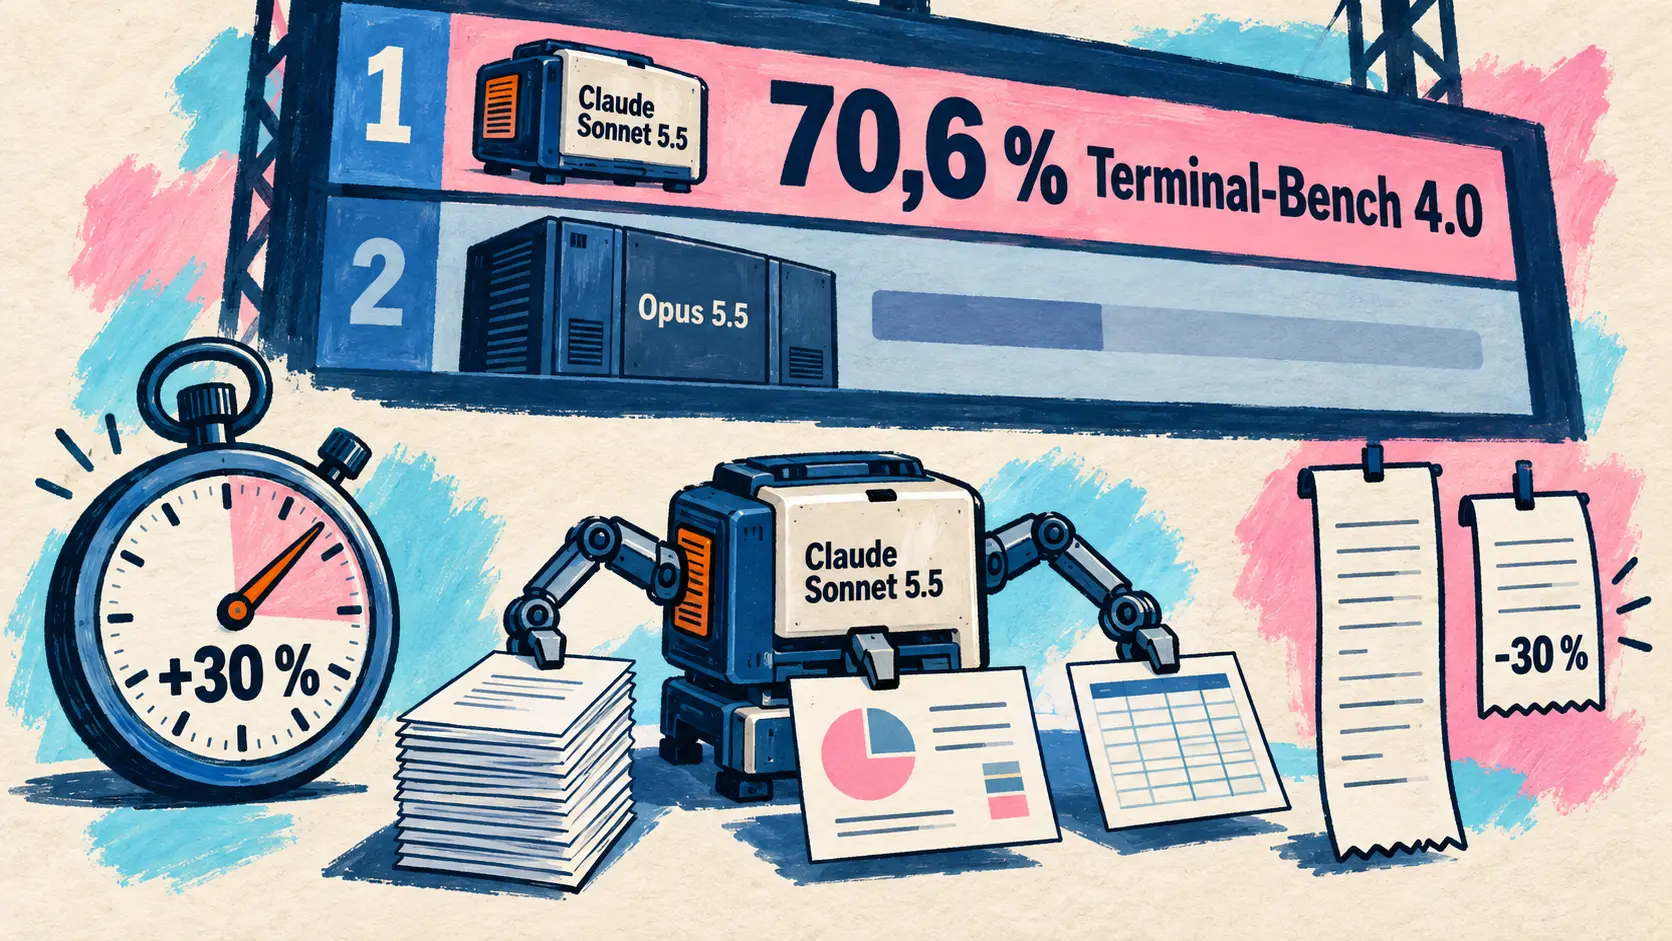
Lundi 28 septembre, six jours après Opus 5.5, Anthropic lance Claude Sonnet 5.5 : même tarif que Sonnet 5, une génération plus de 30 % plus rapide et 70,6 % sur Terminal-Bench 4.0, contre 10,3 % pour son prédécesseur ; GitHub Copilot, Devin, Cursor et v0 l’ouvrent le jour même. NVIDIA présente Open Agent Safety Platform, qui surveille les agents du logiciel jusqu’au silicium avec plus de 100 organisations, Manus passe en 2.0 et lance Cue, ElevenLabs sort Eleven v4 et Kling annonce Kling 4.0 pour octobre. Côté agents de code, Claude Code 2.1.284 démarre en mode auto sur tous les forfaits et Devin devient 30 à 40 % moins cher.
Anthropic lance Claude Sonnet 5.5, plus rapide et moins cher par tâche que Sonnet 5
28 septembre — Six jours après Claude Opus 5.5, Anthropic lance Claude Sonnet 5.5 (claude-sonnet-5-5), deuxième modèle de la famille Claude 5.5. Présenté comme une nette amélioration (clear upgrade) de Sonnet 5, il génère ses réponses plus de 30 % plus vite et coûte, dans les tests d’Anthropic, jusqu’à 30 % de moins par tâche, parce qu’il lui faut bien moins de tokens pour le même travail. Opus 5.5 reste le modèle du travail complexe qui exige un jugement soigné ; Sonnet 5.5 vise les tâches quotidiennes bien cadrées : corriger des bugs, produire des documents, des présentations et des tableurs soignés. Claude Haiku 5.5, pensé pour les gros volumes, doit suivre dans les prochaines semaines.
L’écart le plus net avec Sonnet 5 apparaît sur Terminal-Bench 4.0, une évaluation de programmation agentique en ligne de commande : 70,6 % contre 10,3 %, au-dessus des 66,4 % d’Opus 5.5, mesurés à l’effort Xhigh, son meilleur résultat. Sur GDPval-AA, consacré au travail intellectuel, Sonnet 5.5 finit à deux points d’Opus 5.5 et environ 400 points au-dessus de Sonnet 5. C’est aussi le premier Sonnet à terminer Pokémon Rouge en ne travaillant qu’à partir de captures d’écran.
| Benchmark (chiffres Anthropic) | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % (Xhigh) | — |
| FrontierCode 1.1 Main | 52,1 % (Xhigh), 46,2 % (Max) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | — |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 | 1483 |
| Humanity’s Last Exam (avec outils) | 64,5 % | 54,9 % | 67,7 % | — |
| OSWorld 2.1 (partiel) | 80,1 % | 57,0 % | 81,8 % | — |
| Chartography (sans outils) | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
Anthropic assortit ces chiffres de réserves. Sur FrontierCode, Sonnet 5.5 recule à l’effort Max, où il lance plus souvent le skill de revue de code de Claude Code, au point de dépasser le délai ou de sortir du périmètre de la tâche dans deux cas examinés par Cognition ; GDPval-AA et AA-Briefcase ont été mesurés sur une préversion touchée par un bug, à l’effet jugé faible. Surtout, Anthropic juge Opus 5.5 nettement plus fort sur le travail ouvert et complexe qui demande un jugement soutenu.
Le tarif ne bouge pas : 2 dollars par million de tokens en entrée, 10 dollars en sortie et 0,20 dollar en lecture de cache, comme Sonnet 5 ; en entrée et en sortie, c’est moitié moins qu’Opus 5.5 (4 et 20 dollars). L’économie vient du nombre de tokens consommés : aux efforts Low ou Medium, Sonnet 5.5 dépasse le meilleur score de Sonnet 5 sur plusieurs benchmarks pour environ un dixième du coût par tâche. Le modèle accepte 1 million de tokens de contexte et produit jusqu’à 128 000 tokens en sortie ; l’effort par défaut est Medium dans Claude Code et les applications Claude, High sur la Claude Platform.
We recommend starting with Opus for large projects and Sonnet for tasks where you need to balance quality with speed and cost.
🇫🇷 Nous recommandons de commencer avec Opus pour les gros projets et avec Sonnet pour les tâches où il faut équilibrer qualité, vitesse et coût. — @ClaudeDevs sur X
Ses capacités en cybersécurité étant comparables à celles d’Opus 5, Sonnet 5.5 est le premier Sonnet lancé avec des garde-fous cyber du niveau des modèles les plus capables : les demandes à haut risque basculent visiblement sur Sonnet 5, sans toucher à la correction de bugs courante. C’est aussi le premier Sonnet doté de classifieurs de sécurité qui empêchent l’extraction de son raisonnement, et sa réflexion reste désormais liée au compte qui l’a produite.
Pour les développeurs, passer à claude-sonnet-5-5 ne se limite pas à changer d’identifiant : la documentation liste cinq changements cassants face à Sonnet 5, dont le remplacement de la désactivation de la réflexion par le réglage between_tools et le refus du choix d’outil forcé (tool_choice à any ou tool, erreur 400). La commande /claude-api migrate assiste la migration dans Claude Code.
Sonnet 5.5 est disponible dès aujourd’hui sur la Claude Platform, dans Claude Code et chez Amazon Web Services, Google Cloud et Microsoft Azure, sans détail par forfait (Free, Pro, Max) dans les sources. Dans Claude Code, la version 2.1.284 en fait le modèle Sonnet par défaut sur l’API Anthropic (voir la section consacrée aux agents de code).
🔗 Annonce de Claude Sonnet 5.5 · Guide de migration vers Sonnet 5.5
GitHub Copilot l’ouvre dès la formule Pro
28 septembre — GitHub ouvre Claude Sonnet 5.5 en disponibilité générale dans Copilot (entrée du changelog à 11 h 03 PT). Contrairement à Claude Opus 5.5, arrivé le 22 septembre sans la formule Pro, il est proposé à Copilot Pro, Pro+, Max, Business et Enterprise, sur dix surfaces : Visual Studio Code, Visual Studio, Copilot CLI, l’agent de code Copilot, l’application GitHub Copilot, github.com, GitHub Mobile, les IDE JetBrains, Xcode et Eclipse, avec un déploiement progressif.
GitHub affirme que, lors de ses premiers tests, Sonnet 5.5 égale Claude Sonnet 5 sur les tâches de code avec nettement moins d’étapes, de tokens et d’appels d’outils, et termine plus vite, sans publier de chiffre. Le modèle est facturé à l’usage au tarif public du fournisseur : la documentation de GitHub indique 2 dollars en entrée et 10 dollars en sortie par million de tokens, la même ligne que Claude Sonnet 5. Pour Business et Enterprise, l’activation par défaut des nouveaux modèles l’ouvre automatiquement, sauf si un administrateur a désactivé ce réglage ou ce modèle.
🔗 Claude Sonnet 5.5 dans GitHub Copilot · Modèles et tarifs de Copilot
Devin le mesure à 64,4 % sur FrontierCode 1.1
28 septembre — Cognition ouvre Sonnet 5.5 dans Devin Desktop et Devin CLI le jour de sa sortie et le mesure à 64,4 % sur FrontierCode 1.1, son banc d’essai qui vérifie le respect des exigences de bases de code de production, contre 56,2 % pour Sonnet 5. Il passe devant Claude Fable 5.1 (63,6 %) et se glisse juste derrière le trio de tête du graphique : Opus 5.5 (65,3 %), Fable 5 (64,9 %) et GPT-6 Astra (64,5 %).
Le tweet de Cognition parle de la variante Main, mais le graphique du billet est titré Extended et reprend, pour les autres modèles, les valeurs publiées le 22 septembre pour cette variante. À titre de repère, Anthropic donne 52,1 % à Sonnet 5.5 sur la variante Main, à l’effort Xhigh. Cognition relaie enfin les chiffres d’Anthropic : une génération plus de 30 % plus rapide et un coût par tâche jusqu’à 30 % inférieur à Sonnet 5, à prix des tokens inchangé.
🔗 Claude Sonnet 5.5 dans Devin · Cognition sur X
Cursor et v0 l’ouvrent le jour même
28 septembre — v0, l’outil de création d’applications de Vercel, ouvre Sonnet 5.5 à 18 h 04 UTC, une minute après l’annonce ; Cursor suit à 20 h 14 UTC et le décrit comme un modèle solide, au niveau d’Opus sur de nombreuses tâches, sans préciser de quel Opus il s’agit. Aucun tarif ni mesure propre à l’outil : comme pour Opus 5.5 le 22 septembre, il s’agit d’une simple disponibilité.
🔗 Cursor sur X · v0 sur X
NVIDIA lance Open Agent Safety Platform pour surveiller les agents du logiciel jusqu’au silicium
28 septembre — NVIDIA lance Open Agent Safety Platform, une plateforme logicielle ouverte doublée d’une conception de système de référence, pour sécuriser les agents IA du test au déploiement, avec gouvernance et contrôle sur toute la pile (logiciel, matériel, calcul et systèmes robotiques). Le constat de départ, posé dans le billet d’architecture : plusieurs laboratoires de pointe ont récemment rapporté des agents sortis des environnements d’évaluation censés les contenir. Parmi les cinq principes retenus, la politique doit être vérifiable et appliquée hors bande, c’est-à-dire hors de portée de l’agent.
| Composant de la plateforme | Rôle annoncé par NVIDIA |
|---|---|
| NVIDIA OpenShell (open source, version 0.1) | Environnement d’exécution (runtime) en bac à sable : politique vérifiée formellement et appliquée hors de l’agent, sur CPU Vera et plateformes tierces (Arm, Intel) |
| NVIDIA Sentry (conception de référence) | Chien de garde hors bande sur DPU BlueField-4, qui met un agent en quarantaine en quelques millisecondes |
| NVIDIA DOCA | Inspection des requêtes et réponses, télémétrie attestée, identité de l’agent, accès zéro confiance |
OpenShell, environnement d’exécution open source (Apache 2.0) suivi depuis mars, passe en version 0.1 (0.1.0 publiée sur GitHub le 25 septembre, 0.1.2 le 28) et est désormais annoncé comme largement disponible, pour les modèles ouverts comme fermés. Chaque agent tourne dans un bac à sable (sandbox) aux contrôles noyau ; un superviseur extérieur inspecte le trafic HTTP, GraphQL et MCP (une lecture passe, une écriture sur la même API est bloquée), et l’agent accède aux services sans que les identifiants réels lui soient exposés. Les politiques s’écrivent en YAML, se compilent en OPA/Rego et passent par un prouveur formel ; lorsqu’un accès manque, l’agent peut proposer une règle étroite, qui attend par défaut une validation humaine sans qu’il puisse l’approuver lui-même. OpenShell prend en charge Codex, Claude Code, Pi et Hermes. Lors d’essais adverses de longue durée, rapporte NVIDIA, des agents de pointe aux garde-fous réduits ont passé jusqu’à deux heures à tenter de convaincre un relecteur IA de leur ouvrir un dépôt GitHub protégé, sans qu’aucune écriture n’y ait lieu.
Sentry, la seconde brique, déplace la surveillance dans le matériel : un chien de garde hors bande (out-of-band watchdog) sur DPU BlueField-4, bâti sur DOCA, qui surveille en continu le comportement des agents, vérifie leur identité et peut mettre en quarantaine en quelques millisecondes celui qui sort de ses limites. Dans un POD Vera Rubin, chaque plateau de calcul place un BlueField-4 sur le seul chemin du nœud vers le modèle ; sur un système Vera déjà équipé de BlueField-4, l’activation relève d’une mise à jour logicielle selon NVIDIA.
NVIDIA revendique plus de 100 organisations qui travaillent avec les technologies de la plateforme. Anthropic intègre à OpenShell et BlueField ses Claude Managed Agents, qui exécutent la boucle de l’agent sur un serveur distinct des bacs à sable ; SpaceXAI applique la plateforme aux agents de code Cursor et aux modèles Grok ; Salesforce suit l’activité des agents OpenShell depuis Slack, où l’on approuve ou refuse leurs demandes de permissions ; SAP l’intègre à l’environnement d’exécution de Joule Studio et Scale AI à son offre GenAI. La liste s’étend de Microsoft, IBM, Palantir, CrowdStrike et Hugging Face à la robotique (Figure, Skild AI), à la finance (Citi, JPMorganChase), aux systèmes d’exploitation (Canonical, SUSE, Red Hat) et aux fournisseurs d’infrastructure (CoreWeave, Nebius, Oracle Cloud Infrastructure). Les logiciels, dont OpenShell et des skills, sont disponibles sur GitHub et sur la page développeurs de NVIDIA, et Jensen Huang est venu présenter ces mesures sur CNBC le jour même.
🔗 Communiqué NVIDIA · Architecture de la plateforme · OpenShell 0.1.0 en pratique · Jensen Huang sur CNBC (@NVIDIAAI)
Together AI et Perplexity relaient l’annonce
28 septembre — Together AI se dit partenaire de lancement de la plateforme, quand le communiqué de NVIDIA le range parmi les fournisseurs d’infrastructure. Le fournisseur d’inférence rappelle avoir construit des fonctions de plateforme pour développer et déployer des agents de façon sécurisée, et dit poursuivre ses investissements dans ce domaine, notamment avec NVIDIA autour d’OpenShell, sans chiffre ni produit nommé.
Perplexity, cité deux fois dans le communiqué (parmi les acteurs qui rejoignent NVIDIA, puis parmi les plus de 100 organisations qui utilisent les technologies de la plateforme) mais sans rôle précis, ouvre un fil de neuf messages :
We’re partnering with Nvidia and 100+ industry partners to build infrastructure that contains rogue AI agents.
🇫🇷 Nous nous associons à NVIDIA et à plus de 100 partenaires industriels pour bâtir une infrastructure qui confine les agents IA incontrôlés. — @perplexity_ai sur X
La suite du fil reprend Escaping SPACE, l’audit de sécurité de son bac à sable publié le 23 septembre et couvert alors (aucune évasion de la machine virtuelle en 108 essais). Ce billet ne citait NVIDIA qu’à travers OpenShell, l’un des bacs à sable tiers testés, sur lequel aucun des deux contournements n’avait réussi.
Manus passe en 2.0 avec le harnais Cascade et lance Cue, une application d’agents personnels
28 septembre — Manus lance Manus 2.0, qu’il présente non comme une mise à jour de version, mais comme une nouvelle architecture accompagnée de nouveaux produits. L’annonce arrive moins d’un mois après la reprise des opérations indépendantes de Manus, le 1er septembre.
La fondation s’appelle Cascade, la dernière itération du harnais d’agent maison : chaque projet démarre léger et ne reçoit des capacités spécialisées que lorsque le travail l’exige, le brief, la page, la vidéo et l’automatisation restant réunis dans un même projet. Manus chiffre le gain face à son système précédent, mais dans une seule configuration testée, que le billet ne détaille pas.
| Mesure annoncée par Manus (une configuration testée) | Écart face au système précédent |
|---|---|
| Tokens consommés | -23,2 % |
| Durée des tâches | -28,2 % |
| Coût d’exécution | -32 % |
Deux briques complètent l’ensemble : le Cloud Computer, un environnement dédié que l’on achète pour ce qui doit tourner en permanence (le serveur d’un jeu multijoueur, une automatisation), et des automatisations qui se déclenchent désormais sur un événement d’un service connecté (nouvel e-mail, variation des performances publicitaires, rendez-vous d’agenda, message Slack, mise à jour Notion), configurées en un seul prompt.
L’application de bureau devient Manus Studio, un espace de travail partagé entre personnes et IA qui ne charge que les outils utiles au projet. Deux environnements y apparaissent. Video Editor produit un premier montage puis ouvre une ligne de temps (timeline) où clips, images, textes, animations et audio restent séparés et modifiables ; il vise les publicités produit de 30 à 60 secondes, les tutoriels ou les vlogs, et son mode Alchemy confie la direction créative à l’IA. Game Dev combine modèles vidéo, image et code, publie un jeu jouable par simple lien et règle le multijoueur en achetant un Cloud Computer. Avec Remote Control et Computer Use, on confie enfin à Manus, depuis son téléphone, une tâche à mener sur son propre ordinateur, en suivant le bureau en direct.
Troisième volet, Cue est une nouvelle application autonome d’agents personnels, sur téléphone et ordinateur, bâtie sur l’infrastructure de Manus. Chaque agent y dispose de sa propre adresse e-mail, de son numéro de téléphone, de son portefeuille et de son ordinateur : il envoie des messages, paie dans la limite du budget fixé, prend des appels et en laisse un résumé. Plusieurs agents peuvent partager un objectif dans une discussion de groupe, et Cue s’ouvre aux services du quotidien, comme commander au restaurant en scannant un QR code. En fin de journée, Manus a précisé que ces numéros permettent de passer et de recevoir appels et SMS, dans certains pays seulement et parfois en voix seule.
Manus 2.0 est disponible dès maintenant sur le web, le bureau et le mobile. Cue l’est aussi, la version iOS attendant l’examen de l’App Store, en accès anticipé gratuit sur code d’invitation, réservé à un nombre limité de premiers utilisateurs. Le billet ne donne aucun tarif, pas même pour le Cloud Computer, ne nomme aucun modèle sous-jacent et ne cite aucune évaluation externe.
🔗 Introducing Manus 2.0 · Annonce de Cue sur X · Numéros de téléphone des agents
ElevenLabs lance Eleven v4, son modèle vocal le plus expressif, et une variante Turbo pour les agents
28 septembre — ElevenLabs lance Eleven v4, présenté comme son modèle de synthèse vocale (TTS) le plus émotif, et Eleven v4 Turbo, une variante basse latence pensée pour les agents conversationnels. Bâti sur une architecture entièrement nouvelle, Eleven v4 doit interpréter le ton, le rythme, l’émotion et le contexte d’un texte pour produire une diction dramatique, tendre, urgente ou comique sans perdre l’identité de la voix. ElevenLabs revendique la première place du classement Provider Voice Arena d’Artificial Analysis (septembre 2026) et une préférence d’environ 75 % des auditeurs en tests à l’aveugle face à Cartesia Sonic 3.6, Inworld TTS-2 et deux modèles TTS Gemini 3.8 de Google, les égalités comptant pour moitié.
Le jeu se dirige en langage naturel ou par des balises glissées dans le texte (rires, réplique en colère avec un accent français, pluie légère, téléphone qui vibre), qu’Eleven v4 suit plus fidèlement que ses prédécesseurs selon l’éditeur. La prise en charge de l’alphabet phonétique international (IPA) progresse nettement, et les dialogues à plusieurs voix gagnent en naturel, avec une nouvelle méthode de capture de l’identité des voix pour garder leur cohérence dans les agents, les livres audio et les publicités.
| Indicateur publié par ElevenLabs | Valeur annoncée |
|---|---|
| Classement Provider Voice Arena d’Artificial Analysis (sept.) | 1er |
| Préférence en tests à l’aveugle face à 4 modèles concurrents | environ 75 % |
| Latence d’inférence médiane d’Eleven v4 Turbo | environ 100 ms |
| Délai médian avant la première parole d’Eleven v4 Turbo | environ 150 ms |
| Langues prises en charge | plus de 90 (Eleven v3 : plus de 70) |
| Limite par requête d’Eleven v4 | 10 000 caractères (Eleven v3 : 5 000) |
| Audio minimal pour un clone instantané | 10 secondes |
Le délai avant la première parole a été mesuré en streaming WebSocket face à Cartesia, xAI, Google et OpenAI, latence réseau retirée, et Eleven v4 Turbo a été optimisé conjointement avec la plateforme ElevenAgents. Une voix enregistrée dans une langue parle les autres avec l’accent natif, et Eleven v4 accepte désormais les clones professionnels (Professional Voice Clones) ; l’enchaînement de longues générations, utile au Studio et à l’application Reader, devient plus fiable.
Les deux modèles sont disponibles dès maintenant dans ElevenAgents, ElevenCreative et via l’API (eleven_v4 et eleven_v4_turbo). Pendant deux semaines, l’API Eleven v4 est remisée à 22 dollars et celle d’Eleven v4 Turbo à 11 dollars par million de caractères, et Eleven v4 est gratuit pour les formules Creator et supérieures d’ElevenCreative, dans la limite de deux fois les crédits mensuels ; le prix catalogue n’est pas publié. Cette sortie succède à Eleven v3, commercialisé en février 2026.
🔗 Introducing Eleven v4 · Fil d’annonce sur X
Kling annonce Kling 4.0 pour octobre et ouvre Kling 4.0 Flash en accès anticipé
28 septembre — Kling AI présente Kling 4.0, sa nouvelle génération de modèle vidéo, dont la sortie officielle est prévue en octobre. Sa première déclinaison, Kling 4.0 Flash, est ouverte depuis le 28 septembre en accès anticipé à un groupe limité d’utilisateurs, les abonnés Ultra annuels selon le tweet d’annonce. Kling met en avant trois axes : le réalisme visuel, le contrôle créatif et la complétude du récit (narrative completeness).
Sur le papier, Kling 4.0 génère de 3 à 30 secondes de vidéo d’un seul tenant, jusqu’en 4K, avec un son stéréo sur deux canaux. Le récit se pilote avec jusqu’à 10 images clés et des prompts de 8 000 tokens au plus, et le système Omni Reference accepte jusqu’à 15 références par génération : 10 images, 5 vidéos cumulant 30 secondes au plus et 7 sujets, dont 3 tirés de vidéos, la référence audio se limitant à la voix. Des maquettes non texturées et des cartes de profondeur peuvent servir à caler mouvements et cadrages, et le montage retouche expressions, gestes, caméra, style ou arrière-plan sur jusqu’à 5 clips. Kling revendique aussi du texte lisible dans l’image et davantage de langues, d’accents et de dialectes, du cantonais au sichuanais et à l’anglais indien.
| Spécification technique | Kling 4.0 | Kling 4.0 Flash |
|---|---|---|
| Disponibilité | Sortie officielle en octobre | Accès anticipé limité depuis le 28 septembre |
| Modes de génération | Texte vers vidéo, image vers vidéo, première et dernière images, 10 images clés, Omni Reference | Texte vers vidéo, image vers vidéo, Omni Reference |
| Durée d’une génération | 3 à 30 secondes | 3 à 20 secondes |
| Résolution maximale | 4K (aussi 720p et 1080p) | 720p |
| Plage dynamique | HDR 10 bits en 1080p et 4K, annoncé pour plus tard | SDR 8 bits |
Tout n’est pas encore là. La note de version annonce pour plus tard (coming soon) la sortie HDR 10 bits en 1080p et 4K, que le tweet range pourtant parmi les fonctions de Kling 4.0, ainsi que l’extension d’une vidéo jusqu’à 2 minutes. Kling refond aussi sa page de création, qui réunit toutes les références dans un seul champ de saisie et ajoute un canevas où un agent exécute les tâches demandées. Aucun tarif, aucun accès API ni aucun benchmark n’accompagne l’annonce, illustrée par un court métrage réalisé avec Kling 4.0, THE BEAT.
🔗 Note de version de Kling 4.0 · Annonce sur X
Agents de code : Claude Code 2.1.284, Codex CLI 0.158.0, Copilot CLI 1.0.89 et son SDK, Devin, Delta et Gemini CLI
Claude Code 2.1.284 démarre en mode auto sur tous les forfaits et fournisseurs
28 septembre — Publiée à 18 h 02 UTC, quelques instants avant l’annonce du modèle, Claude Code 2.1.284 ajoute Claude Sonnet 5.5, qui devient le modèle Sonnet par défaut sur l’API Anthropic. La version compte 100 entrées : 57 correctifs, 18 améliorations, 14 ajouts et 11 changements.
Le changement le plus visible concerne les permissions : quand aucun mode n’est configuré, les sessions interactives du terminal et de VS Code démarrent désormais en mode auto, sur tous les forfaits et chez tous les fournisseurs. La 2.1.283 l’avait déjà fait le 25 septembre pour les fournisseurs tiers et les sessions sans télémétrie ; la 2.1.284 généralise, et le réglage permissions.defaultMode garde la priorité. Une nouvelle réponse, « Oui, mais redemander la prochaine fois » (Yes, but ask again next time), autorise une seule lecture hors des répertoires de travail et laisse Claude Code redemander pour les suivantes.
Ultracode sort du curseur d’effort pour devenir une bascule à part dans /effort (touche Tab, ou /effort ultracode on et off) : il ne force plus l’effort xhigh et reste actif quel que soit le niveau choisi, avec un interrupteur équivalent sous le curseur d’effort de VS Code.
| Nouveauté de la 2.1.284 | Commande ou réglage |
|---|---|
| Mode auto par défaut, tous forfaits et fournisseurs | permissions.defaultMode garde la priorité |
| Ultracode en bascule indépendante | Tab dans /effort, ou /effort ultracode on et off |
| Reconnexion groupée des serveurs MCP en échec | /mcp reconnect all |
| Dépenses en dollars pour la passerelle Claude apps | /usage et ligne d’état (champs used_usd, limit_usd, period) |
| Second compactage si « Prompt is too long » persiste | automatique |
Côté sécurité, les plugins venus de marketplaces, de claude.ai ou de npm ne peuvent plus pré-approuver leurs propres outils quand l’administration n’autorise que ses règles gérées (allowManagedPermissionRulesOnly), les règles de .claude/rules liées par lien symbolique depuis l’extérieur du projet passent par une demande d’approbation, et le chargement de la mémoire neutralise dans MEMORY.md les caractères invisibles et les balises qui imitent le balisage de Claude Code. Pour la fiabilité, un flux de réponse endommagé est réessayé au lieu d’afficher « JSON Parse error », et les appels MCP d’une session reprise attendent jusqu’à 10 secondes leur serveur. Enfin, quand les garde-fous d’un modèle Sonnet signalent un message, l’avis s’explique davantage et propose de modifier la demande puis de la relancer.
Codex CLI 0.158.0 : copie à la sélection et secrets client OAuth pour MCP
28 septembre — Publiée à 05 h 07 UTC, Codex CLI 0.158.0 est la première version stable depuis la 0.157.1 du 26 septembre ; ses notes recensent 188 pull requests depuis la 0.157.0. L’interface plein écran (fullscreen TUI) rend configurables la copie à la sélection (copy-on-select) et le collage au clic droit, et un passage copié depuis la transcription garde son formatage Markdown.
| Fonction concernée | Réglage ou détail |
|---|---|
| Copie à la sélection | tui.copy_on_select : auto par défaut (tmux, Zellij, terminaux macOS directs hors Ghostty et Kitty), always, never |
| Collage au clic droit | tui.right_click_paste : auto (Windows, Linux, WSL), on (macOS aussi), off |
| Serveurs MCP avec OAuth | codex mcp add --oauth-client-secret, clé oauth.client_secret |
| Exec-server | Jetons porteurs pour les connexions WebSocket directes |
| Génération d’images | Fond transparent explicite (transparent_background), édition des images de la conversation |
Codex sait désormais se connecter aux serveurs MCP qui exigent un client OAuth pré-enregistré avec secret, et les connexions WebSocket directes à l’exec-server peuvent être protégées par des jetons porteurs (bearer tokens), y compris quand elles passent par l’app-server. Côté sécurité, l’approbation des saisies envoyées à un terminal passe en stable et s’active par défaut pour les commandes lancées avec des permissions élevées. Les correctifs visent surtout les bacs à sable : chemins Windows 10 ordinaires, identifiants stockés rejetés, démarrage sous Linux avec des racines inscriptibles imbriquées, protection des métadonnées Git sur Linux et macOS.
Copilot CLI 1.0.89 passe en stable, le SDK Copilot 1.0.15 type ses sorties
28 septembre — GitHub publie Copilot CLI 1.0.89 en version stable (19 h 20 UTC). La préversion 1.0.89-5, décrite le 27 septembre, apportait déjà la prise en charge des fichiers .claude/rules ; sur les 35 entrées des notes, plusieurs nouveautés sont inédites. Le routage Auto suggère désormais un niveau, que l’on change par raccourci ou d’un clic, et perd le profil Fast, qui n’était pas pris en charge : une préférence Fast enregistrée retombe sur Balance. La création de pull request suit les modèles du dépôt, sections obligatoires et listes de contrôle comprises. En session locale, Échap Échap dans une saisie vide reprend un prompt dont le tour n’a pas commencé, et les plugins installés directement deviennent activables et désactivables (copilot plugin enable). Dans le bac à sable, les commandes gh et git enveloppées (timeout 60 gh …) fonctionnent, et localhost devient accessible sous Windows quand l’accès au réseau local est activé.
Dans la foulée (19 h 38 UTC), le SDK GitHub Copilot, qui embarque l’environnement d’exécution agentique de Copilot dans une application, passe en version 1.0.15 après cinq préversions. Nouveauté principale : des sorties structurées typées dans les six SDK (TypeScript, Python, Go, Java, C# et Rust) ; le développeur fournit un schéma JSON ou un type idiomatique, et le modèle renvoie une sortie typée et validée au lieu de texte libre. Un gestionnaire expérimental permet aussi à l’application d’imposer une revue humaine avant l’installation d’un serveur MCP ou d’un skill, avec une décision explicite (confirmer, refuser ou annuler), et, en Rust, la mémoire retenue par l’installation de cet environnement d’exécution baisse d’environ 99 %.
🔗 Copilot CLI v1.0.89 · Copilot SDK v1.0.15
Devin devient 30 à 40 % moins cher, Devin Fusion en tête de FrontierCode 1.1 Extended
28 septembre — Cognition annonce un Devin nettement moins cher à l’usage : de 30 à 40 % de moins en modes Fusion et Normal, de 15 à 20 % en mode Ultra et jusqu’à 70 % pour Devin Review, son outil de revue de code. L’éditeur attribue ces gains à l’intégration des derniers modèles, dont son propre SWE-2, et au travail sur le harnais cloud de Devin (cloud harness) : davantage d’actions groupées dans un même appel d’outil (formater, analyser et tester d’un coup), des appels indépendants lancés en parallèle et une meilleure réutilisation du cache de prompt. Les ordres de grandeur donnés pour ce harnais viennent d’exemples illustratifs, pas de mesures.
Cognition assure avoir maintenu ou amélioré l’intelligence de chaque mode. Fusion associe un modèle principal capable à un acolyte (sidekick) moins coûteux, et le graphique du billet le place en tête de FrontierCode 1.1 Extended.
| Configuration évaluée par Cognition | Score FrontierCode 1.1 Extended | Coût moyen par tâche |
|---|---|---|
| Devin Fusion | 68,8 | 0,60 dollar |
| Opus 5.5 (high) | 65,2 | 0,90 dollar |
| Fable 5.1 (medium) | 63,6 | 2,68 dollars |
| GPT-6 Astra (high) | 63,1 | 2,62 dollars |
| SWE-2 (high) | 60,1 | 0,64 dollar |
| GPT-6 Sol (high) | 59,6 | 0,87 dollar |
Les valeurs d’Opus 5.5 (65,2) et de GPT-6 Astra (63,1), données à l’effort high, diffèrent de celles du graphique publié le même jour pour Sonnet 5.5 (65,3 et 64,5), qui ne précise pas l’effort. Ce Devin plus économe est disponible dès aujourd’hui, sans nouvelle grille tarifaire publiée.
🔗 Devin is now up to 40% more cost-efficient
Notes de version de Devin du 25 septembre et bêta de Devin Mobile
25 septembre — Passées inaperçues jusqu’ici, les notes de version de Devin du 25 septembre ajoutent 57 intégrations MCP hébergées (hosted MCP) dans la Marketplace, dont Buildkite, Brex, Expo, Vanta, WorkOS et Wix. Devin produit aussi un rapport HTML interactif quand on lui demande un rapport qui gagne à l’être (graphiques, tableaux, diagrammes) sans préciser de format. Une session fille démarre avec un résumé de sa session parente, affiché comme une pastille amovible dans la zone de saisie, et une session dont la machine s’est endormie se réveille dès qu’on ouvre une URL d’aperçu ou qu’on s’y connecte en SSH. Les automatisations peuvent tourner sur un Outpost partagé, et Devin lit les journaux Azure Pipelines des vérifications en échec sur les pull requests Azure DevOps.
Le 28 septembre, Cognition ouvre aussi une liste d’attente pour la bêta de Devin Mobile. La page d’inscription la résume en une phrase : Devin tourne dans le cloud ou sur votre machine, teste dans son propre navigateur et ne s’arrête pas avant que la pull request soit prête à être fusionnée. Ni date d’ouverture générale ni tarif ne sont publiés.
🔗 Notes de version de Devin · Devin Mobile sur X
Zed annonce Delta 0.18, Gemini CLI publie une nightly vide
28 septembre — Zed annonce, sans date, que la version 0.18 de Delta, son environnement multijoueur pour coder avec des agents, fera tourner les fils (threads) de Delta dans des worktrees Git déjà existants ; la 0.17, publiée le 23 septembre, isolait déjà chaque tâche parallèle dans son propre espace de travail. Côté Google, la nightly de Gemini CLI publiée le 28 septembre ne contient aucun changement : elle repose sur le même commit que celle du 26, et la stable v0.61.0 comme la préversion v0.62.0-preview.0 restent en place.
🔗 Zed sur X · Gemini CLI v0.63.0-nightly.20260928
L’Agent API de Perplexity devient réutilisable : Profiles, Skills versionnés et connecteurs partagés
28 septembre — Perplexity ajoute à son Agent API une couche de configuration réutilisable et versionnée, pensée pour les équipes. La pièce centrale, le Profile, enregistre sous un identifiant versionné unique tout ce qui définit un agent : modèle, instructions, outils, Skills, connecteurs et réglages d’exécution. Un administrateur de projet configure l’agent une fois et le met à disposition des développeurs autorisés ; chaque application n’apporte plus que ses propres données.
Les Skills personnalisés empaquettent des instructions, des procédures et des fichiers d’appui sous forme versionnée : une équipe plateforme peut y ranger ses contrôles de déploiement, ses critères de retour arrière (rollback) et son format de rapport, puis publier une nouvelle version au lieu de retoucher chaque application. Les connecteurs gérés (managed connectors), lancés fin août, deviennent une ressource que l’administrateur partage avec tout le projet : les applications y font référence sans stocker chacune leurs identifiants ni leurs définitions d’outils.
| Ressource ajoutée | Rôle dans l’Agent API | Disponibilité annoncée |
|---|---|---|
| Profiles | Modèle, instructions, outils, Skills, connecteurs et réglages d’exécution sous un identifiant versionné | Disponible |
| Skills personnalisés | Instructions, procédures et fichiers d’appui versionnés, invoqués par les membres du projet | Disponible |
| Connecteurs gérés | Intégrations approuvées partagées par l’administrateur (GitHub, Slack, Google Drive, Datadog, Linear, Notion) | Préversion |
Tout se règle depuis l’API Console, et les membres appellent ces ressources avec une clé d’API du même projet ; le billet n’annonce aucun tarif. Le même jour, une entrée du changelog de l’API fait passer le préréglage xhigh de l’Agent API de GPT-5.6 Sol (openai/gpt-5.6-sol) à Claude Opus 5.5 (anthropic/claude-opus-5-5), prompts, effort de raisonnement, outils, budgets de tokens et limites d’étapes restant inchangés. Trois jours plus tôt, les préréglages low, medium et high étaient passés sur GPT-6.
🔗 Agent API now supports reusable agents · Changelog de l’API Perplexity
SpaceXAI lance Team Bots, des Grok Bots partagés par toute une équipe
28 septembre — SpaceXAI lance Team Bots, des Grok Bots construits autour d’un rôle ou d’un flux de travail d’équipe et partagés par tous ses membres, chacun pouvant aussi travailler seul avec le Bot. Le Bot est commun, mais les conversations restent privées : contexte et mémoires sont séparés par utilisateur, tandis que les skills sont communs à l’équipe. Chaque Team Bot a son propre identifiant dans Slack et peut être invité dans un canal où toute l’équipe l’interroge.
| Composante du Bot | Rôle décrit par SpaceXAI |
|---|---|
| Contexte | Fichiers, instructions et skills |
| Plugins | Travail dans Salesforce, Notion ou GitHub, connectés par chacun ou pour l’équipe |
| Identifiants | Accès aux API tierces qui n’ont pas de plugin |
| Mémoires | Ce que le Bot retient pour progresser dans son rôle, séparé par utilisateur |
SpaceXAI décrit ses propres usages. Chaque grand compte commercial a son Team Bot, qui analyse la nuit l’actualité du client, les appels Gong, les documents Notion et les fils Slack, puis publie un point le matin dans Slack. Le Bot d’ingénierie, relié à Notion, Linear, Hex, Datadog et Cursor, a piloté des centaines de Cloud Agents : une équipe de cinq personnes a ainsi livré plus de 100 pull requests par jour et lancé Team Bots en quelques semaines. Côté clients, l’assureur Harper dit avoir construit en 24 heures un Team Bot qui aide ses clients à rétablir leurs polices expirées, avec plus de 120 000 dollars économisés pour eux selon son PDG.
Team Bots est disponible dès aujourd’hui en bêta publique sur les formules Teams et Enterprise, avec des Team Bots préconfigurés pour les ventes, la gestion de produit, le marketing et l’analyse de données. SpaceXAI ne communique ni tarif ni quota.
🔗 Team Bots (SpaceXAI) · Annonce de @bot sur X
H Company publie Holo4, des modèles agentiques à poids ouverts de 27B et 35B-A3B
28 septembre — H Company publie Holo4, sa nouvelle série de modèles agentiques, en deux tailles : un modèle dense de 27 milliards de paramètres et un mélange d’experts (Mixture of Experts) 35B-A3B, tous deux servis par l’API H Models et publiés sur Hugging Face en BF16, FP8, NVFP4 et GGUF 4 bits. H y ajoute Holotron4 Nano, obtenu en appliquant sa recette de post-entraînement à Nemotron 3 Nano Omni de NVIDIA. Un même modèle agit par l’interface graphique, le code, MCP ou des API, sur ordinateur, sur le web, sur Android ou dans un bac à sable de code ; H l’a entraîné par apprentissage supervisé puis par renforcement, notamment sur environ 10 000 tâches vérifiables que son Agentic Task Factory génère à partir de simple documentation.
| Modèle évalué | Base et licence | Score publié |
|---|---|---|
| Holo4 27B | Qwen3.8-27B, CC-BY-NC-4.0 (non commerciale) | 61,7 % sur OSWorld 2.0 ; 85,2 % sur OSWorld à 0,08 dollar par tâche |
| Holo4 35B-A3B | Qwen3.6-35B-A3B, Apache-2.0 | 30,9 % sur OSWorld 2.0 |
| Holotron4 Nano (Holotron4-30B-A3B) | Nemotron 3 Nano Omni, NVIDIA Open Model Agreement | gains sur la base donnés en graphique seulement |
| Claude Opus 5.5 (référence citée par H) | modèle fermé | 81,8 % sur OSWorld 2.0 |
H précise ses conditions : Holo4 est mesuré dans son propre harnais, avec un seul run sur OSWorld 2.0, et comparé à des scores publics obtenus avec d’autres harnais et niveaux d’effort ; sur AutomationBench, 480 des 600 tâches publiques appartiennent à la répartition qui a servi à collecter les données d’entraînement. H publie toutes les trajectoires derrière ses scores publics, consultables pas à pas ou téléchargeables sur Hugging Face, et annonce des brouillons DSpark pour accélérer l’inférence dans les prochains jours.
🔗 Billet Holo4 sur Hugging Face · Annonce de H Company
Robotique : SAIL de Sakana AI passe de 25 à 73 % de réussite, ProjectSim interroge la mesure en simulation
28 septembre — Sakana AI présente SAIL (Scaling In-Context Imitation Learning), un travail mené avec l’université de Tokyo et accepté à la conférence IROS 2026 ; le papier porte un identifiant arXiv de mars 2026, la nouveauté du jour étant sa présentation publique. La question posée : peut-on tirer d’un modèle vision-langage (VLM) existant des mouvements de robot fiables, sans le réentraîner, en lui accordant plus de calcul au moment de l’inférence ?
SAIL génère une trajectoire complète à partir de quelques démonstrations réussies placées en contexte et l’exécute en simulation ; un second VLM estime alors, à partir de la vidéo, la progression de la tâche, et ce retour guide une recherche arborescente Monte-Carlo (MCTS). Seule la trajectoire retenue part vers le robot réel. Gemini Robotics-ER 1.5 tient les deux rôles, sans modification de ses poids.
| Méthode évaluée | Nœuds de recherche | Réussite moyenne sur six tâches simulées |
|---|---|---|
| Génération unique | 1 | 25 % |
| Parcours en profondeur | 15 | 37 % |
| Parcours en largeur | 15 | 51 % |
| SAIL | 6 | 55 % |
| SAIL | 15 | 65 % |
| SAIL | 45 | 73 % |
Ces taux comptent les configurations (20 par tâche, dans le simulateur ALOHA) pour lesquelles une trajectoire réussie est trouvée dans le budget, la réussite étant vérifiée par le simulateur et non par le VLM. Sur un bras LeRobot SO-101, SAIL réussit 5 essais sur 6 pour poser un bloc dans un bol, avec un budget de 15 candidates, et une politique d’imitation entraînée sur les trajectoires trouvées fait aussi 5 sur 6 en s’exécutant plus vite. Sakana reconnaît les limites : exécution en boucle ouverte, calcul supplémentaire pour la recherche, évaluation réelle réduite à une tâche et six essais par méthode.
🔗 Billet de Sakana AI · Page du projet SAIL
ProjectSim fait le point sur les bancs d’essai en robotique
28 septembre — L’écart entre scores simulés et scores réels est justement le sujet de la première expérience de ProjectSim. Dans un billet de synthèse sans résultat propre, Luca Cilio passe en revue les bancs d’essai de manipulation, de MetaWorld et LIBERO jusqu’aux tests physiques partagés comme RoboChallenge, et rappelle, chiffres de RoboCasa365 à l’appui, que GR00T N1.5, affiné sur 30 000 démonstrations, réussit 43 % des compétences isolées mais tombe à 4,4 % sur des combinaisons absentes de son affinage. L’expérience de ProjectSim cherche à savoir si des scènes simulées plus fidèles (géométrie, apparence et propriétés physiques reconstruites) rapprochent les scores en simulation de ceux mesurés sur un robot réel ; aucun résultat n’est encore publié.
Mistral ouvre à Munich un hub consacré à l’IA industrielle et à l’IA pour la physique
28 septembre — Mistral ouvre un hub à Munich. Le site accueillera des équipes de recherche en IA pour la physique (Physics AI) et en IA industrielle (Industrial AI), aux côtés d’ingénieurs appliqués qui travaillent directement pour les entreprises partenaires : Mistral s’y présente en partenaire technologique de long terme plutôt qu’en éditeur de logiciels.
| Partenaire cité par Mistral | Travail annoncé |
|---|---|
| BMW | Simulation de crash et IA d’ingénierie |
| Siemens Energy | Applications d’IA industrielle |
| Université technique de Munich (TUM) | Jumeaux numériques en soufflerie pour l’aérodynamique automobile |
Ce hub prolonge le rachat d’Emmi AI en mai 2026, qui a fait entrer chez Mistral plus de 30 physiciens, chercheurs et ingénieurs spécialisés en mécanique des fluides numérique (CFD), en mécanique des structures et en simulations multiphysiques. Avec la TUM et le professeur Nikolaus A. Adams, Mistral développera des jumeaux numériques pour l’aérodynamique automobile, en fusionnant les mesures des capteurs de soufflerie en temps réel et des simulations CFD calculées hors ligne, pour obtenir des prédictions aérodynamiques précises en temps réel.
Le billet reprend l’argument de souveraineté (poids accessibles au client, modèles exécutés sur sa propre infrastructure et sous droit européen, sans que les données quittent l’organisation) et indique que Mistral construira un gigawatt de capacité de calcul européenne d’ici 2030. Il cite le ministre fédéral allemand de la Transformation numérique, Karsten Wildberger, et le chef de la Chancellerie d’État de Bavière, Florian Herrmann. Mistral recrute dans la région de Munich, sans donner d’effectif ni de montant d’investissement.
🔗 Hallo, Deutschland! (Mistral AI)
NVIDIA et Nscale mesurent DSX MaxLPS : 37 % de GPU et 49 % de débit en plus dans le même budget électrique
27 septembre — NVIDIA publie une évaluation chiffrée de DSX MaxLPS, son logiciel qui partage la puissance entre les ressources d’une usine IA selon les politiques de l’opérateur, menée avec Nscale. Selon NVIDIA, il permet de déployer jusqu’à 40 % de GPU en plus dans le même budget électrique approuvé ; le billet insiste sur un point : il s’agit d’une allocation coordonnée, pas d’une hausse de l’alimentation du site.
Le test a tourné sur des GB300 NVL72 au centre de données de Nscale du campus Verne, à Keflavík (Islande), alimenté entièrement en énergie renouvelable, avec Kimi K2.5 en FP4, NVIDIA Dynamo et TensorRT LLM. Dans le même budget provisionné de 264,4 kW, la flotte passe de 140 à 192 GPU sans baisse du débit des instances existantes.
| Indicateur mesuré | Base statique | Avec DSX MaxLPS | Écart relevé |
|---|---|---|---|
| GPU gérés | 140 | 192 | +37,1 % |
| Débit agrégé normalisé | 1 084 503 tokens/s | 1 618 443 tokens/s | +49,2 % |
| Puissance totale mesurée | 166,2 kW | 198,9 kW | +19,7 % |
| Utilisation du budget électrique | 62,9 % | 75,2 % | +12,3 points |
| Débit par watt provisionné | 4,10 tokens/s/W | 6,12 tokens/s/W | +49,2 % |
Le billet ne cache pas la contrepartie : si les latences médiane et P75 restent à moins de 5 % de la référence, le P99 du délai avant le premier token grimpe de 17 %, à partir d’une base de 15,7 secondes. NVIDIA recommande aux opérateurs une validation en cinq étapes, de la délimitation du périmètre électrique à la fixation des limites de production. Cette évaluation fait suite à la validation par Lambda sur HGX B200, présentée le 15 septembre (19 nœuds dans le budget de 16) ; les projections pour Vera Rubin, avec un refroidissement liquide à 45 °C en entrée, restent présentées à part.
Brèves
- DeepSeek Harness 0.2.0-rc.1 — Première release candidate de la série 0.2.0 et 23e préversion du harnais d’agent de DeepSeek, toujours sans version stable : les conversations sur les modèles du compte DeepSeek cherchent sur le web sans clé d’API supplémentaire, et les tâches automatisées passent dans un paquet de plugins optionnel. 🔗 source
- Pixel Canary sur Vercel AI Gateway — Depuis le 25 septembre, Vercel propose gratuitement, le temps de sa période furtive, ce modèle de code d’un éditeur non nommé : 28 tâches Next.js sur 31 en pass@4, à égalité avec GPT-6 Astra (high), et 30 sur 31 avec la documentation fournie via AGENTS.md ; pas de rétention zéro des données. 🔗 source
- Runners auto-hébergés de GitHub Actions — Sur GitHub Enterprise Cloud, l’application complète des versions minimales commence le 29 septembre : sous la version 2.329.0, un runner ne peut plus s’enregistrer, et un runner sous le minimum d’exécution cesse de prendre des jobs ; une nouvelle API REST donne les dates de fin de prise en charge. GitHub Enterprise Server n’est pas concerné. 🔗 source
- NexteraBERT — Rikka Botan publie un encodeur bidirectionnel de 212,6 millions de paramètres, préentraîné sur 130 milliards de tokens (environ 15 fois moins que ModernBERT) : 87,90 sur GLUE contre 87,97 pour ModernBERT-base, 54,70 contre 53,63 sur MTEB v2 et un débit 5,22 fois supérieur à 65 536 tokens, selon ses propres mesures ; code sous licence MIT. 🔗 source
- LTX-2.5 en temps réel — Un billet communautaire fait passer ce modèle audio et vidéo de 22 milliards de paramètres de 90 secondes par clip à une génération plus rapide que la lecture : 1,83 seconde pour un clip de 5 secondes sur une carte de 96 Go, grâce à 4 étapes au lieu de 8, au calcul NVFP4 et à CUDA Graph ; code sous Apache-2.0. 🔗 source
- SCRIBE — Adalat AI, qui conçoit de la reconnaissance vocale pour les tribunaux indiens, publie sur PyPI cet outil d’évaluation open source (article à Interspeech 2026) qui note séparément mots, nombres, ponctuation et termes métier, là où le taux d’erreur par mot donne 100 % à une phrase malayalam qu’aucun correcteur ne modifierait. 🔗 source
- 228 projets JEV — Eric Kang, qui tient la liste Awesome JEV, retient 228 projets open source (10 types, 50 étoiles minimum, chacun figé à un commit) parmi les 13 473 dépôts que renvoie une recherche « jev » sur GitHub, un total qui mêle des projets sans rapport : une sélection manuelle, pas un recensement indépendant. 🔗 source
- HeyGen et Jev — HeyGen publie sur X un guide qui place Jev, le modèle de décision de TypeSafe AI, devant son serveur MCP : Jev trie une quarantaine de prospects (vidéo ou non, angle, langue, adéquation), Claude écrit les scripts, puis le MCP HeyGen rend le lot, seule étape qui consomme des crédits et attend une validation. 🔗 source
- Quatre créations avec Gemini 3.8 Flash — Le blog de Google présente quatre réalisations construites avec le modèle lancé le 2 septembre : un suivi en direct de satellites bâti avec Antigravity, des vagues Seigaiha animées, un squelette 3D de tyrannosaure et une boîte de vitesses automatique à 10 vues de caméra ; ni chiffre ni nouveauté produit. 🔗 source
- Un traiteur de Brooklyn et Gemini — Le blog de Google raconte comment Edy Massih, propriétaire de l’épicerie Edy’s Grocer à Greenpoint, utilise Gemini pour mettre ses recettes à l’échelle de 200 convives, générer ses listes de courses et adapter ses menus aux régimes alimentaires ; aucune fonction nouvelle. 🔗 source
- Lenfest Institute — OpenAI engage 5 millions de dollars, plus jusqu’à 5 millions de dollars en crédits logiciels et en soutien d’ingénierie, dans la phase suivante du programme de boursiers IA du Lenfest Institute, lancé en 2024 dans 11 rédactions américaines : le double de son soutien précédent. 🔗 source
- Onglet Santé de ChatGPT — Sélectionner un graphique, une métrique ou un dossier dans l’onglet Health donne désormais des explications personnalisées, parfois avec un graphique interactif, sans rédiger de prompt ; Health reste réservé aux États-Unis (18 ans et plus, forfaits Free, Go, Plus et Pro, web et iOS). 🔗 source
- Lauréats du WebMCP Challenge — OpenAI Developers présente les dix projets lauréats du hackathon lancé fin août (MASIL, Alza, ArchMorph, Aisle, Roque Nights, Mandate, Observatory, Bouquet Studio, Faraday, JupyterLite WebMCP), sans classement ni montant par projet. 🔗 source
- Correctif de sécurité sur macOS — Le 25 septembre, la version 26.924.20706 de l’application de bureau pour macOS, rangée dans la rubrique de l’application Codex du changelog ChatGPT et Codex, a corrigé la vulnérabilité CVE-2026-100754 signalée par Patrick Wardle (Objective-See Foundation), sans description de la faille. 🔗 source
Ce que ça signifie
Le prix du token ne bouge plus, c’est le nombre de tokens qui baisse. Sonnet 5.5 garde le tarif de Sonnet 5 mais coûte, selon Anthropic, jusqu’à 30 % de moins par tâche parce qu’il en consomme moins ; Devin devient 30 à 40 % moins cher en intégrant ses derniers modèles, dont SWE-2, et en groupant ses appels d’outils ; Manus annonce 32 % de coût d’exécution en moins avec son nouveau harnais, dans une configuration testée. Le levier n’est plus le tarif affiché mais la quantité de travail consommée, côté modèle comme côté harnais, et le milieu de gamme rattrape le haut : sur Terminal-Bench 4.0, Sonnet 5.5 dépasse le score d’Opus 5.5 mesuré à l’effort Xhigh.
Les agents gagnent en autonomie par défaut, et les garde-fous se déplacent hors de leur portée. Claude Code démarre désormais en mode auto sur tous les forfaits, pendant que NVIDIA installe la surveillance dans un DPU que l’agent ne peut pas atteindre et soumet par défaut à une validation humaine toute règle d’accès qu’il propose. Les outils suivent la même ligne : Codex CLI soumet à approbation les saisies terminal des commandes à permissions élevées, et le SDK Copilot permet d’exiger une revue humaine avant l’installation d’un serveur MCP ou d’un skill. Plus l’agent agit seul, plus le contrôle doit vivre ailleurs que dans l’agent lui-même.
L’agent devient aussi un membre d’équipe, doté d’une identité. Les Profiles de Perplexity font d’un agent une configuration versionnée que tout un projet réutilise, les Team Bots de SpaceXAI ont leur propre identifiant Slack et gardent des mémoires séparées pour chaque utilisateur, et les agents de Cue reçoivent une adresse e-mail, un numéro de téléphone et un portefeuille. Un agent qui peut payer, appeler ou écrire au nom de quelqu’un rend très concrètes les questions de contrôle que NVIDIA pose le même jour.
Enfin, les chiffres de la journée demandent une lecture attentive. Devin mesure Sonnet 5.5 sur une variante de FrontierCode que son tweet et son graphique ne nomment pas de la même façon, et deux graphiques de Cognition publiés le même jour donnent des scores différents pour Opus 5.5 ; Holo4 est mesuré dans le harnais de H, en un seul run sur OSWorld 2.0 ; les 73 % de SAIL sont obtenus en simulation, et l’écart entre simulation et réel est justement l’objet de la première expérience de ProjectSim. Côté médias, Eleven v4 s’appuie sur un classement externe et des tests à l’aveugle, quand Kling 4.0 arrive sans benchmark ni tarif, avec une partie de ses fonctions renvoyée à plus tard.
Sources
- Introducing Claude Sonnet 5.5 (Anthropic)
- Guide de migration vers Claude Sonnet 5.5
- @ClaudeDevs : recommandations d’effort pour Sonnet 5.5
- Claude Sonnet 5.5 dans GitHub Copilot
- Modèles et tarifs de GitHub Copilot
- Claude Sonnet 5.5 dans Devin
- @cognition : Sonnet 5.5 sur FrontierCode 1.1 Main
- @cursor_ai : Sonnet 5.5 dans Cursor
- @v0 : Sonnet 5.5 dans v0
- NVIDIA Launches Open Agent Safety Platform (communiqué)
- Architecture de l’Open Agent Safety Platform (NVIDIA)
- Add runtime controls to AI agents with NVIDIA OpenShell
- @NVIDIAAI : Jensen Huang sur CNBC
- @togethercompute : partenaire de lancement
- @perplexity_ai : partenariat avec NVIDIA
- Introducing Manus 2.0
- @ManusAI : lancement de Cue
- @ManusAI : numéros de téléphone des agents
- Introducing Eleven v4 (ElevenLabs)
- @ElevenLabs : fil d’annonce d’Eleven v4
- Note de version de Kling 4.0
- @Kling_ai : annonce de Kling 4.0
- Claude Code v2.1.284
- Codex CLI 0.158.0
- Copilot CLI v1.0.89
- Copilot SDK v1.0.15
- Devin is now up to 40% more cost-efficient
- Notes de version de Devin du 25 septembre
- @cognition : bêta de Devin Mobile
- @zeddotdev : Delta 0.18
- Gemini CLI v0.63.0-nightly.20260928
- Agent API now supports reusable agents (Perplexity)
- Changelog de l’API Perplexity
- Team Bots (SpaceXAI)
- @bot : annonce de Team Bots
- Holo4 sur le blog Hugging Face
- Holo4 (H Company)
- SAIL (Sakana AI)
- Page du projet SAIL
- Robotics benchmarking: where we are and what comes next (ProjectSim)
- Hallo, Deutschland! (Mistral AI)
- How NVIDIA DSX MaxLPS maximizes AI factory throughput and efficiency
- DeepSeek Harness 0.2.0-rc.1
- Pixel Canary sur Vercel AI Gateway
- Self-hosted runner version enforcement date has moved (GitHub)
- Rapport technique NexteraBERT
- Real-Time Talking Characters from a 22B Video Diffusion Model
- SCRIBE (Adalat AI)
- JEV : 228 projets retenus (Eric Kang)
- @HeyGen : guide Jev et MCP HeyGen
- See what 4 builders are making with Gemini 3.8 Flash (Google)
- 3 ways this grocer cooks for 200 guests with Gemini (Google)
- Lenfest AI Collaborative : nouvelle phase (OpenAI)
- Notes de version de ChatGPT
- @OpenAIDevs : lauréats du WebMCP Challenge
- Changelog ChatGPT et Codex : CVE-2026-100754