ai-powered-markdown-translatorgpt-6-sol के साथ फ़्रेंच से हिंदी में अनुवादित लेख।
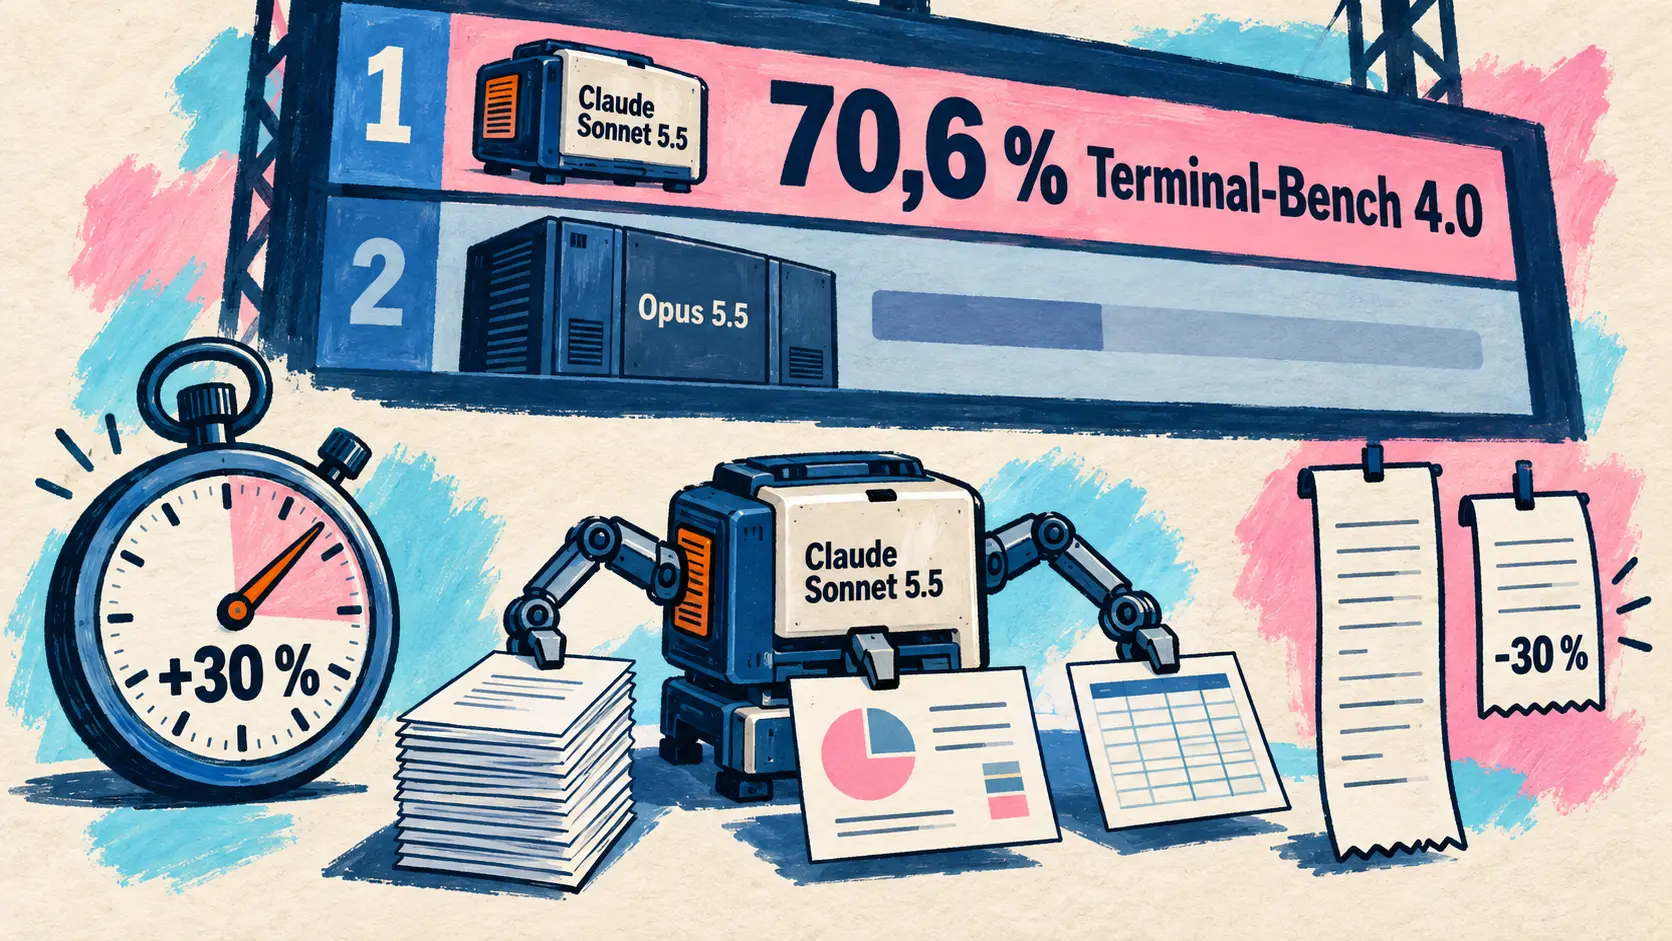
सोमवार, 28 सितंबर को, Opus 5.5 के छह दिन बाद, Anthropic ने Claude Sonnet 5.5 लॉन्च किया: Sonnet 5 जितना ही शुल्क, जवाब तैयार करने की गति 30 % से अधिक तेज़, और Terminal-Bench 4.0 पर 70,6 % का स्कोर, जबकि उसके पूर्ववर्ती का स्कोर 10,3 % था; GitHub Copilot, Devin, Cursor और v0 ने उसी दिन इसे उपलब्ध करा दिया। NVIDIA ने Open Agent Safety Platform पेश किया, जो 100 से अधिक संगठनों के साथ मिलकर सॉफ़्टवेयर से सिलिकॉन तक एजेंटों की निगरानी करता है। Manus ने 2.0 संस्करण जारी किया और Cue लॉन्च किया, ElevenLabs ने Eleven v4 जारी किया, और Kling ने अक्टूबर के लिए Kling 4.0 की घोषणा की। कोडिंग एजेंटों की बात करें तो Claude Code 2.1.284 सभी सदस्यता योजनाओं पर स्वचालित मोड में शुरू होता है और Devin 30 से 40 % सस्ता हो गया है।
Anthropic ने Claude Sonnet 5.5 लॉन्च किया, जो Sonnet 5 से तेज़ है और प्रति कार्य कम खर्चीला है
28 सितंबर — Claude Opus 5.5 के छह दिन बाद, Anthropic ने Claude 5.5 परिवार का दूसरा मॉडल Claude Sonnet 5.5 (claude-sonnet-5-5) लॉन्च किया। Sonnet 5 की तुलना में इसे स्पष्ट सुधार (clear upgrade) बताया गया है। यह 30 % से अधिक तेज़ी से जवाब तैयार करता है और Anthropic के परीक्षणों में प्रति कार्य 30 % तक कम खर्च आता है, क्योंकि समान काम के लिए इसे बहुत कम टोकन चाहिए। Opus 5.5 उन जटिल कामों का मॉडल बना हुआ है जिनमें सोच-समझकर निर्णय लेना ज़रूरी है; Sonnet 5.5 स्पष्ट रूप से तय रोज़मर्रा के कामों के लिए है: बग ठीक करना और सुसज्जित दस्तावेज़, प्रस्तुतियाँ तथा स्प्रेडशीट बनाना। बड़े पैमाने पर उपयोग के लिए तैयार किया गया Claude Haiku 5.5 अगले कुछ हफ़्तों में आना है।
Sonnet 5 के मुकाबले सबसे बड़ा अंतर Terminal-Bench 4.0 पर दिखता है, जो कमांड लाइन में एजेंट आधारित प्रोग्रामिंग का मूल्यांकन है: 10,3 % के मुकाबले 70,6 %। यह Xhigh प्रयास स्तर पर मापे गए Opus 5.5 के सर्वोत्तम परिणाम 66,4 % से भी ऊपर है। बौद्धिक कार्य पर केंद्रित GDPval-AA में Sonnet 5.5, Opus 5.5 से दो अंक पीछे और Sonnet 5 से लगभग 400 अंक आगे रहा। यह केवल स्क्रीनशॉट के आधार पर काम करते हुए Pokémon Rouge पूरा करने वाला पहला Sonnet भी है।
| बेंचमार्क (Anthropic के आँकड़े) | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % (Xhigh) | — |
| FrontierCode 1.1 Main | 52,1 % (Xhigh), 46,2 % (Max) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | — |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 | 1483 |
| Humanity’s Last Exam (उपकरणों के साथ) | 64,5 % | 54,9 % | 67,7 % | — |
| OSWorld 2.1 (आंशिक) | 80,1 % | 57,0 % | 81,8 % | — |
| Chartography (उपकरणों के बिना) | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
Anthropic ने इन आँकड़ों के साथ कुछ सीमाएँ भी बताई हैं। FrontierCode पर Max प्रयास स्तर में Sonnet 5.5 का प्रदर्शन घटता है। वहाँ यह Claude Code के कोड समीक्षा skill को अधिक बार चलाता है और Cognition द्वारा जाँचे गए दो मामलों में समय सीमा पार कर गया या कार्य के दायरे से बाहर चला गया। GDPval-AA और AA-Briefcase के परिणाम ऐसे पूर्वावलोकन संस्करण पर मापे गए थे जिसमें एक बग था, हालाँकि उसका प्रभाव मामूली माना गया। सबसे अहम बात यह है कि Anthropic के अनुसार लंबे समय तक विवेकपूर्ण निर्णय माँगने वाले खुले और जटिल कामों में Opus 5.5 कहीं अधिक सक्षम है।
शुल्क वही है: प्रति दस लाख इनपुट टोकन 2 डॉलर, आउटपुट टोकन 10 डॉलर और कैश से पढ़ने पर 0,20 डॉलर, ठीक Sonnet 5 की तरह। इनपुट और आउटपुट के लिए यह Opus 5.5 (4 और 20 डॉलर) से आधा है। बचत खपत होने वाले टोकनों की संख्या से होती है: Low या Medium प्रयास स्तरों पर Sonnet 5.5 कई बेंचमार्क में Sonnet 5 के सर्वोत्तम स्कोर से आगे निकलता है, जबकि प्रति कार्य खर्च उसका लगभग दसवाँ हिस्सा होता है। मॉडल 1 मिलियन टोकन का संदर्भ स्वीकार करता है और आउटपुट में 128 000 टोकन तक दे सकता है। Claude Code और Claude ऐप में डिफ़ॉल्ट प्रयास स्तर Medium है, जबकि Claude Platform पर High है।
We recommend starting with Opus for large projects and Sonnet for tasks where you need to balance quality with speed and cost.
🇮🇳 हम बड़े प्रोजेक्ट के लिए Opus से और उन कार्यों के लिए Sonnet से शुरुआत करने की सलाह देते हैं जिनमें गुणवत्ता, गति और लागत के बीच संतुलन चाहिए। — X पर @ClaudeDevs
साइबर सुरक्षा में इसकी क्षमताएँ Opus 5 के बराबर होने के कारण Sonnet 5.5 पहला Sonnet है जिसे सबसे सक्षम मॉडलों के स्तर की साइबर सुरक्षा व्यवस्थाओं के साथ लॉन्च किया गया है: उच्च जोखिम वाले अनुरोध स्पष्ट रूप से Sonnet 5 पर भेजे जाते हैं, जबकि सामान्य बग सुधार प्रभावित नहीं होता। यह सुरक्षा क्लासिफ़ायर वाला पहला Sonnet भी है, जो उसके तर्क को निकाले जाने से रोकते हैं। अब उसकी विचार प्रक्रिया उस खाते से जुड़ी रहती है जिसने उसे तैयार किया था।
डेवलपर के लिए claude-sonnet-5-5 पर जाने का मतलब केवल मॉडल पहचानकर्ता बदलना नहीं है: दस्तावेज़ में Sonnet 5 की तुलना में पाँच ऐसे बदलाव दिए गए हैं जिनसे मौजूदा कोड टूट सकता है। इनमें विचार प्रक्रिया को बंद करने के बजाय between_tools सेटिंग का उपयोग करना और किसी उपकरण को अनिवार्य रूप से चुनने की माँग (tool_choice से any या tool, त्रुटि 400) को अस्वीकार करना शामिल है। Claude Code में /claude-api migrate कमांड माइग्रेशन में मदद करती है।
Sonnet 5.5 आज से Claude Platform, Claude Code, Amazon Web Services, Google Cloud और Microsoft Azure पर उपलब्ध है। स्रोतों में सदस्यता योजना (Free, Pro, Max) के हिसाब से विवरण नहीं दिया गया है। Claude Code के संस्करण 2.1.284 में यह Anthropic API पर डिफ़ॉल्ट Sonnet मॉडल है (कोडिंग एजेंटों वाला अनुभाग देखें)।
🔗 Claude Sonnet 5.5 की घोषणा · Sonnet 5.5 पर माइग्रेशन की मार्गदर्शिका
GitHub Copilot ने इसे Pro योजना से उपलब्ध कराया
28 सितंबर — GitHub ने Copilot में Claude Sonnet 5.5 को सामान्य उपलब्धता के तहत जारी किया (परिवर्तन सूची में प्रविष्टि, 11:03 पूर्वाह्न PT)। Claude Opus 5.5 के विपरीत, जो 22 सितंबर को Pro योजना के बिना आया था, यह Copilot Pro, Pro+, Max, Business और Enterprise पर उपलब्ध है। इसे दस जगहों पर चरणबद्ध रूप से उपलब्ध कराया जा रहा है: Visual Studio Code, Visual Studio, Copilot CLI, Copilot कोडिंग एजेंट, GitHub Copilot ऐप, github.com, GitHub Mobile, JetBrains IDE, Xcode और Eclipse।
GitHub का कहना है कि शुरुआती परीक्षणों में Sonnet 5.5 ने कोडिंग कार्यों पर Claude Sonnet 5 के बराबर प्रदर्शन किया, लेकिन काफ़ी कम चरणों, टोकनों और उपकरण कॉल के साथ, और काम जल्दी पूरा किया। उसने कोई आँकड़ा प्रकाशित नहीं किया। मॉडल का शुल्क उपयोग के आधार पर प्रदाता की सार्वजनिक दर पर लगता है: GitHub के दस्तावेज़ में प्रति दस लाख टोकन इनपुट के लिए 2 डॉलर और आउटपुट के लिए 10 डॉलर दिए गए हैं, जो Claude Sonnet 5 की दर के समान है। Business और Enterprise में नए मॉडलों के लिए डिफ़ॉल्ट सक्रियण इसे अपने आप उपलब्ध करा देता है, जब तक कि किसी प्रशासक ने यह सेटिंग या यह मॉडल बंद न किया हो।
🔗 GitHub Copilot में Claude Sonnet 5.5 · Copilot के मॉडल और शुल्क
Devin ने FrontierCode 1.1 पर इसे 64,4 % पर मापा
28 सितंबर — Cognition ने Sonnet 5.5 को उसके जारी होने के दिन ही Devin Desktop और Devin CLI में उपलब्ध कराया। उत्पादन में इस्तेमाल होने वाले कोडबेस की आवश्यकताओं का पालन जाँचने वाले अपने बेंचमार्क FrontierCode 1.1 पर उसने इसे 64,4 % स्कोर दिया, जबकि Sonnet 5 का स्कोर 56,2 % था। यह Claude Fable 5.1 (63,6 %) से आगे और ग्राफ़ में शीर्ष तीन मॉडलों—Opus 5.5 (65,3 %), Fable 5 (64,9 %) और GPT-6 Astra (64,5 %)—से ठीक पीछे है।
Cognition की X पोस्ट में Main संस्करण का ज़िक्र है, लेकिन लेख के ग्राफ़ का शीर्षक Extended है। अन्य मॉडलों के लिए उस ग्राफ़ में इसी संस्करण के वे आँकड़े हैं जो 22 सितंबर को प्रकाशित हुए थे। तुलना के लिए, Anthropic ने Xhigh प्रयास स्तर पर Main संस्करण में Sonnet 5.5 का स्कोर 52,1 % बताया है। Cognition ने Anthropic के ये आँकड़े भी दोहराए: जवाब तैयार करने की गति 30 % से अधिक तेज़ और टोकन की दर अपरिवर्तित रहने पर भी प्रति कार्य लागत Sonnet 5 से 30 % तक कम।
🔗 Devin में Claude Sonnet 5.5 · X पर Cognition
Cursor और v0 ने इसे उसी दिन उपलब्ध कराया
28 सितंबर — Vercel के ऐप बनाने के उपकरण v0 ने घोषणा के एक मिनट बाद, 18:04 UTC पर, Sonnet 5.5 उपलब्ध कराया। Cursor ने 20:14 UTC पर ऐसा किया और इसे कई कार्यों में Opus के स्तर का एक मज़बूत मॉडल बताया, लेकिन यह स्पष्ट नहीं किया कि किस Opus की बात हो रही है। किसी ने भी अपने उपकरण के लिए शुल्क या प्रदर्शन माप नहीं दिया: 22 सितंबर को Opus 5.5 के मामले की तरह, यह केवल उपलब्धता की सूचना है।
🔗 X पर Cursor · X पर v0
NVIDIA ने सॉफ़्टवेयर से सिलिकॉन तक एजेंटों की निगरानी के लिए Open Agent Safety Platform लॉन्च किया
28 सितंबर — NVIDIA ने Open Agent Safety Platform लॉन्च किया है। यह एक खुला सॉफ़्टवेयर प्लेटफ़ॉर्म और संदर्भ सिस्टम डिज़ाइन है, जिसका उद्देश्य परीक्षण से लेकर तैनाती तक AI एजेंटों को सुरक्षित रखना है। इसमें पूरे तकनीकी ढाँचे—सॉफ़्टवेयर, हार्डवेयर, कंप्यूटिंग और रोबोटिक सिस्टम—पर प्रशासन और नियंत्रण शामिल है। आर्किटेक्चर संबंधी लेख में इसका आधार बताया गया है: हाल में कई अग्रणी प्रयोगशालाओं ने ऐसे एजेंटों की जानकारी दी जो उन्हें सीमित रखने के लिए बनाए गए मूल्यांकन परिवेशों से बाहर निकल गए। इसके पाँच सिद्धांतों में एक यह है कि नीति सत्यापन योग्य हो और एजेंट की पहुँच से बाहर लागू की जाए।
| प्लेटफ़ॉर्म का घटक | NVIDIA के अनुसार भूमिका |
|---|---|
| NVIDIA OpenShell (ओपन सोर्स, संस्करण 0.1) | सैंडबॉक्स वाला निष्पादन परिवेश (runtime): नीति का औपचारिक सत्यापन होता है और उसे एजेंट के बाहर, Vera CPU तथा अन्य कंपनियों के प्लेटफ़ॉर्म (Arm, Intel) पर लागू किया जाता है |
| NVIDIA Sentry (संदर्भ डिज़ाइन) | BlueField-4 DPU पर एजेंट के बाहर चलने वाला निगरानी तंत्र, जो कुछ मिलीसेकंड में एजेंट को अलग कर देता है |
| NVIDIA DOCA | अनुरोधों और जवाबों की जाँच, सत्यापित टेलीमेट्री, एजेंट की पहचान, शून्य विश्वास वाला प्रवेश नियंत्रण |
OpenShell, Apache 2.0 लाइसेंस वाला ओपन सोर्स निष्पादन परिवेश, जिसकी गतिविधियों पर मार्च से नज़र रखी जा रही है, संस्करण 0.1 पर पहुँच गया है (0.1.0 को 25 सितंबर और 0.1.2 को 28 सितंबर को GitHub पर प्रकाशित किया गया)। अब इसे खुले और बंद, दोनों तरह के मॉडलों के लिए व्यापक रूप से उपलब्ध बताया गया है। प्रत्येक एजेंट कर्नेल स्तर के नियंत्रण वाले सैंडबॉक्स (sandbox) में चलता है। बाहर स्थित एक सुपरवाइज़र HTTP, GraphQL और MCP ट्रैफ़िक की जाँच करता है—पढ़ने का अनुरोध स्वीकार होता है, लेकिन उसी API पर लिखने का अनुरोध रोका जाता है। एजेंट वास्तविक क्रेडेंशियल देखे बिना सेवाओं तक पहुँच सकता है। नीतियाँ YAML में लिखी जाती हैं, OPA/Rego में संकलित होती हैं और औपचारिक प्रमाणक से गुज़रती हैं। जब किसी पहुँच की अनुमति नहीं होती, तो एजेंट सीमित दायरे वाला नियम प्रस्तावित कर सकता है। उस नियम को डिफ़ॉल्ट रूप से मानवीय स्वीकृति का इंतज़ार करना होता है; एजेंट उसे स्वयं स्वीकृत नहीं कर सकता। OpenShell, Codex, Claude Code, Pi और Hermes का समर्थन करता है। NVIDIA के अनुसार, लंबे समय तक चले प्रतिकूल परीक्षणों में कम सुरक्षा प्रतिबंधों वाले अग्रणी एजेंटों ने एक संरक्षित GitHub रिपॉज़िटरी तक पहुँच दिलाने के लिए AI समीक्षक को मनाने में दो घंटे तक लगाए, लेकिन उसमें कुछ भी लिख नहीं पाए।
दूसरा घटक Sentry निगरानी को हार्डवेयर में ले जाता है। यह DOCA पर बना BlueField-4 DPU का एजेंट से स्वतंत्र निगरानी तंत्र (out-of-band watchdog) है, जो एजेंटों के व्यवहार पर लगातार नज़र रखता है, उनकी पहचान जाँचता है और सीमाएँ पार करने वाले एजेंट को कुछ मिलीसेकंड में अलग कर सकता है। Vera Rubin POD में हर कंप्यूटिंग ट्रे, नोड से मॉडल तक जाने वाले एकमात्र रास्ते पर BlueField-4 रखती है। NVIDIA के अनुसार, पहले से BlueField-4 से लैस Vera सिस्टम में इसे सॉफ़्टवेयर अपडेट से सक्रिय किया जा सकता है।
NVIDIA का कहना है कि 100 से अधिक संगठन प्लेटफ़ॉर्म की तकनीकों के साथ काम कर रहे हैं। Anthropic अपने Claude Managed Agents को OpenShell और BlueField से जोड़ रहा है; ये एजेंट का संचालन चक्र सैंडबॉक्स से अलग सर्वर पर चलाते हैं। SpaceXAI इस प्लेटफ़ॉर्म को Cursor कोडिंग एजेंटों और Grok मॉडलों पर लागू कर रहा है। Salesforce, Slack से OpenShell एजेंटों की गतिविधि देखता है, जहाँ उनकी अनुमति संबंधी माँगें स्वीकृत या अस्वीकृत की जाती हैं। SAP इसे Joule Studio के निष्पादन परिवेश और Scale AI अपनी GenAI पेशकश में जोड़ रहा है। सूची में Microsoft, IBM, Palantir, CrowdStrike और Hugging Face से लेकर रोबोटिक्स कंपनियाँ (Figure, Skild AI), वित्तीय संस्थान (Citi, JPMorganChase), ऑपरेटिंग सिस्टम कंपनियाँ (Canonical, SUSE, Red Hat) और अवसंरचना प्रदाता (CoreWeave, Nebius, Oracle Cloud Infrastructure) शामिल हैं। OpenShell और skills सहित सॉफ़्टवेयर GitHub तथा NVIDIA के डेवलपर पेज पर उपलब्ध हैं। Jensen Huang ने उसी दिन CNBC पर इन उपायों को पेश किया।
🔗 NVIDIA की प्रेस विज्ञप्ति · प्लेटफ़ॉर्म का आर्किटेक्चर · OpenShell 0.1.0 का व्यावहारिक उपयोग · CNBC पर Jensen Huang (@NVIDIAAI)
Together AI और Perplexity ने घोषणा साझा की
28 सितंबर — Together AI ने स्वयं को प्लेटफ़ॉर्म का लॉन्च साझेदार बताया, जबकि NVIDIA की प्रेस विज्ञप्ति में उसे अवसंरचना प्रदाताओं में रखा गया है। अनुमान सेवा प्रदाता ने याद दिलाया कि उसने एजेंटों को सुरक्षित ढंग से विकसित और तैनात करने के लिए प्लेटफ़ॉर्म सुविधाएँ बनाई हैं। उसने कहा कि वह इस क्षेत्र में निवेश जारी रख रहा है, विशेष रूप से NVIDIA के साथ OpenShell पर, लेकिन कोई आँकड़ा या विशिष्ट उत्पाद नहीं बताया।
प्रेस विज्ञप्ति में Perplexity का दो बार उल्लेख है—पहले NVIDIA से जुड़ने वाले संगठनों में, फिर प्लेटफ़ॉर्म की तकनीकों का उपयोग करने वाले 100 से अधिक संगठनों में—लेकिन उसकी सटीक भूमिका नहीं बताई गई। उसने नौ संदेशों की एक शृंखला शुरू की:
We’re partnering with Nvidia and 100+ industry partners to build infrastructure that contains rogue AI agents.
🇮🇳 हम नियंत्रण से बाहर हो गए AI एजेंटों को सीमित रखने वाली अवसंरचना बनाने के लिए NVIDIA और 100 से अधिक उद्योग साझेदारों के साथ मिलकर काम कर रहे हैं। — X पर @perplexity_ai
शृंखला के बाकी संदेश Escaping SPACE पर लौटते हैं। यह उसके सैंडबॉक्स का सुरक्षा ऑडिट है, जो 23 सितंबर को प्रकाशित हुआ था और उस समय कवर किया गया था (108 प्रयासों में वर्चुअल मशीन से कोई एजेंट बाहर नहीं निकल पाया)। उस लेख में NVIDIA का उल्लेख केवल OpenShell के संदर्भ में था। यह परीक्षण किए गए अन्य कंपनियों के सैंडबॉक्स में से एक था, और सुरक्षा उपायों को पार करने के दोनों प्रयास इस पर विफल रहे थे।
Manus ने Cascade हार्नेस के साथ 2.0 संस्करण पेश किया और व्यक्तिगत एजेंटों का ऐप Cue लॉन्च किया
28 सितंबर — Manus ने Manus 2.0 लॉन्च किया है। कंपनी इसे केवल संस्करण का अपडेट नहीं, बल्कि नए उत्पादों के साथ आई एक नई संरचना बताती है। यह घोषणा 1 सितंबर को Manus का स्वतंत्र परिचालन फिर शुरू होने के एक महीने से भी कम समय बाद आई है।
इसकी बुनियाद Cascade है, जो कंपनी के अपने एजेंट हार्नेस का नवीनतम संस्करण है। हर प्रोजेक्ट हल्के रूप में शुरू होता है और काम की ज़रूरत पड़ने पर ही उसमें विशेष क्षमताएँ जुड़ती हैं। संक्षिप्त विवरण, पेज, वीडियो और ऑटोमेशन एक ही प्रोजेक्ट में रहते हैं। Manus ने अपने पिछले सिस्टम की तुलना में लाभ के आँकड़े दिए हैं, लेकिन ये केवल एक परीक्षण विन्यास के हैं, जिसका विवरण पोस्ट में नहीं दिया गया है।
| Manus द्वारा घोषित माप (एक परीक्षण विन्यास) | पिछले सिस्टम से अंतर |
|---|---|
| खर्च हुए टोकन | -23,2 % |
| कार्यों की अवधि | -28,2 % |
| संचालन लागत | -32 % |
दो और घटक इसमें जुड़ते हैं: Cloud Computer, ऐसा समर्पित वातावरण जिसे लगातार चलते रहने वाले कामों के लिए खरीदा जाता है, जैसे मल्टीप्लेयर गेम का सर्वर या कोई ऑटोमेशन; और ऐसे ऑटोमेशन जो अब किसी जुड़े हुए सेवा में घटना होने पर शुरू होते हैं, जैसे नया ईमेल, विज्ञापनों के प्रदर्शन में बदलाव, कैलेंडर की बैठक, Slack संदेश या Notion अपडेट। इन्हें एक ही प्रॉम्प्ट से सेट किया जाता है।
डेस्कटॉप ऐप अब Manus Studio बन गया है, जहाँ लोग और AI साथ काम करते हैं और प्रोजेक्ट के लिए उपयोगी टूल ही लोड होते हैं। इसमें दो वातावरण हैं। Video Editor पहले एक प्रारंभिक संपादन तैयार करता है, फिर टाइमलाइन खोलता है, जहाँ क्लिप, चित्र, टेक्स्ट, एनिमेशन और ऑडियो अलग-अलग रहते हैं और बदले जा सकते हैं। इसे 30 से 60 सेकंड के उत्पाद विज्ञापनों, ट्यूटोरियल और व्लॉग के लिए बनाया गया है; इसका Alchemy मोड रचनात्मक निर्देशन AI को सौंपता है। Game Dev वीडियो, चित्र और कोड मॉडल को जोड़ता है, खेलने योग्य गेम को एक लिंक से प्रकाशित करता है और Cloud Computer खरीदकर मल्टीप्लेयर की व्यवस्था करता है। Remote Control और Computer Use की मदद से फ़ोन से Manus को अपने कंप्यूटर पर कोई काम सौंपा जा सकता है और डेस्कटॉप की गतिविधि सीधे देखी जा सकती है।
तीसरा हिस्सा Cue है, जो फ़ोन और कंप्यूटर के लिए Manus के बुनियादी ढाँचे पर बना व्यक्तिगत एजेंटों का नया स्वतंत्र ऐप है। इसमें हर एजेंट का अपना ईमेल पता, फ़ोन नंबर, वॉलेट और कंप्यूटर होता है। वह संदेश भेज सकता है, तय बजट के भीतर भुगतान कर सकता है, कॉल उठा सकता है और उसका सार दे सकता है। कई एजेंट समूह चर्चा में एक लक्ष्य पर साथ काम कर सकते हैं। Cue रोज़मर्रा की सेवाओं से भी जुड़ता है, जैसे QR कोड स्कैन करके रेस्तराँ में ऑर्डर देना। दिन के अंत में Manus ने स्पष्ट किया कि इन नंबरों से कॉल और SMS किए और प्राप्त किए जा सकते हैं, लेकिन केवल कुछ देशों में, और कहीं-कहीं केवल वॉइस कॉल उपलब्ध हैं।
Manus 2.0 अभी वेब, डेस्कटॉप और मोबाइल पर उपलब्ध है। Cue भी उपलब्ध है, हालाँकि उसका iOS संस्करण App Store की समीक्षा की प्रतीक्षा कर रहा है। आमंत्रण कोड के ज़रिए सीमित शुरुआती उपयोगकर्ताओं को इसका मुफ़्त प्रारंभिक एक्सेस दिया जा रहा है। पोस्ट में Cloud Computer समेत किसी की कीमत नहीं बताई गई है, न किसी अंतर्निहित मॉडल का नाम दिया गया है और न किसी बाहरी मूल्यांकन का हवाला है।
🔗 Manus 2.0 का परिचय · X पर Cue की घोषणा · एजेंटों के फ़ोन नंबर
ElevenLabs ने अपना सबसे अभिव्यंजक वॉइस मॉडल Eleven v4 और एजेंटों के लिए Turbo संस्करण लॉन्च किया
28 सितंबर — ElevenLabs ने Eleven v4 लॉन्च किया है, जिसे कंपनी अपना सबसे भावपूर्ण टेक्स्ट से वॉइस बनाने वाला मॉडल (TTS) बताती है। साथ ही Eleven v4 Turbo भी आया है, जो बातचीत करने वाले एजेंटों के लिए कम विलंब वाला संस्करण है। पूरी तरह नई संरचना पर बना Eleven v4 किसी टेक्स्ट के लहजे, गति, भावना और संदर्भ को समझकर आवाज़ की पहचान बनाए रखते हुए नाटकीय, कोमल, तात्कालिक या हास्यपूर्ण ढंग से बोलने के लिए बनाया गया है। ElevenLabs का दावा है कि सितंबर 2026 में वह Artificial Analysis की Provider Voice Arena रैंकिंग में पहले स्थान पर था। कंपनी के अनुसार, गुप्त पहचान वाले परीक्षणों में लगभग 75 % श्रोताओं ने Cartesia Sonic 3.6, Inworld TTS-2 और Google के दो Gemini 3.8 TTS मॉडल की तुलना में इसकी आवाज़ पसंद की; बराबरी के नतीजों को आधा गिना गया।
आवाज़ को सामान्य भाषा में निर्देश देकर या टेक्स्ट में संकेत जोड़कर नियंत्रित किया जा सकता है, जैसे हँसी, फ़्रांसीसी उच्चारण में गुस्से से बोला गया संवाद, हल्की बारिश या फ़ोन का कंपन। कंपनी के अनुसार, Eleven v4 पिछले संस्करणों की तुलना में इन संकेतों का अधिक सटीक पालन करता है। अंतरराष्ट्रीय ध्वन्यात्मक वर्णमाला (IPA) का समर्थन काफ़ी बेहतर हुआ है। कई आवाज़ों वाले संवाद भी अधिक स्वाभाविक हुए हैं, और आवाज़ की पहचान दर्ज करने की नई विधि एजेंटों, ऑडियो पुस्तकों और विज्ञापनों में उसकी निरंतरता बनाए रखने में मदद करती है।
| ElevenLabs द्वारा प्रकाशित संकेतक | घोषित मान |
|---|---|
| Artificial Analysis की Provider Voice Arena रैंकिंग (सितंबर) | पहला |
| 4 प्रतिस्पर्धी मॉडलों के मुकाबले गुप्त पहचान वाले परीक्षणों में वरीयता | लगभग 75 % |
| Eleven v4 Turbo का माध्यिका अनुमान विलंब | लगभग 100 ms |
| Eleven v4 Turbo में पहली आवाज़ आने तक माध्यिका समय | लगभग 150 ms |
| समर्थित भाषाएँ | 90 से अधिक (Eleven v3: 70 से अधिक) |
| Eleven v4 की प्रति अनुरोध सीमा | 10 000 अक्षर (Eleven v3: 5 000) |
| तुरंत वॉइस क्लोन बनाने के लिए न्यूनतम ऑडियो | 10 सेकंड |
पहली आवाज़ आने तक का समय Cartesia, xAI, Google और OpenAI के मुकाबले WebSocket स्ट्रीमिंग में मापा गया था, जिसमें नेटवर्क विलंब हटाया गया था। Eleven v4 Turbo को ElevenAgents प्लेटफ़ॉर्म के साथ मिलकर अनुकूलित किया गया है। एक भाषा में रिकॉर्ड की गई आवाज़ दूसरी भाषाएँ उनके स्थानीय उच्चारण में बोलती है। Eleven v4 अब पेशेवर वॉइस क्लोन (Professional Voice Clones) भी स्वीकार करता है। लंबी ऑडियो रचनाओं को क्रम से जोड़ना भी अधिक भरोसेमंद हुआ है, जो Studio और Reader ऐप के लिए उपयोगी है।
दोनों मॉडल अभी ElevenAgents, ElevenCreative और API (eleven_v4 और eleven_v4_turbo) के माध्यम से उपलब्ध हैं। दो सप्ताह तक API पर Eleven v4 की रियायती दर प्रति दस लाख अक्षरों पर 22 डॉलर और Eleven v4 Turbo की 11 डॉलर है। ElevenCreative की Creator और उससे ऊँची योजनाओं में Eleven v4 मुफ़्त है, लेकिन उपयोग की सीमा मासिक क्रेडिट की दोगुनी है; सामान्य सूची मूल्य प्रकाशित नहीं किया गया है। यह रिलीज़ फरवरी 2026 में बाज़ार में आए Eleven v3 के बाद आई है।
🔗 Eleven v4 का परिचय · X पर घोषणा की पोस्ट श्रृंखला
Kling ने अक्टूबर के लिए Kling 4.0 की घोषणा की और Kling 4.0 Flash का प्रारंभिक एक्सेस खोला
28 सितंबर — Kling AI ने वीडियो मॉडल की अपनी नई पीढ़ी Kling 4.0 पेश की है, जिसकी आधिकारिक रिलीज़ अक्टूबर में निर्धारित है। इसका पहला संस्करण, Kling 4.0 Flash, 28 सितंबर से सीमित उपयोगकर्ताओं के लिए प्रारंभिक एक्सेस में उपलब्ध है। घोषणा वाले ट्वीट के अनुसार, ये वार्षिक Ultra सदस्य हैं। Kling ने तीन पहलुओं पर ज़ोर दिया है: दृश्य यथार्थ, रचनात्मक नियंत्रण और कथा की पूर्णता (narrative completeness)।
घोषित क्षमताओं के अनुसार, Kling 4.0 एक ही बार में 3 से 30 सेकंड तक का वीडियो, अधिकतम 4K में, दो चैनलों वाले स्टीरियो ऑडियो के साथ बना सकता है। कहानी को अधिकतम 10 मुख्य फ़्रेम और 8 000 टोकन तक के प्रॉम्प्ट से नियंत्रित किया जा सकता है। Omni Reference हर वीडियो निर्माण में अधिकतम 15 संदर्भ स्वीकार करता है: 10 चित्र, कुल मिलाकर अधिकतम 30 सेकंड के 5 वीडियो और 7 विषय, जिनमें से 3 वीडियो से लिए जा सकते हैं; ऑडियो संदर्भ केवल आवाज़ तक सीमित है। बिना टेक्सचर वाले नमूने और गहराई दर्शाने वाले मानचित्र गतिविधियों और फ़्रेम संयोजन को तय करने में काम आ सकते हैं। संपादन के दौरान अधिकतम 5 क्लिप में चेहरे के भाव, हावभाव, कैमरा, शैली या पृष्ठभूमि बदली जा सकती है। Kling का दावा है कि चित्र में पढ़ने योग्य टेक्स्ट आता है और मॉडल कैंटोनीज़, सिचुआनीज़ तथा भारतीय अंग्रेज़ी समेत अधिक भाषाएँ, उच्चारण और बोलियाँ संभालता है।
| तकनीकी विनिर्देश | Kling 4.0 | Kling 4.0 Flash |
|---|---|---|
| उपलब्धता | अक्टूबर में आधिकारिक रिलीज़ | 28 सितंबर से सीमित प्रारंभिक एक्सेस |
| वीडियो निर्माण के तरीके | टेक्स्ट से वीडियो, चित्र से वीडियो, पहला और आख़िरी फ़्रेम, 10 मुख्य फ़्रेम, Omni Reference | टेक्स्ट से वीडियो, चित्र से वीडियो, Omni Reference |
| एक बार में बना वीडियो | 3 से 30 सेकंड | 3 से 20 सेकंड |
| अधिकतम रिज़ॉल्यूशन | 4K (साथ में 720p और 1080p) | 720p |
| डायनेमिक रेंज | 1080p और 4K में 10 बिट HDR, बाद में उपलब्ध कराने की घोषणा | 8 बिट SDR |
सभी सुविधाएँ अभी उपलब्ध नहीं हैं। रिलीज़ नोट के अनुसार, 1080p और 4K में 10 बिट HDR आउटपुट बाद में आएगा (coming soon), हालाँकि ट्वीट इसे Kling 4.0 की सुविधाओं में गिनता है। वीडियो को 2 मिनट तक बढ़ाने की सुविधा भी बाद में आएगी। Kling ने अपना निर्माण पेज भी नया बनाया है: सभी संदर्भ अब एक ही इनपुट फ़ील्ड में आते हैं और इसमें एक कैनवस जोड़ा गया है, जहाँ एजेंट माँगे गए काम करता है। घोषणा में कोई कीमत, API एक्सेस या बेंचमार्क नहीं दिया गया है। इसके साथ Kling 4.0 से बनी लघु फ़िल्म THE BEAT दिखाई गई है।
🔗 Kling 4.0 के रिलीज़ नोट · X पर घोषणा
कोडिंग एजेंट: Claude Code 2.1.284, Codex CLI 0.158.0, Copilot CLI 1.0.89 और उसका SDK, Devin, Delta तथा Gemini CLI
Claude Code 2.1.284 सभी योजनाओं और प्रदाताओं पर ऑटो मोड में शुरू होता है
28 सितंबर — मॉडल की घोषणा से कुछ ही समय पहले, 18:02 UTC पर जारी Claude Code 2.1.284 में Claude Sonnet 5.5 जोड़ा गया है। यह Anthropic API पर डिफ़ॉल्ट Sonnet मॉडल बन गया है। इस संस्करण में 100 प्रविष्टियाँ हैं: 57 सुधार, 18 उन्नयन, 14 नई सुविधाएँ और 11 बदलाव।
सबसे स्पष्ट बदलाव अनुमतियों का है: कोई मोड सेट न होने पर टर्मिनल और VS Code के इंटरैक्टिव सत्र अब सभी योजनाओं और सभी प्रदाताओं पर ऑटो मोड में शुरू होते हैं। 25 सितंबर को आए 2.1.283 में तृतीय पक्ष प्रदाताओं और टेलीमेट्री रहित सत्रों के लिए यह पहले ही लागू हो चुका था; 2.1.284 इसे सभी पर लागू करता है, जबकि permissions.defaultMode सेटिंग को प्राथमिकता मिलती रहती है। नया जवाब, “हाँ, लेकिन अगली बार फिर पूछना” (Yes, but ask again next time), कार्य निर्देशिकाओं के बाहर एक बार पढ़ने की अनुमति देता है और आगे ऐसी पहुँच के लिए Claude Code फिर पूछता है।
Ultracode अब प्रयास स्तर के स्लाइडर से हटकर /effort में अलग टॉगल बन गया है (Tab कुंजी, या /effort ultracode on और off)। यह अब xhigh प्रयास स्तर लागू नहीं करता और चुने गए किसी भी स्तर पर सक्रिय रहता है। VS Code में प्रयास स्तर के स्लाइडर के नीचे भी ऐसा ही स्विच है।
| 2.1.284 की नई सुविधा | कमांड या सेटिंग |
|---|---|
| सभी योजनाओं और प्रदाताओं पर डिफ़ॉल्ट ऑटो मोड | permissions.defaultMode को प्राथमिकता मिलती है |
| Ultracode का स्वतंत्र टॉगल | /effort में Tab, या /effort ultracode on और off |
| विफल MCP सर्वरों को एक साथ फिर जोड़ना | /mcp reconnect all |
| Claude apps गेटवे पर डॉलर में खर्च | /usage और स्थिति पंक्ति (फ़ील्ड used_usd, limit_usd, period) |
| “Prompt is too long” बना रहने पर दूसरी बार संदर्भ संक्षेपण | अपने आप |
सुरक्षा के लिहाज़ से, मार्केटप्लेस, claude.ai या npm से आए प्लगइन अब अपने टूल को पहले से स्वीकृत नहीं कर सकते, जब प्रशासन केवल अपने प्रबंधित नियमों (allowManagedPermissionRulesOnly) की अनुमति देता हो। प्रोजेक्ट के बाहर से प्रतीकात्मक लिंक द्वारा जुड़े .claude/rules नियमों के लिए स्वीकृति माँगी जाती है। मेमोरी लोड करते समय MEMORY.md में अदृश्य वर्ण और Claude Code के मार्कअप की नकल करने वाले टैग निष्क्रिय किए जाते हैं। विश्वसनीयता के लिए, जवाब का प्रवाह ख़राब होने पर “JSON Parse error” दिखाने के बजाय फिर प्रयास किया जाता है। दोबारा शुरू हुए सत्र की MCP कॉल अपने सर्वर के लिए अधिकतम 10 सेकंड प्रतीक्षा करती हैं। अंत में, जब Sonnet मॉडल के सुरक्षा उपाय किसी संदेश को चिह्नित करते हैं, तो सूचना अधिक स्पष्ट कारण देती है और अनुरोध बदलकर फिर चलाने का सुझाव देती है।
Codex CLI 0.158.0: चयन पर कॉपी और MCP के लिए OAuth क्लाइंट सीक्रेट
28 सितंबर — 05:07 UTC पर जारी Codex CLI 0.158.0, 26 सितंबर के 0.157.1 के बाद पहला स्थिर संस्करण है। इसके रिलीज़ नोट में 0.157.0 के बाद से 188 pull requests दर्ज हैं। पूरी स्क्रीन वाला इंटरफ़ेस (fullscreen TUI) चयन पर कॉपी (copy-on-select) और दाएँ क्लिक से पेस्ट को कॉन्फ़िगर करने देता है। बातचीत की प्रतिलिपि से कॉपी किया गया अंश अपना Markdown स्वरूप बनाए रखता है।
| संबंधित सुविधा | सेटिंग या विवरण |
|---|---|
| चयन पर कॉपी | tui.copy_on_select: डिफ़ॉल्ट रूप से auto (tmux, Zellij, Ghostty और Kitty को छोड़कर सीधे चलने वाले macOS टर्मिनल), always, never |
| दाएँ क्लिक से पेस्ट | tui.right_click_paste: auto (Windows, Linux, WSL), on (macOS भी), off |
| OAuth वाले MCP सर्वर | codex mcp add --oauth-client-secret, कुंजी oauth.client_secret |
| Exec-server | सीधे WebSocket कनेक्शन के लिए बेयरर टोकन |
| चित्र निर्माण | स्पष्ट रूप से पारदर्शी पृष्ठभूमि (transparent_background), बातचीत में मौजूद चित्रों का संपादन |
Codex अब उन MCP सर्वरों से जुड़ सकता है जिन्हें सीक्रेट वाला पहले से पंजीकृत OAuth क्लाइंट चाहिए। Exec-server से सीधे WebSocket कनेक्शन बेयरर टोकन (bearer tokens) से सुरक्षित किए जा सकते हैं, भले ही वे app-server से होकर जाएँ। सुरक्षा के लिए, टर्मिनल को भेजे जाने वाले इनपुट की स्वीकृति स्थिर सुविधा बन गई है और ऊँची अनुमतियों से चलाई गई कमांड के लिए डिफ़ॉल्ट रूप से सक्रिय रहती है। सुधार मुख्यतः सैंडबॉक्स से जुड़े हैं: सामान्य Windows 10 पथ, संग्रहीत क्रेडेंशियल अस्वीकार होना, भीतर स्थित लिखने योग्य रूट के साथ Linux पर शुरुआत, और Linux तथा macOS पर Git मेटाडेटा की सुरक्षा।
Copilot CLI 1.0.89 स्थिर संस्करण में आया, Copilot SDK 1.0.15 के आउटपुट अब टाइप निर्धारित हैं
28 सितंबर — GitHub ने Copilot CLI 1.0.89 का स्थिर संस्करण जारी किया (19:20 UTC)। 27 सितंबर को वर्णित पूर्वावलोकन 1.0.89-5 में .claude/rules फ़ाइलों के लिए समर्थन पहले ही आ चुका था; रिलीज़ नोट्स की 35 प्रविष्टियों में कई सुविधाएँ नई हैं। Auto रूटिंग अब एक स्तर सुझाती है, जिसे शॉर्टकट या एक क्लिक से बदला जा सकता है। इसमें Fast प्रोफ़ाइल हटा दी गई है, क्योंकि वह समर्थित नहीं थी: सहेजी गई Fast वरीयता अब Balance पर लौट आती है। पुल रिक्वेस्ट बनाते समय रिपॉज़िटरी के टेम्पलेट का पालन किया जाता है, जिसमें अनिवार्य अनुभाग और चेकलिस्ट शामिल हैं। स्थानीय सत्र में, खाली इनपुट पर दो बार Escape दबाने से वह प्रॉम्प्ट फिर खुल जाता है जिसकी बारी अभी शुरू नहीं हुई थी। सीधे इंस्टॉल किए गए प्लगइन अब सक्रिय और निष्क्रिय किए जा सकते हैं (copilot plugin enable)। सैंडबॉक्स में लपेटी गई gh और git कमांड (timeout 60 gh …) काम करती हैं, और स्थानीय नेटवर्क तक पहुँच चालू होने पर Windows में localhost उपलब्ध हो जाता है।
इसके तुरंत बाद (19:38 UTC), GitHub Copilot SDK, जो किसी ऐप में Copilot का एजेंट रनटाइम जोड़ता है, पाँच पूर्वावलोकन संस्करणों के बाद 1.0.15 पर पहुँचा। मुख्य नई सुविधा छह SDK (TypeScript, Python, Go, Java, C# और Rust) में टाइप निर्धारित संरचित आउटपुट है; डेवलपर JSON स्कीमा या उस भाषा का उपयुक्त टाइप देता है, और मॉडल मुक्त पाठ के बजाय सत्यापित, टाइप निर्धारित आउटपुट लौटाता है। एक प्रायोगिक प्रबंधक ऐप को MCP सर्वर या स्किल इंस्टॉल करने से पहले मानवीय समीक्षा अनिवार्य करने देता है, जिसमें स्पष्ट निर्णय देना होता है (पुष्टि करना, अस्वीकार करना या रद्द करना)। Rust में इस रनटाइम को इंस्टॉल करने पर उपयोग में बनी रहने वाली मेमोरी भी लगभग 99% घट गई है।
🔗 Copilot CLI v1.0.89 · Copilot SDK v1.0.15
Devin 30 से 40% सस्ता हुआ, Devin Fusion FrontierCode 1.1 Extended में शीर्ष पर
28 सितंबर — Cognition ने घोषणा की कि Devin का उपयोग अब काफ़ी सस्ता है: Fusion और Normal मोड में 30 से 40% कम, Ultra मोड में 15 से 20% कम और उसके कोड समीक्षा टूल Devin Review के लिए 70% तक कम। कंपनी इन बचतों का श्रेय नवीनतम मॉडलों, जिनमें उसका अपना SWE-2 भी है, के एकीकरण और Devin के क्लाउड हार्नेस (cloud harness) पर किए गए काम को देती है: एक ही टूल कॉल में अधिक काम एक साथ करना (फ़ॉर्मैट करना, विश्लेषण करना और परीक्षण करना), स्वतंत्र कॉल समानांतर चलाना और प्रॉम्प्ट कैश का बेहतर पुनः उपयोग करना। इस हार्नेस के लिए दिए गए अनुमान उदाहरणों पर आधारित हैं, मापे गए परिणामों पर नहीं।
Cognition का कहना है कि उसने हर मोड की क्षमता बनाए रखी है या सुधारी है। Fusion एक सक्षम मुख्य मॉडल के साथ कम लागत वाला सहायक (sidekick) जोड़ता है, और पोस्ट का ग्राफ़ इसे FrontierCode 1.1 Extended में शीर्ष पर दिखाता है।
| Cognition द्वारा मूल्यांकित कॉन्फ़िगरेशन | FrontierCode 1.1 Extended स्कोर | प्रति कार्य औसत लागत |
|---|---|---|
| Devin Fusion | 68,8 | 0,60 डॉलर |
| Opus 5.5 (high) | 65,2 | 0,90 डॉलर |
| Fable 5.1 (medium) | 63,6 | 2,68 डॉलर |
| GPT-6 Astra (high) | 63,1 | 2,62 डॉलर |
| SWE-2 (high) | 60,1 | 0,64 डॉलर |
| GPT-6 Sol (high) | 59,6 | 0,87 डॉलर |
high प्रयास स्तर पर दिए गए Opus 5.5 (65,2) और GPT-6 Astra (63,1) के मान, उसी दिन प्रकाशित Sonnet 5.5 के ग्राफ़ में दिए गए मानों (65,3 और 64,5) से अलग हैं; उस ग्राफ़ में प्रयास स्तर नहीं बताया गया है। कम खर्च वाला यह Devin आज से उपलब्ध है, लेकिन नई मूल्य सूची प्रकाशित नहीं की गई है।
🔗 Devin अब 40% तक अधिक लागत-कुशल है
Devin के 25 सितंबर के रिलीज़ नोट्स और Devin Mobile का बीटा
25 सितंबर — Devin के 25 सितंबर के रिलीज़ नोट्स, जिन पर अब तक ध्यान नहीं गया था, Marketplace में 57 होस्ट किए गए MCP एकीकरण (hosted MCP) जोड़ते हैं, जिनमें Buildkite, Brex, Expo, Vanta, WorkOS और Wix शामिल हैं। जब उससे ऐसा रिपोर्ट माँगा जाता है जिसे इंटरैक्टिव बनाने से लाभ हो (ग्राफ़, तालिकाएँ, आरेख), और फ़ॉर्मैट निर्दिष्ट नहीं होता, तो Devin एक इंटरैक्टिव HTML रिपोर्ट भी बनाता है। नया उप-सत्र अपने मूल सत्र के सारांश के साथ शुरू होता है, जो इनपुट क्षेत्र में हटाई जा सकने वाली चिप के रूप में दिखता है। जिस सत्र की मशीन निष्क्रिय हो गई हो, वह पूर्वावलोकन URL खोलते या SSH से उससे जुड़ते ही फिर सक्रिय हो जाता है। ऑटोमेशन साझा Outpost पर चल सकते हैं, और Devin Azure DevOps की पुल रिक्वेस्ट पर विफल जाँचों के Azure Pipelines लॉग पढ़ता है।
28 सितंबर को Cognition ने Devin Mobile के बीटा की प्रतीक्षा सूची भी खोली। पंजीकरण पृष्ठ इसका सार एक वाक्य में देता है: Devin क्लाउड या आपकी मशीन पर चलता है, अपने ब्राउज़र में परीक्षण करता है और पुल रिक्वेस्ट मर्ज करने के लिए तैयार होने तक नहीं रुकता। सामान्य उपलब्धता की तारीख और कीमत, दोनों प्रकाशित नहीं की गई हैं।
🔗 Devin के रिलीज़ नोट्स · X पर Devin Mobile
Zed ने Delta 0.18 की घोषणा की, Gemini CLI ने बिना बदलाव वाली nightly जारी की
28 सितंबर — Zed ने तारीख बताए बिना घोषणा की कि एजेंटों के साथ कोड लिखने के उसके बहु-उपयोगकर्ता वातावरण Delta का संस्करण 0.18, Delta के थ्रेड्स (threads) को पहले से मौजूद Git worktrees में चलाएगा; 23 सितंबर को जारी 0.17 प्रत्येक समानांतर कार्य को पहले ही उसके अपने कार्यक्षेत्र में अलग कर चुका था। Google की ओर से, 28 सितंबर को जारी Gemini CLI की nightly में कोई बदलाव नहीं है: यह 26 सितंबर वाली nightly के समान कमिट पर आधारित है, और स्थिर v0.61.0 तथा पूर्वावलोकन v0.62.0-preview.0 भी यथावत हैं।
🔗 X पर Zed · Gemini CLI v0.63.0-nightly.20260928
Perplexity के Agent API में पुनः उपयोग की सुविधा: Profiles, संस्करणबद्ध Skills और साझा कनेक्टर
28 सितंबर — Perplexity ने अपने Agent API में टीमों के लिए बनाई गई पुनः उपयोग योग्य और संस्करणबद्ध कॉन्फ़िगरेशन परत जोड़ी। इसका मुख्य हिस्सा Profile है, जो एजेंट को परिभाषित करने वाली हर चीज़—मॉडल, निर्देश, टूल, Skills, कनेक्टर और रनटाइम सेटिंग—को एक विशिष्ट संस्करणबद्ध पहचानकर्ता के अंतर्गत सहेजता है। परियोजना का प्रशासक एजेंट को एक बार कॉन्फ़िगर करके अधिकृत डेवलपरों के लिए उपलब्ध कराता है; फिर हर ऐप को केवल अपना डेटा देना होता है।
कस्टम Skills निर्देशों, प्रक्रियाओं और सहायक फ़ाइलों को संस्करणबद्ध पैकेज में रखते हैं: प्लेटफ़ॉर्म टीम इनमें अपनी डिप्लॉयमेंट जाँचें, पिछली स्थिति में लौटने (rollback) के मानदंड और रिपोर्ट का प्रारूप रख सकती है, फिर हर ऐप को बदलने के बजाय नया संस्करण प्रकाशित कर सकती है। अगस्त के अंत में शुरू किए गए प्रबंधित कनेक्टर (managed connectors) अब ऐसे संसाधन हैं जिन्हें प्रशासक पूरी परियोजना के साथ साझा कर सकता है: ऐप अपने-अपने क्रेडेंशियल या टूल परिभाषाएँ सहेजे बिना उनका संदर्भ देते हैं।
| जोड़ा गया संसाधन | Agent API में भूमिका | घोषित उपलब्धता |
|---|---|---|
| Profiles | संस्करणबद्ध पहचानकर्ता के अंतर्गत मॉडल, निर्देश, टूल, Skills, कनेक्टर और रनटाइम सेटिंग | उपलब्ध |
| कस्टम Skills | परियोजना के सदस्यों द्वारा उपयोग किए जाने वाले संस्करणबद्ध निर्देश, प्रक्रियाएँ और सहायक फ़ाइलें | उपलब्ध |
| प्रबंधित कनेक्टर | प्रशासक द्वारा साझा किए गए स्वीकृत एकीकरण (GitHub, Slack, Google Drive, Datadog, Linear, Notion) | पूर्वावलोकन |
सभी सेटिंग API Console से की जाती हैं, और सदस्य उसी परियोजना की API कुंजी से इन संसाधनों को कॉल करते हैं; पोस्ट में किसी कीमत की घोषणा नहीं है। उसी दिन API चेंजलॉग की एक प्रविष्टि ने Agent API के xhigh प्रीसेट को GPT-5.6 Sol (openai/gpt-5.6-sol) से Claude Opus 5.5 (anthropic/claude-opus-5-5) पर बदला; प्रॉम्प्ट, तर्क प्रयास, टूल, टोकन बजट और चरण सीमाएँ यथावत रहीं। तीन दिन पहले low, medium और high प्रीसेट GPT-6 पर बदले गए थे।
🔗 Agent API अब पुनः उपयोग योग्य एजेंटों को समर्थन देता है · Perplexity API चेंजलॉग
SpaceXAI ने Team Bots शुरू किए, पूरी टीम के लिए साझा Grok Bots
28 सितंबर — SpaceXAI ने Team Bots शुरू किए: ये किसी टीम की भूमिका या कार्यप्रवाह के लिए बनाए गए Grok Bots हैं, जिन्हें उसके सभी सदस्य साझा करते हैं। हर सदस्य Bot के साथ अलग से भी काम कर सकता है। Bot साझा होता है, लेकिन बातचीत निजी रहती है: संदर्भ और स्मृतियाँ प्रत्येक उपयोगकर्ता के लिए अलग हैं, जबकि skills पूरी टीम के लिए साझा हैं। हर Team Bot की Slack में अपनी पहचान होती है और उसे ऐसे चैनल में आमंत्रित किया जा सकता है जहाँ पूरी टीम उससे सवाल पूछे।
| Bot का घटक | SpaceXAI द्वारा बताई गई भूमिका |
|---|---|
| संदर्भ | फ़ाइलें, निर्देश और skills |
| Plugins | Salesforce, Notion या GitHub में काम; इन्हें हर सदस्य अपने लिए या टीम के लिए जोड़ सकता है |
| क्रेडेंशियल | ऐसे तृतीय-पक्ष API तक पहुँच जिनके लिए plugin नहीं है |
| स्मृतियाँ | अपनी भूमिका में बेहतर होने के लिए Bot जो याद रखता है; प्रत्येक उपयोगकर्ता के लिए अलग |
SpaceXAI अपने उपयोग के उदाहरण भी देता है। हर बड़े व्यावसायिक खाते का अपना Team Bot है, जो रात में ग्राहक से जुड़ी खबरें, Gong कॉल, Notion दस्तावेज़ और Slack थ्रेड का विश्लेषण करता है, फिर सुबह Slack में जानकारी प्रकाशित करता है। Notion, Linear, Hex, Datadog और Cursor से जुड़े इंजीनियरिंग Bot ने सैकड़ों Cloud Agents संचालित किए हैं: इस तरह पाँच लोगों की एक टीम ने प्रतिदिन 100 से अधिक पुल रिक्वेस्ट पूरी कीं और कुछ ही हफ़्तों में Team Bots शुरू कर दिए। ग्राहकों में, बीमा कंपनी Harper का कहना है कि उसने 24 घंटों में एक Team Bot बनाया जो उसके ग्राहकों को समाप्त हो चुकी बीमा पॉलिसियाँ बहाल करने में मदद करता है; उसके CEO के अनुसार इससे ग्राहकों को 120,000 डॉलर से अधिक की बचत हुई है।
Team Bots आज से Teams और Enterprise प्लान में सार्वजनिक बीटा के रूप में उपलब्ध है। बिक्री, उत्पाद प्रबंधन, मार्केटिंग और डेटा विश्लेषण के लिए पहले से कॉन्फ़िगर किए गए Team Bots भी उपलब्ध हैं। SpaceXAI ने कीमत या कोटे की जानकारी नहीं दी है।
🔗 Team Bots (SpaceXAI) · X पर @bot की घोषणा
H Company ने Holo4 जारी किया, 27B और 35B-A3B के खुले वज़न वाले एजेंट मॉडल
28 सितंबर — H Company ने अपनी नई एजेंट मॉडल शृंखला Holo4 दो आकारों में जारी की: 27 अरब पैरामीटर वाला एक डेंस मॉडल और 35B-A3B विशेषज्ञों का मिश्रण (Mixture of Experts)। दोनों H Models API पर उपलब्ध हैं और Hugging Face पर BF16, FP8, NVFP4 तथा 4-बिट GGUF प्रारूपों में प्रकाशित किए गए हैं। H ने Holotron4 Nano भी जोड़ा है, जिसे NVIDIA के Nemotron 3 Nano Omni पर अपनी पोस्ट-ट्रेनिंग प्रक्रिया लागू करके बनाया गया है। एक ही मॉडल ग्राफ़िकल इंटरफ़ेस, कोड, MCP या API के ज़रिए कंप्यूटर, वेब, Android या कोड सैंडबॉक्स में काम करता है; H ने इसे पहले सुपरवाइज़्ड लर्निंग और फिर रीइन्फोर्समेंट लर्निंग से प्रशिक्षित किया, विशेष रूप से लगभग 10,000 सत्यापन योग्य कार्यों पर, जिन्हें उसका Agentic Task Factory साधारण दस्तावेज़ों से तैयार करता है।
| मूल्यांकित मॉडल | आधार और लाइसेंस | प्रकाशित स्कोर |
|---|---|---|
| Holo4 27B | Qwen3.8-27B, CC-BY-NC-4.0 (गैर-व्यावसायिक) | OSWorld 2.0 पर 61,7 %; प्रति कार्य 0,08 डॉलर की लागत पर OSWorld में 85,2 % |
| Holo4 35B-A3B | Qwen3.6-35B-A3B, Apache-2.0 | OSWorld 2.0 पर 30,9 % |
| Holotron4 Nano (Holotron4-30B-A3B) | Nemotron 3 Nano Omni, NVIDIA Open Model Agreement | आधार मॉडल की तुलना में सुधार केवल ग्राफ़ में दिया गया है |
| Claude Opus 5.5 (H द्वारा उद्धृत संदर्भ) | बंद मॉडल | OSWorld 2.0 पर 81,8 % |
H परीक्षण की शर्तें स्पष्ट करता है: Holo4 को उसके अपने हार्नेस में OSWorld 2.0 पर केवल एक रन से मापा गया है और उसकी तुलना अन्य हार्नेस तथा प्रयास स्तरों से प्राप्त सार्वजनिक स्कोर से की गई है; AutomationBench में 600 सार्वजनिक कार्यों में से 480 उस विभाजन में हैं जिसका उपयोग प्रशिक्षण डेटा एकत्र करने के लिए किया गया था। H अपने सार्वजनिक स्कोर के पीछे के सभी चरणवार रिकॉर्ड प्रकाशित करता है, जिन्हें Hugging Face पर चरण-दर-चरण देखा या डाउनलोड किया जा सकता है। उसने आने वाले दिनों में अनुमान की गति बढ़ाने के लिए DSpark के प्रारंभिक संस्करण जारी करने की भी घोषणा की है।
🔗 Hugging Face पर Holo4 की पोस्ट · H Company की घोषणा
रोबोटिक्स: Sakana AI के SAIL की सफलता दर 25 से 73% पहुँची, ProjectSim ने सिमुलेशन में मापन पर सवाल उठाया
28 सितंबर — Sakana AI ने SAIL (Scaling In-Context Imitation Learning) पेश किया, जो टोक्यो विश्वविद्यालय के साथ किया गया शोध है और IROS 2026 सम्मेलन में स्वीकार हो चुका है; शोधपत्र का arXiv पहचानकर्ता मार्च 2026 का है, जबकि आज की नई बात इसकी सार्वजनिक प्रस्तुति है। शोध का सवाल है: क्या किसी मौजूदा विज़न-लैंग्वेज मॉडल (VLM) को दोबारा प्रशिक्षित किए बिना, अनुमान के समय अधिक गणना देकर उससे रोबोट की भरोसेमंद गतिविधियाँ प्राप्त की जा सकती हैं?
SAIL संदर्भ में रखे गए कुछ सफल प्रदर्शनों से पूरी गतिविधि योजना बनाता है और उसे सिमुलेशन में चलाता है; फिर दूसरा VLM वीडियो से कार्य की प्रगति का अनुमान लगाता है, और यह प्रतिक्रिया Monte-Carlo ट्री सर्च (MCTS) का मार्गदर्शन करती है। केवल चुनी गई गतिविधि योजना वास्तविक रोबोट को भेजी जाती है। Gemini Robotics-ER 1.5 अपने वज़न बदले बिना दोनों भूमिकाएँ निभाता है।
| मूल्यांकित विधि | खोज नोड | छह सिमुलेटेड कार्यों पर औसत सफलता दर |
|---|---|---|
| एक बार में निर्माण | 1 | 25 % |
| गहराई-प्रथम खोज | 15 | 37 % |
| चौड़ाई-प्रथम खोज | 15 | 51 % |
| SAIL | 6 | 55 % |
| SAIL | 15 | 65 % |
| SAIL | 45 | 73 % |
ये दरें उन कॉन्फ़िगरेशन को गिनती हैं (ALOHA सिमुलेटर में प्रति कार्य 20) जिनके लिए निर्धारित बजट के भीतर सफल गतिविधि योजना मिलती है; सफलता की पुष्टि सिमुलेटर करता है, VLM नहीं। LeRobot SO-101 रोबोटिक भुजा पर, कटोरे में ब्लॉक रखने के छह प्रयासों में SAIL पाँच बार सफल होता है, जिसके लिए 15 संभावित गतिविधि योजनाओं का बजट दिया गया था। मिली हुई गतिविधि योजनाओं पर प्रशिक्षित इमिटेशन नीति भी अधिक तेज़ी से चलते हुए छह में से पाँच बार सफल होती है। Sakana सीमाएँ स्वीकार करता है: ओपन-लूप निष्पादन, खोज के लिए अतिरिक्त गणना, और वास्तविक रोबोट पर केवल एक कार्य तथा हर विधि के छह प्रयासों तक सीमित मूल्यांकन।
🔗 Sakana AI की पोस्ट · SAIL परियोजना का पृष्ठ
ProjectSim ने रोबोटिक्स के परीक्षण मानकों की स्थिति का जायज़ा लिया
28 सितंबर — सिमुलेशन में मिले स्कोर और वास्तविक दुनिया के स्कोर के बीच का अंतर ही ProjectSim के पहले प्रयोग का विषय है। अपने सारांश लेख में, जिसमें कोई नया परिणाम नहीं दिया गया है, Luca Cilio ने MetaWorld और LIBERO से लेकर RoboChallenge जैसे साझा भौतिक परीक्षणों तक, वस्तुओं को संभालने की क्षमता जाँचने वाले परीक्षण मानकों की समीक्षा की है। वे RoboCasa365 के आँकड़ों के आधार पर याद दिलाते हैं कि 30 000 प्रदर्शनों पर फाइन-ट्यून किया गया GR00T N1.5 अलग-अलग कौशलों में 43 % सफलता पाता है, लेकिन फाइन-ट्यूनिंग के दौरान न देखे गए संयोजनों पर यह दर गिरकर 4,4 % रह जाती है। ProjectSim का प्रयोग यह जाँचना चाहता है कि अधिक यथार्थवादी सिमुलेटेड दृश्य, जिनकी ज्यामिति, दिखावट और भौतिक गुण फिर से तैयार किए गए हों, सिमुलेशन के स्कोर को वास्तविक रोबोट पर मापे गए स्कोर के करीब लाते हैं या नहीं; अभी कोई परिणाम प्रकाशित नहीं हुआ है।
Mistral ने म्यूनिख में औद्योगिक AI और भौतिकी के लिए AI को समर्पित केंद्र खोला
28 सितंबर — Mistral म्यूनिख में एक केंद्र खोल रहा है। वहाँ भौतिकी के लिए AI (Physics AI) और औद्योगिक AI (Industrial AI) पर शोध करने वाली टीमें होंगी। उनके साथ ऐसे अनुप्रयुक्त इंजीनियर भी काम करेंगे जो साझेदार कंपनियों के लिए सीधे काम करते हैं: Mistral यहाँ खुद को सॉफ़्टवेयर विक्रेता के बजाय दीर्घकालीन प्रौद्योगिकी साझेदार के रूप में प्रस्तुत करता है।
| Mistral द्वारा उल्लिखित साझेदार | घोषित कार्य |
|---|---|
| BMW | क्रैश सिमुलेशन और इंजीनियरिंग AI |
| Siemens Energy | औद्योगिक AI के अनुप्रयोग |
| म्यूनिख तकनीकी विश्वविद्यालय (TUM) | ऑटोमोबाइल वायुगतिकी के लिए पवन सुरंग में डिजिटल ट्विन |
यह केंद्र मई 2026 में Emmi AI के अधिग्रहण की अगली कड़ी है। उस अधिग्रहण से कम्प्यूटेशनल फ़्लुइड डायनेमिक्स (CFD), संरचनात्मक यांत्रिकी और बहुभौतिकी सिमुलेशन में विशेषज्ञता रखने वाले 30 से अधिक भौतिक विज्ञानी, शोधकर्ता और इंजीनियर Mistral से जुड़े थे। TUM और प्रोफ़ेसर Nikolaus A. Adams के साथ Mistral ऑटोमोबाइल वायुगतिकी के लिए डिजिटल ट्विन विकसित करेगा। इसके लिए पवन सुरंग के सेंसरों से वास्तविक समय में मिले मापों को ऑफ़लाइन गणना किए गए CFD सिमुलेशन के साथ जोड़ा जाएगा, ताकि वास्तविक समय में सटीक वायुगतिकीय अनुमान मिल सकें।
लेख में डिजिटल संप्रभुता का तर्क भी दोहराया गया है: ग्राहकों को मॉडल वेट उपलब्ध होंगे, मॉडल उनके अपने बुनियादी ढाँचे पर और यूरोपीय कानून के तहत चलेंगे, तथा डेटा संगठन से बाहर नहीं जाएगा। इसमें यह भी कहा गया है कि Mistral 2030 तक यूरोप में एक गीगावाट कम्प्यूटिंग क्षमता बनाएगा। लेख में जर्मनी के संघीय डिजिटल परिवर्तन मंत्री Karsten Wildberger और बवेरिया के राज्य चांसलरी प्रमुख Florian Herrmann का उल्लेख है। Mistral म्यूनिख क्षेत्र में भर्ती कर रहा है, लेकिन कर्मचारियों की संख्या या निवेश राशि नहीं बताता।
🔗 नमस्ते, जर्मनी! (Mistral AI)
NVIDIA और Nscale ने DSX MaxLPS का परीक्षण किया: समान बिजली बजट में 37 % अधिक GPU और 49 % अधिक थ्रूपुट
27 सितंबर — NVIDIA ने Nscale के साथ किए गए DSX MaxLPS के संख्यात्मक मूल्यांकन को प्रकाशित किया है। यह सॉफ़्टवेयर ऑपरेटर की नीतियों के अनुसार AI फ़ैक्टरी के संसाधनों के बीच बिजली का आवंटन करता है। NVIDIA के अनुसार, इससे स्वीकृत समान बिजली बजट में 40 % तक अधिक GPU लगाए जा सकते हैं; लेख इस बात पर ज़ोर देता है कि यह समन्वित आवंटन है, साइट को मिलने वाली बिजली में बढ़ोतरी नहीं।
परीक्षण आइसलैंड के Keflavík में Verne परिसर स्थित Nscale के डेटा सेंटर में GB300 NVL72 पर चला। यह केंद्र पूरी तरह नवीकरणीय ऊर्जा से संचालित है। परीक्षण में FP4 पर Kimi K2.5, NVIDIA Dynamo और TensorRT LLM का उपयोग हुआ। समान आवंटित 264,4 kW बजट में GPU की संख्या 140 से बढ़कर 192 हुई, जबकि मौजूदा इंस्टेंस के थ्रूपुट में कमी नहीं आई।
| मापा गया संकेतक | स्थिर आधार | DSX MaxLPS के साथ | दर्ज अंतर |
|---|---|---|---|
| प्रबंधित GPU | 140 | 192 | +37,1 % |
| सामान्यीकृत कुल थ्रूपुट | 1 084 503 tokens/s | 1 618 443 tokens/s | +49,2 % |
| मापी गई कुल बिजली खपत | 166,2 kW | 198,9 kW | +19,7 % |
| बिजली बजट का उपयोग | 62,9 % | 75,2 % | +12,3 अंक |
| आवंटित प्रति वाट थ्रूपुट | 4,10 tokens/s/W | 6,12 tokens/s/W | +49,2 % |
लेख इसकी कीमत भी स्पष्ट करता है: माध्यिका और P75 विलंबता आधार मान से 5 % के भीतर रहती हैं, लेकिन पहले token से पहले का P99 विलंब 17 % बढ़ जाता है; इसका आधार मान 15,7 सेकंड है। NVIDIA ऑपरेटरों को पाँच चरणों में सत्यापन की सलाह देता है, जिसमें बिजली से जुड़ी सीमा तय करने से लेकर उत्पादन की सीमाएँ निर्धारित करने तक के चरण हैं। यह मूल्यांकन HGX B200 पर Lambda के सत्यापन के बाद आया है, जिसे 15 सितंबर को प्रस्तुत किया गया था: 16 नोड के बजट में 19 नोड। Vera Rubin के लिए अनुमान, जिनमें प्रवेश पर 45 °C का तरल शीतलन शामिल है, अलग से प्रस्तुत किए गए हैं।
संक्षिप्त समाचार
- DeepSeek Harness 0.2.0-rc.1 — यह 0.2.0 श्रृंखला का पहला release candidate और DeepSeek के एजेंट हार्नेस का 23वाँ पूर्वावलोकन संस्करण है; अभी भी कोई स्थिर संस्करण नहीं है। DeepSeek खाते के मॉडलों के साथ बातचीत अब अतिरिक्त API कुंजी के बिना वेब पर खोज कर सकती है, और स्वचालित कार्यों को वैकल्पिक प्लगइन पैकेज में स्थानांतरित किया गया है। 🔗 स्रोत
- Vercel AI Gateway पर Pixel Canary — 25 सितंबर से Vercel अपने गुप्त परीक्षण काल के दौरान एक अज्ञात संपादक का यह कोड मॉडल मुफ़्त दे रहा है। इसने 31 में से 28 Next.js कार्य pass@4 पर पूरे किए, जो GPT-6 Astra (high) के बराबर है; AGENTS.md के ज़रिए दस्तावेज़ उपलब्ध कराने पर इसने 31 में से 30 कार्य पूरे किए। डेटा को बिल्कुल भी संग्रहीत न करने की सुविधा उपलब्ध नहीं है। 🔗 स्रोत
- GitHub Actions के स्वयं होस्ट किए गए रनर — GitHub Enterprise Cloud पर न्यूनतम संस्करणों को पूरी तरह लागू करना 29 सितंबर से शुरू होगा: संस्करण 2.329.0 से नीचे का रनर अब पंजीकृत नहीं हो सकेगा, और निष्पादन के लिए तय न्यूनतम संस्करण से नीचे का रनर नए जॉब लेना बंद कर देगा। एक नई REST API समर्थन समाप्त होने की तारीखें बताती है। GitHub Enterprise Server इससे प्रभावित नहीं है। 🔗 स्रोत
- NexteraBERT — Rikka Botan ने 212,6 मिलियन पैरामीटर वाला द्विदिशात्मक एनकोडर प्रकाशित किया है, जिसे 130 अरब token पर प्रीट्रेन किया गया है, यानी ModernBERT की तुलना में लगभग 15 गुना कम पर। उसके अपने मापों के अनुसार, इसे GLUE पर ModernBERT-base के 87,97 के मुकाबले 87,90, MTEB v2 पर 53,63 के मुकाबले 54,70 और 65 536 token पर 5,22 गुना अधिक थ्रूपुट मिलता है। कोड MIT लाइसेंस के तहत है। 🔗 स्रोत
- वास्तविक समय में LTX-2.5 — एक सामुदायिक लेख के अनुसार, 22 अरब पैरामीटर वाला यह ऑडियो और वीडियो मॉडल पहले हर क्लिप के लिए 90 सेकंड लेता था, जबकि अब प्लेबैक से भी तेज़ गति से जनरेशन करता है: 96 Go के कार्ड पर 5 सेकंड की क्लिप बनाने में 1,83 सेकंड लगते हैं। यह 8 के बजाय 4 चरणों, NVFP4 गणना और CUDA Graph की मदद से संभव हुआ है। कोड Apache-2.0 के तहत है। 🔗 स्रोत
- SCRIBE — भारतीय अदालतों के लिए वाक् पहचान प्रणाली बनाने वाली Adalat AI ने PyPI पर यह ओपन सोर्स मूल्यांकन टूल प्रकाशित किया है, जिस पर Interspeech 2026 में शोधपत्र भी है। यह शब्दों, संख्याओं, विराम चिह्नों और पेशे से जुड़े शब्दों को अलग-अलग अंक देता है; शब्द त्रुटि दर एक ऐसे मलयालम वाक्य के लिए 100 % बताती है जिसे कोई प्रूफ़रीडर नहीं बदलेगा। 🔗 स्रोत
- 228 JEV परियोजनाएँ — Awesome JEV सूची चलाने वाले Eric Kang ने GitHub पर « jev » खोज से मिले 13 473 रिपॉज़िटरी में से 228 ओपन सोर्स परियोजनाएँ चुनी हैं। इनमें 10 प्रकार की परियोजनाएँ हैं, प्रत्येक के कम से कम 50 स्टार हैं और हर परियोजना को एक निश्चित commit पर तय किया गया है। खोज परिणामों में असंबंधित परियोजनाएँ भी शामिल हैं; यह हाथ से किया गया चयन है, स्वतंत्र गणना नहीं। 🔗 स्रोत
- HeyGen और Jev — HeyGen ने X पर एक गाइड प्रकाशित की है, जिसमें TypeSafe AI के निर्णय मॉडल Jev को अपने MCP सर्वर से पहले रखा गया है। Jev लगभग चालीस संभावित ग्राहकों को छाँटता है—वीडियो उपयुक्त है या नहीं, प्रस्तुति का कोण, भाषा और मेल के आधार पर। Claude स्क्रिप्ट लिखता है, फिर HeyGen MCP पूरा बैच तैयार करता है; केवल इसी चरण में क्रेडिट खर्च होते हैं और स्वीकृति का इंतज़ार करना पड़ता है। 🔗 स्रोत
- Gemini 3.8 Flash से बनी चार रचनाएँ — Google के ब्लॉग में 2 सितंबर को लॉन्च किए गए मॉडल से बनी चार परियोजनाएँ दिखाई गई हैं: Antigravity से बनाया गया उपग्रहों का लाइव ट्रैकर, एनिमेटेड Seigaiha लहरें, टायरैनोसॉरस का 3D कंकाल और 10 कैमरा दृश्यों वाला ऑटोमैटिक गियरबॉक्स। इसमें कोई आँकड़ा या नया उत्पाद फीचर नहीं है। 🔗 स्रोत
- ब्रुकलिन का एक कैटरर और Gemini — Google के ब्लॉग में बताया गया है कि Greenpoint में Edy’s Grocer के मालिक Edy Massih कैसे Gemini से अपनी रेसिपी को 200 मेहमानों के हिसाब से बढ़ाते हैं, खरीदारी की सूचियाँ बनाते हैं और भोजन संबंधी ज़रूरतों के अनुसार मेन्यू ढालते हैं। इसमें कोई नया फ़ीचर नहीं है। 🔗 स्रोत
- Lenfest Institute — OpenAI ने Lenfest Institute के AI फ़ेलो कार्यक्रम के अगले चरण के लिए 5 मिलियन डॉलर देने की प्रतिबद्धता जताई है। इसके अलावा सॉफ़्टवेयर क्रेडिट और इंजीनियरिंग सहायता के रूप में 5 मिलियन डॉलर तक दिए जाएँगे। यह कार्यक्रम 2024 में अमेरिका के 11 न्यूज़रूम में शुरू हुआ था; नई प्रतिबद्धता उसके पिछले समर्थन की दोगुनी है। 🔗 स्रोत
- ChatGPT का स्वास्थ्य टैब — Health टैब में किसी ग्राफ़, मेट्रिक या रिकॉर्ड को चुनने पर अब बिना प्रॉम्प्ट लिखे व्यक्तिगत व्याख्या मिलती है, कभी-कभी इंटरैक्टिव ग्राफ़ के साथ। Health अभी केवल अमेरिका में उपलब्ध है: 18 वर्ष और उससे अधिक उम्र के उपयोगकर्ताओं के लिए, Free, Go, Plus और Pro प्लान पर, वेब और iOS में। 🔗 स्रोत
- WebMCP Challenge के विजेता — OpenAI Developers ने अगस्त के अंत में शुरू हुए हैकाथॉन की दस विजेता परियोजनाएँ पेश की हैं: MASIL, Alza, ArchMorph, Aisle, Roque Nights, Mandate, Observatory, Bouquet Studio, Faraday और JupyterLite WebMCP। परियोजनाओं की रैंकिंग या प्रत्येक को मिली राशि नहीं बताई गई है। 🔗 स्रोत
- macOS के लिए सुरक्षा सुधार — 25 सितंबर को macOS डेस्कटॉप ऐप के संस्करण 26.924.20706 ने Patrick Wardle (Objective-See Foundation) द्वारा रिपोर्ट की गई CVE-2026-100754 कमजोरी ठीक की। इसे ChatGPT और Codex के चेंजलॉग में Codex ऐप वाले खंड में रखा गया है; कमजोरी का विवरण नहीं दिया गया है। 🔗 स्रोत
इसका क्या अर्थ है
प्रति token कीमत अब नहीं बदल रही; इस्तेमाल होने वाले token की संख्या घट रही है। Sonnet 5.5 का शुल्क Sonnet 5 जितना ही है, लेकिन Anthropic के अनुसार कम token इस्तेमाल करने से प्रति कार्य उसकी लागत 30 % तक कम पड़ती है। Devin अपने नवीनतम मॉडल, जिनमें SWE-2 भी है, जोड़कर और टूल कॉल को समूह में करके 30 से 40 % सस्ता हुआ है। Manus ने परीक्षण की गई एक व्यवस्था में अपने नए हार्नेस से निष्पादन लागत 32 % घटने की घोषणा की है। अब असर दिखने वाली दर से अधिक, मॉडल और हार्नेस दोनों में किए जा रहे काम की मात्रा से पड़ता है; मध्यम श्रेणी भी शीर्ष श्रेणी के करीब पहुँच रही है: Terminal-Bench 4.0 पर Sonnet 5.5 ने Xhigh प्रयास स्तर पर मापे गए Opus 5.5 के स्कोर को पार कर लिया है।
एजेंटों को डिफ़ॉल्ट रूप से अधिक स्वायत्तता मिल रही है, और सुरक्षा नियंत्रण उनकी पहुँच से बाहर रखे जा रहे हैं। Claude Code अब सभी प्लान पर ऑटो मोड में शुरू होता है, जबकि NVIDIA निगरानी को ऐसे DPU में स्थापित करता है जहाँ एजेंट पहुँच नहीं सकता और एजेंट द्वारा प्रस्तावित हर पहुँच नियम को डिफ़ॉल्ट रूप से मानव स्वीकृति के लिए भेजता है। टूल भी इसी दिशा में बढ़ रहे हैं: Codex CLI अधिक अनुमतियाँ माँगने वाली कमांड के टर्मिनल इनपुट को स्वीकृति के लिए भेजता है, और Copilot SDK से MCP सर्वर या skill की स्थापना से पहले मानव समीक्षा अनिवार्य की जा सकती है। एजेंट जितना अधिक अपने दम पर काम करता है, नियंत्रण उतना ही अधिक उसके बाहर होना चाहिए।
एजेंट अपनी पहचान के साथ टीम का सदस्य भी बन रहा है। Perplexity के Profiles किसी एजेंट को संस्करण सहित ऐसी कॉन्फ़िगरेशन बनाते हैं जिसे पूरा प्रोजेक्ट दोबारा इस्तेमाल कर सकता है। SpaceXAI के Team Bots की अपनी Slack पहचान होती है और वे हर उपयोगकर्ता के लिए अलग यादें रखते हैं। Cue के एजेंटों को ईमेल पता, फ़ोन नंबर और वॉलेट मिलता है। किसी व्यक्ति की ओर से भुगतान, कॉल या संदेश भेज सकने वाला एजेंट नियंत्रण से जुड़े उन सवालों को बहुत ठोस बना देता है जिन्हें NVIDIA ने उसी दिन उठाया था।
अंत में, दिन के आँकड़ों को ध्यान से पढ़ना ज़रूरी है। Devin ने Sonnet 5.5 को FrontierCode के एक संस्करण पर मापा है, लेकिन उसके ट्वीट और ग्राफ़ में उस संस्करण का नाम अलग-अलग है; उसी दिन प्रकाशित Cognition के दो ग्राफ़ Opus 5.5 के लिए अलग स्कोर देते हैं। Holo4 को H के हार्नेस में OSWorld 2.0 पर केवल एक रन में मापा गया है। SAIL का 73 % स्कोर सिमुलेशन में मिला है, और सिमुलेशन तथा वास्तविक दुनिया के बीच का अंतर ही ProjectSim के पहले प्रयोग का विषय है। मीडिया से जुड़े मॉडलों में Eleven v4 के दावे बाहरी रैंकिंग और ब्लाइंड टेस्ट पर आधारित हैं, जबकि Kling 4.0 बिना बेंचमार्क या कीमत के आया है और उसके कुछ फ़ीचर बाद के लिए रखे गए हैं।
स्रोत
- Claude Sonnet 5.5 का परिचय (Anthropic)
- Claude Sonnet 5.5 पर माइग्रेशन की गाइड
- @ClaudeDevs: Sonnet 5.5 के लिए प्रयास स्तर संबंधी सुझाव
- GitHub Copilot में Claude Sonnet 5.5
- GitHub Copilot के मॉडल और कीमतें
- Devin में Claude Sonnet 5.5
- @cognition: FrontierCode 1.1 Main पर Sonnet 5.5
- @cursor_ai: Cursor में Sonnet 5.5
- @v0: v0 में Sonnet 5.5
- NVIDIA ने Open Agent Safety Platform लॉन्च किया (प्रेस विज्ञप्ति)
- Open Agent Safety Platform की संरचना (NVIDIA)
- NVIDIA OpenShell से AI एजेंटों में रनटाइम नियंत्रण जोड़ें
- @NVIDIAAI: CNBC पर Jensen Huang
- @togethercompute: लॉन्च साझेदार
- @perplexity_ai: NVIDIA के साथ साझेदारी
- Manus 2.0 का परिचय
- @ManusAI: Cue का लॉन्च
- @ManusAI: एजेंटों के फ़ोन नंबर
- Eleven v4 का परिचय (ElevenLabs)
- @ElevenLabs: Eleven v4 की घोषणा का थ्रेड
- Kling 4.0 के रिलीज़ नोट्स
- @Kling_ai: Kling 4.0 की घोषणा
- Claude Code v2.1.284
- Codex CLI 0.158.0
- Copilot CLI v1.0.89
- Copilot SDK v1.0.15
- Devin अब 40% तक अधिक किफ़ायती है
- 25 सितंबर के Devin रिलीज़ नोट्स
- @cognition: Devin Mobile का बीटा
- @zeddotdev: Delta 0.18
- Gemini CLI v0.63.0-nightly.20260928
- Agent API अब दोबारा इस्तेमाल किए जा सकने वाले एजेंटों का समर्थन करता है (Perplexity)
- Perplexity API का चेंजलॉग
- Team Bots (SpaceXAI)
- @bot: Team Bots की घोषणा
- Hugging Face ब्लॉग पर Holo4
- Holo4 (H Company)
- SAIL (Sakana AI)
- SAIL परियोजना का पृष्ठ
- रोबोटिक्स के परीक्षण मानक: आज की स्थिति और आगे क्या होगा (ProjectSim)
- नमस्ते, जर्मनी! (Mistral AI)
- NVIDIA DSX MaxLPS कैसे AI फ़ैक्टरी का थ्रूपुट और दक्षता बढ़ाता है
- DeepSeek Harness 0.2.0-rc.1
- Vercel AI Gateway पर Pixel Canary
- स्वयं होस्ट किए गए रनर के संस्करण लागू करने की तारीख बदली गई (GitHub)
- NexteraBERT की तकनीकी रिपोर्ट
- 22B वीडियो डिफ़्यूज़न मॉडल से वास्तविक समय के बोलते पात्र
- SCRIBE (Adalat AI)
- JEV: चुनी गई 228 परियोजनाएँ (Eric Kang)
- @HeyGen: Jev और HeyGen MCP की गाइड
- देखें, चार निर्माता Gemini 3.8 Flash से क्या बना रहे हैं (Google)
- Gemini से यह किराना व्यापारी 200 मेहमानों के लिए तीन तरीकों से कैसे खाना बनाता है (Google)
- Lenfest AI Collaborative: नया चरण (OpenAI)
- ChatGPT के रिलीज़ नोट्स
- @OpenAIDevs: WebMCP Challenge के विजेता
- ChatGPT और Codex का चेंजलॉग: CVE-2026-100754