ai-powered-markdown-translatorArtigo traduzido do francês para o português com gpt-6.1-sol.
Na quinta-feira, 1 de outubro, Anthropic lança os mods, pequenas funções TypeScript que se ligam aos eventos de Claude Code para reescrever o seu comportamento e a sua interface, incluídas na versão 2.1.287. GitHub disponibiliza no mesmo dia, em pré-visualização pública, duas capacidades de agente no Copilot CLI e na aplicação GitHub Copilot: o controlo de aplicações de desktop e os workflows dinâmicos, orquestrações escritas em código. Black Forest Labs lança FLUX 3 Image, que compõe através de caixas delimitadoras e gera até 4K; Google disponibiliza Guided Vision no Gemini Live, Barclays alarga Claude a todo o banco e GitHub torna mais rigoroso o processo de comunicação de vulnerabilidades perante os relatórios gerados por IA.
Claude Code abre-se aos mods, funções TypeScript que reescrevem o seu comportamento e a sua interface
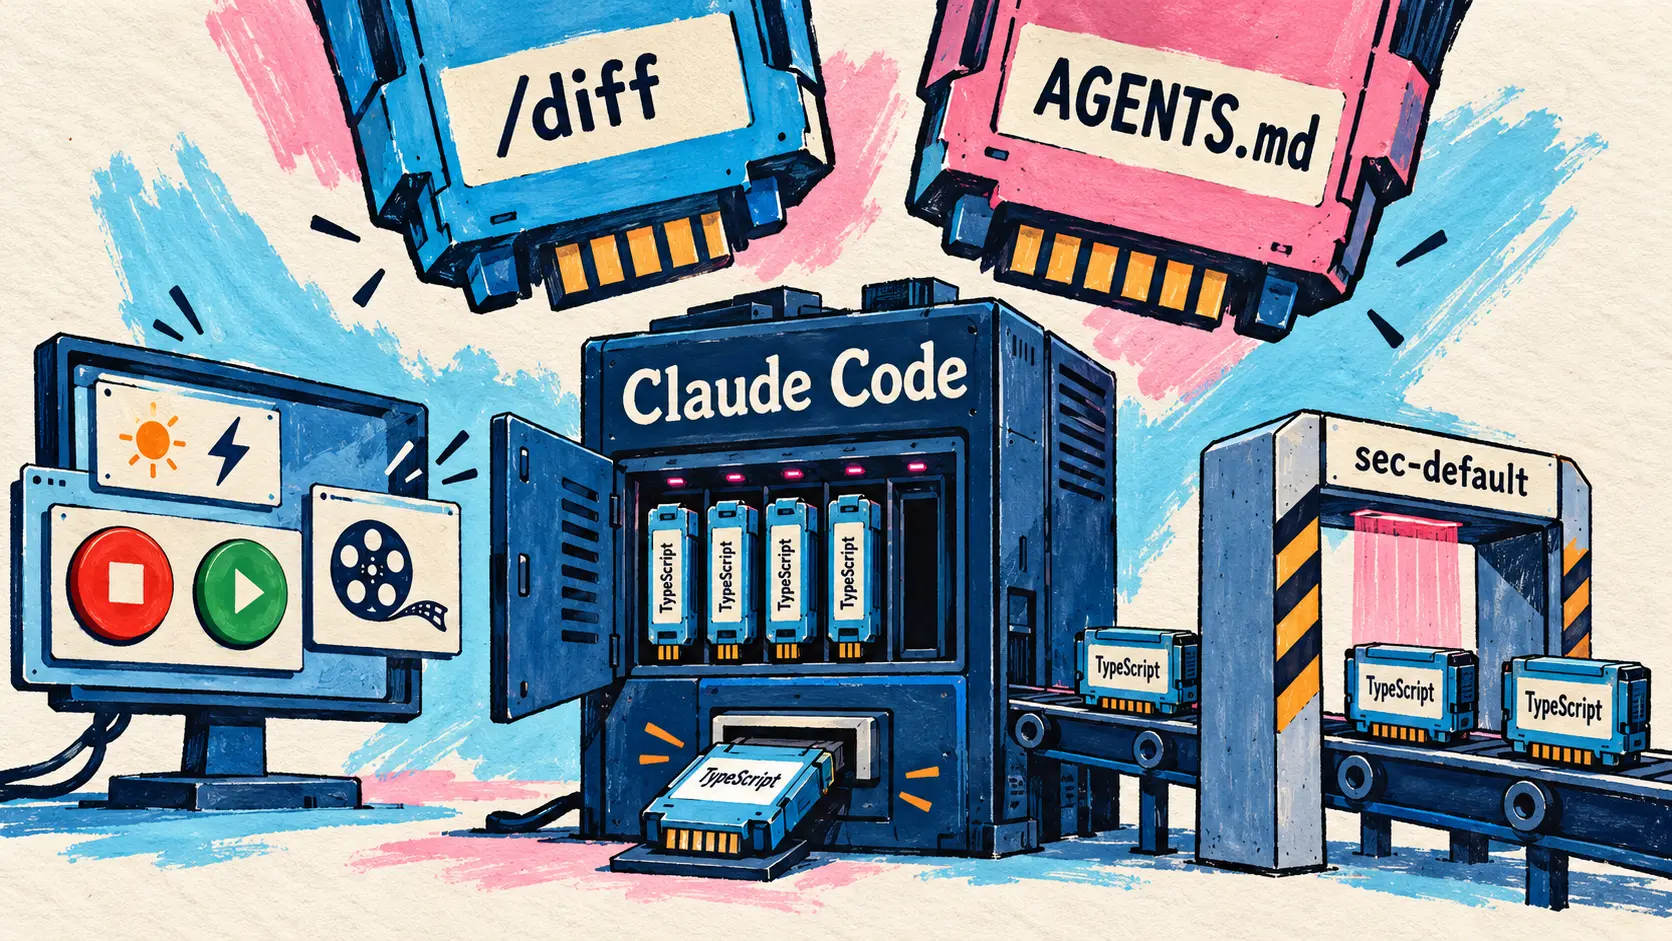
1 de outubro — Anthropic lança os mods, pequenas funções TypeScript que alteram o funcionamento de Claude Code. Cada ação da ferramenta emite um evento (chamada de ferramenta, pedido de autorização, prompt submetido, início e fim de turno, desenho de uma parte do ecrã), e um mod liga-se a esse evento antes, depois, em sua substituição ou envolvendo-o. Pode reescrever um prompt antes de este chegar ao modelo, bloquear, reescrever ou repetir uma chamada de ferramenta, aprovar ou recusar uma autorização, ocultar segredos na saída de uma ferramenta antes de Claude a ler, ou acrescentar os seus próprios painéis, botões e campos de introdução de texto. Os mods são distribuídos em plugins, instalam-se com /plugin e partilham-se da mesma forma; chegam com Claude Code 2.1.287 e estão ativados por predefinição. Não é necessário conhecer a API para começar: pode pedir-se a Claude Code que escreva o mod, e ele produz o TypeScript, instala-o e recarrega-o a quente na sessão.
A diferença em relação aos hooks existentes é clara. Um hook de definições (settings hook) executa um comando shell a cada evento; um mod é carregado uma vez e permanece na sessão, pelo que mantém um estado, redesenha a interface à medida que os eventos ocorrem e pode registar comandos slash ou ferramentas que o modelo chama. Anthropic já os utiliza para as suas próprias funções: o painel /diff e o suporte de AGENTS.md passaram a ser mods integrados, que podem ser desativados ou substituídos, e a empresa prevê converter outros ao longo do tempo para que seja possível reduzir Claude Code a um pequeno núcleo. Entre os seis mods integrados apresentados na documentação encontra-se You should know, desativado por predefinição, no qual um agente secundário assinala o que pode escapar ao utilizador ou a Claude.
| Aspeto dos mods | Detalhe oficial |
|---|---|
| Versão mínima | Claude Code 2.1.287, mods ativados por predefinição |
| Interfaces com visualização | CLI no terminal, separador Code de Claude Desktop (exceto sessões WSL) |
| Interfaces sem visualização | Extensão VS Code, claude -p, Agent SDK e sessões cloud, onde os hooks são executados |
| Mods integrados | 6, incluindo /diff, AGENTS.md, sec-default e You should know |
| Tempo próprio de um hook | 10 segundos por acionamento |
| Desativação | /plugin para um mod, --safe-mode para uma sessão, disableAllHooks para todos |
O guia de introdução de Addy Osmani em claude.dev constrói Token Weather, um mod de cerca de 80 linhas que apresenta acima do prompt a «meteorologia» do contexto, com um minigráfico dos últimos 12 turnos. Apresenta também Blast Radius, que suspende um rm -rf, um git reset --hard ou um push forçado enquanto mostra o que seria afetado, e Replay Theater, que reproduz as alterações de ficheiros de um turno.
A confiança continua a ser o ponto delicado. A publicação avisa que os mods não estão isolados: têm o mesmo acesso à máquina que Claude Code, e a documentação esclarece que um mod pode ler as variáveis de ambiente e os ficheiros de definições, ver cada prompt, aprovar uma chamada de ferramenta ou consumir a quota do plano, mas não modificar o pedido de autorização. O guia de claude.dev descreve, contudo, um módulo que é executado na sua própria sandbox, sem DOM nem Node, em que toda a ação externa passa pela API $: é isso que permite a claude plugin validate listar, antes da instalação, os eventos que um mod interceta e as chamadas que faz. Em Team e Enterprise, e em qualquer máquina com definições geridas, o mod integrado sec-default é carregado primeiro e impede os mods instalados pelo utilizador de contornar as regras de recusa; os administradores podem colocar os seus próprios mods antes dele.
Mods are absolutely insane. You can now customize Claude to work and look the way you want by just prompting it. Each person works differently, so there’s no reason why everyone should have an identical Claude experience. Make Claude your own, and share mods as plugins so others can try your mods too.
🇵🇹 Os mods são uma verdadeira loucura. Agora pode personalizar Claude para que trabalhe e se apresente como quiser, simplesmente pedindo-lhe isso. Cada pessoa trabalha de forma diferente, pelo que não há razão para todos terem uma experiência Claude idêntica. Faça de Claude o seu e partilhe os seus mods sob a forma de plugins para que outras pessoas os possam experimentar. — @bcherny no X
O lançamento era esperado: Boris Cherny tinha-o anunciado a 14 de setembro, e Anthropic tinha partilhado a conceção no GitHub (issue #91870). A publicação e o guia de claude.dev convidam a submeter os mods ao diretório Claude.
🔗 Personalize Claude Code com mods em TypeScript · Guia de introdução em claude.dev · Documentação dos mods
Claude Code 2.1.287: contexto de 1M por predefinição nos fornecedores cloud e 67 correções
1 de outubro — Claude Code 2.1.287 é a versão que inclui os mods, mas conta com 106 entradas, das quais 67 são correções. Para as empresas, em Bedrock, Vertex, Foundry e no gateway Claude apps, Opus 4.7 e as versões seguintes, bem como Fable, passam a utilizar por predefinição uma janela de contexto de 1M, sem o sufixo [1m]; CLAUDE_CODE_DISABLE_1M_CONTEXT=1 permite manter os 200K. /advisor aceita Sonnet 5.5 como conselheiro de Opus 4.7 e 4.8, uma mudança automática de modelo mantém o nível de esforço atual, e os servidores MCP com o protocolo 2025-11-25 podem abrir pedidos de URL. Um rm perigoso mantém a sua confirmação mesmo quando o comando redireciona a saída para ~ ou um wildcard, os pedidos de autorização pendentes são apresentados do mais antigo ao mais recente, e nove entradas melhoram o modo de leitor de ecrã. No VS Code, um comando ou subagente em execução pode passar para segundo plano (Executar em segundo plano).
🔗 Notas de versão de Claude Code 2.1.287
GitHub Copilot: controlo de aplicações de desktop e workflows dinâmicos em pré-visualização pública
1 de outubro — GitHub disponibiliza no mesmo dia duas capacidades de agente em pré-visualização pública no Copilot CLI e na aplicação GitHub Copilot: o controlo de aplicações de desktop e os workflows dinâmicos, também disponíveis no GitHub Copilot SDK.
Copilot controla aplicações de desktop. O controlo do computador (computer use) chega ao macOS e ao Windows. Copilot lê o conteúdo acessível de uma janela e o seu contexto visual, através da árvore de acessibilidade do sistema ou de capturas de ecrã quando necessário, clica em controlos, introduz texto, prime teclas, desloca o conteúdo, arrasta e larga e encadeia etapas de uma aplicação para outra; a demonstração mostra-o a preencher uma declaração de despesas no Safari. GitHub visa software antigo ou puramente gráfico, sem API, sem interface de linha de comandos nem integração MCP, e a documentação recomenda estas vias quando existem, pois proporcionam resultados mais previsíveis. A função está desativada por predefinição: /computer on ativa-a na CLI, /computer show apresenta o seu estado e /computer off desativa-a, enquanto a aplicação a disponibiliza nas suas definições. Copilot pede autorização antes de controlar cada aplicação: pode concedê-la para a sessão, guardá-la para as seguintes ou recusá-la. Uma aprovação permanente (Permitir sempre) aplica-se à CLI e à aplicação na mesma máquina, mas uma regra de recusa prevalece sempre, e premir Esc duas vezes na CLI, ou o botão Parar na aplicação, interrompe uma ação que esteja a sair do controlo. As definições geridas de uma organização podem desativar a função, sem que uma ativação local se sobreponha. GitHub avisa que uma instrução ambígua ou conteúdo inesperado no ecrã pode provocar ações indesejadas em contas com sessão iniciada, incluindo contas financeiras, e desaconselha a aprovação permanente para aplicações sensíveis. Não são especificados os planos abrangidos nem quaisquer números; o comando /computer já constava das notas de Copilot CLI 1.0.85, a 16 de setembro.
🔗 GitHub Copilot já pode interagir com aplicações de desktop através do controlo do computador
Orquestrações escritas em código. Os workflows dinâmicos (dynamic workflows), disponíveis em todos os planos Copilot, descrevem num programa a forma de realizar uma tarefa: o código define as etapas, o momento em que um agente intervém e a utilização dos seus resultados, em sequência, em paralelo ou de ambas as formas, e os agentes tratam do que exige análise ou discernimento. Um workflow pode executar comandos, dividir um objetivo em tarefas paralelas, transmitir resultados estruturados de uma etapa para outra, fazer com que um subagente verifique as conclusões de outro e parar num ponto de controlo (checkpoint) para uma revisão antes de retomar. GitHub cita a investigação de um incidente, a revisão em paralelo dos ficheiros de uma pull request, ou comentários de revisão submetidos a dois modelos e assinalados apenas se ambos concordarem.
| Modo de Copilot | Quem organiza o trabalho, segundo a documentação |
|---|---|
| Autopilot | Copilot, que avança sem pedir validação após cada etapa |
/fleet | Copilot, que divide a tarefa de cada vez entre subagentes em paralelo |
| Workflow dinâmico | O código escrito pelo autor: etapas, condições e passagens de responsabilidade |
O programa reside numa extensão do Copilot CLI e da aplicação. Um workflow escrito por Copilot fica limitado à sessão, mas pode ser reutilizado copiando a extensão para o diretório pessoal, partilhado através do diretório de um repositório ou empacotado num plugin. Os subagentes herdam as autorizações da sessão, enquanto o comando copilot workflow run não apresenta qualquer pedido: é necessário conceder as autorizações antes da execução. Disponíveis sem configuração na aplicação, os workflows exigem a ativação das funções experimentais na CLI (--experimental ou /experimental on). GitHub não publica números nem regras de faturação, e o nome lembra, sem qualquer ligação anunciada, os Dynamic Workflows lançados por Anthropic em Claude Code a 28 de maio.
🔗 Workflows dinâmicos no Copilot CLI e na aplicação Copilot
FLUX 3 Image: Black Forest Labs compõe através de caixas delimitadoras e gera até 4K
1 de outubro — Black Forest Labs (BFL) acrescenta um modelo de imagem à sua família FLUX 3, com um lema: controlar cada pixel. FLUX 3 Image retoca uma zona em várias passagens sucessivas sem modificar o resto da imagem e aceita várias alterações num único pedido.
A novidade mais visível é a composição através de caixas delimitadoras (bounding boxes). Independentemente do formato, a imagem torna-se um sistema de coordenadas de 0 a 1000 em cada eixo: desenha-se uma caixa por elemento, descreve-se o seu conteúdo e depois resume-se a cena numa linha, e o modelo coloca cada elemento na sua caixa; continua a ser possível utilizar apenas um prompt de texto. FLUX 3 Image também combina até 10 imagens de referência, citadas por tokens no prompt, decidindo por si próprio a sua posição e o seu tamanho. BFL apresenta-o como «concebido para agentes»: um LLM pode escrever a tabela dos elementos e das respetivas caixas a partir de um simples pedido, que o utilizador ajusta antes de iniciar a geração.
| Característica anunciada | Detalhe comunicado pela BFL |
|---|---|
| Resolução nativa | 2K e 4K (exemplo da página do modelo: 5456 × 3072 pixels, 16,8 MP) |
| Imagens de referência | Até 10 |
| Composição | Caixas delimitadoras numa grelha de 0 a 1000 por eixo |
| Edição | Vários turnos, sem modificar os outros pixels |
| Oferta API | 50 % de desconto até 8 de outubro |
| Pesos do modelo | Comerciais sob licença; pesos abertos «nas próximas semanas» |
Quanto ao acesso, FLUX 3 Image está disponível através da API com 50 % de desconto até 8 de outubro, e BFL disponibiliza pesos comerciais sob licença às empresas que pretendem afiná-lo e implementá-lo na sua própria infraestrutura. A versão com pesos abertos é anunciada sem data. Não havia qualquer preço base nem benchmark quantificado publicado no momento do anúncio. O modelo completa uma série lançada este verão: FLUX 3, modelo multimodal unificado (23 de julho), FLUX 3 Video (4 de agosto), o seu modo de edição (10 de setembro) e FLUX 3 Action para a robótica (23 de setembro).
🔗 Anúncio de FLUX 3 Image por @bfl_ai · Página do modelo FLUX 3 Image
Assistentes para o público em geral: Guided Vision no Gemini Live, prova virtual no ChatGPT, gráficos no Perplexity Computer, limites flexibilizados para os artefactos de Claude
Guided Vision: Gemini Live orienta pessoas cegas e com baixa visão
1 de outubro — A Google disponibiliza o Guided Vision no Gemini Live em Android 9 e versões posteriores, nas regiões e línguas onde o Gemini Live está disponível. Concebida com pessoas cegas e com baixa visão, a função descreve em tempo real o que a câmara partilhada está a filmar, responde a perguntas de seguimento e dá instruções verbais para ajustar o enquadramento: virar lentamente para a direita, inclinar para baixo, recuar. A Google dá como exemplos a leitura de um rótulo nutricional ou de uma ementa num restaurante escuro, a procura de um auricular que caiu ou a descrição das cores de uma peça de roupa. Para a treinar, a Google associou-se à Aira, um serviço de interpretação visual: dezenas de milhares de horas de dados, mais de 1 000 participantes em testes da sua rede e especialistas envolvidos nas salvaguardas. O Guided Vision ativa-se no perfil da aplicação Gemini, através de um atalho de acessibilidade do Android ou a partir do TalkBack. A Google esclarece que não é um dispositivo médico nem um auxiliar de mobilidade: a função não substitui a bengala branca.
🔗 Guided Vision no Gemini Live (blog da Google)
ChatGPT: prova virtual e favoritos para compras
1 de outubro — Segundo as notas de versão do ChatGPT, surge um botão de prova (Try on) nas fichas de roupa e acessórios: tira-se ou carrega-se uma selfie, e o ChatGPT Images gera uma prova virtual do artigo. A fotografia de referência é guardada para as provas seguintes; pode ser substituída ou eliminada nas definições, na secção de fotografias de referência (Settings → Personalization → Reference photos). Qualquer produto também pode ser guardado nos favoritos ou organizado numa pasta da biblioteca do ChatGPT. As duas funções estão disponíveis em dispositivos móveis e na web, mas a nota não especifica os planos nem os países abrangidos. O ChatGPT já disponibilizava compras visuais desde 24 de março.
Perplexity Computer cria gráficos interativos
1 de outubro — O Perplexity Computer passa a criar gráficos e visualizações interativos diretamente no fio da conversa. Para os dados financeiros, o agente recorre ao Lightweight Charts da TradingView para apresentar gráficos de velas, volume e médias móveis. O anúncio resume-se a um tweet acompanhado de um vídeo: não indica quais os planos abrangidos nem em que plataformas, e ainda não há nenhuma entrada no changelog que o detalhe. O ChatGPT e o Claude tinham feito esta mudança a 10 e 12 de março, e o Replit Agent a 25 de setembro.
🔗 Anúncio de @perplexity_ai no X
Claude reduz para metade o consumo dos limites após um artefacto, até 15 de outubro
1 de outubro — De 1 de outubro às 11 h PT a 15 de outubro às 23 h 59 PT, criar ou modificar um artefacto (documento, apresentação ou design) no Claude ou no Claude Cowork faz com que o trabalho seguinte consuma menos 50 % do limite de sessão de cinco horas. A oferta aplica-se automaticamente aos planos Pro, Max e Team; o Free e os planos Enterprise estão excluídos, e o limite semanal não muda.
| Área abrangida | Âmbito da redução de 50 % |
|---|---|
| Conversa iniciada a partir do menu Output | Desde a primeira mensagem: 10 mensagens, 15 etapas por resposta |
| Conversa normal | As 10 mensagens após a criação do artefacto, 15 etapas por resposta |
| Tarefa Cowork na cloud iniciada a partir de Output | Aproximadamente os primeiros 45 minutos |
| Outra tarefa Cowork na cloud | Até 80 etapas após a criação ou modificação de um artefacto |
Estão excluídos o Claude Code, a API, o Claude no Slack, as tarefas Cowork locais ou agendadas, os créditos de utilização e a aplicação autónoma Claude Design. A Anthropic sugere experimentar com o Sonnet 5.5 e reserva-se o direito de modificar ou terminar a oferta antecipadamente.
🔗 Anúncio de @claudeai no X · Condições da oferta (centro de ajuda do Claude)
Finanças: Barclays alarga Claude a todo o banco, American Express disponibiliza Perplexity Computer aos seus clientes Business
Barclays pretende ter metade dos seus programadores a usar Claude Code até ao final de 2026
1 de outubro — O Barclays, o banco universal britânico, alarga a sua colaboração com a Anthropic e implementa o Claude em toda a organização, para acelerar o desenvolvimento de software, modernizar os sistemas antigos e aumentar a eficiência operacional. O banco prevê que o Claude Code seja adotado por 50 % dos seus programadores até ao final de 2026, e depois pela maioria dos seus engenheiros de software em 2027. Dois casos de utilização já têm resultados quantificados. O Colleague Knowledge Assistant, em funcionamento desde 2025 e construído sobre o Claude com uma arquitetura de geração aumentada por recuperação (RAG), foi adotado por mais de 16 000 colaboradores e processou mais de um milhão de pesquisas; ajuda as equipas que servem mais de 20 milhões de clientes particulares no Reino Unido. Na atividade Global Markets, os modelos Claude classificam, enriquecem e encaminham cerca de 120 000 e-mails por dia. Paul Smith, diretor comercial da Anthropic, considera esta uma etapa importante para a empresa no Reino Unido; não foi divulgado qualquer valor nem a duração do contrato.
Perplexity e American Express: dez Skills empresariais no Computer para os cartões Business
1 de outubro — A Perplexity lança uma coleção de Skills prontas a usar para o Perplexity Computer, reservada aos titulares norte-americanos de um cartão American Express Business com uma subscrição do Perplexity Enterprise. O responsável pela empresa escolhe uma tarefa e especifica-a num formulário em vez de escrever um pedido. As dez Skills abrangem a previsão de tesouraria, a preparação fiscal, a comparação de fornecedores, os cenários orçamentais, a reconciliação, as campanhas de marketing, a previsão da procura, o retorno sobre os gastos em publicidade por canal (ROAS), o acompanhamento das operações e o recrutamento. O cartão é associado através do Plaid a partir do Personal CFO, e cada execução consome créditos Computer conforme a complexidade da tarefa. A página do parceiro acrescenta, até 29 de março de 2027, um crédito único de 125 dólares por uma compra de pelo menos 325 dólares de um plano Enterprise Pro ou Enterprise Max, e 1 000 créditos Computer oferecidos uma única vez por conta. Os cartões Corporate estão excluídos, e os resultados não constituem aconselhamento financeiro, fiscal, jurídico ou contabilístico.
🔗 Publicação da Perplexity · Página do parceiro American Express
Vídeo generativo e avatares: Wan 3.0 lidera a classificação da Artificial Analysis, Project Continuum da Runway, Sessions da Synthesia
Wan 3.0 assume a liderança da nova classificação de vídeo da Artificial Analysis
1 de outubro — A Alibaba reivindica o primeiro lugar do Wan 3.0 na nova classificação de texto para vídeo da Artificial Analysis, AA-Video-T2V v2.0, lançada a 30 de setembro com uma nova metodologia: cada modelo é avaliado em 1080p com um conjunto de prompts atualizado regularmente, e a sincronização do som conta para a pontuação. Os resultados do pódio são próximos, com intervalos de confiança que se sobrepõem.
| Modelo classificado | Pontuação Elo | Intervalo de posições | Preço via API |
|---|---|---|---|
| Wan 3.0 | 1157 (±9) | 1 a 2 | 12,00 dólares por minuto |
| Utopai X (baseado no MiniMax H3) | 1150 (±10) | 1 a 3 | Sem API pública |
| Dreamina Seedance 2.5 | 1144 (±9) | 2 a 4 | 34,12 dólares por minuto |
| MiniMax H3 (768p) | 1139 (±9) | 3 a 5 | 4,80 dólares por minuto |
A surpresa da classificação é o Utopai X, lançado a 30 de setembro pela Utopai Studios, um estúdio de cinema e televisão nativo de IA. Submetido a pós-treino com base no MiniMax H3, só está acessível na plataforma PAI do estúdio (93 créditos por segundo de vídeo, subscrições a partir de 15 dólares por mês), e fica à frente do próprio MiniMax H3.
🔗 Anúncio de @Alibaba_Wan no X · Classificação AA-Video-T2V v2.0 · Utopai X segundo @ArtificialAnlys
Runway Labs apresenta Project Continuum, interfaces geradas em vídeo em tempo real
1 de outubro — A Runway Labs, a unidade exploratória da Runway, mostra o Project Continuum, uma aplicação de investigação que imagina um sistema operativo cuja interface seria gerada em vídeo, em tempo real, na linha do Solaris, o modelo de mundo de interface apresentado a 31 de agosto. Esta primeira apresentação descreve quatro formas de interagir com o computador. Com o Portals, um modelo de vídeo gera sobreposições animadas e interativas durante a navegação, com margens desfocadas para assinalar o conteúdo gerado. As interfaces de vídeo responsivas (Responsive Video Interfaces) reorganizam-se quando são redimensionadas e respondem aos cliques. O Interactive Worlds transforma um conteúdo multimédia numa simulação interativa, tanto para pessoas como para agentes. Por fim, o Visual Thinking é um harness para agentes de código: um modelo de vídeo em tempo real transforma em imagens cada etapa e cada chamada de ferramenta, para manter o utilizador a acompanhar o processo. A Runway não disponibiliza acesso nem indica uma data, um preço ou o modelo subjacente.
Synthesia lança Sessions, avatares que treinam e entrevistam
1 de outubro — A Synthesia lança o Sessions, uma família de produtos construída sobre os seus avatares interativos: uma videochamada em que o interlocutor é um avatar que faz perguntas, ouve, contradiz e sintetiza. O Roleplay Sessions serve para treino: o avatar representa um cliente, um potencial cliente ou um colaborador, um coach de IA comenta cada tentativa e os gestores acompanham as pontuações e a evolução num painel. O Survey Sessions transforma o questionário numa entrevista: o avatar entrevista centenas de pessoas em paralelo, faz perguntas de seguimento conforme as respostas e depois entrega um relatório de temas e sentimentos, mantendo cada resposta disponível em transcrição, áudio ou CSV. É oferecido um teste gratuito, sem preços detalhados. O Sessions assenta na Interactive Avatar API, disponibilizada de forma geral a 16 de setembro, e a Synthesia promete outras variantes.
🔗 Anúncio de @synthesiaIO no X · Página do Synthesia Sessions
IA e ciência: SynthID Bio aplica marcas de água às proteínas, Matthew Schwartz descreve uma ciência «em forma de Claude»
SynthID Bio: Google DeepMind aplica marcas de água às proteínas concebidas por IA
30 de setembro — A Google DeepMind apresenta o SynthID Bio, uma família de métodos de marca de água digital (watermarking) para criações biológicas geradas por IA, divulgada no X a 1 de outubro. A publicação apresenta-a como uma prova de conceito: uma assinatura impercetível é inscrita no código biológico, verificável tanto no modelo digital como na proteína sintetizada. Para as sequências, o método orienta discretamente a escolha dos aminoácidos; para as estruturas 3D, uma pequena parte da rede de difusão do AlphaFold 3 é afinada. Em laboratório, em três alvos (VEGF-A, o domínio RBD da proteína spike do SARS-CoV-2 e PD-L1), os ligantes com marca de água igualaram as versões convencionais na taxa de sucesso, na afinidade e na diversidade de sequência. O objetivo é a biossegurança: um sinal automático ajudaria os fornecedores de síntese de ADN a verificar a origem de uma sequência desconhecida. A Google DeepMind publica o seu artigo de métodos, o código, os dados in vitro e os pesos para investigação; com o Hie lab de Stanford e o Arc Institute, a abordagem já se estende ao genoma de um bacteriófago concebido pelo Evo 2. A robustez perante uma alteração deliberada continua a ser o principal desafio.
🔗 Publicação da Google DeepMind sobre o SynthID Bio
A ciência «em forma de Claude»: a publicação de Matthew Schwartz como convidado
1 de outubro — O blog Anthropic Science publica um texto de Matthew Schwartz como convidado, um físico de Harvard que esclarece trabalhar como investigador convidado na Anthropic. Descreve um «desajuste de impedância» entre cientistas e IA: trabalhar com um modelo como se fosse um colaborador humano não permite tirar o melhor partido dele, e é preferível procurar problemas «em forma de Claude», nos quais uma técnica conhecida de matemática, física ou informática resolve de uma só vez uma questão de outro domínio. Daí surgiu o BootLoops, um harness open source de cálculo exato utilizável com qualquer modelo; o BootLoops não é um projeto da Anthropic, é mantido por Schwartz. Em física, foram tratadas 30 integrais do início ao fim, incluindo 15 nunca antes calculadas; em ecologia, as árvores de Barro Colorado Island mudam 4,5 vezes mais depressa do que permite a teoria neutra; em linguística, a base AccStack abrange a acentuação lexical de 6 072 línguas. Balanço: 36 manuscritos em 18 domínios com 19 coautores em três meses. Schwartz assinala também as limitações: o Claude não tem noção do tempo, gosta de «declarar vitória», e os seus resultados fora da física continuavam a ser pouco interessantes até um especialista os reorientar.
🔗 Ciência em forma de Claude (blog Anthropic Science)
Modelos abertos e treino: Olmo-core 3 da Ai2, Clef e Clef-flash da Cloudflare, o RL com vários harnesses da FineEnvs
Olmo-core 3: Ai2 disponibiliza uma stack de treino MoE que visa mais de um bilião de parâmetros
1 de outubro — A Ai2 publica o Olmo-core 3, uma nova versão do framework que treina os seus modelos Olmo, reconstruída em torno de um sistema de treino de mistura de especialistas (mixture-of-experts, MoE) inteiramente aberto. É um dos sistemas da próxima geração do Olmo, que passará a MoE e deverá tornar-se, segundo a Ai2, o mais capaz dos modelos Olmo. A implementação anterior, baseada em FSDP, reunia e voltava a repartir os pesos a cada lote; o Olmo-core 3 passa a DDP, mantém os especialistas nos seus GPU e envia-lhes os dados.
| Medição publicada pela Ai2 | Valor medido |
|---|---|
| MoE de 47 mil milhões de parâmetros em oito B300, teste preliminar | 52 000 contra 19 400 tokens/s por GPU, cerca de 2,7 vezes |
| MXFP8 contra BF16, em quatro B300 | Cerca de 21 % mais débito |
| Modelo de 1 200 mil milhões de parâmetros em 512 GPU | 858 TFLOP/s por GPU no máximo, encaminhamento aleatório |
A Ai2 esclarece que a medição com 1 200 mil milhões de parâmetros avalia o sistema, não a qualidade de um modelo treinado. São publicados o código (versão 3.0.0), o relatório técnico e uma demonstração interativa.
🔗 Publicação da Ai2 sobre o Olmo-core 3 · Release Olmo-core v3.0.0
Clef e Clef-flash: a Cloudflare disponibiliza dois modelos de decisão compatíveis com Jev
1 de outubro — A equipa Workers AI da Cloudflare publica Clef e Clef-flash, os seus primeiros modelos treinados internamente, no terreno aberto por Jev, o modelo System One da Typesafe AI: recebem um estado (texto, JSON, imagem ou vídeo) e um esquema de perguntas tipadas, e devolvem numa única passagem uma probabilidade para cada opção permitida. Clef é pós-treinado a partir de Qwen3.8-27B, enquanto Clef-flash se baseia em Qwen3.5-9B. Alojados no Workers AI com uma API compatível com a de Jev, são publicados no Hugging Face sob a licença Apache 2.0, segundo o artigo, com uma janela de 64k tokens contra 32k para Jev. Os números, escolhidos pela Cloudflare, são contrastantes:
| Benchmark e métrica | Pontuação de Clef | Pontuação de Clef-flash | Pontuação de Jev |
|---|---|---|---|
| BFCL, casos exatos | 98,47 | 98,76 | 95,75 |
| BANKING77, macro-F1 | 94,20 | 90,93 | 79,74 |
| When2Call, exatidão | 72,37 | 65,58 | 80,97 |
| BRIGHT, nDCG@10 | 45,91 | 39,26 | 47,52 |
| Latência mediana | 209,3 ms | 38,8 ms | 524,1 ms |
A Cloudflare afirma que Clef lidera o Jev Decision Index, uma posição que a Liquid AI reivindicava para d1 dois dias antes, e lança um serviço de ajuste fino de Clef por reforço com os dados do cliente.
🔗 Artigo da Cloudflare sobre Clef · Clef no Hugging Face
FineEnvs treina um modelo por reforço em quatro harnesses de agentes ao mesmo tempo
1 de outubro — O mesmo modelo não se comporta da mesma forma consoante o harness que o controla: os pesos de LFM2.5-2.6B, da Liquid AI, resolvem 62 % das tarefas com Mini-SWE-Agent, mas 33 % com Claude Code. A organização FineEnvs publica no Hugging Face um guia para treinar um modelo por aprendizagem por reforço diretamente nos harnesses dos programadores, sem modificar o respetivo código. Um proxy de captura adicionado ao OpenEnv apresenta-se ao harness como um fornecedor de modelos (formatos OpenAI, Anthropic ou Gemini) e regista os tokens e as probabilidades exatos produzidos pelo vLLM; Harbor fornece tarefas e sandboxes, e TRL treina com GRPO assíncrono. Treinado em quatro harnesses ao mesmo tempo, LFM2.5-2.6B passa de 42 % para 54 % em média, e um pequeno bónus por soluções económicas reduz em 31 % as suas chamadas de ferramentas nas tarefas já resolvidas. Imitar um modelo maior não basta: um ajuste fino supervisionado com 3 189 rollouts de Qwen3.8-27B fica limitado a 47,5 %. São publicados o proxy, o treinador, as tarefas, os dados e os modelos treinados.
🔗 O guia definitivo de RL com múltiplos harnesses
Grok 4.7 em pré-visualização na plataforma de agentes do Google Cloud
1 de outubro — A SpaceXAI anuncia que Grok 4.7 está disponível no Gemini Enterprise Agent Platform, a plataforma de agentes do Google Cloud. A ficha do modelo, datada de 30 de setembro, coloca-o em pré-visualização sob o identificador grok-4.7 e descreve-o como um modelo da xAI concebido para código e trabalho de conhecimento, que dedica mais tempo às tarefas difíceis e verifica o seu próprio trabalho. Aceita texto e imagens como entrada e devolve apenas texto; suporta chamadas de funções, saída estruturada e raciocínio, mas não previsões em lote.
| Dado publicado pelo Google Cloud | Valor para Grok 4.7 |
|---|---|
| Comprimento do contexto | 524 288 tokens |
| Quotas por minuto | 13 pedidos, 188 000 tokens de entrada e 16 000 tokens de saída |
| Tipos de utilização | Apenas quota fixa, sem pagamento por utilização nem débito provisionado |
| Regiões de serviço | Multirregião Estados Unidos e endpoint global |
| Preço por milhão de tokens | 2 dólares de entrada, 6 de saída, 0,50 em cache abaixo de 200 000 tokens de entrada, o dobro acima |
A tabela de preços é a mesma da API xAI. Lançado a 21 de setembro, Grok 4.7 tinha chegado ao Amazon Bedrock a 28 de setembro, e Grok 4.6 tinha sido disponibilizado na mesma plataforma da Google a 21 de agosto.
🔗 Ficha de Grok 4.7 no Google Cloud · Anúncio de @SpaceXAI no X
GitHub reforça as regras de comunicação privada de vulnerabilidades face aos relatórios gerados por IA
1 de outubro — O GitHub publica no mesmo minuto duas medidas para a comunicação privada de vulnerabilidades (comunicação privada de vulnerabilidades), com uma constatação comum: os responsáveis pela manutenção de projetos open source recebem cada vez mais relatórios de baixa qualidade, automatizados ou gerados por IA, que abafam os que realmente contam.
A single free-text box made it easy to submit low-quality or AI-generated reports and hard for you to find the signal in them.
🇵🇹 Uma simples caixa de texto livre facilitava o envio de relatórios de baixa qualidade ou gerados por IA e dificultava a identificação do essencial. — GitHub Changelog, Formulários estruturados para relatórios privados de vulnerabilidades
Um formulário estruturado. Por predefinição, quem comunica a vulnerabilidade tem de preencher quatro campos obrigatórios: um resumo, detalhes, uma prova de conceito com pelo menos 150 caracteres e o impacto, que são reunidos na descrição do aviso de segurança que o responsável pela manutenção revê como antes. Cada repositório pode adaptar o formulário com um ficheiro .github/VULNERABILITY_REPORT.yml, ou aplicá-lo a todos os seus repositórios a partir do repositório .github da organização; os responsáveis pela manutenção podem exigir uma categoria CWE, algo que uma organização ou empresa pode impor através de uma política. Uma caixa de seleção permite a quem comunica a vulnerabilidade declarar que recebeu ajuda de IA para a encontrar ou redigir o relatório. Na API REST, um formulário personalizado também se aplica, mas o formulário predefinido não, para evitar quebrar as integrações existentes.
Um limite diário. O número de novos relatórios que a mesma conta pode enviar por dia passa a ser limitado, tanto para um repositório como para o conjunto do GitHub; os comentários em avisos existentes não são afetados. Os administradores podem definir o seu próprio limite e isentar autores de relatórios de confiança, e o GitHub não divulga o valor do limite predefinido. As duas medidas abrangem os repositórios públicos que tenham ativado a comunicação privada, no GitHub Free, Pro, Team e Enterprise Cloud.
🔗 Limites de frequência para relatórios privados de vulnerabilidades
Agentes de código: Codex CLI 0.160.0, Delta 0.18 e Antigravity 2.19.1
Codex CLI 0.160.0: o histórico do centro de comando e as sessões fora de projetos
1 de outubro — A OpenAI publica Codex CLI 0.160.0, a primeira versão estável desde a 0.159.3 do dia anterior, com 55 PR listadas desde a 0.159.0. O centro de comando dos agentes (centro de comando de agentes) ganha uma ação para mostrar tarefas mais antigas (Mostrar mais), utilizável com o teclado. As sessões podem começar fora de um projeto, com as definições predefinidas do espaço de trabalho quando a política da organização o permite, e as permissões guardadas são restauradas ao retomar a sessão. A revisão de aprovação Guardian recebe duas capacidades opcionais: recuperar instruções dadas anteriormente pelo utilizador e integrar o contexto das transferências entre agentes. Em ecrã inteiro, os terminais Linux X11 locais permitem selecionar a transcrição e colar com um clique no botão do meio. Quanto às correções, as mensagens em fila retomam o envio após uma reconexão sem serem enviadas em duplicado, e uma série de correções incide sobre a sandbox do Windows e bloqueios do SQLite na inicialização.
Delta 0.18: as threads são executadas em worktrees Git existentes, e chega uma CLI
30 de setembro — A Zed publica a versão 0.18.0 do Delta, o seu ambiente multijogador para programar com agentes: 23 novidades, 41 melhorias, 51 correções e uma remoção. A principal novidade tinha sido anunciada sem data a 28 de setembro: uma thread pode agora ser executada em qualquer worktree Git existente já associado e transmitir essa cópia de trabalho às novas threads criadas a partir dela. O Delta também pode ser controlado a partir do terminal: uma CLI delta pode ser instalada no macOS, Windows e Linux, e os comandos delta auth gerem a conta com sessão iniciada. Quanto aos modelos, a versão adiciona os modelos Gemini do Google AI Studio, disponibiliza GPT-6 Sol, GPT-6 Luna e Claude Opus 5.5 com uma chave API e aceita, na aplicação de desktop, qualquer fornecedor compatível com OpenAI ou Anthropic. O trabalho em threads ganha uma pesquisa em todas as subthreads e marcadores; por outro lado, as subthreads deixam de publicar as suas mensagens de progresso na thread principal, onde apenas continuam a ser apresentados os resultados de Land Changes.
🔗 Notas da versão 0.18.0 do Delta
Antigravity 2.19.1: escrever diretamente aos subagentes
30 de setembro — Antigravity 2.19.1 permite enviar uma mensagem diretamente a um subagente a partir da área de introdução de texto, sem passar pelo agente principal; a CLI já o permitia com a sua sintaxe @ desde as versões 1.2.8 e 1.2.9. A versão adiciona a exportação para PDF do Markdown renderizado nos artefactos e no painel lateral, incluindo tabelas, blocos de código e diagramas, e uma opção de anulação limitada à conversa; entre as suas cinco correções, os agentes personalizados passam finalmente a respeitar as regras globais e as do projeto. A disponibilização é gradual e pode demorar alguns dias. A CLI tinha recebido, a 27 de setembro, uma versão 1.2.12 que passou despercebida: uma sessão iniciada com uma chave GEMINI_API_KEY termina agora imediatamente quando a API Gemini indica que a quota diária foi esgotada, que foi atingido um limite de despesas ou que os créditos pré-pagos se esgotaram, em vez de continuar durante vários minutos com tentativas destinadas a falhar.
🔗 Changelog da aplicação Antigravity · Changelog da CLI Antigravity
Breves
- Copilot CLI 1.0.90 e 1.0.91 — A 1.0.90 passa a estável em 30 de setembro com GPT-6.1 Sol no seletor de modelos e correções do MCP e da retoma de sessões; a 1.0.91, em 1 de outubro, acrescenta os comandos
copilot sandbox capara gerir o certificado do proxy da sua sandbox. 🔗 fonte - Codex CLI 0.159.3 — Publicada em 30 de setembro às 22 h 57 UTC, contém apenas um backport: as sessões locais com sessão iniciada através do ChatGPT podem apresentar lembretes opcionais para concluir a configuração da segurança da conta, uma alteração também incluída na 0.160.0. 🔗 fonte
- Nightly do Gemini CLI — A v0.64.0-nightly de 1 de outubro corrige um bloqueio com utilização de 100 % do processador em modo headless e torna atómicas as escritas das ferramentas de ficheiros; as versões estável e de pré-lançamento mantêm-se inalteradas. 🔗 fonte
- Zed 1.23.1 em pré-lançamento — Publicada em 30 de setembro, apresenta os ficheiros JSONL e NDJSON em forma de tabela, acrescenta a definição
agent.max_idle_retained_threadse repete automaticamente os pedidos quando um modelo Google AI está sobrecarregado. 🔗 fonte - Copilot no VS Code em setembro — O balanço mensal das versões 1.136 a 1.140 assinala algumas novidades que passaram despercebidas, incluindo a retoma no VS Code de uma conversa Codex iniciada na aplicação ChatGPT, um distintivo da aplicação em pré-lançamento e chats abertos sem espaço de trabalho. 🔗 fonte
- Planear em conjunto no Delta — No blog do Delta, Nathan Sobo conta como três membros da equipa planeiam na mesma conversa com Fable e depois Astra, uma subconversa e um subagente isolados, em vez de o fazerem num ficheiro
plan.md; não é anunciada nenhuma funcionalidade nova. 🔗 fonte - Innate filmada pela Cursor — A Cursor publica um breve retrato em vídeo da Innate, uma equipa de sete pessoas que constrói robôs para o dia a dia e cujo cofundador Vignesh Anand afirma que faz o trabalho de 50, sem especificar como utiliza o Cursor. 🔗 fonte
- Recordar em vez de compactar — David Corvoysier, programador do funes, mede com Claude Code que recuperar a sessão anterior através da sua ferramenta encontra as respostas certas com 8, 4 e 3 vezes menos tokens ponderados do que manter todo o contexto, em três tarefas que ele próprio escolheu. 🔗 fonte
- Novo painel do GitHub — A vista que reúne sessões de agentes ativas, issues e pull requests, com um máximo de 12 elementos por lista, torna-se a vista predefinida para todos; o fluxo de notícias passa para um separador Feed e a apresentação anterior continua acessível. 🔗 fonte
- API de merge assíncrono — Passa a disponibilidade geral e torna-se a via recomendada para efetuar merges programaticamente, em substituição do endpoint REST síncrono e das mutations GraphQL; é a única API de merge que suporta pull requests empilhadas. 🔗 fonte
- Dist-tags npm sem token — As configurações de publicação de confiança do npm podem receber uma autorização opcional, desativada por predefinição, para gerir dist-tags com credenciais OIDC de curta duração em vez de um token de acesso de longa duração. 🔗 fonte
- Retenção do GitHub Actions — Checks, execuções de workflows e estados, incluindo os de aplicações de terceiros, passam a seguir a definição de retenção dos artefactos e dos registos e são eliminados após esse prazo, com um máximo de 90 dias para os repositórios públicos e sem possibilidade de recuperação. 🔗 fonte
- Code scanning e repositórios inativos — As análises semanais agendadas do code scanning e do GitHub Code Quality só passam a iniciar-se após uma análise desencadeada por um push ou uma pull request, para evitar que um repositório inativo pareça ativo durante mais seis meses. 🔗 fonte
- Cobertura de código — A action
upload-code-coveragedo GitHub Code Quality deixa de fazer falhar a CI no push de um branch que ainda não tem uma pull request aberta. 🔗 fonte - Declarações de acessibilidade — Um ficheiro
ACCESSIBILITY.mdcolocado na raiz, em.github/ou emdocs/é destacado na página inicial do repositório, em todos os planos do github.com, e chegará ao GitHub Enterprise Server 3.24. 🔗 fonte - Actions Runner Controller 0.15.0 — O controlador Kubernetes dos runners alojados pelos próprios utilizadores atualiza os recursos no local durante atualizações de correção, permite configurar o prazo de encerramento, os limites do cliente Kubernetes e a concorrência dos controladores, e reduz a carga dos seus pedidos. 🔗 fonte
- Grok Bot toma a iniciativa — O Bot principal do utilizador passa a identificar trabalho que pode fazer por ele e propõe tratar dele; a disponibilização decorre ao longo de algumas horas e estas sugestões não são contabilizadas na utilização, sem indicação de planos ou países. 🔗 fonte
- Genspark e Azure Cosmos DB — Uma publicação no blog do Azure Cosmos DB, escrita do ponto de vista da Genspark, explica como alguns processamentos em segundo plano passam por índices secundários globais para deixarem de abrandar as sessões de agentes em direto; não são apresentados números. 🔗 fonte
- Testemunho na Genspark — Seulki Kang, com quinze anos de experiência em marketing, diz preparar um conjunto completo de materiais de formação em 5 horas em vez de 30, ligando os seus documentos antigos ao SecondBrain e depois ao AI Slides; não há novidades de produto. 🔗 fonte
- Albertsons e OpenAI — O retalhista com mais de 2 200 lojas alarga a sua parceria, do ChatGPT Enterprise para equipas selecionadas à API para as suas experiências de cliente e análises promocionais, e destaca o seu plugin Safeway no ChatGPT, anunciado em 5 de agosto. 🔗 fonte
- O complemento eterno — A OpenAI publica o primeiro ensaio de uma série sobre a próxima economia, assinado por Hemanth Asirvatham e Elliott Mokski, que esclarecem falar em nome próprio: a maior parte da inteligência das máquinas poderá servir para executar tarefas, em vez de alcançar avanços. 🔗 fonte
- Perplexity e os consultores — Um guia compara dez ferramentas de IA para consultores, da AlphaSense à Qwilr, com preços verificados em setembro; a sua FAQ recorda que o plano gratuito da Perplexity treina os seus modelos com os dados dos utilizadores, salvo oposição. 🔗 fonte
- Luma Variants — Apresentada na véspera sem pormenores, a funcionalidade é lançada para todos os utilizadores da Luma: a partir de um anúncio estático aprovado, produz variantes em cinco formatos padrão, de 9:16 a 16:9, e em várias línguas, sem preço anunciado. 🔗 fonte
- HeyGen Professional Voice Clone — Segundo o seu balanço de setembro, a HeyGen disponibiliza pela API o seu clone de voz mais fiel, treinado com pelo menos 20 minutos de gravações (1 a 10 ficheiros), após uma fase de acesso antecipado privado lançada em 9 de setembro. 🔗 fonte
- Pika e as suas aplicações — A Pika afirma ter mais de 40 aplicações na sua nova plataforma e apresenta duas, Podcast Video, que põe duas personagens a debater, e Color Grade, que ajusta a cor de uma imagem ou de um clip, sem data nem preço. 🔗 fonte
- ElevenLabs no Benelux — A ElevenLabs abre escritórios em Bruxelas e Amesterdão e prevê triplicar as suas equipas nesses locais; no operador KPN, o reconhecimento dos códigos postais passa de 64 % para 82 % e o agente de verificação trata cerca de 60 000 chamadas por semana. 🔗 Países Baixos · 🔗 Bélgica
- Skills DOCA da NVIDIA — Em 65 prompts reais de programadores, os agentes de código equipados com estas skills para as DPU BlueField cumprem 100 % dos critérios da grelha de avaliação, contra 19 % sem elas; estão publicadas no GitHub. 🔗 fonte
- DIN Deploy — A NVIDIA publica exemplos C++ open source para executar modelos localmente com ONNX Runtime e TensorRT RTX, em Windows e Linux; num DGX Spark, Parakeet TDT transcreve 206 vezes mais depressa do que o tempo real no GPU, contra 14 vezes no CPU. 🔗 fonte
- Nemotron 3.5 ASR e dialetos sauditas — Um tutorial da NVIDIA faz fine-tuning do modelo com os dialetos najdi e hijazi: a taxa de erro por palavra passa de 55,05 % para 29,96 % em 12 000 passos em duas RTX PRO 6000, com uma ligeira melhoria também no inglês e no árabe do FLEURS. 🔗 fonte
- Sistema de recomendação HSTU no Dynamo-Triton — A NVIDIA disponibiliza um sistema de recomendação generativo HSTU com PyTorch AOTInductor e uma cache KV: no melhor caso, numa RTX PRO 6000, é até 4,47 e 5,93 vezes mais rápido consoante o número de camadas, correspondendo a 0,423 e 0,678 ms por pedido. 🔗 fonte
- Rentabilidade das fábricas de IA — Numa publicação de opinião, a NVIDIA estima o custo de uma fábrica de IA em cerca de 60 milhões de dólares por megawatt e retoma os dados da SemiAnalysis: Vera Rubin NVL72 até 45 vezes mais barato por milhão de tokens do que GB300 NVL72 no DeepSeek V4 Pro, contra 35 vezes em 24 de agosto. 🔗 fonte
- huggingface_hub 2.1.0 — A biblioteca reinicia automaticamente os Jobs que falham, reagenda-os sem os recriar, lê a quota ZeroGPU restante e descarrega os ficheiros Xet através de
hf_xet: um parquet de 2 GB passa de cerca de 120 para 7 segundos nos HF Jobs; três alterações incompatíveis com versões anteriores. 🔗 fonte - ML Intern e MCP — A Hugging Face liga fontes de dados MCP ao ML Intern, o modo do HuggingChat que treina modelos, para fazer fine-tuning de modelos abertos com os próprios dados empresariais; o anúncio não é acompanhado de números oficiais. 🔗 fonte
- Hugging Face e o Open Source for Science Fund — Os dois parceiros querem identificar as bibliotecas de que mais dependem os contribuidores de modelos científicos e apoiar os seus maintainers, sem montante nem calendário. 🔗 fonte
- Um milhão de treinos com TRL — Segundo a telemetria citada por Quentin Gallouédec, a biblioteca de pós-treino da Hugging Face regista um milhão de treinos por mês, com um objetivo de um milhão por semana; o método de contagem não foi publicado. 🔗 fonte
- O milhão de conjuntos de dados do Hub — Três autores mostram que as contas de organizações publicam cerca de 19 % dos conjuntos, mas concentram metade dos downloads, e que os Estados Unidos detêm 390 dos 1 000 conjuntos mais descarregados. 🔗 fonte
- Oito VLM numa RTX 3090 — Aakash Gupta, da ThinkEvolve, mostra que, com a mesma exatidão, Qwen3-VL-8B processa cada pedido 2,2 vezes mais depressa do que Qwen3.8-27B, mas demora 18,88 horas contra 7,53 num trabalho de 7 329 chamadas, por não reutilizar a cache de prefixos. 🔗 fonte
- GLiNER2.5-Decide face ao layax — Aravind Vijayakumar não consegue certificar nenhum limiar de confiança para o modelo da Fastino, contra 10 ensaios em 10 para o layax, a sua própria ferramenta, com uma exatidão superior em 20 a 23 pontos e cerca de cinco vezes mais rápida. 🔗 fonte
- David Ha e os orquestradores — Num artigo de opinião para o Nikkei Asia, o cofundador e CEO da Sakana AI considera que o valor passará dos pesos de um modelo para a inteligência que combina vários modelos, e define a soberania como a solidez da cadeia de abastecimento. 🔗 fonte
- Difusão de vídeo em TPU — Três engenheiros da Google reduzem a remoção de ruído de um vídeo 1440p de 2 471 para 1 461 segundos em oito chips TPU v6e, ou seja, 1,69 vezes mais depressa, graças à atenção esparsa do Sparse VideoGen e a um kernel Splash Attention otimizado. 🔗 fonte
O que isto significa
Os agentes de código tornam-se programáveis por quem os utiliza. Com os mods, Claude Code expõe os seus eventos internos a pequenas funções TypeScript, ao ponto de converter as suas próprias funções em mods substituíveis; com os workflows dinâmicos, o GitHub permite escrever a orquestração dos subagentes em código, em vez de deixar o Copilot decidir a divisão das tarefas de cada vez. O guia do FineEnvs recorda por que razão o harness conta tanto como o modelo: os mesmos pesos resolvem 62 % das tarefas num harness e 33 % noutro. A contrapartida é a confiança. Um mod tem o mesmo acesso à máquina que Claude Code, copilot workflow run não apresenta nenhum pedido de confirmação, e o controlo das aplicações de desktop pode atuar sobre contas com sessão iniciada. Os dois fornecedores respondem com a desativação por predefinição do controlo do desktop, uma verificação antes da instalação (claude plugin validate) para os mods e regras empresariais que têm prioridade.
A IA impõe também novos filtros a quem recebe os seus resultados. O GitHub estrutura e limita a comunicação privada de vulnerabilidades porque os relatórios gerados por IA inundam os maintainers; a Google DeepMind propõe aplicar marcas de água às proteínas concebidas por IA para que os fornecedores de síntese de ADN saibam de onde vem uma sequência desconhecida. Nos dois casos, o objetivo não é proibir a IA, mas tornar a sua utilização visível: uma caixa para declarar a ajuda da IA de um lado, uma assinatura verificável do outro.
Nas empresas, a adoção passa a medir-se por utilizações concretas. O Barclays fixa um objetivo de 50 % dos programadores a utilizar Claude Code no final de 2026 e recorre à IA para triar 120 000 e-mails por dia, a American Express faz do seu cartão Business uma porta de entrada para as Skills do Perplexity Computer, com créditos oferecidos, e a Anthropic usa os seus limites de utilização como incentivo ao reduzir para metade, durante duas semanas, o consumo do trabalho que se segue à criação de um artefacto. Para o público em geral, os assistentes integram-se em ações concretas: ler um menu a uma pessoa cega, experimentar uma peça de roupa antes de a comprar, traçar um gráfico bolsista na conversa.
Os números dos modelos, por fim, devem ser lidos à luz do respetivo protocolo. A Ai2 esclarece que a sua medição com 1 200 mil milhões de parâmetros avalia o sistema e não um modelo treinado, a Cloudflare escolhe os seus benchmarks e reconhece que Jev continua à frente no When2Call e no BRIGHT, e a classificação de vídeo da Artificial Analysis coloca Wan 3.0 no topo com intervalos de confiança que se sobrepõem. FLUX 3 Image segue um caminho que se tornou comum: pesos comerciais sob licença de imediato, pesos abertos mais tarde, sem data.
Fontes
- Personalize o Claude Code com mods em TypeScript (claude.com)
- Guia de introdução aos mods em claude.dev
- Documentação dos mods do Claude Code
- Reação de Boris Cherny no X
- Notas de versão do Claude Code 2.1.287
- Changelog do GitHub sobre o controlo de aplicações de desktop
- Changelog do GitHub sobre workflows dinâmicos
- Anúncio do FLUX 3 Image por @bfl_ai
- Página do modelo FLUX 3 Image
- Guided Vision no Gemini Live (blog do Google)
- Notas de versão do ChatGPT
- Gráficos interativos do Perplexity Computer
- Oferta de artefactos anunciada por @claudeai
- Condições da oferta de artefactos (centro de ajuda do Claude)
- Barclays e Claude (Anthropic)
- Publicação da Perplexity sobre a American Express
- Página da American Express como parceira da Perplexity
- Anúncio do Wan 3.0 por @Alibaba_Wan
- Classificação AA-Video-T2V v2.0 da Artificial Analysis
- Utopai X na classificação da Artificial Analysis
- Project Continuum por @runwayml
- Anúncio de Sessions por @synthesiaIO
- Página do Synthesia Sessions
- SynthID Bio (Google DeepMind)
- Ciência moldada pelo Claude (Anthropic Science)
- Olmo-core 3 (Ai2)
- Lançamento do Olmo-core v3.0.0
- Clef e Clef-flash (blog da Cloudflare)
- Clef no Hugging Face
- Guia de RL com múltiplos harnesses da FineEnvs
- Ficha do Grok 4.7 no Google Cloud
- Anúncio do Grok 4.7 no Google Cloud por @SpaceXAI
- Formulários estruturados para denúncias privadas de vulnerabilidades
- Limites diários para denúncias privadas de vulnerabilidades
- Codex CLI 0.160.0
- Notas de versão do Delta 0.18.0
- Changelog da aplicação Antigravity
- Changelog da CLI Antigravity
- Copilot CLI 1.0.91
- Codex CLI 0.159.3
- Nightly do Gemini CLI de 1 de outubro
- Versão de pré-visualização do Zed 1.23.1
- Resumo de setembro do Copilot no VS Code
- Planear em conjunto no Delta
- Perfil da Innate pelo Cursor
- Benchmark de recuperação de sessões com funes
- Novo painel do GitHub
- API de merge assíncrono do GitHub
- Dist-tags e publicação de confiança no npm
- Retenção do GitHub Actions
- Code scanning e repositórios inativos
- Envios de cobertura de código
- Declarações de acessibilidade dos repositórios
- Actions Runner Controller 0.15.0
- Sugestões do Grok Bot
- Genspark e Azure Cosmos DB
- Testemunho de Seulki Kang (Genspark)
- Albertsons Companies e OpenAI
- O complemento eterno (OpenAI)
- Guia da Perplexity sobre ferramentas de IA para consultores
- Luma Variants
- Resumo de setembro da HeyGen
- Aplicações da Pika
- ElevenLabs nos Países Baixos
- ElevenLabs na Bélgica
- Skills DOCA da NVIDIA
- DIN Deploy da NVIDIA
- Nemotron 3.5 ASR e dialetos sauditas
- Recomendador HSTU no Dynamo-Triton
- Rentabilidade das fábricas de IA (NVIDIA)
- huggingface_hub 2.1.0
- ML Intern e fontes de dados MCP
- Open Source for Science Fund e Hugging Face
- Um milhão de treinos com TRL
- O milhão de conjuntos de dados do Hub
- Oito VLM avaliados numa RTX 3090
- GLiNER2.5-Decide face ao layax
- Artigo de opinião de David Ha partilhado pela Sakana AI
- Difusão de vídeo acelerada em TPU