ai-powered-markdown-translatorArticolo tradotto dal fr all’it con gpt-6.1-sol.
Giovedì 1° ottobre, Anthropic lancia i mod, piccole funzioni TypeScript che si agganciano agli eventi di Claude Code per riscriverne il comportamento e l’interfaccia, distribuite con la versione 2.1.287. Lo stesso giorno GitHub rende disponibili in anteprima pubblica due capacità degli agenti in Copilot CLI e nell’app GitHub Copilot: il controllo delle applicazioni desktop e i workflow dinamici, orchestrazioni scritte in codice. Black Forest Labs lancia FLUX 3 Image, che compone tramite riquadri delimitatori e genera fino al 4K; Google introduce Guided Vision in Gemini Live, Barclays estende Claude a tutta la banca e GitHub inasprisce le regole per la segnalazione delle vulnerabilità di fronte alle segnalazioni generate dall’IA.
Claude Code si apre ai mod, funzioni TypeScript che ne riscrivono il comportamento e l’interfaccia
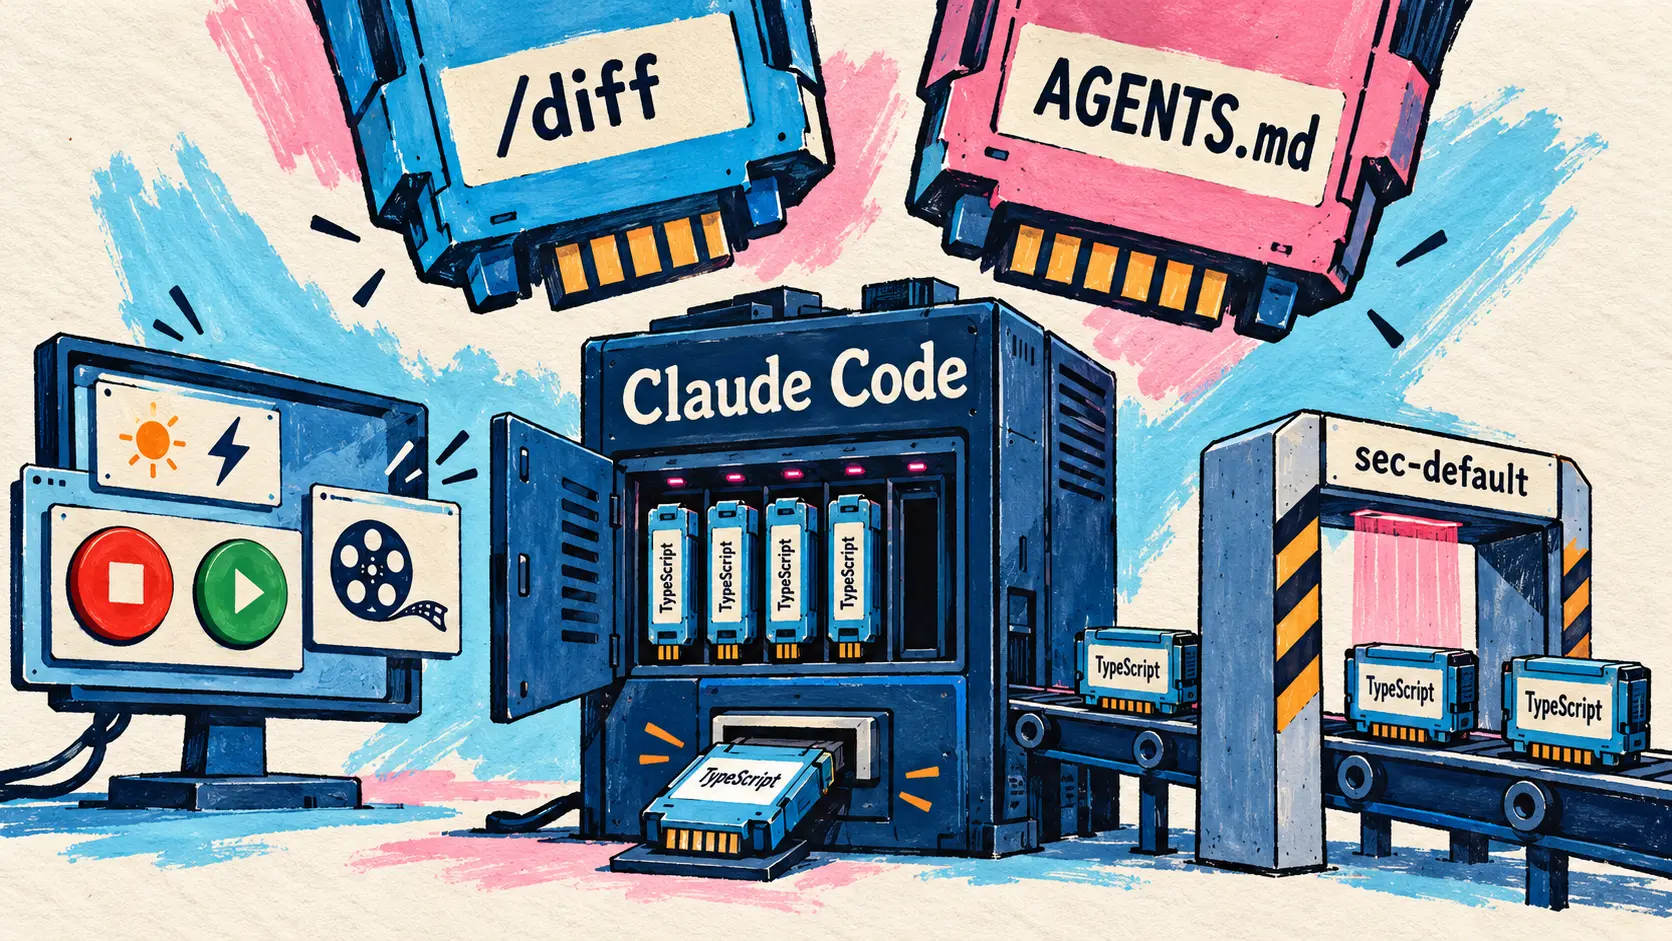
1° ottobre — Anthropic lancia i mod, piccole funzioni TypeScript che cambiano il funzionamento di Claude Code. Ogni azione dello strumento emette un evento (chiamata a uno strumento, richiesta di autorizzazione, prompt inviato, inizio e fine del turno, rendering di una parte dello schermo), e un mod vi si aggancia prima, dopo, al suo posto o avvolgendolo. Può riscrivere un prompt prima che raggiunga il modello, bloccare, riscrivere o ripetere una chiamata a uno strumento, approvare o negare un’autorizzazione, nascondere segreti nell’output di uno strumento prima che Claude lo legga, oppure aggiungere i propri pannelli, pulsanti e campi di immissione. I mod vengono distribuiti nei plugin, si installano con /plugin e si condividono come questi ultimi; arrivano con Claude Code 2.1.287 e sono attivati per impostazione predefinita. Non serve conoscere l’API per iniziare: si può chiedere a Claude Code di scrivere il mod, e lui produce il TypeScript, lo installa e lo ricarica a caldo nella sessione.
La differenza rispetto agli hook esistenti è netta. Un hook delle impostazioni (settings hook) esegue un comando shell a ogni evento; un mod viene caricato una volta e rimane nella sessione, quindi conserva uno stato, ridisegna l’interfaccia al susseguirsi degli eventi e può registrare comandi slash o strumenti che il modello richiama. Anthropic li usa già per le proprie funzioni: il pannello /diff e il supporto per AGENTS.md sono diventati mod integrati, che si possono disattivare o sostituire, e l’azienda prevede di convertirne altri nel tempo per consentire di ridurre Claude Code a un piccolo nucleo. Tra i sei mod integrati elencati dalla documentazione figura You should know, disattivato per impostazione predefinita, in cui un agente secondario segnala ciò che potrebbe sfuggire all’utente o a Claude.
| Aspetto dei mod | Dettaglio ufficiale |
|---|---|
| Versione minima | Claude Code 2.1.287, mod attivati per impostazione predefinita |
| Interfacce con visualizzazione | CLI nel terminale, scheda Code di Claude Desktop (escluse le sessioni WSL) |
| Interfacce senza visualizzazione | Estensione VS Code, claude -p, Agent SDK e sessioni cloud, in cui vengono eseguiti gli hook |
| Mod integrati | 6, tra cui /diff, AGENTS.md, sec-default e You should know |
| Tempo di esecuzione proprio di un hook | 10 secondi per attivazione |
| Disattivazione | /plugin per un mod, --safe-mode per una sessione, disableAllHooks per tutti |
La guida introduttiva di Addy Osmani su claude.dev costruisce Token Weather, un mod di circa 80 righe che mostra sopra il prompt il «meteo» del contesto, con un piccolo grafico degli ultimi 12 turni. Presenta anche Blast Radius, che sospende un rm -rf, un git reset --hard o un push forzato per mostrare su cosa inciderebbe, e Replay Theater, che riproduce le modifiche ai file di un turno.
La fiducia rimane il punto delicato. Il post avverte che i mod non sono isolati: dispongono dello stesso accesso alla macchina di Claude Code, e la documentazione precisa che un mod può leggere le variabili d’ambiente e i file delle impostazioni, vedere ogni prompt, approvare una chiamata a uno strumento o consumare la quota del piano, ma non modificare la richiesta di autorizzazione. La guida di claude.dev descrive però un modulo che viene eseguito nella propria sandbox, senza DOM né Node, con ogni azione esterna che passa attraverso l’API $: è questo che permette a claude plugin validate di elencare, prima dell’installazione, gli eventi che un mod intercetta e le chiamate che effettua. Su Team ed Enterprise, e su qualsiasi macchina con impostazioni gestite, il mod integrato sec-default viene caricato per primo e impedisce ai mod installati dall’utente di aggirare le regole di rifiuto; gli amministratori possono collocare i propri mod prima di esso.
Mods are absolutely insane. You can now customize Claude to work and look the way you want by just prompting it. Each person works differently, so there’s no reason why everyone should have an identical Claude experience. Make Claude your own, and share mods as plugins so others can try your mods too.
🇮🇹 I mod sono una follia totale. Ora potete personalizzare Claude affinché lavori e si presenti come volete, semplicemente chiedendoglielo. Ognuno lavora in modo diverso, quindi non c’è alcun motivo per cui tutti debbano avere un’esperienza Claude identica. Fate vostro Claude e condividete i vostri mod sotto forma di plugin, così che altri possano provarli. — @bcherny su X
Il lancio era atteso: Boris Cherny lo aveva annunciato il 14 settembre, e Anthropic aveva condiviso il progetto su GitHub (issue #91870). Il post e la guida di claude.dev invitano a inviare i propri mod alla directory di Claude.
🔗 Personalizzare Claude Code con i mod in TypeScript · Guida introduttiva su claude.dev · Documentazione dei mod
Claude Code 2.1.287: contesto di 1M per impostazione predefinita presso i fornitori cloud e 67 correzioni
1° ottobre — Claude Code 2.1.287 è la versione che introduce i mod, ma conta 106 voci, di cui 67 correzioni. Per le aziende, su Bedrock, Vertex, Foundry e il gateway Claude apps, Opus 4.7 e le versioni successive, oltre a Fable, usano ora per impostazione predefinita una finestra di contesto di 1M, senza suffisso [1m]; CLAUDE_CODE_DISABLE_1M_CONTEXT=1 permette di rimanere a 200K. /advisor accetta Sonnet 5.5 come consigliere di Opus 4.7 e 4.8, un cambio automatico di modello conserva il livello di sforzo corrente, e i server MCP con protocollo 2025-11-25 possono aprire richieste di URL. Un rm pericoloso mantiene la richiesta di conferma anche quando il comando reindirizza il proprio output verso ~ o un carattere jolly, le richieste di autorizzazione in sospeso vengono visualizzate dalla più vecchia alla più recente, e nove voci migliorano la modalità lettore di schermo. In VS Code, un comando o un sottoagente in esecuzione può passare in background (Run in background).
🔗 Note di rilascio di Claude Code 2.1.287
GitHub Copilot: il controllo delle applicazioni desktop e i workflow dinamici in anteprima pubblica
1° ottobre — Lo stesso giorno GitHub rende disponibili in anteprima pubblica due capacità degli agenti in Copilot CLI e nell’app GitHub Copilot: il controllo delle applicazioni desktop e i workflow dinamici, disponibili anche nel GitHub Copilot SDK.
Copilot controlla le applicazioni desktop. Il controllo del computer (computer use) arriva su macOS e Windows. Copilot legge il contenuto accessibile di una finestra e il suo contesto visivo, tramite l’albero di accessibilità del sistema o tramite screenshot quando necessario, fa clic sui controlli, inserisce testo, preme tasti, scorre, trascina e rilascia ed esegue una sequenza di passaggi da un’applicazione all’altra; la dimostrazione lo mostra mentre compila una nota spese in Safari. GitHub punta ai software datati o puramente grafici, senza API, senza interfaccia a riga di comando né integrazione MCP, e la documentazione raccomanda questi canali quando esistono, perché danno risultati più prevedibili. La funzione è disattivata per impostazione predefinita: /computer on la attiva nella CLI, /computer show ne mostra lo stato e /computer off la disattiva, mentre l’app la propone nelle proprie impostazioni. Copilot chiede l’autorizzazione prima di controllare ciascuna applicazione: la si può concedere per la sessione, memorizzare per quelle successive o negare. Un’approvazione permanente (Always allow) vale per la CLI e l’app sulla stessa macchina, ma una regola di rifiuto prevale sempre, e due pressioni del tasto Esc nella CLI, o il pulsante Stop nell’app, interrompono un’azione che sfugge al controllo. Le impostazioni gestite di un’organizzazione possono disattivare la funzione, senza che un’attivazione locale possa aggirarle. GitHub avverte che un’istruzione ambigua o un contenuto inatteso sullo schermo può provocare azioni indesiderate sugli account connessi, anche finanziari, e sconsiglia l’approvazione permanente per le applicazioni sensibili. Non vengono precisati né i piani interessati né alcun dato numerico; il comando /computer figurava già nelle note di Copilot CLI 1.0.85, il 16 settembre.
🔗 GitHub Copilot può ora interagire con le applicazioni desktop tramite computer use
Orchestrazioni scritte in codice. I workflow dinamici (dynamic workflows), disponibili su tutti i piani Copilot, descrivono in un programma come svolgere un’attività: il codice stabilisce le fasi, il momento in cui interviene un agente e l’uso dei suoi risultati, in sequenza, in parallelo o in entrambi i modi, e gli agenti si occupano di ciò che richiede analisi o giudizio. Un workflow può eseguire comandi, suddividere un obiettivo in attività parallele, trasmettere risultati strutturati da una fase all’altra, far verificare le conclusioni di un sottoagente da un altro e fermarsi a un punto di controllo (checkpoint) per una revisione prima di riprendere. GitHub cita l’indagine su un incidente, la revisione in parallelo dei file di una pull request o commenti di revisione sottoposti a due modelli e segnalati soltanto se entrambi concordano.
| Modalità di Copilot | Chi organizza il lavoro, secondo la documentazione |
|---|---|
| Autopilot | Copilot, che procede senza chiedere una convalida dopo ogni fase |
/fleet | Copilot, che ogni volta suddivide l’attività tra sottoagenti in parallelo |
| Workflow dinamico | Il codice scritto dall’autore: fasi, condizioni e passaggi di consegne |
Il programma risiede in un’estensione di Copilot CLI e dell’app. Un workflow scritto da Copilot rimane limitato alla sessione, ma si può riutilizzare copiando l’estensione nella propria directory personale, condividere tramite quella di un repository o impacchettare in un plugin. I sottoagenti ereditano le autorizzazioni della sessione, mentre il comando copilot workflow run non mostra alcuna richiesta: occorre concedere le autorizzazioni prima dell’avvio. Disponibili senza configurazione nell’app, i workflow richiedono nella CLI l’attivazione delle funzioni sperimentali (--experimental o /experimental on). GitHub non pubblica né dati numerici né regole di fatturazione, e il nome richiama, senza alcun legame annunciato, i Dynamic Workflows lanciati da Anthropic in Claude Code il 28 maggio.
🔗 Workflow dinamici in Copilot CLI e nell’app Copilot
FLUX 3 Image: Black Forest Labs compone tramite riquadri delimitatori e genera fino al 4K
1° ottobre — Black Forest Labs (BFL) aggiunge un modello di immagini alla propria famiglia FLUX 3, con una parola d’ordine: controllare ogni pixel. FLUX 3 Image ritocca un’area in più passaggi successivi senza modificare il resto dell’immagine e accetta più modifiche nella stessa richiesta.
La novità più evidente è la composizione tramite riquadri delimitatori (bounding boxes). Qualunque sia il formato, l’immagine diventa un sistema di coordinate da 0 a 1000 su ciascun asse: si traccia un riquadro per ogni elemento, se ne descrive il contenuto, poi si riassume la scena in una riga, e il modello colloca ciascun elemento nel proprio riquadro; resta possibile usare soltanto un prompt testuale. FLUX 3 Image combina anche fino a 10 immagini di riferimento, richiamate tramite token nel prompt, delle quali decide autonomamente posizione e dimensioni. BFL lo presenta come «progettato per gli agenti»: un LLM può redigere la tabella degli elementi e dei loro riquadri a partire da una semplice richiesta, che l’utente modifica prima di avviare la generazione.
| Caratteristica annunciata | Dettaglio comunicato da BFL |
|---|---|
| Risoluzione nativa | 2K e 4K (esempio dalla pagina del modello: 5456 × 3072 pixel, 16,8 MP) |
| Immagini di riferimento | Fino a 10 |
| Composizione | Riquadri delimitatori su una griglia da 0 a 1000 per asse |
| Modifica | Su più turni, senza modificare gli altri pixel |
| Offerta API | 50 % di sconto fino all’8 ottobre |
| Pesi del modello | Commerciali su licenza; pesi aperti «nelle prossime settimane» |
Quanto all’accesso, FLUX 3 Image è disponibile tramite l’API con il 50 % di sconto fino all’8 ottobre, e BFL propone pesi commerciali su licenza alle aziende che vogliono affinare il modello e distribuirlo sulla propria infrastruttura. La versione a pesi aperti è annunciata senza una data. Al momento dell’annuncio non erano stati pubblicati né un prezzo di base né benchmark con risultati numerici. Il modello completa una serie lanciata quest’estate: FLUX 3, modello multimodale unificato (23 luglio), FLUX 3 Video (4 agosto), la sua modalità di modifica (10 settembre) e FLUX 3 Action per la robotica (23 settembre).
🔗 Annuncio di FLUX 3 Image da parte di @bfl_ai · Pagina del modello FLUX 3 Image
Assistenti per il grande pubblico: Guided Vision in Gemini Live, prova virtuale in ChatGPT, grafici in Perplexity Computer, limiti meno restrittivi per gli artefatti di Claude
Guided Vision: Gemini Live guida le persone cieche e ipovedenti
1° ottobre — Google distribuisce Guided Vision in Gemini Live su Android 9 e versioni successive, nelle regioni e nelle lingue in cui Gemini Live è disponibile. Progettata insieme a persone cieche e ipovedenti, la funzione descrive in tempo reale ciò che riprende la videocamera condivisa, risponde alle domande di approfondimento e fornisce istruzioni verbali per regolare l’inquadratura: ruotare lentamente verso destra, inclinare verso il basso, indietreggiare. Google cita la lettura di un’etichetta nutrizionale o di un menu in un ristorante poco illuminato, la ricerca di un auricolare caduto o la descrizione dei colori di un indumento. Per addestrarla, Google ha collaborato con Aira, un servizio di interpretazione visiva: decine di migliaia di ore di dati, oltre 1 000 tester della sua rete e specialisti coinvolti nelle misure di protezione. Guided Vision si attiva dal profilo dell’applicazione Gemini, tramite una scorciatoia di accessibilità Android o da TalkBack. Google precisa che non è né un dispositivo medico né un ausilio alla mobilità: la funzione non sostituisce il bastone bianco.
🔗 Guided Vision in Gemini Live (blog Google)
ChatGPT: prova virtuale e preferiti per gli acquisti
1° ottobre — Secondo le note di rilascio di ChatGPT, sulle schede di abbigliamento e accessori compare un pulsante per la prova virtuale (Try on): si scatta o si carica un selfie e ChatGPT Images genera una prova virtuale dell’articolo. La foto di riferimento viene conservata per le prove successive; si può sostituire o eliminare nelle impostazioni, nella sezione delle foto di riferimento (Settings → Personalization → Reference photos). Qualsiasi prodotto può anche essere salvato nei preferiti o inserito in una cartella della libreria ChatGPT. Entrambe le funzioni sono disponibili su mobile e sul web, ma la nota non specifica né i piani né i paesi interessati. ChatGPT proponeva già uno shopping visivo dal 24 marzo.
Perplexity Computer crea grafici interattivi
1° ottobre — Perplexity Computer crea ora grafici e visualizzazioni interattive direttamente nel flusso della conversazione. Per i dati finanziari, l’agente si basa su Lightweight Charts di TradingView per visualizzare candele, volume e medie mobili. L’annuncio si limita a un tweet accompagnato da un video: non indica né quali piani ne beneficiano né su quali piattaforme, e nessuna voce del changelog ne descrive ancora i dettagli. ChatGPT e Claude avevano intrapreso questa strada il 10 e il 12 marzo, Replit Agent il 25 settembre.
🔗 Annuncio di @perplexity_ai su X
Claude dimezza il consumo dei limiti dopo un artefatto, fino al 15 ottobre
1° ottobre — Dal 1° ottobre alle 11 h PT al 15 ottobre alle 23 h 59 PT, creare o modificare un artefatto (documento, presentazione o design) in Claude o Claude Cowork riduce del 50 % il consumo del limite della sessione di cinque ore per il lavoro successivo. L’offerta si applica automaticamente ai piani Pro, Max e Team; Free e i piani Enterprise sono esclusi, e il limite settimanale non cambia.
| Ambito interessato | Portata della riduzione del 50 % |
|---|---|
| Conversazione avviata dal menu Output | Dal primo messaggio: 10 messaggi, 15 passaggi per risposta |
| Conversazione ordinaria | I 10 messaggi successivi alla creazione dell’artefatto, 15 passaggi per risposta |
| Attività Cowork nel cloud avviata da Output | Circa i primi 45 minuti |
| Altra attività Cowork nel cloud | Fino a 80 passaggi dopo la creazione o la modifica di un artefatto |
Claude Code, l’API, Claude in Slack, le attività Cowork locali o pianificate, i crediti di utilizzo e l’applicazione autonoma Claude Design sono esclusi. Anthropic suggerisce di provare con Sonnet 5.5 e si riserva il diritto di modificare o interrompere l’offerta in anticipo.
🔗 Annuncio di @claudeai su X · Condizioni dell’offerta (centro assistenza Claude)
Finanza: Barclays estende Claude a tutta la banca, American Express apre Perplexity Computer ai suoi clienti Business
Barclays punta a portare metà dei suoi sviluppatori su Claude Code entro la fine del 2026
1° ottobre — Barclays, la banca universale britannica, amplia la collaborazione con Anthropic e distribuisce Claude in tutta l’organizzazione per accelerare lo sviluppo software, modernizzare i sistemi obsoleti e migliorare l’efficienza operativa. La banca prevede che Claude Code venga adottato dal 50 % dei suoi sviluppatori entro la fine del 2026, poi dalla maggioranza dei suoi ingegneri software nel 2027. Due utilizzi sono già quantificati. Il Colleague Knowledge Assistant, in servizio dal 2025 e costruito su Claude con un’architettura di generazione aumentata tramite recupero (RAG), è stato adottato da oltre 16 000 colleghi e ha elaborato più di un milione di ricerche; aiuta i team che servono oltre 20 milioni di clienti privati nel Regno Unito. Nell’attività Global Markets, i modelli Claude classificano, arricchiscono e smistano circa 120 000 e-mail al giorno. Paul Smith, direttore commerciale di Anthropic, la considera una tappa importante per l’azienda nel Regno Unito; non vengono comunicati né l’importo né la durata del contratto.
🔗 Barclays estende l’uso di Claude per migliorare le operazioni e l’esperienza dei clienti
Perplexity e American Express: dieci Skills aziendali in Computer per le carte Business
1° ottobre — Perplexity lancia una raccolta di Skills pronte all’uso per Perplexity Computer, riservata ai titolari statunitensi di una carta American Express Business abbonati a Perplexity Enterprise. Il dirigente sceglie un’attività e ne specifica i dettagli in un modulo invece di scrivere una richiesta. Le dieci Skills coprono la previsione dei flussi di cassa, la preparazione fiscale, il confronto dei fornitori, gli scenari di bilancio, la riconciliazione, le campagne marketing, la previsione della domanda, il ritorno sulla spesa pubblicitaria per canale (ROAS), il monitoraggio delle operazioni e il reclutamento. La carta si collega tramite Plaid da Personal CFO, e ogni esecuzione consuma crediti Computer in base alla complessità dell’attività. La pagina del partner aggiunge, fino al 29 marzo 2027, un credito una tantum di 125 dollari per un acquisto di almeno 325 dollari di un piano Enterprise Pro o Enterprise Max, e 1 000 crediti Computer offerti una sola volta per account. Le carte Corporate sono escluse, e i risultati non costituiscono consulenza finanziaria, fiscale, legale o contabile.
🔗 Post di Perplexity · Pagina del partner American Express
Video generativi e avatar: Wan 3.0 in testa ad Artificial Analysis, Project Continuum di Runway, Sessions di Synthesia
Wan 3.0 conquista il primo posto nella nuova classifica video di Artificial Analysis
1° ottobre — Alibaba rivendica il primo posto di Wan 3.0 nella nuova classifica da testo a video di Artificial Analysis, AA-Video-T2V v2.0, lanciata il 30 settembre con una nuova metodologia: ogni modello viene valutato in 1080p su un insieme di prompt aggiornato regolarmente, e la sincronizzazione del suono contribuisce al punteggio. Il podio è molto serrato, con intervalli di confidenza che si sovrappongono.
| Modello in classifica | Punteggio Elo | Intervallo di posizione | Prezzo tramite API |
|---|---|---|---|
| Wan 3.0 | 1157 (±9) | 1 a 2 | 12,00 dollari al minuto |
| Utopai X (costruito su MiniMax H3) | 1150 (±10) | 1 a 3 | Nessuna API pubblica |
| Dreamina Seedance 2.5 | 1144 (±9) | 2 a 4 | 34,12 dollari al minuto |
| MiniMax H3 (768p) | 1139 (±9) | 3 a 5 | 4,80 dollari al minuto |
La sorpresa della classifica è Utopai X, lanciato il 30 settembre da Utopai Studios, uno studio cinematografico e televisivo nato intorno all’IA. Sottoposto a post-addestramento su MiniMax H3, è accessibile solo nella piattaforma PAI dello studio (93 crediti per secondo di video, abbonamenti a partire da 15 dollari al mese), e supera lo stesso MiniMax H3.
🔗 Annuncio di @Alibaba_Wan su X · Classifica AA-Video-T2V v2.0 · Utopai X secondo @ArtificialAnlys
Runway Labs presenta Project Continuum, interfacce generate in video in tempo reale
1° ottobre — Runway Labs, l’unità di ricerca esplorativa di Runway, mostra Project Continuum, un’applicazione di ricerca che immagina un sistema operativo la cui interfaccia verrebbe generata in video, in tempo reale, sulla scia di Solaris, il modello di mondo per interfacce presentato il 31 agosto. Questa prima anteprima descrive quattro modi di interagire con il proprio computer. Con Portals, un modello video genera durante la navigazione sovrapposizioni animate e interattive, con bordi sfumati per segnalare il contenuto generato. Le interfacce video reattive (Responsive Video Interfaces) si riconfigurano quando vengono ridimensionate e rispondono ai clic. Interactive Worlds trasforma un contenuto multimediale in una simulazione interattiva, sia per persone sia per agenti. Visual Thinking, infine, è un harness per agenti di coding: un modello video in tempo reale visualizza ogni passaggio e ogni chiamata a uno strumento, per mantenere l’utente coinvolto nel processo. Runway non fornisce né accesso, né una data, né un prezzo, né informazioni sul modello sottostante.
Synthesia lancia Sessions, avatar che formano e intervistano
1° ottobre — Synthesia lancia Sessions, una famiglia di prodotti costruita sui suoi avatar interattivi: una videochiamata in cui l’interlocutore è un avatar che pone domande, ascolta, controbatte e sintetizza. Roleplay Sessions serve per la formazione: l’avatar interpreta un cliente, un prospect o un collaboratore, un coach IA commenta ogni tentativo e i manager seguono punteggi e progressi in una dashboard. Survey Sessions trasforma il questionario in un’intervista: l’avatar intervista centinaia di persone in parallelo, pone domande di approfondimento in base alle risposte, poi fornisce un rapporto sui temi e sul sentiment, mentre ogni risposta resta consultabile come trascrizione, audio o CSV. Viene proposta una prova gratuita, senza prezzi dettagliati. Sessions si basa sull’Interactive Avatar API, resa generalmente disponibile il 16 settembre, e Synthesia promette altre varianti.
🔗 Annuncio di @synthesiaIO su X · Pagina Synthesia Sessions
IA e scienza: SynthID Bio marca le proteine, Matthew Schwartz descrive una scienza «a forma di Claude»
SynthID Bio: Google DeepMind marca le proteine progettate dall’IA
30 settembre — Google DeepMind presenta SynthID Bio, una famiglia di metodi di marcatura digitale (watermarking) per le creazioni biologiche generate dall’IA, ripresa su X il 1° ottobre. Il post la presenta come una prova di concetto: una firma impercettibile viene inserita nel codice biologico, verificabile sia sul modello digitale sia sulla proteina sintetizzata. Per le sequenze, il metodo orienta discretamente la scelta degli amminoacidi; per le strutture 3D, viene affinata una piccola parte della rete di diffusione di AlphaFold 3. In laboratorio, su tre bersagli (VEGF-A, il dominio RBD della proteina spike del SARS-CoV-2 e PD-L1), le molecole leganti marcate hanno eguagliato le versioni classiche per tasso di successo, affinità e diversità di sequenza. La questione è la biosicurezza: un segnale automatico aiuterebbe i fornitori di sintesi di ADN a verificare l’origine di una sequenza sconosciuta. Google DeepMind pubblica il suo articolo sui metodi, il codice, i dati in vitro e i pesi per la ricerca; insieme al Hie lab di Stanford e all’Arc Institute, l’approccio si estende già al genoma di un batteriofago progettato da Evo 2. La robustezza di fronte a un’alterazione deliberata resta il principale ambito di lavoro.
🔗 Post di Google DeepMind su SynthID Bio
La scienza «a forma di Claude»: il post ospite di Matthew Schwartz
1° ottobre — Il blog Anthropic Science pubblica un post ospite di Matthew Schwartz, fisico a Harvard, che precisa di lavorare come ricercatore ospite presso Anthropic. Vi descrive un «disadattamento di impedenza» tra scienziati e IA: lavorare con un modello come con un collaboratore umano non permette di trarne il meglio, ed è preferibile cercare problemi «a forma di Claude», in cui una tecnica nota di matematica, fisica o informatica risolve in un colpo solo una questione di un altro campo. Da questo approccio ha ricavato BootLoops, un harness open source per il calcolo esatto utilizzabile con qualsiasi modello; BootLoops non è un progetto Anthropic, è Schwartz a mantenerlo. In fisica, 30 integrali sono stati trattati dall’inizio alla fine, di cui 15 mai calcolati prima; in ecologia, gli alberi di Barro Colorado Island cambiano 4,5 volte più velocemente di quanto consenta la teoria neutrale; in linguistica, la base AccStack copre l’accento lessicale di 6 072 lingue. Risultato: 36 manoscritti in 18 campi con 19 coautori in tre mesi. Schwartz segnala anche i limiti: Claude non ha il senso del tempo, ama «dichiarare vittoria», e i suoi risultati al di fuori della fisica restavano poco interessanti prima che un esperto li riorientasse.
🔗 Scienza a forma di Claude (blog Anthropic Science)
Modelli aperti e addestramento: Olmo-core 3 di Ai2, Clef e Clef-flash di Cloudflare, il RL con più harness di FineEnvs
Olmo-core 3: Ai2 apre uno stack di addestramento MoE che punta a oltre mille miliardi di parametri
1° ottobre — Ai2 pubblica Olmo-core 3, una nuova versione del framework che addestra i suoi modelli Olmo, ricostruita intorno a un sistema di addestramento a miscela di esperti (mixture-of-experts, MoE) completamente aperto. È uno dei sistemi della prossima generazione di Olmo, che passerà al MoE e dovrebbe diventare, secondo Ai2, la più capace tra le generazioni di Olmo. La vecchia implementazione, basata su FSDP, riuniva e poi ripartiva i pesi a ogni batch; Olmo-core 3 passa a DDP, mantiene gli esperti sulle loro GPU e invia loro i dati.
| Misura pubblicata da Ai2 | Valore misurato |
|---|---|
| MoE da 47 miliardi di parametri su otto B300, test preliminare | 52 000 contro 19 400 tokens/s per GPU, circa 2,7 volte |
| MXFP8 contro BF16, su quattro B300 | Circa il 21 % di throughput in più |
| Modello da 1 200 miliardi di parametri su 512 GPU | 858 TFLOP/s per GPU al massimo, routing casuale |
Ai2 precisa che la misura a 1 200 miliardi di parametri valuta il sistema, non la qualità di un modello addestrato. Sono pubblicati il codice (versione 3.0.0), il rapporto tecnico e una dimostrazione interattiva.
🔗 Post di Ai2 su Olmo-core 3 · Release Olmo-core v3.0.0
Clef e Clef-flash: Cloudflare rende aperti due modelli decisionali compatibili con Jev
1° ottobre — Il team Workers AI di Cloudflare pubblica Clef e Clef-flash, i suoi primi modelli addestrati internamente, nel filone inaugurato da Jev, il modello System One di Typesafe AI: ricevono uno stato (testo, JSON, immagine o video) e uno schema di domande tipizzate, poi restituiscono in un unico passaggio una probabilità per ogni opzione consentita. Clef è sottoposto a post-training a partire da Qwen3.8-27B, Clef-flash si basa su Qwen3.5-9B. Ospitati su Workers AI con un’API compatibile con quella di Jev, sono pubblicati su Hugging Face con licenza Apache 2.0 secondo il post, con una finestra di 64k tokens contro i 32k di Jev. I dati, scelti da Cloudflare, mostrano risultati contrastanti:
| Benchmark e metrica | Punteggio di Clef | Punteggio di Clef-flash | Punteggio di Jev |
|---|---|---|---|
| BFCL, casi esatti | 98,47 | 98,76 | 95,75 |
| BANKING77, macro-F1 | 94,20 | 90,93 | 79,74 |
| When2Call, accuratezza | 72,37 | 65,58 | 80,97 |
| BRIGHT, nDCG@10 | 45,91 | 39,26 | 47,52 |
| Latenza mediana | 209,3 ms | 38,8 ms | 524,1 ms |
Cloudflare afferma che Clef è in testa al Jev Decision Index, una posizione che Liquid AI rivendicava per d1 due giorni prima, e lancia un servizio di fine-tuning per rinforzo di Clef sui dati del cliente.
🔗 Post di Cloudflare su Clef · Clef su Hugging Face
FineEnvs addestra un modello per rinforzo in quattro harness per agenti contemporaneamente
1° ottobre — Uno stesso modello si comporta diversamente a seconda dell’harness che lo guida: i pesi di LFM2.5-2.6B, di Liquid AI, risolvono il 62 % dei compiti con Mini-SWE-Agent ma il 33 % con Claude Code. L’organizzazione FineEnvs pubblica su Hugging Face una guida per addestrare un modello tramite apprendimento per rinforzo direttamente negli harness degli sviluppatori, senza modificarne il codice. Un proxy di acquisizione aggiunto a OpenEnv si presenta all’harness come un fornitore di modelli (formati OpenAI, Anthropic o Gemini) e registra i tokens e le probabilità esatte prodotti da vLLM; Harbor fornisce compiti e sandbox, TRL esegue l’addestramento con GRPO asincrono. Addestrato in quattro harness contemporaneamente, LFM2.5-2.6B passa in media dal 42 % al 54 %, e un piccolo premio per le soluzioni efficienti riduce del 31 % le sue chiamate agli strumenti nei compiti già risolti. Imitare un modello più grande non basta: un fine-tuning supervisionato su 3 189 rollouts di Qwen3.8-27B si ferma al 47,5 %. Proxy, trainer, compiti, dati e modelli addestrati sono pubblicati.
🔗 La guida definitiva al RL multi-harness
Grok 4.7 in anteprima sulla piattaforma di agenti di Google Cloud
1° ottobre — SpaceXAI annuncia che Grok 4.7 è disponibile su Gemini Enterprise Agent Platform, la piattaforma di agenti di Google Cloud. La scheda del modello, datata 30 settembre, lo presenta in anteprima con l’identificativo grok-4.7 e lo descrive come un modello di xAI progettato per il codice e il lavoro della conoscenza, che dedica più tempo ai compiti difficili e verifica il proprio lavoro. Accetta testo e immagini in input e restituisce soltanto testo; sono supportati le chiamate di funzione, l’output strutturato e il ragionamento, ma non le predizioni in batch.
| Dato pubblicato da Google Cloud | Valore per Grok 4.7 |
|---|---|
| Lunghezza del contesto | 524 288 tokens |
| Quote al minuto | 13 richieste, 188 000 tokens di input e 16 000 tokens di output |
| Tipi di utilizzo | Solo quota fissa, né pagamento a consumo né throughput provisionato |
| Regioni del servizio | Multiregione Stati Uniti ed endpoint globale |
| Prezzo per milione di tokens | 2 dollari in input, 6 in output, 0,50 in cache sotto i 200 000 tokens di input, il doppio oltre tale soglia |
Il listino riprende quello dell’API xAI. Lanciato il 21 settembre, Grok 4.7 era arrivato su Amazon Bedrock il 28 settembre, e Grok 4.6 era approdato sulla stessa piattaforma Google il 21 agosto.
🔗 Scheda di Grok 4.7 su Google Cloud · Annuncio di @SpaceXAI su X
GitHub inasprisce le regole per la segnalazione privata di vulnerabilità di fronte ai report generati dall’IA
1° ottobre — GitHub pubblica nello stesso minuto due misure per la segnalazione privata di vulnerabilità (private vulnerability reporting), con una constatazione comune: i maintainer open source ricevono sempre più report di scarsa qualità, automatizzati o generati dall’IA, che sommergono quelli che contano.
A single free-text box made it easy to submit low-quality or AI-generated reports and hard for you to find the signal in them.
🇮🇹 Una semplice area di testo libero facilitava l’invio di report di scarsa qualità o generati dall’IA e vi rendeva difficile individuare gli elementi essenziali al loro interno. — GitHub Changelog, Moduli strutturati per le segnalazioni private di vulnerabilità
Un modulo strutturato. Per impostazione predefinita, il segnalatore deve compilare quattro campi obbligatori: un riepilogo, i dettagli, una prova di concetto di almeno 150 caratteri e l’impatto, che vengono riuniti nella descrizione dell’avviso di sicurezza che il maintainer rilegge come prima. Ogni repository può personalizzare il modulo con un file .github/VULNERABILITY_REPORT.yml, oppure applicarlo a tutti i propri repository tramite il repository .github dell’organizzazione; i maintainer possono richiedere una categoria CWE, requisito che un’organizzazione o un’azienda può imporre tramite policy. Una casella consente al segnalatore di dichiarare di essersi fatto aiutare dall’IA per individuare il problema o redigere il report. Per l’API REST si applica anche un modulo personalizzato, ma non quello predefinito, per non compromettere le integrazioni esistenti.
Un limite giornaliero. Il numero di nuovi report che uno stesso account può inviare ogni giorno è ora limitato, sia verso un singolo repository sia sull’insieme di GitHub; i commenti sugli avvisi esistenti non sono interessati. Gli amministratori possono impostare un proprio limite ed esentare i segnalatori fidati, e GitHub non quantifica il limite predefinito. Le due misure riguardano i repository pubblici che hanno attivato la segnalazione privata, su GitHub Free, Pro, Team ed Enterprise Cloud.
🔗 Limiti di frequenza per le segnalazioni private di vulnerabilità
Agenti di codice: Codex CLI 0.160.0, Delta 0.18 e Antigravity 2.19.1
Codex CLI 0.160.0: la cronologia del centro di comando e le sessioni fuori progetto
1° ottobre — OpenAI pubblica Codex CLI 0.160.0, la prima versione stabile dalla 0.159.3 del giorno prima, con 55 PR elencate a partire dalla 0.159.0. Il centro di comando degli agenti (agent command center) aggiunge un’azione per visualizzare i compiti più vecchi (Mostra altro), utilizzabile da tastiera. Le sessioni possono avviarsi fuori da un progetto, con le impostazioni predefinite dello spazio di lavoro quando la policy dell’organizzazione lo consente, e le autorizzazioni salvate vengono ripristinate alla ripresa. La revisione delle approvazioni Guardian riceve due funzionalità opzionali: recuperare istruzioni fornite in precedenza dall’utente e integrare il contesto dei passaggi di consegne tra agenti. A schermo intero, i terminali Linux X11 locali consentono di selezionare la trascrizione e incollare con un clic del pulsante centrale. Per quanto riguarda le correzioni, i messaggi in coda riprendono dopo una riconnessione senza essere inviati due volte, e una serie di correzioni riguarda la sandbox Windows e i blocchi di SQLite durante l’inizializzazione.
Delta 0.18: i thread girano nei worktrees Git esistenti e arriva una CLI
30 settembre — Zed pubblica la versione 0.18.0 di Delta, il suo ambiente multigiocatore per programmare con gli agenti: 23 novità, 41 miglioramenti, 51 correzioni e una rimozione. La novità principale era stata annunciata senza una data il 28 settembre: un thread può ora girare in qualsiasi worktree Git esistente già collegato e passare questa copia di lavoro ai nuovi thread creati a partire da esso. Delta si può controllare anche dal terminale: una CLI delta si installa su macOS, Windows e Linux, e i comandi delta auth gestiscono l’account connesso. Per quanto riguarda i modelli, la versione aggiunge i modelli Gemini di Google AI Studio, rende disponibili GPT-6 Sol, GPT-6 Luna e Claude Opus 5.5 con una chiave API e accetta nell’applicazione desktop qualsiasi fornitore compatibile con OpenAI o Anthropic. Il lavoro nei thread aggiunge una ricerca in tutti i sottothread e i segnalibri; i sottothread, però, non pubblicano più i loro messaggi di avanzamento nel thread principale, dove restano visualizzati soltanto i risultati di Land Changes.
🔗 Note di rilascio di Delta 0.18.0
Antigravity 2.19.1: scrivere direttamente ai sottoagenti
30 settembre — Antigravity 2.19.1 permette di inviare un messaggio direttamente a un sottoagente dalla casella di testo, senza passare dall’agente principale; la CLI lo consentiva già con la sua sintassi @ dalle versioni 1.2.8 e 1.2.9. La versione aggiunge l’esportazione in PDF del Markdown visualizzato negli artefatti e nel pannello laterale, comprese tabelle, blocchi di codice e diagrammi, e un’opzione di annullamento limitata alla conversazione; tra le sue cinque correzioni, gli agenti personalizzati rispettano finalmente le regole globali e quelle del progetto. La distribuzione è graduale e può richiedere qualche giorno. La CLI aveva ricevuto il 27 settembre una versione 1.2.12 passata inosservata: una sessione avviata con una chiave GEMINI_API_KEY ora si interrompe immediatamente quando l’API Gemini segnala l’esaurimento della quota giornaliera, il raggiungimento di un limite di spesa o l’esaurimento dei crediti prepagati, invece di continuare per diversi minuti con tentativi destinati a fallire.
🔗 Changelog dell’applicazione Antigravity · Changelog della CLI Antigravity
Notizie in breve
- Copilot CLI 1.0.90 e 1.0.91 — La 1.0.90 passa al canale stabile il 30 settembre con GPT-6.1 Sol nel selettore dei modelli e correzioni per MCP e la ripresa delle sessioni; la 1.0.91, il 1º ottobre, aggiunge i comandi
copilot sandbox caper gestire il certificato del proxy della sua sandbox. 🔗 fonte - Codex CLI 0.159.3 — Pubblicata il 30 settembre alle 22 h 57 UTC, contiene un solo backport: le sessioni locali autenticate con ChatGPT possono mostrare promemoria facoltativi per completare la configurazione della sicurezza dell’account, una modifica ripresa nella 0.160.0. 🔗 fonte
- Nightly di Gemini CLI — La v0.64.0-nightly del 1º ottobre corregge un blocco con utilizzo del processore al 100 % in modalità headless e rende atomiche le scritture degli strumenti per i file; la versione stabile e quella di anteprima restano invariate. 🔗 fonte
- Zed 1.23.1 in anteprima — Pubblicata il 30 settembre, visualizza i file JSONL e NDJSON in forma di tabella, aggiunge l’impostazione
agent.max_idle_retained_threadse ritenta automaticamente le richieste quando un modello Google AI è sovraccarico. 🔗 fonte - Copilot in VS Code a settembre — Il riepilogo mensile delle versioni da 1.136 a 1.140 segnala alcune novità passate inosservate, tra cui la ripresa in VS Code di una conversazione Codex iniziata nell’app ChatGPT, un badge dell’app in anteprima e chat aperte senza un workspace. 🔗 fonte
- Pianificare insieme in Delta — Sul blog di Delta, Nathan Sobo racconta come tre membri del team pianificano nello stesso thread con Fable e poi Astra, un thread secondario e un sottoagente isolati, anziché in un file
plan.md; non viene annunciata alcuna nuova funzione. 🔗 fonte - Innate in un video di Cursor — Cursor pubblica un breve ritratto video di Innate, un team di sette persone che costruisce robot per la vita quotidiana e il cui cofondatore Vignesh Anand afferma che svolge il lavoro di 50 persone, senza precisare come utilizzi Cursor. 🔗 fonte
- Richiamare invece di compattare — David Corvoysier, sviluppatore di funes, misura con Claude Code che richiamare la vecchia sessione tramite il suo strumento permette di trovare le risposte corrette con un numero di tokens ponderati rispettivamente 8, 4 e 3 volte inferiore rispetto a mantenere tutto il contesto, su tre attività scelte da lui stesso. 🔗 fonte
- Nuova dashboard di GitHub — La vista che riunisce sessioni di agenti attive, issues e pull requests, con un massimo di 12 elementi per lista, diventa la vista predefinita per tutti; il feed delle notizie passa in una scheda Feed e la vecchia visualizzazione resta accessibile. 🔗 fonte
- API di merge asincrono — Diventa generalmente disponibile ed è ora il metodo consigliato per eseguire merge via codice, al posto dell’endpoint REST sincrono e delle mutazioni GraphQL; è l’unica API di merge che gestisce le pull requests impilate. 🔗 fonte
- Dist-tags npm senza token — Le configurazioni di pubblicazione attendibile di npm possono ricevere un’autorizzazione facoltativa, disattivata per impostazione predefinita, per gestire i dist-tags con credenziali OIDC di breve durata anziché con un token di accesso di lunga durata. 🔗 fonte
- Conservazione in GitHub Actions — Checks, esecuzioni di workflow e stati, compresi quelli di applicazioni di terze parti, seguono ora l’impostazione di conservazione degli artefatti e dei log e vengono eliminati allo scadere del periodo previsto, con un massimo di 90 giorni per i repository pubblici e senza possibilità di ripristino. 🔗 fonte
- Code scanning e repository inattivi — Le analisi settimanali pianificate di code scanning e GitHub Code Quality si avviano ora solo dopo un’analisi attivata da un push o da una pull request, per evitare che un repository inattivo sembri attivo per altri sei mesi. 🔗 fonte
- Copertura del codice — L’action
upload-code-coveragedi GitHub Code Quality non fa più fallire la CI al push su un branch per cui non è ancora aperta una pull request. 🔗 fonte - Dichiarazioni di accessibilità — Un file
ACCESSIBILITY.mdcollocato nella directory radice, in.github/o indocs/viene messo in evidenza sulla pagina iniziale del repository, con tutti i piani di github.com, e arriverà in GitHub Enterprise Server 3.24. 🔗 fonte - Actions Runner Controller 0.15.0 — Il controller Kubernetes dei runners self-hosted aggiorna le risorse sul posto durante gli aggiornamenti patch, rende configurabili il tempo di arresto, i limiti del client Kubernetes e la concorrenza dei controller, e alleggerisce le proprie richieste. 🔗 fonte
- Grok Bot prende l’iniziativa — Il Bot principale dell’utente individua ora il lavoro che può svolgere al suo posto e propone di occuparsene; il rilascio avviene nell’arco di alcune ore e questi suggerimenti non vengono conteggiati nell’utilizzo, senza indicazioni su piani o paesi. 🔗 fonte
- Genspark e Azure Cosmos DB — Un post sul blog Azure Cosmos DB, scritto dal punto di vista di Genspark, spiega come alcune elaborazioni in background utilizzino indici secondari globali per non rallentare più le sessioni di agenti in tempo reale; non vengono forniti numeri. 🔗 fonte
- Testimonianza su Genspark — Seulki Kang, con quindici anni di esperienza nel marketing, afferma di preparare una serie completa di materiali didattici in 5 ore anziché 30 collegando i suoi vecchi documenti a SecondBrain e poi ad AI Slides; nessuna novità di prodotto. 🔗 fonte
- Albertsons e OpenAI — La catena con oltre 2 200 negozi estende la propria partnership, da ChatGPT Enterprise per team selezionati all’API per le esperienze dei clienti e le analisi promozionali, e mette in evidenza il proprio plugin Safeway in ChatGPT, annunciato il 5 agosto. 🔗 fonte
- Il complemento eterno — OpenAI pubblica il primo saggio di una serie sull’economia futura, firmato da Hemanth Asirvatham ed Elliott Mokski, che precisano di parlare a titolo personale: gran parte dell’intelligenza delle macchine potrebbe servire all’esecuzione più che alle scoperte rivoluzionarie. 🔗 fonte
- Perplexity e i consulenti — Una guida confronta dieci strumenti di IA per consulenti, da AlphaSense a Qwilr, con prezzi verificati a settembre; la sua FAQ ricorda che con il piano gratuito Perplexity addestra i propri modelli sui dati degli utenti, salvo opposizione. 🔗 fonte
- Luma Variants — Presentata il giorno precedente senza dettagli, la funzione viene lanciata per tutti gli utenti di Luma: a partire da una pubblicità statica approvata, ne produce le varianti in cinque formati standard, da 9:16 a 16:9, e in più lingue, senza prezzi annunciati. 🔗 fonte
- HeyGen Professional Voice Clone — Secondo il suo riepilogo di settembre, HeyGen rende disponibile tramite API il suo clone vocale più fedele, addestrato su almeno 20 minuti di registrazioni (da 1 a 10 file), dopo un’anteprima privata avviata il 9 settembre. 🔗 fonte
- Pika e le sue applicazioni — Pika dichiara di avere oltre 40 applicazioni sulla sua nuova piattaforma e ne presenta due, Podcast Video, che fa dibattere due personaggi, e Color Grade, che applica il color grading a un’immagine o a una clip, senza data né prezzo. 🔗 fonte
- ElevenLabs nel Benelux — ElevenLabs apre uffici a Bruxelles e ad Amsterdam e prevede di triplicare gli organici; presso l’operatore KPN, il riconoscimento dei codici postali passa dal 64 % all’82 % e l’agente di verifica gestisce circa 60 000 chiamate a settimana. 🔗 Paesi Bassi · 🔗 Belgio
- Skills DOCA di NVIDIA — Su 65 prompts reali di sviluppatori, gli agenti di codice dotati di queste skills per le DPU BlueField soddisfano il 100 % dei criteri della griglia di valutazione, contro il 19 % senza; sono pubblicate su GitHub. 🔗 fonte
- DIN Deploy — NVIDIA pubblica esempi C++ open source per eseguire modelli in locale con ONNX Runtime e TensorRT RTX, su Windows e Linux; su un DGX Spark, Parakeet TDT trascrive 206 volte più velocemente del tempo reale sulla GPU, contro 14 volte sulla CPU. 🔗 fonte
- Nemotron 3.5 ASR e dialetti sauditi — Un tutorial di NVIDIA esegue il fine-tuning del modello sui dialetti najdi e hijazi: il tasso di errore per parola passa dal 55,05 % al 29,96 % in 12 000 passi su due RTX PRO 6000, con un lieve miglioramento anche per l’inglese e l’arabo di FLEURS. 🔗 fonte
- Sistema di raccomandazione HSTU su Dynamo-Triton — NVIDIA serve un sistema di raccomandazione generativo HSTU con PyTorch AOTInductor e una cache KV: nel caso migliore, su una RTX PRO 6000, fino a 4,47 e 5,93 volte più veloce in base al numero di layer, ossia 0,423 e 0,678 ms per richiesta. 🔗 fonte
- Redditività delle fabbriche di IA — In un post di opinione, NVIDIA valuta il costo di una fabbrica di IA in circa 60 milioni di dollari per megawatt e riprende i dati di SemiAnalysis: Vera Rubin NVL72 costa fino a 45 volte meno per milione di tokens rispetto a GB300 NVL72 su DeepSeek V4 Pro, contro le 35 volte del 24 agosto. 🔗 fonte
- huggingface_hub 2.1.0 — La libreria riavvia automaticamente i Jobs falliti, li riprogramma senza ricrearli, legge la quota ZeroGPU residua e scarica i file Xet tramite
hf_xet: un parquet da 2 Go passa da circa 120 a 7 secondi su HF Jobs; tre modifiche incompatibili. 🔗 fonte - ML Intern e MCP — Hugging Face collega fonti di dati MCP a ML Intern, la modalità di HuggingChat che addestra modelli, per effettuare il fine-tuning di modelli aperti sui propri dati aziendali; l’annuncio non è accompagnato da cifre ufficiali. 🔗 fonte
- Hugging Face e l’Open Source for Science Fund — I due partner vogliono individuare le librerie da cui dipendono maggiormente i contributori di modelli scientifici e sostenere i loro maintainer, senza indicare importi né tempistiche. 🔗 fonte
- Un milione di addestramenti con TRL — Secondo la telemetria citata da Quentin Gallouédec, la libreria di post-training di Hugging Face registra un milione di addestramenti al mese, con l’obiettivo di un milione a settimana; il metodo di conteggio non è pubblicato. 🔗 fonte
- Il milione di dataset dell’Hub — Tre autori mostrano che gli account delle organizzazioni pubblicano circa il 19 % dei dataset ma raccolgono metà dei download, e che gli Stati Uniti detengono 390 dei 1 000 dataset più scaricati. 🔗 fonte
- Otto VLM su una RTX 3090 — Aakash Gupta, di ThinkEvolve, mostra che, a parità di accuratezza, Qwen3-VL-8B elabora ogni richiesta 2,2 volte più velocemente di Qwen3.8-27B ma impiega 18,88 ore contro 7,53 per un lavoro di 7 329 chiamate, perché non riutilizza la cache del prefisso. 🔗 fonte
- GLiNER2.5-Decide a confronto con layax — Aravind Vijayakumar non riesce a certificare alcuna soglia di confidenza per il modello di Fastino, contro 10 prove su 10 per layax, il suo strumento, più accurato con un margine tra 20 e 23 punti e circa cinque volte più veloce. 🔗 fonte
- David Ha e gli orchestratori — In un editoriale per Nikkei Asia, il cofondatore e CEO di Sakana AI ritiene che il valore passerà dai pesi di un modello all’intelligenza che combina più modelli, e definisce la sovranità come la solidità della catena di approvvigionamento. 🔗 fonte
- Diffusione video su TPU — Tre ingegneri di Google riducono il tempo di denoising di un video 1440p da 2 471 a 1 461 secondi su otto chip TPU v6e, con una velocità 1,69 volte maggiore, grazie all’attenzione sparsa di Sparse VideoGen e a un kernel Splash Attention ottimizzato. 🔗 fonte
Che cosa significa
Gli agenti di codice diventano programmabili da chi li usa. Con i mods, Claude Code espone i propri eventi interni a piccole funzioni TypeScript, fino a trasformare le proprie funzioni in mods sostituibili; con i workflows dinamici, GitHub fa scrivere nel codice l’orchestrazione dei sottoagenti, anziché lasciare che Copilot decida ogni volta come suddividere il lavoro. La guida di FineEnvs ricorda perché l’harness conta quanto il modello: gli stessi pesi risolvono il 62 % delle attività in un harness e il 33 % in un altro. La contropartita è la fiducia. Un mod ha lo stesso accesso alla macchina di Claude Code, copilot workflow run non mostra alcun prompt, e il controllo delle applicazioni desktop può agire su account autenticati. I due fornitori rispondono disabilitando per impostazione predefinita il controllo del desktop, con una verifica prima dell’installazione (claude plugin validate) per i mods e con regole aziendali che hanno la precedenza.
L’IA impone anche nuovi filtri a chi ne riceve i contenuti prodotti. GitHub struttura e limita le segnalazioni private di vulnerabilità perché i report generati dall’IA sommergono i maintainer; Google DeepMind propone di applicare un watermark alle proteine progettate dall’IA perché i fornitori di sintesi del DNA sappiano da dove proviene una sequenza sconosciuta. In entrambi i casi, l’obiettivo non è vietare l’IA ma renderne visibile l’uso: una casella per dichiarare l’aiuto dell’IA da un lato, una firma verificabile dall’altro.
Per le aziende, l’adozione si misura ormai in utilizzi specifici. Barclays fissa l’obiettivo di portare il 50 % degli sviluppatori su Claude Code entro la fine del 2026 e fa smistare 120 000 e-mail al giorno, American Express fa della propria carta Business una porta d’accesso alle Skills di Perplexity Computer, offrendo anche crediti, e Anthropic usa i propri limiti di utilizzo come leva, dimezzando per due settimane il consumo legato al lavoro che segue la creazione di un artefatto. Per il grande pubblico, gli assistenti entrano in attività concrete: leggere un menu a una persona cieca, provare un capo d’abbigliamento prima di acquistarlo, tracciare un grafico di borsa nella conversazione.
I numeri dei modelli, infine, vanno letti insieme al loro protocollo. Ai2 precisa che la sua misurazione a 1 200 miliardi di parametri valuta il sistema e non un modello addestrato, Cloudflare sceglie i propri benchmark e riconosce che Jev resta in vantaggio su When2Call e BRIGHT, e la classifica video di Artificial Analysis colloca Wan 3.0 al primo posto con intervalli di confidenza che si sovrappongono. FLUX 3 Image segue un percorso ormai comune: pesi commerciali su licenza subito, pesi aperti in seguito, senza una data.
Fonti
- Personalizza Claude Code con mods in TypeScript (claude.com)
- Guida introduttiva ai mods su claude.dev
- Documentazione dei mods di Claude Code
- Reazione di Boris Cherny su X
- Note di rilascio di Claude Code 2.1.287
- Changelog GitHub sul controllo delle applicazioni desktop
- Changelog GitHub sui workflows dinamici
- Annuncio di FLUX 3 Image da parte di @bfl_ai
- Pagina del modello FLUX 3 Image
- Guided Vision in Gemini Live (blog Google)
- Note di rilascio di ChatGPT
- Grafici interattivi di Perplexity Computer
- Offerta sugli artefatti annunciata da @claudeai
- Condizioni dell’offerta sugli artefatti (centro assistenza Claude)
- Barclays e Claude (Anthropic)
- Articolo di Perplexity su American Express
- Pagina di Perplexity dedicata al partner American Express
- Annuncio di Wan 3.0 da parte di @Alibaba_Wan
- Classifica AA-Video-T2V v2.0 di Artificial Analysis
- Utopai X nella classifica di Artificial Analysis
- Project Continuum di @runwayml
- Annuncio di Sessions da parte di @synthesiaIO
- Pagina di Synthesia Sessions
- SynthID Bio (Google DeepMind)
- Scienza plasmata da Claude (Anthropic Science)
- Olmo-core 3 (Ai2)
- Release Olmo-core v3.0.0
- Clef e Clef-flash (blog Cloudflare)
- Clef su Hugging Face
- Guida al RL con più harness di FineEnvs
- Scheda di Grok 4.7 su Google Cloud
- Annuncio di Grok 4.7 su Google Cloud da parte di @SpaceXAI
- Moduli strutturati per le segnalazioni private di vulnerabilità
- Limiti giornalieri delle segnalazioni private di vulnerabilità
- Codex CLI 0.160.0
- Note di rilascio di Delta 0.18.0
- Changelog dell’applicazione Antigravity
- Changelog della CLI Antigravity
- Copilot CLI 1.0.91
- Codex CLI 0.159.3
- Nightly di Gemini CLI del 1° ottobre
- Anteprima di Zed 1.23.1
- Riepilogo di settembre di Copilot in VS Code
- Pianificare in gruppo in Delta
- Profilo di Innate a cura di Cursor
- Banco di prova per il richiamo delle sessioni con funes
- Nuova dashboard GitHub
- API di merge asincrono di GitHub
- Dist-tags e pubblicazione attendibile di npm
- Conservazione di GitHub Actions
- Code scanning e repository inattivi
- Invii della copertura del codice
- Dichiarazioni di accessibilità dei repository
- Actions Runner Controller 0.15.0
- Suggerimenti di Grok Bot
- Genspark e Azure Cosmos DB
- Testimonianza di Seulki Kang (Genspark)
- Albertsons Companies e OpenAI
- Il complemento eterno (OpenAI)
- Guida di Perplexity agli strumenti di IA per consulenti
- Luma Variants
- Riepilogo di settembre di HeyGen
- Applicazioni di Pika
- ElevenLabs nei Paesi Bassi
- ElevenLabs in Belgio
- Skills DOCA di NVIDIA
- DIN Deploy di NVIDIA
- Nemotron 3.5 ASR e dialetti sauditi
- Sistema di raccomandazione HSTU su Dynamo-Triton
- Redditività delle fabbriche di IA (NVIDIA)
- huggingface_hub 2.1.0
- ML Intern e fonti di dati MCP
- Open Source for Science Fund e Hugging Face
- Un milione di addestramenti con TRL
- Il milione di dataset dell’Hub
- Otto VLM valutati su una RTX 3090
- GLiNER2.5-Decide a confronto con layax
- Editoriale di David Ha condiviso da Sakana AI
- Diffusion video accelerata su TPU