ai-powered-markdown-translatorgpt-6.1-sol을 사용해 프랑스어에서 한국어로 번역한 기사.
목요일인 10월 1일, Anthropic은 Claude Code의 이벤트에 연결되어 동작과 인터페이스를 다시 정의하는 작은 TypeScript 함수인 모드를 출시했으며, 버전 2.1.287에 포함했다. GitHub도 같은 날 Copilot CLI와 GitHub Copilot 앱에서 두 가지 에이전트 기능을 공개 미리 보기로 제공했다. 데스크톱 애플리케이션 제어와 코드로 작성한 작업 조율 방식인 동적 워크플로다. Black Forest Labs는 경계 상자로 구도를 구성하고 최대 4K로 이미지를 생성하는 FLUX 3 Image를 출시했다. Google은 Gemini Live에 Guided Vision을 배포하고, Barclays는 은행 전반으로 Claude 도입을 확대하며, GitHub는 인공지능이 생성한 보고서에 대응해 취약점 신고 기준을 강화했다.
Claude Code에 모드 도입, 동작과 인터페이스를 다시 정의하는 TypeScript 함수
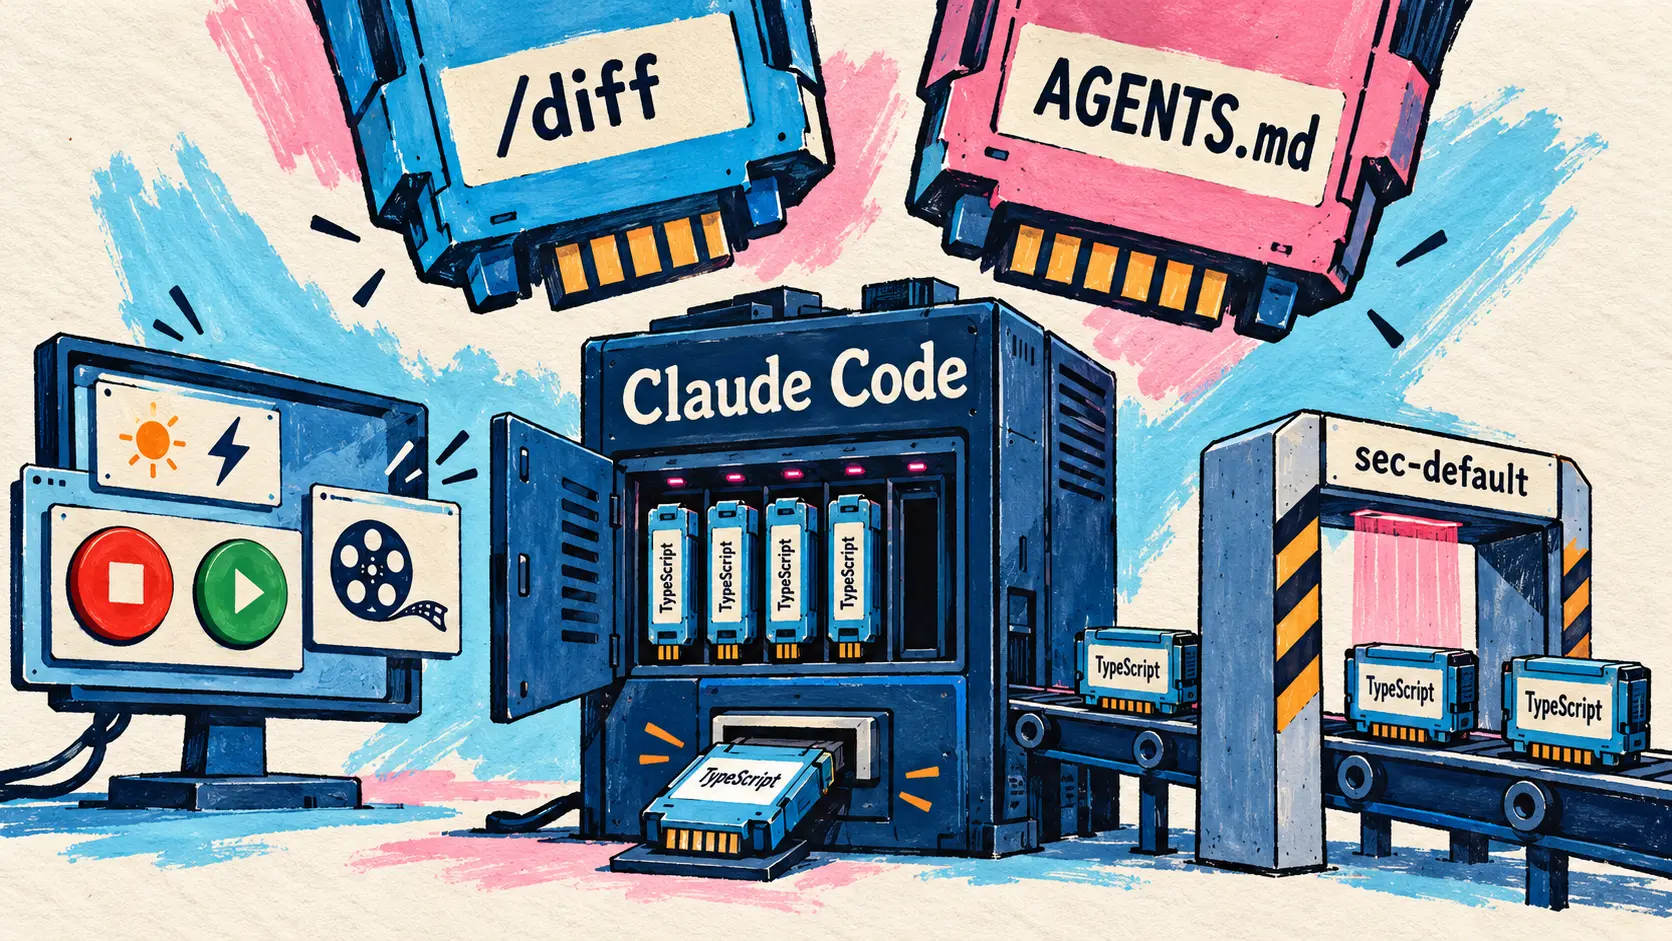
10월 1일 — Anthropic은 Claude Code의 작동 방식을 바꾸는 작은 TypeScript 함수인 모드를 출시했다. 도구의 각 동작은 이벤트를 발생시키며, 도구 호출, 권한 요청, 프롬프트 제출, 턴 시작과 종료, 화면 일부 렌더링 등이 여기에 해당한다. 모드는 해당 이벤트의 앞이나 뒤에 연결되거나, 이벤트를 대체하거나 감싸는 방식으로 연결된다. 프롬프트가 모델에 도달하기 전에 다시 작성하고, 도구 호출을 차단하거나 수정하거나 다시 실행하며, 권한을 승인하거나 거부하고, Claude가 도구 출력을 읽기 전에 비밀 정보를 가리거나, 자체 패널과 버튼, 입력 필드를 추가할 수 있다. 모드는 플러그인에 포함되어 제공되며, /plugin으로 설치하고 플러그인처럼 공유한다. Claude Code 2.1.287부터 제공되며 기본적으로 활성화된다. 시작하는 데 API를 알 필요는 없다. Claude Code에 모드 작성을 요청하면 TypeScript 코드를 생성하고, 설치한 뒤 세션에서 즉시 다시 로드한다.
기존 훅과의 차이는 뚜렷하다. 설정 훅 (설정 훅)은 이벤트가 발생할 때마다 셸 명령을 실행하지만, 모드는 한 번 로드된 뒤 세션에 계속 남는다. 따라서 상태를 유지하고, 이벤트에 따라 인터페이스를 다시 그리며, 모델이 호출할 수 있는 슬래시 명령이나 도구를 등록할 수 있다. Anthropic은 이미 자체 기능에 이를 활용하고 있다. /diff 패널과 AGENTS.md 지원은 비활성화하거나 대체할 수 있는 내장 모드로 전환되었다. Anthropic은 사용자가 Claude Code를 작은 핵심 기능만 남기도록 줄일 수 있게 다른 기능도 점차 모드로 전환할 계획이다. 문서에 나열된 여섯 가지 내장 모드에는 기본적으로 비활성화된 You should know도 포함된다. 이 모드에서는 보조 에이전트가 사용자나 Claude가 놓칠 수 있는 내용을 알려 준다.
| 모드 관련 항목 | 공식 세부 정보 |
|---|---|
| 최소 버전 | Claude Code 2.1.287, 모드 기본 활성화 |
| 표시 기능이 있는 환경 | 터미널 CLI, Claude Desktop의 Code 탭(WSL 세션 제외) |
| 표시 기능이 없는 환경 | VS Code 확장, claude -p, Agent SDK 및 클라우드 세션에서 훅 실행 |
| 내장 모드 | 6개, /diff, AGENTS.md, sec-default, You should know 등 |
| 훅 자체 실행 시간 | 트리거당 10초 |
| 비활성화 | 개별 모드는 /plugin, 세션은 --safe-mode, 전체는 disableAllHooks |
claude.dev에 게시된 Addy Osmani의 시작 가이드에서는 약 80줄로 구성된 Token Weather 모드를 만든다. 이 모드는 프롬프트 위에 컨텍스트의 ‘날씨’를 표시하고, 최근 12개 턴의 작은 그래프를 보여 준다. 가이드는 rm -rf, git reset --hard 또는 강제 푸시가 무엇에 영향을 줄지 보여 주는 동안 실행을 보류하는 Blast Radius와, 한 턴에서 이루어진 파일 변경을 재현하는 Replay Theater도 소개한다.
신뢰는 여전히 까다로운 문제다. 게시글은 모드가 격리되어 있지 않으며 Claude Code와 동일한 머신 접근 권한을 갖는다고 경고한다. 문서에 따르면 모드는 환경 변수와 설정 파일을 읽고, 모든 프롬프트를 확인하며, 도구 호출을 승인하거나 요금제의 사용량을 소모할 수 있지만, 권한 요청 창을 수정할 수는 없다. 그런데 claude.dev 가이드는 DOM이나 Node 없이 자체 샌드박스에서 실행되고 모든 외부 동작이 $ API를 거치는 모듈을 설명한다. 이 구조 덕분에 claude plugin validate은 설치 전에 모드가 가로채는 이벤트와 수행하는 호출을 나열할 수 있다. Team과 Enterprise, 그리고 관리형 설정이 적용된 모든 머신에서는 내장 모드 sec-default가 먼저 로드되어 사용자가 설치한 모드가 거부 규칙을 우회하지 못하게 한다. 관리자는 자체 모드를 이 모드보다 먼저 실행되도록 배치할 수 있다.
Mods are absolutely insane. You can now customize Claude to work and look the way you want by just prompting it. Each person works differently, so there’s no reason why everyone should have an identical Claude experience. Make Claude your own, and share mods as plugins so others can try your mods too.
🇰🇷 모드는 정말 놀랍습니다. 이제 Claude에게 요청하기만 하면 원하는 방식으로 작동하고 표시되도록 맞춤 설정할 수 있습니다. 사람마다 일하는 방식이 다르므로 모두가 똑같은 Claude 경험을 할 이유는 없습니다. Claude를 나에게 맞게 만들고, 다른 사람도 써 볼 수 있도록 모드를 플러그인 형태로 공유하세요. — X의 @bcherny
이번 출시는 예고되어 있었다. Boris Cherny는 9월 14일 이를 발표했고, Anthropic은 GitHub에서 설계를 공유했다(이슈 #91870). 게시글과 claude.dev 가이드는 자신이 만든 모드를 Claude 디렉터리에 제출하도록 권한다.
🔗 TypeScript 모드로 Claude Code 맞춤 설정하기 · claude.dev 시작 가이드 · 모드 문서
Claude Code 2.1.287: 클라우드 제공업체에서 기본 1M 컨텍스트와 67건의 수정
10월 1일 — Claude Code 2.1.287은 모드를 제공하는 버전이지만, 67건의 수정을 포함해 총 106개의 변경 항목이 있다. 기업용으로 Bedrock, Vertex, Foundry 및 Claude apps 게이트웨이에서 Opus 4.7 이후 버전과 Fable은 이제 [1m] 접미사 없이 기본적으로 1M 컨텍스트 윈도우를 사용한다. CLAUDE_CODE_DISABLE_1M_CONTEXT=1로 200K를 유지할 수 있다. /advisor는 Sonnet 5.5를 Opus 4.7과 4.8의 조언 모델로 지원하며, 자동 모델 전환 시 현재 추론 노력 수준을 유지한다. 2025-11-25 프로토콜을 사용하는 MCP 서버는 URL 프롬프트를 열 수 있다. 위험한 rm 명령은 출력을 ~이나 와일드카드로 리디렉션하더라도 확인 절차를 유지한다. 대기 중인 권한 요청은 오래된 것부터 최신 순서로 표시되며, 아홉 개 항목이 화면 읽기 프로그램 모드를 개선한다. VS Code에서는 실행 중인 명령이나 하위 에이전트를 백그라운드로 전환할 수 있다(백그라운드에서 실행).
GitHub Copilot: 데스크톱 애플리케이션 제어와 동적 워크플로 공개 미리 보기
10월 1일 — GitHub는 같은 날 Copilot CLI와 GitHub Copilot 앱에서 두 가지 에이전트 기능을 공개 미리 보기로 제공했다. 데스크톱 애플리케이션 제어와 동적 워크플로이며, 동적 워크플로는 GitHub Copilot SDK에서도 제공된다.
Copilot이 데스크톱 애플리케이션을 제어한다. 컴퓨터 제어 (컴퓨터 사용) 기능이 macOS와 Windows에 도입된다. Copilot은 시스템의 접근성 트리나 필요할 때 촬영한 화면 캡처를 통해 창에서 접근 가능한 콘텐츠와 시각적 맥락을 읽는다. 컨트롤을 클릭하고, 텍스트를 입력하며, 키를 누르고, 스크롤하고, 끌어다 놓으며, 여러 애플리케이션에 걸쳐 작업 단계를 이어 간다. 시연에서는 Safari에서 경비 보고서를 작성하는 모습을 보여 준다. GitHub는 API, 명령줄 인터페이스, MCP 통합이 없는 기존 소프트웨어나 그래픽 인터페이스만 제공하는 소프트웨어를 대상으로 한다. 문서는 이러한 연동 수단이 있다면 결과를 더 예측하기 쉽기 때문에 해당 수단을 사용하도록 권한다. 이 기능은 기본적으로 비활성화된다. CLI에서는 /computer on로 활성화하고, /computer show로 상태를 표시하며, /computer off으로 비활성화한다. 앱에서는 설정에서 사용할 수 있다. Copilot은 각 애플리케이션을 제어하기 전에 권한을 요청한다. 해당 세션에만 허용하거나, 이후 세션에도 적용되도록 저장하거나, 거부할 수 있다. 영구 승인 (항상 허용)은 같은 머신의 CLI와 앱에 모두 적용되지만, 거부 규칙이 항상 우선한다. CLI에서 Esc 키를 두 번 누르거나 앱에서 중지 버튼을 누르면 잘못된 방향으로 진행되는 동작을 중단할 수 있다. 조직의 관리형 설정으로 기능을 비활성화할 수 있으며, 로컬에서 활성화하더라도 이를 우회할 수 없다. GitHub는 모호한 지시나 예상치 못한 화면 콘텐츠가 금융 계정을 포함한 로그인된 계정에서 원치 않는 동작을 일으킬 수 있다고 경고하며, 민감한 애플리케이션에는 영구 승인을 권하지 않는다. 적용되는 요금제나 수치는 제시되지 않았다. /computer 명령은 이미 9월 16일 Copilot CLI 1.0.85 릴리스 노트에 포함되어 있었다.
🔗 GitHub Copilot, 컴퓨터 사용 기능으로 데스크톱 앱과 상호 작용 가능
코드로 작성하는 작업 조율. 모든 Copilot 요금제에서 제공되는 동적 워크플로 (동적 워크플로)는 작업을 수행하는 방식을 프로그램으로 기술한다. 코드는 작업 단계, 에이전트가 개입할 시점, 에이전트 결과의 활용 방식을 순차 실행, 병렬 실행 또는 두 방식의 조합으로 정하며, 에이전트는 분석이나 판단이 필요한 부분을 처리한다. 워크플로는 명령을 실행하고, 목표를 병렬 작업으로 나누며, 단계 간에 구조화된 결과를 전달하고, 한 하위 에이전트의 발견 사항을 다른 에이전트가 검증하게 할 수 있다. 또한 검토를 위해 점검 지점 (체크포인트)에서 멈췄다가 다시 진행할 수 있다. GitHub는 사고 조사, 풀 리퀘스트 파일의 병렬 검토, 또는 검토 의견을 두 모델에 제출한 뒤 두 모델의 판단이 일치할 때만 표시하는 사례를 제시한다.
| Copilot 모드 | 문서에 따른 작업 조율 주체 |
|---|---|
| Autopilot | 단계마다 승인을 요청하지 않고 진행하는 Copilot |
/fleet | 매번 작업을 병렬 하위 에이전트로 나누는 Copilot |
| 동적 워크플로 | 작성자가 만든 코드가 단계, 조건, 인계를 결정 |
프로그램은 Copilot CLI와 앱의 확장 안에 위치한다. Copilot이 작성한 워크플로는 해당 세션에서만 유지되지만, 확장을 개인 디렉터리에 복사하면 재사용할 수 있고, 저장소의 확장 디렉터리를 통해 공유하거나 플러그인으로 패키징할 수 있다. 하위 에이전트는 세션의 권한을 상속하지만, copilot workflow run 명령은 권한 요청을 표시하지 않으므로 실행 전에 권한을 부여해야 한다. 앱에서는 별도 설정 없이 사용할 수 있지만, CLI에서는 실험적 기능을 활성화해야 한다(--experimental 또는 /experimental on). GitHub는 수치나 과금 규칙을 공개하지 않았다. 공식적으로 연관성이 발표되지는 않았지만, 이 이름은 Anthropic이 5월 28일 Claude Code에 도입한 Dynamic Workflows를 떠올리게 한다.
🔗 Copilot CLI와 Copilot 앱의 동적 워크플로
FLUX 3 Image: Black Forest Labs, 경계 상자로 구도를 구성하고 최대 4K 이미지 생성
10월 1일 — Black Forest Labs(BFL)는 모든 픽셀을 제어한다는 목표로 FLUX 3 제품군에 이미지 모델을 추가했다. FLUX 3 Image는 이미지의 나머지 부분을 바꾸지 않고 특정 영역을 여러 차례에 걸쳐 연속으로 수정하며, 하나의 요청에서 여러 수정 사항을 처리할 수 있다.
가장 눈에 띄는 새 기능은 경계 상자 (경계 상자)를 이용한 구도 구성이다. 이미지 형식과 관계없이 각 축이 0부터 1000까지인 좌표계를 사용한다. 요소마다 상자를 그리고 내용을 설명한 다음, 장면을 한 줄로 요약하면 모델이 각 요소를 해당 상자 안에 배치한다. 텍스트 프롬프트만 사용하는 방식도 가능하다. FLUX 3 Image는 프롬프트에서 토큰으로 참조하는 최대 10개의 참고 이미지도 조합하며, 배치 위치와 크기는 모델이 직접 결정한다. BFL은 이를 ‘에이전트를 위해 설계된’ 모델이라고 소개한다. LLM이 간단한 요청을 바탕으로 요소와 경계 상자를 표로 작성하면, 사용자가 이를 조정한 뒤 생성을 시작할 수 있다.
| 발표된 특성 | BFL이 공개한 세부 정보 |
|---|---|
| 기본 해상도 | 2K 및 4K(모델 페이지의 예시: 5456 × 3072 픽셀, 16,8 MP) |
| 참고 이미지 | 최대 10개 |
| 구도 구성 | 각 축이 0부터 1000까지인 격자 위의 경계 상자 |
| 편집 | 다른 픽셀을 바꾸지 않는 다중 턴 편집 |
| API 할인 | 10월 8일까지 50 % 할인 |
| 모델 가중치 | 라이선스로 제공되는 상용 가중치, 공개 가중치는 ‘앞으로 몇 주 안에’ 제공 |
이용 방법으로는 API를 통해 FLUX 3 Image를 사용할 수 있으며, 10월 8일까지 50 % 할인이 적용된다. BFL은 자체 인프라에서 모델을 미세 조정하고 배포하려는 기업에 라이선스가 적용되는 상용 가중치를 제공한다. 가중치 공개 버전은 날짜 없이 예고되었다. 발표 당시 기본 가격이나 수치로 제시된 벤치마크는 공개되지 않았다. 이 모델은 올여름 시작된 시리즈를 확장한다. 통합 멀티모달 모델인 FLUX 3(7월 23일), FLUX 3 Video(8월 4일), 해당 모델의 편집 모드(9월 10일), 로봇용 FLUX 3 Action(9월 23일)이 앞서 출시되었다.
🔗 @bfl_ai의 FLUX 3 Image 발표 · FLUX 3 Image 모델 페이지
일반 사용자용 어시스턴트: Gemini Live의 Guided Vision, ChatGPT의 가상 착용, Perplexity Computer의 그래프, Claude 아티팩트 제한 완화
Guided Vision: Gemini Live가 시각장애인과 저시력자를 안내한다
10월 1일 — Google이 Gemini Live를 사용할 수 있는 지역과 언어에서 Android 9 이상 버전의 Gemini Live에 Guided Vision을 배포한다. 시각장애인과 저시력자와 함께 설계한 이 기능은 공유된 카메라가 촬영하는 내용을 실시간으로 설명하고, 후속 질문에 답하며, 구도를 조정하도록 음성으로 안내한다. 천천히 오른쪽으로 돌리기, 아래로 기울이기, 뒤로 물러나기 등이 그 예다. Google은 영양정보 라벨이나 어두운 식당의 메뉴 읽기, 떨어뜨린 이어폰 찾기, 옷의 색상 설명 등을 활용 사례로 들었다. 학습을 위해 Google은 시각 정보 해석 서비스인 Aira와 협력했다. 수만 시간의 데이터, Aira 네트워크의 1,000명 이상의 테스터, 안전장치 설계에 참여한 전문가들이 동원됐다. Guided Vision은 Gemini 앱의 프로필, Android 접근성 단축키 또는 TalkBack에서 활성화할 수 있다. Google은 이 기능이 의료기기도 이동 보조 도구도 아니며, 흰지팡이를 대체하지 않는다고 명시했다.
🔗 Gemini Live의 Guided Vision(Google 블로그)
ChatGPT: 쇼핑을 위한 가상 착용과 즐겨찾기
10월 1일 — ChatGPT 릴리스 노트에 따르면 의류와 액세서리 상품 카드에 착용해 보기(입어 보기) 버튼이 표시된다. 셀카를 찍거나 업로드하면 ChatGPT Images가 해당 상품을 가상으로 착용한 이미지를 생성한다. 참조 사진은 다음 착용에도 사용할 수 있도록 저장되며, 설정의 참조 사진 항목(설정 → 개인 맞춤 설정 → 참조 사진)에서 교체하거나 삭제할 수 있다. 모든 상품을 즐겨찾기에 저장하거나 ChatGPT 라이브러리의 폴더에 정리할 수도 있다. 두 기능 모두 모바일과 웹에서 사용할 수 있지만, 릴리스 노트에는 적용 요금제와 국가가 명시되지 않았다. ChatGPT는 이미 3월 24일부터 시각적 쇼핑 기능을 제공하고 있었다.
Perplexity Computer가 대화형 그래프를 그린다
10월 1일 — Perplexity Computer가 이제 대화 흐름 안에서 직접 대화형 그래프와 시각화를 생성한다. 금융 데이터의 경우 에이전트는 TradingView의 Lightweight Charts를 활용해 캔들스틱, 거래량, 이동평균을 표시한다. 발표는 동영상이 첨부된 트윗 하나로 이루어졌다. 적용 요금제와 플랫폼은 밝히지 않았으며, 변경 기록에도 아직 상세한 설명이 없다. ChatGPT와 Claude는 각각 3월 10일과 12일에, Replit Agent는 9월 25일에 이러한 기능을 도입했다.
Claude, 10월 15일까지 아티팩트 작업 이후의 한도 차감량을 절반으로 축소
10월 1일 — 10월 1일 11시 PT부터 10월 15일 23시 59분 PT까지 Claude 또는 Claude Cowork에서 아티팩트(문서, 프레젠테이션 또는 디자인)를 생성하거나 수정하면, 이후 작업에서 5시간 세션 한도의 차감량이 50 % 줄어든다. 혜택은 Pro, Max, Team 요금제에 자동으로 적용된다. Free와 Enterprise 요금제는 제외되며, 주간 한도는 바뀌지 않는다.
| 적용 대상 | 50 % 감면 적용 범위 |
|---|---|
| Output 메뉴에서 시작한 대화 | 첫 메시지부터: 10개 메시지, 응답당 15단계 |
| 일반 대화 | 아티팩트 생성 이후의 10개 메시지, 응답당 15단계 |
| Output에서 시작한 클라우드 Cowork 작업 | 처음 약 45분 |
| 그 밖의 클라우드 Cowork 작업 | 아티팩트 생성 또는 수정 이후 최대 80단계 |
Claude Code, API, Slack의 Claude, 로컬 또는 예약된 Cowork 작업, 사용 크레딧, 독립형 Claude Design 앱은 제외된다. Anthropic은 Sonnet 5.5로 사용해 볼 것을 제안하며, 혜택을 조기에 변경하거나 종료할 권리를 보유한다.
🔗 X의 @claudeai 발표 · 혜택 이용 조건(Claude 도움말 센터)
금융: Barclays는 은행 전체로 Claude를 확대하고, American Express는 Business 고객에게 Perplexity Computer를 제공한다
Barclays, 2026년 말까지 개발자의 절반이 Claude Code를 사용하도록 추진
10월 1일 — 영국의 종합 금융 은행인 Barclays가 Anthropic과의 협력을 확대하고 조직 전체에 Claude를 도입해 소프트웨어 개발을 가속하고, 기존 시스템을 현대화하며, 운영 효율성을 높인다. 은행은 2026년 말까지 개발자의 50 %가 Claude Code를 사용하고, 2027년에는 소프트웨어 엔지니어의 대다수가 사용하도록 할 계획이다. 두 가지 활용 사례는 이미 수치로 제시됐다. 2025년부터 운영 중이며 검색 증강 생성(RAG) 아키텍처를 적용해 Claude를 기반으로 구축한 Colleague Knowledge Assistant는 16,000명 이상의 직원이 사용하고 있으며, 100만 건 이상의 검색을 처리했다. 이 도구는 영국에서 2,000만 명 이상의 개인 고객을 지원하는 팀들을 돕는다. Global Markets 부문에서는 Claude 모델이 하루 약 120,000통의 이메일을 분류하고, 정보를 보강하고, 담당자에게 전달한다. Anthropic의 최고상업책임자인 폴 스미스는 이를 영국 사업의 중요한 진전으로 평가했다. 계약 금액과 기간은 공개되지 않았다.
🔗 Barclays, 운영 개선과 고객 경험 향상을 위해 Claude 도입 확대
Perplexity와 American Express: Business 카드 고객을 위한 Computer의 업무용 Skills 10종
10월 1일 — Perplexity가 Perplexity Enterprise에 가입한 미국 내 American Express Business 카드 소지자만 사용할 수 있는 Perplexity Computer용 Skills 모음을 출시한다. 기업 운영자는 요청을 직접 작성하는 대신 작업을 선택하고 양식에 세부 내용을 입력한다. 10종의 Skills는 현금흐름 예측, 세무 준비, 공급업체 비교, 예산 시나리오, 계정 대사, 마케팅 캠페인, 수요 예측, 채널별 광고비 대비 수익률(ROAS), 운영 추적, 채용을 지원한다. 카드는 Personal CFO에서 Plaid를 통해 연결하며, 실행할 때마다 작업의 복잡도에 따라 Computer 크레딧이 차감된다. 제휴 페이지는 2027년 3월 29일까지 Enterprise Pro 또는 Enterprise Max 요금제를 325달러 이상 구매하면 일회성 125달러 크레딧을 제공하고, 계정당 한 번 Computer 크레딧 1,000개를 무료로 제공한다고 덧붙였다. Corporate 카드는 제외되며, 결과는 금융·세무·법률·회계 자문에 해당하지 않는다.
🔗 Perplexity 게시글 · American Express 제휴 페이지
생성형 영상과 아바타: Artificial Analysis 선두에 오른 Wan 3.0, Runway의 Project Continuum, Synthesia의 Sessions
Wan 3.0, Artificial Analysis의 새로운 영상 순위에서 선두에 오르다
10월 1일 — Alibaba는 새로운 Artificial Analysis 텍스트 기반 영상 생성 순위인 AA-Video-T2V v2.0에서 Wan 3.0이 1위를 차지했다고 발표했다. 이 순위는 새로운 평가 방법을 적용해 9월 30일 공개됐다. 각 모델은 정기적으로 갱신되는 프롬프트 세트를 사용해 1080p로 평가되며, 음향 동기화도 점수에 반영된다. 상위권의 차이는 근소하며 신뢰구간이 서로 겹친다.
| 순위에 오른 모델 | Elo 점수 | 순위 구간 | API 가격 |
|---|---|---|---|
| Wan 3.0 | 1157 (±9) | 1~2 | 분당 12,00달러 |
| Utopai X (MiniMax H3 기반) | 1150 (±10) | 1~3 | 공개 API 없음 |
| Dreamina Seedance 2.5 | 1144 (±9) | 2~4 | 분당 34,12달러 |
| MiniMax H3 (768p) | 1139 (±9) | 3~5 | 분당 4,80달러 |
이번 순위에서 뜻밖의 성과를 낸 모델은 AI를 기반으로 설립된 영화·텔레비전 제작사 Utopai Studios가 9월 30일 출시한 Utopai X다. MiniMax H3를 추가 학습한 이 모델은 제작사의 PAI 플랫폼에서만 사용할 수 있으며(영상 1초당 93크레딧, 구독료는 월 15달러부터), 기반 모델인 MiniMax H3보다 높은 순위를 기록했다.
🔗 X의 @Alibaba_Wan 발표 · AA-Video-T2V v2.0 순위 · @ArtificialAnlys가 소개한 Utopai X
Runway Labs, 실시간 영상으로 인터페이스를 생성하는 Project Continuum 공개
10월 1일 — Runway의 탐색 연구 조직인 Runway Labs가 Project Continuum을 공개했다. 이는 인터페이스를 실시간 영상으로 생성하는 운영체제를 구상한 연구용 애플리케이션으로, 8월 31일 발표한 인터페이스 월드 모델 Solaris의 연장선에 있다. 이번 첫 공개에서는 컴퓨터와 상호작용하는 네 가지 방식을 설명했다. Portals에서는 탐색하는 동안 영상 모델이 움직이는 대화형 오버레이를 생성하며, 생성된 콘텐츠임을 알리기 위해 가장자리를 흐리게 표시한다. 반응형 영상 인터페이스(Responsive Video Interfaces)는 크기를 조절하면 구성을 바꾸고 클릭에 반응한다. Interactive Worlds는 미디어를 사람과 에이전트 모두를 위한 대화형 시뮬레이션으로 변환한다. 마지막으로 Visual Thinking은 코딩 에이전트용 하네스다. 실시간 영상 모델이 각 단계와 도구 호출을 시각화해 사용자가 과정에 계속 참여할 수 있도록 한다. Runway는 접근 방법, 출시일, 가격, 기반 모델을 공개하지 않았다.
Synthesia, 훈련과 인터뷰를 진행하는 아바타 제품군 Sessions 출시
10월 1일 — Synthesia가 자사의 대화형 아바타를 기반으로 한 제품군 Sessions를 출시한다. 질문하고, 듣고, 반론을 제기하고, 내용을 종합하는 아바타와 영상 통화를 하는 방식이다. Roleplay Sessions는 훈련용으로 사용된다. 아바타가 고객, 잠재 고객 또는 동료 역할을 맡고, AI 코치가 매번 시도에 대해 의견을 제공하며, 관리자는 대시보드에서 점수와 진척도를 확인한다. Survey Sessions는 설문지를 인터뷰로 바꾼다. 아바타가 수백 명을 동시에 인터뷰하고, 답변에 따라 추가 질문을 한 뒤, 주제와 감정을 분석한 보고서를 제공한다. 각 답변은 텍스트 기록, 오디오 또는 CSV로 계속 확인할 수 있다. 무료 체험이 제공되지만 상세한 가격은 공개되지 않았다. Sessions는 9월 16일 정식 출시된 Interactive Avatar API를 기반으로 하며, Synthesia는 추가 제품도 예고했다.
🔗 X의 @synthesiaIO 발표 · Synthesia Sessions 페이지
AI와 과학: SynthID Bio는 단백질에 워터마크를 넣고, 매슈 슈워츠는 ‘Claude형’ 과학을 설명한다
SynthID Bio: Google DeepMind가 AI로 설계한 단백질에 워터마크를 넣는다
9월 30일 — Google DeepMind가 AI로 생성한 생물학적 산물에 디지털 워터마크(watermarking)를 넣는 방법군인 SynthID Bio를 발표했으며, 10월 1일 X에서도 소개했다. 게시글은 이를 개념 증명으로 설명한다. 생물학적 코드에 감지하기 어려운 서명을 삽입하고, 디지털 모델과 합성된 단백질 모두에서 이를 검증할 수 있다. 서열의 경우 아미노산 선택을 미세하게 유도하고, 3D 구조의 경우 AlphaFold 3 확산 네트워크의 일부를 미세 조정한다. 실험실에서 세 가지 표적(VEGF-A, SARS-CoV-2 스파이크 단백질의 RBD 도메인, PD-L1)을 대상으로 시험한 결과, 워터마크가 삽입된 결합체는 성공률, 친화도, 서열 다양성에서 기존 버전과 동등한 성능을 보였다. 핵심 목적은 생물보안이다. 자동으로 감지할 수 있는 신호는 DNA 합성 공급업체가 출처를 알 수 없는 서열의 기원을 확인하는 데 도움이 될 수 있다. Google DeepMind는 연구용으로 방법론 논문, 코드, 시험관 내 실험 데이터, 가중치를 공개한다. Stanford의 Hie lab 및 Arc Institute와 함께 이 접근법을 이미 Evo 2로 설계한 박테리오파지의 유전체로 확장하고 있다. 의도적인 변형에 대한 견고성을 확보하는 것이 여전히 가장 중요한 과제다.
🔗 Google DeepMind의 SynthID Bio 게시글
‘Claude형’ 과학: 매슈 슈워츠의 기고문
10월 1일 — Anthropic Science 블로그가 Harvard의 물리학자 매슈 슈워츠의 기고문을 게시했다. 그는 자신이 Anthropic에서 방문 연구원으로 활동하고 있다고 밝혔다. 글에서는 과학자와 AI 사이의 ‘임피던스 불일치’를 설명한다. 모델을 인간 협업자처럼 대하면 최상의 성과를 끌어내기 어렵다. 대신 수학, 물리학 또는 컴퓨터과학의 알려진 기법으로 다른 분야의 문제를 한 번에 해결할 수 있는 ‘Claude형’ 문제를 찾는 편이 낫다는 것이다. 이를 바탕으로 그는 어떤 모델과도 사용할 수 있는 정확한 계산용 오픈 소스 하네스 BootLoops를 만들었다. BootLoops는 Anthropic의 프로젝트가 아니며, 슈워츠가 직접 유지·관리한다. 물리학에서는 적분 30개를 처음부터 끝까지 처리했으며, 그중 15개는 이전에 계산된 적이 없었다. 생태학에서는 바로콜로라도섬의 나무가 중립 이론이 허용하는 속도보다 4.5배 빠르게 변화한다는 결과를 얻었다. 언어학에서는 AccStack 데이터베이스가 6,072개 언어의 어휘 강세를 다룬다. 성과는 3개월 동안 공동저자 19명과 함께 18개 분야에서 작성한 원고 36편이다. 슈워츠는 한계도 지적했다. Claude는 시간 감각이 없고, ‘성공을 선언하는 것’을 좋아하며, 물리학 이외의 분야에서 얻은 결과는 전문가가 방향을 바로잡기 전까지 별로 흥미롭지 않았다.
🔗 Claude형 과학(Anthropic Science 블로그)
개방형 모델과 학습: Ai2의 Olmo-core 3, Cloudflare의 Clef와 Clef-flash, FineEnvs의 다중 하네스 RL
Olmo-core 3: Ai2, 1조 개가 넘는 매개변수를 목표로 하는 MoE 학습 스택 공개
10월 1일 — Ai2가 자사의 Olmo 모델을 학습하는 프레임워크의 새 버전인 Olmo-core 3를 공개했다. 완전히 개방된 혼합 전문가(mixture-of-experts, MoE) 학습 시스템을 중심으로 재구축한 버전이다. 이는 차세대 Olmo를 위한 시스템 중 하나다. 차세대 Olmo는 MoE로 전환되며, Ai2에 따르면 지금까지의 Olmo 중 가장 뛰어난 성능을 갖출 예정이다. FSDP를 기반으로 한 기존 구현은 배치마다 가중치를 모은 뒤 다시 나눴다. Olmo-core 3는 DDP로 전환해 전문가를 각 GPU에 유지하고 데이터를 해당 전문가에게 보낸다.
| Ai2가 공개한 측정 항목 | 측정값 |
|---|---|
| 매개변수 47(십억 개 단위)인 MoE, B300 8개에서 예비 테스트 | GPU당 52 000 대 19 400 tokens/s, 약 2,7배 |
| B300 4개에서 MXFP8과 BF16 비교 | 처리량 약 21 % 증가 |
| 매개변수 1 200(십억 개 단위)인 모델, 512 GPU | GPU당 최대 858 TFLOP/s, 무작위 라우팅 |
Ai2는 매개변수 1조 2,000억 개 규모의 측정이 학습된 모델의 품질이 아니라 시스템을 평가한 것이라고 명시했다. 코드(버전 3.0.0), 기술 보고서, 대화형 시연이 공개됐다.
🔗 Ai2의 Olmo-core 3 게시글 · Olmo-core v3.0.0 출시
Clef와 Clef-flash: Cloudflare, Jev와 호환되는 의사결정 모델 두 개 공개
10월 1일 — Cloudflare의 Workers AI 팀이 Typesafe AI의 System One 모델인 Jev가 개척한 영역에서 자체적으로 학습한 첫 모델인 Clef와 Clef-flash를 공개했다. 이 모델들은 상태(텍스트, JSON, 이미지 또는 동영상)와 자료형이 지정된 질문 스키마를 입력받고, 한 번의 처리로 허용된 각 선택지의 확률을 반환한다. Clef는 Qwen3.8-27B를 기반으로 사후 학습했으며, Clef-flash는 Qwen3.5-9B를 기반으로 한다. 두 모델은 Workers AI에서 호스팅되며 Jev의 API와 호환되는 API를 제공한다. 게시글에 따르면 Apache 2.0 라이선스로 Hugging Face에 공개되었으며, 컨텍스트 창은 Jev의 32k 토큰보다 큰 64k 토큰이다. Cloudflare가 선택한 수치에서는 결과가 엇갈린다.
| 벤치마크 및 지표 | Clef 점수 | Clef-flash 점수 | Jev 점수 |
|---|---|---|---|
| BFCL, 정확히 일치한 사례 | 98,47 | 98,76 | 95,75 |
| BANKING77, macro-F1 | 94,20 | 90,93 | 79,74 |
| When2Call, 정확도 | 72,37 | 65,58 | 80,97 |
| BRIGHT, nDCG@10 | 45,91 | 39,26 | 47,52 |
| 지연 시간 중앙값 | 209,3 ms | 38,8 ms | 524,1 ms |
Cloudflare는 Clef가 Jev Decision Index에서 선두를 차지했다고 주장한다. 이틀 전 Liquid AI도 d1이 같은 자리를 차지했다고 주장했다. Cloudflare는 고객 데이터를 바탕으로 Clef를 강화학습으로 미세 조정하는 서비스도 출시했다.
🔗 Cloudflare의 Clef 게시글 · Hugging Face의 Clef
FineEnvs, 네 가지 에이전트 하네스에서 동시에 모델 강화학습
10월 1일 — 같은 모델도 이를 구동하는 하네스에 따라 다르게 동작한다. Liquid AI의 LFM2.5-2.6B 가중치는 Mini-SWE-Agent에서 작업의 62 %를 해결하지만, Claude Code에서는 33 %를 해결한다. FineEnvs는 개발자들이 사용하는 하네스의 코드를 수정하지 않고 그 안에서 직접 모델을 강화학습하는 방법을 설명한 안내서를 Hugging Face에 공개했다. OpenEnv에 추가된 수집 프록시는 하네스에 모델 제공자로 나타나며(OpenAI, Anthropic 또는 Gemini 형식), vLLM이 생성한 정확한 토큰과 확률을 기록한다. Harbor는 작업과 샌드박스를 제공하고, TRL은 비동기 GRPO로 학습을 진행한다. 네 가지 하네스에서 동시에 학습한 LFM2.5-2.6B의 평균 성적은 42 %에서 54 %로 올랐다. 효율적인 해결책에 작은 추가 보상을 주자, 이미 해결할 수 있었던 작업에서 도구 호출 횟수가 31 % 줄었다. 더 큰 모델을 모방하는 것만으로는 충분하지 않다. Qwen3.8-27B의 롤아웃 3 189개로 지도 미세 조정을 수행한 결과는 47,5 %에서 정체됐다. 프록시, 학습기, 작업, 데이터와 학습된 모델이 공개되어 있다.
Google Cloud 에이전트 플랫폼에 Grok 4.7 미리 보기 버전 출시
10월 1일 — SpaceXAI는 Grok 4.7을 Google Cloud의 에이전트 플랫폼인 Gemini Enterprise Agent Platform에서 사용할 수 있다고 발표했다. 9월 30일 자 모델 안내 페이지에는 grok-4.7 식별자의 미리 보기 버전으로 등록되어 있다. 이 페이지는 Grok 4.7을 코딩과 지식 업무를 위해 설계된 xAI 모델로 설명하며, 어려운 작업에 더 오래 매달리고 자신의 작업을 검증한다고 명시한다. 입력으로 텍스트와 이미지를 받으며 출력은 텍스트만 제공한다. 함수 호출, 구조화된 출력과 추론은 지원하지만 일괄 예측은 지원하지 않는다.
| Google Cloud가 공개한 항목 | Grok 4.7의 값 |
|---|---|
| 컨텍스트 길이 | 524 288 tokens |
| 분당 할당량 | 요청 13건, 입력 188 000 tokens 및 출력 16 000 tokens |
| 이용 방식 | 고정 할당량만 지원하며, 사용량에 따른 결제와 프로비저닝된 처리량은 지원하지 않음 |
| 서비스 리전 | 미국 멀티리전 및 전역 엔드포인트 |
| 백만 토큰당 가격 | 입력 200 000 tokens 미만일 때 입력 2달러, 출력 6달러, 캐시 0,50달러이며, 그 이상은 두 배 |
가격표는 xAI API와 동일하다. 9월 21일 출시된 Grok 4.7은 9월 28일 Amazon Bedrock에 추가되었으며, Grok 4.6은 8월 21일 같은 Google 플랫폼에 추가된 바 있다.
🔗 Google Cloud의 Grok 4.7 모델 안내 · X의 @SpaceXAI 발표
GitHub, AI 생성 보고서에 대응해 비공개 취약점 신고 요건 강화
10월 1일 — GitHub는 비공개 취약점 신고(비공개 취약점 신고)에 관한 두 가지 조치를 같은 분에 공개했다. 두 조치의 공통된 배경은 오픈 소스 유지관리자들이 자동화되거나 AI로 생성된 저품질 보고서를 점점 더 많이 받고 있으며, 이 때문에 중요한 보고서가 묻힌다는 점이다.
A single free-text box made it easy to submit low-quality or AI-generated reports and hard for you to find the signal in them.
🇰🇷 단순한 자유 입력 텍스트 영역은 품질이 낮거나 AI로 생성된 보고서를 쉽게 제출할 수 있게 해, 그 안에서 핵심을 파악하기 어렵게 만들었습니다. — GitHub 변경 기록, 비공개 취약점 보고서를 위한 구조화된 양식
구조화된 양식. 기본적으로 신고자는 요약, 세부 내용, 최소 150자 이상의 개념 증명, 영향이라는 네 가지 필수 항목을 작성해야 한다. 이 항목들은 보안 권고의 설명에 합쳐지며, 유지관리자는 이전과 같은 방식으로 이를 검토한다. 각 저장소는 .github/VULNERABILITY_REPORT.yml 파일로 양식을 수정할 수 있으며, 조직의 .github 저장소를 통해 모든 저장소에 적용할 수도 있다. 유지관리자는 CWE 범주를 필수로 요구할 수 있고, 조직이나 기업은 이를 정책으로 의무화할 수 있다. 신고자는 체크박스를 통해 취약점을 찾거나 보고서를 작성하는 데 AI의 도움을 받았다고 밝힐 수 있다. REST API에도 사용자 지정 양식은 적용되지만, 기존 연동이 깨지지 않도록 기본 양식은 적용되지 않는다.
일일 상한. 이제 같은 계정이 하루에 보낼 수 있는 새 보고서 수에 제한이 적용된다. 개별 저장소와 GitHub 전체에 모두 적용되며, 기존 보안 권고에 달리는 댓글은 해당하지 않는다. 관리자는 자체 제한을 설정하고 신뢰하는 신고자를 예외로 지정할 수 있다. GitHub는 기본 제한의 구체적인 수치를 공개하지 않았다. 두 조치는 GitHub Free, Pro, Team, Enterprise Cloud에서 비공개 신고를 활성화한 공개 저장소에 적용된다.
코딩 에이전트: Codex CLI 0.160.0, Delta 0.18, Antigravity 2.19.1
Codex CLI 0.160.0: 명령 센터 기록과 프로젝트 외부 세션
10월 1일 — OpenAI가 Codex CLI 0.160.0을 공개했다. 전날 나온 0.159.3 이후 첫 안정 버전으로, 0.159.0 이후의 PR 55개가 나열되어 있다. 에이전트 명령 센터(에이전트 명령 센터)에는 이전 작업을 표시하는 동작(더 보기)이 추가되었으며, 키보드로도 사용할 수 있다. 조직 정책이 허용하면 작업 공간의 기본 설정을 사용해 프로젝트 외부에서 세션을 시작할 수 있고, 세션을 재개할 때 저장된 권한이 복원된다. Guardian 승인 검토에는 두 가지 선택적 기능이 추가되었다. 사용자가 앞서 내린 지시를 찾아내는 기능과 에이전트 간 인계 맥락을 반영하는 기능이다. 전체 화면 모드에서는 로컬 Linux X11 터미널에서 대화 기록을 선택하고 마우스 가운데 버튼을 클릭해 붙여넣을 수 있다. 수정 사항으로는 재연결 후 대기 중인 메시지가 중복 전송 없이 다시 처리되도록 했으며, Windows 샌드박스와 초기화 시 SQLite에서 발생하는 멈춤 현상을 해결하는 여러 수정이 포함되었다.
Delta 0.18: 기존 Git 작업 트리에서 스레드 실행, CLI 도입
9월 30일 — Zed가 에이전트와 함께 코딩하는 다중 사용자 환경인 Delta의 0.18.0 버전을 공개했다. 새 기능 23개, 개선 41개, 수정 51개, 제거 1개가 포함되어 있다. 핵심 기능은 9월 28일 출시일 없이 먼저 발표되었다. 이제 스레드를 이미 연결된 기존 Git 작업 트리 어디에서나 실행할 수 있으며, 해당 스레드에서 생성한 새 스레드에도 그 작업 복사본을 전달할 수 있다. Delta는 터미널에서도 제어할 수 있다. delta CLI를 macOS, Windows, Linux에 설치할 수 있으며, delta auth 명령으로 로그인된 계정을 관리한다. 모델 측면에서는 Google AI Studio의 Gemini 모델을 추가했고, API 키로 GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5를 사용할 수 있게 했다. 데스크톱 애플리케이션에서는 OpenAI 또는 Anthropic과 호환되는 모든 제공자를 사용할 수 있다. 스레드 작업에는 모든 하위 스레드를 검색하는 기능과 북마크가 추가되었다. 다만 하위 스레드는 더 이상 상위 스레드에 진행 메시지를 게시하지 않으며, 상위 스레드에는 Land Changes 결과만 표시된다.
Antigravity 2.19.1: 하위 에이전트에 직접 메시지 보내기
9월 30일 — Antigravity 2.19.1에서는 기본 에이전트를 거치지 않고 입력란에서 하위 에이전트에 직접 메시지를 보낼 수 있다. CLI는 이미 1.2.8과 1.2.9 버전부터 @ 구문으로 이 기능을 제공했다. 이번 버전에는 산출물과 측면 패널에서 렌더링된 Markdown을 표, 코드 블록, 다이어그램까지 포함해 PDF로 내보내는 기능과 취소 범위를 대화로 제한하는 옵션이 추가되었다. 다섯 가지 수정 사항 중 하나로, 사용자 지정 에이전트가 마침내 전역 규칙과 프로젝트 규칙을 준수하게 되었다. 배포는 순차적으로 진행되며 며칠이 걸릴 수 있다. CLI에는 9월 27일 크게 주목받지 못했던 1.2.12 버전이 출시되었다. 이제 GEMINI_API_KEY 키로 시작한 세션은 Gemini API가 일일 할당량 소진, 지출 상한 도달 또는 선불 크레딧 소진을 알리면 즉시 종료된다. 이전에는 실패할 수밖에 없는 시도를 몇 분 동안 반복했다.
🔗 Antigravity 애플리케이션 변경 기록 · Antigravity CLI 변경 기록
단신
- Copilot CLI 1.0.90 및 1.0.91 — 1.0.90은 9월 30일 안정판으로 전환되며, 모델 선택기에 GPT-6.1 Sol을 추가하고 MCP와 세션 재개 관련 문제를 수정했다. 10월 1일 나온 1.0.91은 샌드박스의 프록시 인증서를 관리하는
copilot sandbox ca명령을 추가했다. 🔗 출처 - Codex CLI 0.159.3 — 9월 30일 22시 57분 UTC에 공개됐으며, 이전 버전으로 이식한 변경 사항 하나만 포함한다. ChatGPT로 로그인한 로컬 세션에서 계정 보안 설정을 완료하도록 선택적 알림을 표시할 수 있으며, 이 변경 사항은 0.160.0에도 포함됐다. 🔗 출처
- Gemini CLI Nightly — 10월 1일의 v0.64.0-nightly는 headless 모드에서 프로세서 사용률이 100%에 도달하며 멈추는 문제를 수정하고 파일 도구의 쓰기를 원자적으로 처리하도록 했다. 안정판과 미리보기판에는 변화가 없다. 🔗 출처
- Zed 1.23.1 미리보기판 — 9월 30일 공개됐으며, JSONL과 NDJSON 파일을 표 형태로 표시하고
agent.max_idle_retained_threads설정을 추가했다. Google AI 모델에 과부하가 걸리면 요청을 자동으로 재시도한다. 🔗 출처 - 9월의 VS Code용 Copilot — 버전 1.136부터 1.140까지의 월간 정리에서 크게 주목받지 못했던 몇 가지 새 기능을 소개했다. ChatGPT 앱에서 시작한 Codex 대화를 VS Code에서 이어가기, 미리보기판 앱 배지, 작업 공간 없이 채팅 열기 등이 포함됐다. 🔗 출처
- Delta에서 함께 계획하기 — Delta 블로그에서 네이선 소보는 팀원 세 명이
plan.md파일 대신 하나의 대화에서 먼저 Fable, 이어서 Astra를 사용하고, 격리된 하위 대화와 하위 에이전트를 활용해 함께 계획하는 방식을 설명했다. 새 기능 발표는 없다. 🔗 출처 - Cursor가 영상으로 소개한 Innate — Cursor가 일상용 로봇을 만드는 7인 팀 Innate의 짧은 소개 영상을 공개했다. 공동 창업자 비그네시 아난드는 팀이 50명분의 일을 한다고 말했지만, Cursor를 어떻게 활용하는지는 설명하지 않았다. 🔗 출처
- 압축보다 불러오기 — funes 개발자 다비드 코르부아지에는 직접 고른 세 가지 작업에서 Claude Code로 측정한 결과, 자신의 도구로 이전 세션을 불러오면 전체 맥락을 유지할 때보다 가중 토큰을 각각 8분의 1, 4분의 1, 3분의 1만 사용하면서 올바른 답을 찾는다고 밝혔다. 🔗 출처
- 새로운 GitHub 대시보드 — 진행 중인 에이전트 세션, 이슈, 풀 리퀘스트를 한데 모아 목록당 최대 12개씩 보여주는 화면이 모든 사용자의 기본 화면이 된다. 소식 피드는 Feed 탭으로 이동하며, 기존 화면도 계속 이용할 수 있다. 🔗 출처
- 비동기 병합 API — 정식 제공 단계로 전환되며, 동기식 REST 엔드포인트와 GraphQL 변이 대신 프로그램을 통한 병합에 권장되는 방식이 된다. 연쇄적으로 쌓인 풀 리퀘스트를 처리하는 유일한 병합 API다. 🔗 출처
- 토큰 없이 npm dist-tags 관리 — npm의 신뢰할 수 있는 게시 설정에 선택적 권한을 부여하면, 장기 액세스 토큰 대신 단기 OIDC 자격 증명으로 dist-tags를 관리할 수 있다. 이 권한은 기본적으로 비활성화돼 있다. 🔗 출처
- GitHub Actions 보존 기간 — 외부 앱의 항목을 포함한 검사, 워크플로 실행, 상태가 이제 아티팩트와 로그의 보존 기간 설정을 따르며, 해당 기간을 넘기면 삭제된다. 공개 저장소에서는 최대 90일까지 보존할 수 있으며, 삭제 후에는 복원할 수 없다. 🔗 출처
- 코드 스캔과 휴면 저장소 — 코드 스캔과 GitHub Code Quality의 주간 예약 분석은 이제 푸시나 풀 리퀘스트로 실행된 분석이 있어야 시작된다. 이로써 휴면 저장소가 추가로 6개월 동안 활성 상태인 것처럼 보이는 일을 방지한다. 🔗 출처
- 코드 커버리지 — GitHub Code Quality의
upload-code-coverage액션은 아직 열린 풀 리퀘스트가 없는 브랜치에 푸시할 때 더 이상 CI를 실패시키지 않는다. 🔗 출처 - 접근성 선언 — 루트,
.github/또는docs/에 둔ACCESSIBILITY.md파일이 github.com의 모든 요금제에서 저장소 첫 화면에 눈에 띄게 표시된다. GitHub Enterprise Server 3.24에도 도입될 예정이다. 🔗 출처 - Actions Runner Controller 0.15.0 — 자체 호스팅 러너용 Kubernetes 컨트롤러가 패치 버전 업그레이드 때 리소스를 제자리에서 업데이트한다. 종료 대기 시간, Kubernetes 클라이언트 제한, 컨트롤러 동시 실행 수를 설정할 수 있게 하고 요청 부담도 줄였다. 🔗 출처
- 먼저 제안하는 Grok Bot — 사용자의 기본 Bot이 이제 대신 처리할 수 있는 작업을 찾아 맡겠다고 제안한다. 배포는 몇 시간에 걸쳐 진행되며, 이러한 제안은 사용량에서 차감되지 않는다. 적용 요금제나 국가는 명시되지 않았다. 🔗 출처
- Genspark와 Azure Cosmos DB — Genspark의 관점에서 작성된 Azure Cosmos DB 블로그 글은 일부 백그라운드 처리를 전역 보조 인덱스로 넘겨 실시간 에이전트 세션을 느리게 하지 않는 방식을 설명한다. 수치는 제시하지 않았다. 🔗 출처
- Genspark 활용 경험담 — 마케팅 경력 15년의 강슬기는 기존 문서를 SecondBrain에 연결한 뒤 AI Slides로 연계해, 전체 수업 자료를 준비하는 시간을 30시간에서 5시간으로 줄였다고 밝혔다. 새 제품 기능 발표는 없다. 🔗 출처
- Albertsons와 OpenAI — 2,200개 이상의 매장을 운영하는 유통업체가 협력을 확대한다. 선정된 팀의 ChatGPT Enterprise 사용에서 고객 경험과 판촉 분석을 위한 API 활용으로 범위를 넓히며, 8월 5일 발표한 ChatGPT용 Safeway 플러그인도 강조했다. 🔗 출처
- 영원한 보완재 — OpenAI가 앞으로의 경제를 다루는 연재의 첫 에세이를 공개했다. 필자인 헤만트 아시르바탐과 엘리엇 목스키는 개인 의견임을 명시하며, 기계 지능의 대부분이 획기적 발견보다 실행에 쓰일 수 있다고 주장했다. 🔗 출처
- Perplexity와 컨설턴트 — 한 안내서가 AlphaSense부터 Qwilr까지 컨설턴트용 AI 도구 10개를 9월에 확인한 가격과 함께 비교한다. 자주 묻는 질문에서는 거부 의사를 밝히지 않으면 Perplexity 무료 요금제가 사용자 데이터로 모델을 학습한다는 점을 상기시킨다. 🔗 출처
- Luma Variants — 전날 자세한 설명 없이 소개됐던 기능이 모든 Luma 사용자에게 출시됐다. 승인된 정적 광고를 바탕으로 9:16부터 16:9까지 5가지 표준 형식과 여러 언어의 변형을 생성한다. 가격은 발표하지 않았다. 🔗 출처
- HeyGen Professional Voice Clone — HeyGen의 9월 정리에 따르면, 9월 9일 비공개 사전 체험을 시작한 뒤 가장 충실한 음성 복제 기능을 API로 제공한다. 학습에는 최소 20분 분량의 녹음과 1~10개 파일을 사용한다. 🔗 출처
- Pika와 앱들 — Pika는 새 플랫폼에 40개가 넘는 앱이 있다고 밝히고, 두 등장인물이 토론하는 Podcast Video와 이미지나 영상 클립의 색을 보정하는 Color Grade를 소개했다. 날짜나 가격은 제시하지 않았다. 🔗 출처
- 베네룩스의 ElevenLabs — ElevenLabs가 브뤼셀과 암스테르담에 사무실을 열고 현지 팀 규모를 세 배로 늘릴 계획이다. 통신사 KPN에서는 우편번호 인식률이 64%에서 82%로 올랐으며, 확인용 에이전트가 매주 약 60,000건의 통화를 처리한다. 🔗 네덜란드 · 🔗 벨기에
- NVIDIA의 DOCA Skills — 개발자의 실제 프롬프트 65개를 대상으로, BlueField DPU용 Skills를 갖춘 코드 에이전트는 평가표 기준을 100% 충족했다. Skills가 없을 때는 19%였다. 해당 Skills는 GitHub에 공개됐다. 🔗 출처
- DIN Deploy — NVIDIA가 Windows와 Linux에서 ONNX Runtime과 TensorRT RTX로 모델을 로컬 실행하는 오픈 소스 C++ 예제를 공개했다. DGX Spark에서 Parakeet TDT는 GPU로 실시간보다 206배 빠르게 전사하며, CPU에서는 14배 빠르다. 🔗 출처
- Nemotron 3.5 ASR과 사우디 방언 — NVIDIA 튜토리얼은 나지드와 히자즈 방언으로 모델을 미세 조정한다. RTX PRO 6000 두 개에서 12,000단계 학습 후 단어 오류율이 55.05%에서 29.96%로 낮아졌으며, FLEURS의 영어와 아랍어 성능도 조금 향상됐다. 🔗 출처
- Dynamo-Triton에서 실행하는 HSTU 추천 모델 — NVIDIA가 PyTorch AOTInductor와 KV 캐시를 사용해 HSTU 생성형 추천 모델을 제공한다. RTX PRO 6000에서 가장 좋은 경우 층 수에 따라 최대 4.47배와 5.93배 빠르며, 요청당 0.423ms와 0.678ms가 걸린다. 🔗 출처
- AI 공장의 수익성 — NVIDIA는 입장을 설명하는 글에서 AI 공장 비용을 메가와트당 약 6,000만 달러로 추산하고 SemiAnalysis 데이터를 인용했다. DeepSeek V4 Pro에서 Vera Rubin NVL72의 토큰 100만 개당 비용은 GB300 NVL72의 최대 45분의 1로, 8월 24일 제시한 35분의 1보다 더 낮아졌다. 🔗 출처
- huggingface_hub 2.1.0 — 이 라이브러리는 실패한 Jobs를 자동으로 재시도하고, 다시 생성하지 않고 일정을 변경하며, 남은 ZeroGPU 할당량을 읽고
hf_xet로 Xet 파일을 다운로드한다. HF Jobs에서 2GB parquet 파일 다운로드 시간이 약 120초에서 7초로 줄었다. 하위 호환성을 깨는 변경 사항은 세 가지다. 🔗 출처 - ML Intern과 MCP — Hugging Face가 모델을 학습하는 HuggingChat 모드인 ML Intern에 MCP 데이터 소스를 연결한다. 이를 통해 자체 업무 데이터로 개방형 모델을 미세 조정할 수 있다. 발표에는 공식 수치가 없다. 🔗 출처
- Hugging Face와 Open Source for Science Fund — 두 파트너는 과학 모델 기여자들이 가장 많이 의존하는 라이브러리를 찾아 유지관리자를 지원하려 한다. 금액이나 일정은 제시하지 않았다. 🔗 출처
- TRL로 매월 100만 회 학습 — 캉탱 갈루에덱이 인용한 원격 측정 데이터에 따르면, Hugging Face의 사후 학습 라이브러리는 매월 100만 회의 학습에 사용되며, 주당 100만 회를 목표로 한다. 집계 방식은 공개하지 않았다. 🔗 출처
- Hub의 데이터셋 100만 개 — 세 저자는 조직 계정이 데이터셋의 약 19%를 게시하면서 다운로드의 절반을 차지하며, 가장 많이 다운로드된 데이터셋 1,000개 중 390개가 미국에 속한다는 점을 보여준다. 🔗 출처
- RTX 3090 한 장에서 비교한 VLM 8개 — ThinkEvolve의 아카시 굽타는 정확도가 같을 때 Qwen3-VL-8B가 각 요청을 Qwen3.8-27B보다 2.2배 빠르게 처리하지만, 접두사 캐시를 재사용하지 못해 7,329회 호출 작업에는 7.53시간이 아닌 18.88시간이 걸린다고 보여준다. 🔗 출처
- GLiNER2.5-Decide와 layax 비교 — 아라빈드 비자야쿠마르는 Fastino 모델에 대해 어떤 신뢰도 임계값도 검증하지 못했다. 반면 자신의 도구인 layax는 10번의 실험 모두에서 검증에 성공했고, 정확도가 20~23%포인트 더 높으며 약 5배 빠르다. 🔗 출처
- 데이비드 하와 오케스트레이터 — Sakana AI의 공동 창업자이자 최고경영자는 Nikkei Asia 기고문에서 가치가 모델 가중치에서 여러 모델을 결합하는 지능으로 이동할 것이라고 전망하고, 주권을 공급망의 견고함으로 정의했다. 🔗 출처
- TPU에서의 영상 확산 — Google 엔지니어 세 명이 Sparse VideoGen의 희소 어텐션과 최적화된 Splash Attention 커널을 사용해, TPU v6e 칩 8개에서 1440p 영상의 노이즈 제거 시간을 2,471초에서 1,461초로 줄였다. 속도는 1.69배 빨라졌다. 🔗 출처
이것이 의미하는 것
코드 에이전트는 사용자가 직접 프로그래밍할 수 있는 도구로 바뀌고 있다. Claude Code는 mods를 통해 내부 이벤트를 작은 TypeScript 함수에 노출하며, 자체 기능까지 교체 가능한 mods로 전환한다. GitHub의 동적 워크플로는 Copilot이 매번 작업 분할을 결정하게 하는 대신, 하위 에이전트의 조율 방식을 코드로 작성하게 한다. FineEnvs 안내서는 실행 환경이 모델만큼 중요한 이유를 상기시킨다. 같은 가중치로도 한 실행 환경에서는 작업의 62%를 해결하고 다른 환경에서는 33%만 해결한다. 그에 따라 신뢰 문제가 뒤따른다. mod는 Claude Code와 동일한 수준으로 컴퓨터에 접근할 수 있고, copilot workflow run는 확인 메시지를 표시하지 않으며, 데스크톱 앱 제어는 로그인된 계정에 작업을 수행할 수 있다. 두 개발사는 데스크톱 제어를 기본적으로 비활성화하고, mods 설치 전에 검증(claude plugin validate)을 수행하며, 기업 규칙을 우선 적용하는 방식으로 대응한다.
AI는 그 결과물을 받는 사람들에게도 새로운 필터를 요구한다. AI로 생성된 보고서가 유지관리자를 압도하기 때문에 GitHub는 비공개 취약점 신고를 구조화하고 건수를 제한한다. Google DeepMind는 DNA 합성 업체가 출처를 모르는 서열이 어디서 왔는지 알 수 있도록 AI로 설계한 단백질에 워터마크를 넣자고 제안한다. 두 경우 모두 목표는 AI를 금지하는 것이 아니라 사용 사실을 드러내는 것이다. 한쪽은 AI의 도움을 받았음을 밝히는 체크란을, 다른 쪽은 검증 가능한 서명을 사용한다.
기업의 도입 수준은 이제 구체적인 활용으로 측정된다. Barclays는 2026년 말까지 개발자의 50%가 Claude Code를 사용하도록 목표를 정하고 하루 120,000건의 이메일을 분류하게 한다. American Express는 무료 크레딧을 제공하며 Business 카드를 Perplexity Computer의 Skills를 이용하는 관문으로 삼는다. Anthropic은 아티팩트 생성 이후 이어지는 작업의 사용량 차감을 2주 동안 절반으로 줄여 사용 한도를 유인책으로 활용한다. 일반 대중에게는 보조 도구가 구체적인 일상 행동에 자리 잡고 있다. 시각장애인에게 메뉴를 읽어주고, 구매 전에 옷을 입어보고, 대화 안에서 주가 차트를 그리는 식이다.
마지막으로 모델 수치는 평가 절차와 함께 읽어야 한다. Ai2는 1조 2,000억 매개변수 규모의 측정이 학습된 모델 하나가 아니라 시스템을 평가한 것이라고 명시한다. Cloudflare는 벤치마크를 직접 선택하며 When2Call과 BRIGHT에서는 Jev가 여전히 앞선다는 점을 인정한다. Artificial Analysis의 영상 순위에서는 Wan 3.0이 선두지만 신뢰 구간이 서로 겹친다. FLUX 3 Image는 이제 흔해진 경로를 따른다. 상용 라이선스 가중치는 곧바로 제공하고, 개방형 가중치는 나중에 공개하되 날짜는 제시하지 않는다.
출처
- TypeScript의 mods로 Claude Code 사용자 지정 (claude.com)
- claude.dev의 mods 시작 가이드
- Claude Code mods 문서
- X에서 보리스 체르니의 반응
- Claude Code 2.1.287 릴리스 노트
- 데스크톱 애플리케이션 제어에 관한 GitHub 변경 내역
- 동적 워크플로에 관한 GitHub 변경 내역
- @bfl_ai의 FLUX 3 Image 발표
- FLUX 3 Image 모델 페이지
- Gemini Live의 Guided Vision (Google 블로그)
- ChatGPT 릴리스 노트
- Perplexity Computer의 대화형 차트
- @claudeai가 발표한 아티팩트 혜택
- 아티팩트 혜택 이용 조건 (Claude 도움말 센터)
- Barclays와 Claude (Anthropic)
- American Express에 관한 Perplexity 게시글
- Perplexity의 American Express 파트너 페이지
- @Alibaba_Wan의 Wan 3.0 발표
- Artificial Analysis의 AA-Video-T2V v2.0 순위
- Artificial Analysis 순위에 오른 Utopai X
- @runwayml의 Project Continuum
- @synthesiaIO의 Sessions 발표
- Synthesia Sessions 페이지
- SynthID Bio (Google DeepMind)
- Claude가 빚어낸 과학 (Anthropic Science)
- Olmo-core 3 (Ai2)
- Olmo-core v3.0.0 릴리스
- Clef와 Clef-flash (Cloudflare 블로그)
- Hugging Face의 Clef
- FineEnvs의 다중 하네스 RL 가이드
- Google Cloud의 Grok 4.7 모델 정보
- @SpaceXAI의 Google Cloud용 Grok 4.7 발표
- 비공개 취약점 신고용 구조화된 양식
- 비공개 취약점 신고의 일일 한도
- Codex CLI 0.160.0
- Delta 0.18.0 릴리스 노트
- Antigravity 애플리케이션 변경 내역
- Antigravity CLI 변경 내역
- Copilot CLI 1.0.91
- Codex CLI 0.159.3
- 10월 1일 Gemini CLI Nightly
- Zed 1.23.1 미리 보기
- VS Code의 Copilot 9월 소식 정리
- Delta에서 함께 계획하기
- Cursor의 Innate 소개
- funes를 활용한 세션 기억 벤치마크
- 새로운 GitHub 대시보드
- GitHub의 비동기 병합 API
- Dist-tags와 npm 신뢰 게시
- GitHub Actions 보존 기간
- 코드 스캔과 비활성 저장소
- 코드 커버리지 업로드
- 저장소 접근성 선언
- Actions Runner Controller 0.15.0
- Grok Bot의 제안
- Genspark와 Azure Cosmos DB
- 강슬기의 사용 후기 (Genspark)
- Albertsons Companies와 OpenAI
- 영원한 보완재 (OpenAI)
- 컨설턴트를 위한 Perplexity의 AI 도구 가이드
- Luma Variants
- HeyGen의 9월 소식 정리
- Pika 애플리케이션
- 네덜란드의 ElevenLabs
- 벨기에의 ElevenLabs
- NVIDIA의 DOCA 스킬
- NVIDIA의 DIN Deploy
- Nemotron 3.5 ASR과 사우디 방언
- Dynamo-Triton 기반 HSTU 추천 시스템
- AI 공장의 수익성 (NVIDIA)
- huggingface_hub 2.1.0
- ML Intern과 MCP 데이터 소스
- Open Source for Science Fund와 Hugging Face
- TRL을 활용한 100만 회의 학습
- Hub의 데이터셋 100만 개
- RTX 3090에서 측정한 VLM 8개
- GLiNER2.5-Decide와 layax의 비교
- Sakana AI가 공유한 데이비드 하의 기고문
- TPU에서 가속한 비디오 디퓨전