ai-powered-markdown-translatorArtículo traducido del fr al es con gpt-6.1-sol.
El jueves 1 de octubre, Anthropic lanza los mods, pequeñas funciones TypeScript que se conectan a los eventos de Claude Code para reescribir su comportamiento y su interfaz, incluidas en la versión 2.1.287. GitHub abre el mismo día en versión preliminar pública dos capacidades de agente en Copilot CLI y la app GitHub Copilot: el control de las aplicaciones de escritorio y los workflows dinámicos, orquestaciones escritas en código. Black Forest Labs lanza FLUX 3 Image, que compone mediante cajas delimitadoras y genera hasta en 4K; Google despliega Guided Vision en Gemini Live, Barclays extiende Claude a todo el banco y GitHub endurece la notificación de vulnerabilidades ante los informes generados por IA.
Claude Code se abre a los mods, funciones TypeScript que reescriben su comportamiento y su interfaz
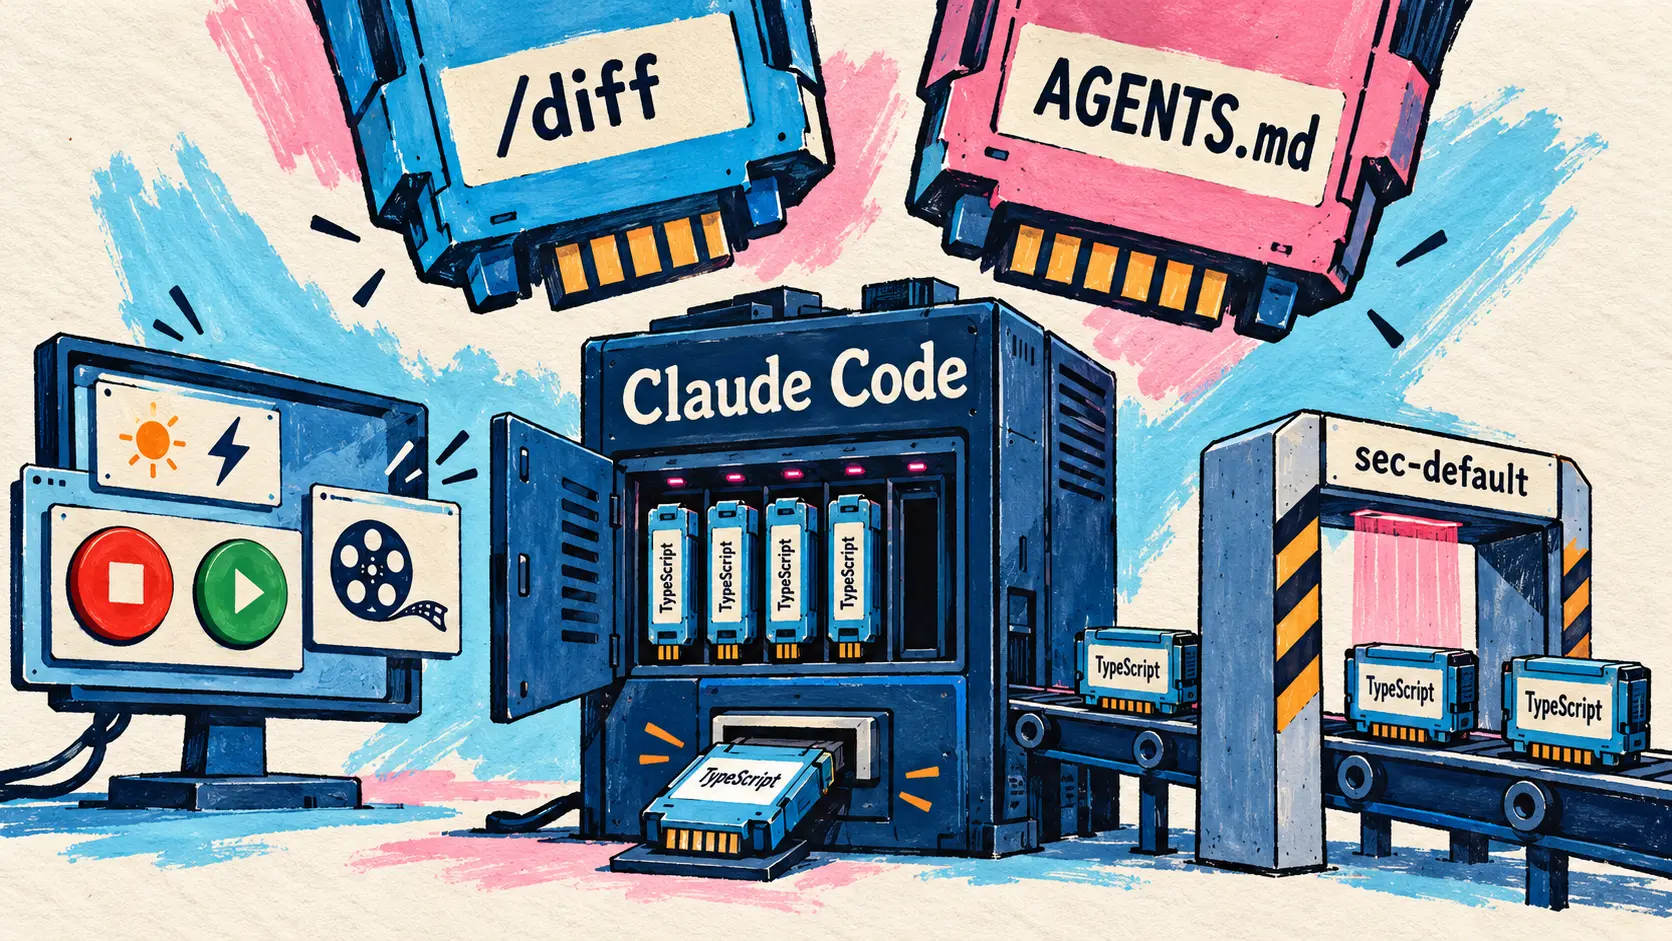
1 de octubre — Anthropic lanza los mods, pequeñas funciones TypeScript que cambian el funcionamiento de Claude Code. Cada acción de la herramienta emite un evento (llamada a una herramienta, solicitud de permiso, envío de un prompt, inicio y final de un turno, renderizado de una parte de la pantalla), y un mod se conecta a él antes, después, en su lugar o envolviéndolo. Puede reescribir un prompt antes de que llegue al modelo, bloquear, reescribir o volver a ejecutar una llamada a una herramienta, aprobar o denegar un permiso, ocultar secretos en la salida de una herramienta antes de que Claude la lea, o añadir sus propios paneles, botones y campos de entrada. Los mods se distribuyen en plugins, se instalan con /plugin y se comparten como ellos; llegan con Claude Code 2.1.287 y están activados por defecto. No hace falta conocer la API para empezar: se puede pedir a Claude Code que escriba el mod, y este produce el TypeScript, lo instala y lo recarga en caliente en la sesión.
La diferencia con los hooks existentes es clara. Un hook de configuración (settings hook) ejecuta un comando shell con cada evento; un mod se carga una vez y permanece en la sesión, de modo que conserva un estado, redibuja la interfaz a medida que se producen eventos y puede registrar comandos slash o herramientas que el modelo llama. Anthropic ya los utiliza para sus propias funciones: el panel /diff y la compatibilidad con AGENTS.md se han convertido en mods integrados, que se pueden desactivar o sustituir, y la empresa prevé convertir otras con el tiempo para que se pueda reducir Claude Code a un pequeño núcleo. Entre los seis mods integrados que enumera la documentación figura You should know, desactivado por defecto, en el que un agente secundario señala lo que el usuario o Claude podrían pasar por alto.
| Aspecto de los mods | Detalle oficial |
|---|---|
| Versión mínima | Claude Code 2.1.287, mods activados por defecto |
| Interfaces con visualización | CLI en terminal, pestaña Code de Claude Desktop (excepto las sesiones WSL) |
| Interfaces sin visualización | Extensión VS Code, claude -p, Agent SDK y sesiones cloud, donde se ejecutan los hooks |
| Mods integrados | 6, incluidos /diff, AGENTS.md, sec-default y You should know |
| Tiempo propio de un hook | 10 segundos por activación |
| Desactivación | /plugin para un mod, --safe-mode para una sesión, disableAllHooks para todos |
La guía de inicio de Addy Osmani en claude.dev construye Token Weather, un mod de unas 80 líneas que muestra encima del prompt el «tiempo» del contexto, con un pequeño gráfico de los 12 últimos turnos. También presenta Blast Radius, que retiene un rm -rf, un git reset --hard o un push forzado mientras muestra a qué afectaría, y Replay Theater, que reproduce las modificaciones de archivos de un turno.
La confianza sigue siendo el punto delicado. El artículo advierte de que los mods no están aislados: tienen el mismo acceso a la máquina que Claude Code, y la documentación precisa que un mod puede leer las variables de entorno y los archivos de configuración, ver cada prompt, aprobar una llamada a una herramienta o consumir el uso del plan, pero no modificar la solicitud de permiso. Sin embargo, la guía de claude.dev describe un módulo que se ejecuta en su propio entorno aislado, sin DOM ni Node, con toda acción externa pasando por la API $: esto es lo que permite a claude plugin validate enumerar, antes de la instalación, los eventos que intercepta un mod y las llamadas que realiza. En Team y Enterprise, y en cualquier máquina con configuración administrada, el mod integrado sec-default se carga primero e impide que los mods instalados por el usuario eludan las reglas de denegación; los administradores pueden colocar sus propios mods antes que él.
Mods are absolutely insane. You can now customize Claude to work and look the way you want by just prompting it. Each person works differently, so there’s no reason why everyone should have an identical Claude experience. Make Claude your own, and share mods as plugins so others can try your mods too.
🇪🇸 Los mods son una auténtica locura. Ahora pueden personalizar Claude para que trabaje y se muestre como ustedes quieran, con solo pedírselo. Cada persona trabaja de forma distinta, así que no hay ninguna razón para que todo el mundo tenga una experiencia idéntica con Claude. Hagan suyo Claude y compartan sus mods en forma de plugins para que otros puedan probarlos. — @bcherny en X
El lanzamiento era esperado: Boris Cherny lo había anunciado el 14 de septiembre, y Anthropic había compartido el diseño en GitHub (issue #91870). El artículo y la guía de claude.dev invitan a enviar los mods al directorio de Claude.
🔗 Personaliza Claude Code con mods en TypeScript · Guía de inicio en claude.dev · Documentación de los mods
Claude Code 2.1.287: contexto de 1M por defecto en los proveedores cloud y 67 correcciones
1 de octubre — Claude Code 2.1.287 es la versión que incorpora los mods, pero cuenta con 106 entradas, incluidas 67 correcciones. Para las empresas, en Bedrock, Vertex, Foundry y la pasarela Claude apps, Opus 4.7 y las versiones posteriores, así como Fable, utilizan ahora por defecto una ventana de contexto de 1M, sin el sufijo [1m]; CLAUDE_CODE_DISABLE_1M_CONTEXT=1 permite mantenerla en 200K. /advisor acepta Sonnet 5.5 como asesor de Opus 4.7 y 4.8, un cambio automático de modelo conserva el nivel de esfuerzo actual, y los servidores MCP con el protocolo 2025-11-25 pueden abrir solicitudes de URL. Un rm peligroso mantiene su confirmación incluso cuando el comando redirige su salida a ~ o a un comodín, las solicitudes de permiso pendientes se muestran de la más antigua a la más reciente, y nueve entradas mejoran el modo de lector de pantalla. En VS Code, un comando o un subagente en ejecución puede pasar a segundo plano (Run in background).
🔗 Notas de la versión de Claude Code 2.1.287
GitHub Copilot: el control de las aplicaciones de escritorio y los workflows dinámicos en versión preliminar pública
1 de octubre — GitHub abre el mismo día dos capacidades de agente en versión preliminar pública en Copilot CLI y la app GitHub Copilot: el control de las aplicaciones de escritorio y los workflows dinámicos, también disponibles en el GitHub Copilot SDK.
Copilot controla las aplicaciones de escritorio. El control del ordenador (computer use) llega a macOS y Windows. Copilot lee el contenido accesible de una ventana y su contexto visual, mediante el árbol de accesibilidad del sistema o capturas de pantalla cuando hace falta, hace clic en controles, introduce texto, pulsa teclas, se desplaza, arrastra y suelta, y encadena pasos de una aplicación a otra; la demostración lo muestra rellenando un informe de gastos en Safari. GitHub apunta a programas antiguos o puramente gráficos, sin API, sin interfaz de línea de comandos ni integración MCP, y la documentación recomienda estas vías cuando existen, porque ofrecen resultados más predecibles. La función está desactivada por defecto: /computer on la activa en la CLI, /computer show muestra su estado y /computer off la desactiva, mientras que la app la ofrece en su configuración. Copilot solicita autorización antes de controlar cada aplicación: se puede conceder para la sesión, guardarla para las siguientes o denegarla. Una aprobación permanente (Always allow) se aplica a la CLI y a la app en la misma máquina, pero una regla de denegación siempre prevalece, y pulsar dos veces Esc en la CLI, o el botón Stop en la app, interrumpe una acción que se desvía de lo previsto. La configuración administrada de una organización puede desactivar la función, sin que una activación local pueda anularla. GitHub advierte de que una instrucción ambigua o un contenido inesperado en la pantalla puede provocar acciones no deseadas en cuentas con sesión iniciada, incluidas las financieras, y desaconseja la aprobación permanente para las aplicaciones sensibles. No se especifican los planes afectados ni ninguna cifra; el comando /computer ya figuraba en las notas de Copilot CLI 1.0.85, el 16 de septiembre.
🔗 GitHub Copilot ya puede interactuar con aplicaciones de escritorio mediante computer use
Orquestaciones escritas en código. Los workflows dinámicos (dynamic workflows), disponibles en todos los planes de Copilot, describen en un programa cómo llevar a cabo una tarea: el código fija los pasos, el momento en que interviene un agente y el uso de sus resultados, en secuencia, en paralelo o de ambas formas, y los agentes se encargan de lo que requiere análisis o juicio. Un workflow puede ejecutar comandos, dividir un objetivo en tareas paralelas, transmitir resultados estructurados de una etapa a otra, hacer que otro subagente verifique los hallazgos de uno y detenerse en un punto de control (checkpoint) para una revisión antes de continuar. GitHub cita la investigación de un incidente, la revisión en paralelo de los archivos de una pull request, o comentarios de revisión sometidos a dos modelos y señalados solo si ambos coinciden.
| Modo de Copilot | Quién organiza el trabajo, según la documentación |
|---|---|
| Autopilot | Copilot, que avanza sin pedir validación después de cada etapa |
/fleet | Copilot, que divide la tarea cada vez entre subagentes en paralelo |
| Workflow dinámico | El código escrito por el autor: etapas, condiciones y relevos |
El programa reside en una extensión de Copilot CLI y de la app. Un workflow escrito por Copilot queda limitado a la sesión, pero se reutiliza copiando la extensión en su directorio personal, se comparte mediante el de un repositorio o se empaqueta en un plugin. Los subagentes heredan las autorizaciones de la sesión, mientras que el comando copilot workflow run no muestra ninguna solicitud: hay que conceder los permisos antes de ejecutarlo. Disponibles sin configuración en la app, los workflows requieren activar las funciones experimentales en la CLI (--experimental o /experimental on). GitHub no publica ninguna cifra ni regla de facturación, y el nombre recuerda, sin que se haya anunciado relación alguna, a los Dynamic Workflows lanzados por Anthropic en Claude Code el 28 de mayo.
🔗 Workflows dinámicos en Copilot CLI y la app Copilot
FLUX 3 Image: Black Forest Labs compone mediante cajas delimitadoras y genera hasta en 4K
1 de octubre — Black Forest Labs (BFL) añade un modelo de imagen a su familia FLUX 3, con una consigna: controlar cada píxel. FLUX 3 Image retoca una zona en varias pasadas sucesivas sin modificar el resto de la imagen, y acepta varias modificaciones en una misma solicitud.
La novedad más visible es la composición mediante cajas delimitadoras (bounding boxes). Sea cual sea el formato, la imagen se convierte en un sistema de coordenadas de 0 a 1000 en cada eje: se traza una caja por elemento, se describe su contenido, luego se resume la escena en una línea, y el modelo coloca cada elemento en su caja; sigue siendo posible usar solo un prompt de texto. FLUX 3 Image también combina hasta 10 imágenes de referencia, citadas mediante tokens en el prompt, cuya ubicación y tamaño decide por sí mismo. BFL lo presenta como «diseñado para agentes»: un LLM puede redactar la tabla de elementos y sus cajas a partir de una simple petición, que el usuario ajusta antes de iniciar la generación.
| Característica anunciada | Detalle comunicado por BFL |
|---|---|
| Resolución nativa | 2K y 4K (ejemplo de la página del modelo: 5456 × 3072 píxeles, 16,8 MP) |
| Imágenes de referencia | Hasta 10 |
| Composición | Cajas delimitadoras en una cuadrícula de 0 a 1000 por eje |
| Edición | Varios turnos, sin modificar los demás píxeles |
| Oferta de la API | 50 % de descuento hasta el 8 de octubre |
| Pesos del modelo | Comerciales bajo licencia; pesos abiertos «en las próximas semanas» |
En cuanto al acceso, FLUX 3 Image está disponible a través de la API con un 50 % de descuento hasta el 8 de octubre, y BFL ofrece pesos comerciales bajo licencia a las empresas que quieren ajustarlo y desplegarlo en su propia infraestructura. La versión con pesos abiertos se anuncia sin fecha. No se había publicado ninguna tarifa base ni benchmark con cifras en el momento del anuncio. El modelo completa una serie lanzada este verano: FLUX 3, modelo multimodal unificado (23 de julio), FLUX 3 Video (4 de agosto), su modo de edición (10 de septiembre) y FLUX 3 Action para la robótica (23 de septiembre).
🔗 Anuncio de FLUX 3 Image por @bfl_ai · Página del modelo FLUX 3 Image
Asistentes para el público general: Guided Vision en Gemini Live, prueba virtual en ChatGPT, gráficos en Perplexity Computer, límites más flexibles para los artefactos de Claude
Guided Vision: Gemini Live guía a las personas ciegas y con baja visión
1 de octubre — Google despliega Guided Vision en Gemini Live en Android 9 y versiones posteriores, en las regiones e idiomas donde Gemini Live está disponible. Diseñada con personas ciegas y con baja visión, la función describe en tiempo real lo que capta la cámara compartida, responde a preguntas de seguimiento y da instrucciones verbales para ajustar el encuadre: girar lentamente hacia la derecha, inclinar hacia abajo, retroceder. Google menciona la lectura de una etiqueta nutricional o de un menú en un restaurante oscuro, la búsqueda de un auricular caído o la descripción de los colores de una prenda. Para entrenarla, Google se ha asociado con Aira, un servicio de interpretación visual: decenas de miles de horas de datos, más de 1 000 participantes en las pruebas de su red y especialistas que participaron en las medidas de protección. Guided Vision se activa desde el perfil de la aplicación Gemini, mediante un acceso directo de accesibilidad de Android o desde TalkBack. Google precisa que no es un dispositivo médico ni una ayuda para la movilidad: la función no sustituye al bastón blanco.
🔗 Guided Vision en Gemini Live (blog de Google)
ChatGPT: prueba virtual y favoritos para las compras
1 de octubre — Según las notas de la versión de ChatGPT, aparece un botón para probarse prendas (Pruébatelo) en las fichas de ropa y accesorios: se toma o se sube un selfie, y ChatGPT Images genera una prueba virtual del artículo. La foto de referencia se conserva para las siguientes pruebas; se puede sustituir o eliminar en los ajustes, en la sección de fotos de referencia (Configuración → Personalización → Fotos de referencia). También se puede guardar cualquier producto en favoritos o colocarlo en una carpeta de la biblioteca de ChatGPT. Ambas funciones están disponibles en móviles y en la web, pero la nota no precisa ni los planes ni los países a los que se aplican. ChatGPT ya ofrecía compras visuales desde el 24 de marzo.
🔗 Notas de la versión de ChatGPT
Perplexity Computer genera gráficos interactivos
1 de octubre — Perplexity Computer ahora crea gráficos y visualizaciones interactivas directamente en el hilo de la conversación. Para los datos financieros, el agente utiliza Lightweight Charts de TradingView para mostrar velas, volumen y medias móviles. El anuncio se limita a un tweet acompañado de un vídeo: no indica qué planes se benefician ni en qué plataformas, y todavía no hay ninguna entrada del changelog que lo detalle. ChatGPT y Claude ya habían dado este paso el 10 y el 12 de marzo, y Replit Agent el 25 de septiembre.
🔗 Anuncio de @perplexity_ai en X
Claude reduce a la mitad el consumo de los límites tras un artefacto, hasta el 15 de octubre
1 de octubre — Desde el 1 de octubre a las 11 h PT hasta el 15 de octubre a las 23 h 59 PT, crear o modificar un artefacto (documento, presentación o diseño) en Claude o Claude Cowork hace que el trabajo posterior consuma un 50 % menos del límite de sesión de cinco horas. La oferta se aplica automáticamente a los planes Pro, Max y Team; el plan Free y los planes Enterprise quedan excluidos, y el límite semanal no cambia.
| Entorno al que se aplica | Alcance del descuento del 50 % |
|---|---|
| Conversación iniciada desde el menú Output | Desde el primer mensaje: 10 mensajes, 15 pasos por respuesta |
| Conversación normal | Los 10 mensajes posteriores a la creación del artefacto, 15 pasos por respuesta |
| Tarea Cowork en el cloud iniciada desde Output | Aproximadamente los primeros 45 minutos |
| Otra tarea Cowork en el cloud | Hasta 80 pasos después de crear o modificar un artefacto |
Claude Code, la API, Claude en Slack, las tareas Cowork locales o programadas, los créditos de uso y la aplicación independiente Claude Design quedan excluidos. Anthropic sugiere probar con Sonnet 5.5 y se reserva el derecho de modificar o finalizar la oferta antes de tiempo.
🔗 Anuncio de @claudeai en X · Condiciones de la oferta (centro de ayuda de Claude)
Finanzas: Barclays amplía Claude a todo el banco, American Express da acceso a Perplexity Computer a sus clientes Business
Barclays aspira a que la mitad de sus desarrolladores use Claude Code para finales de 2026
1 de octubre — Barclays, el banco universal británico, amplía su colaboración con Anthropic y despliega Claude en toda la organización para acelerar el desarrollo de software, modernizar los sistemas antiguos y mejorar la eficiencia operativa. El banco prevé que el 50 % de sus desarrolladores adopte Claude Code para finales de 2026, y que una mayoría de sus ingenieros de software lo haga en 2027. Ya hay cifras de dos usos. Colleague Knowledge Assistant, en servicio desde 2025 y construido sobre Claude con una arquitectura de generación aumentada por recuperación (RAG), ha sido adoptado por más de 16 000 empleados y ha procesado más de un millón de búsquedas; ayuda a los equipos que atienden a más de 20 millones de clientes particulares en el Reino Unido. En la actividad de Global Markets, los modelos Claude clasifican, enriquecen y derivan unos 120 000 correos electrónicos al día. Paul Smith, director comercial de Anthropic, lo considera un paso importante para la empresa en el Reino Unido; no se comunica ningún importe ni duración del contrato.
Perplexity y American Express: diez Skills profesionales en Computer para las tarjetas Business
1 de octubre — Perplexity lanza una colección de Skills listas para usar en Perplexity Computer, reservada a los titulares estadounidenses de una tarjeta American Express Business suscritos a Perplexity Enterprise. El directivo elige una tarea y la concreta en un formulario en lugar de escribir una consulta. Las diez Skills cubren la previsión de tesorería, la preparación fiscal, la comparación de proveedores, los escenarios presupuestarios, la conciliación, las campañas de marketing, la previsión de la demanda, el retorno del gasto publicitario por canal (ROAS), el seguimiento de las operaciones y la contratación de personal. La tarjeta se vincula a través de Plaid desde Personal CFO, y cada ejecución consume créditos Computer según la complejidad de la tarea. La página del socio añade, hasta el 29 de marzo de 2027, un crédito único de 125 dólares por una compra de al menos 325 dólares de un plan Enterprise Pro o Enterprise Max, y 1 000 créditos Computer gratuitos una vez por cuenta. Las tarjetas Corporate quedan excluidas, y los resultados no constituyen asesoramiento financiero, fiscal, jurídico o contable.
🔗 Entrada de Perplexity · Página del socio American Express
Vídeo generativo y avatares: Wan 3.0 encabeza Artificial Analysis, Project Continuum de Runway, Sessions de Synthesia
Wan 3.0 encabeza la nueva clasificación de vídeo de Artificial Analysis
1 de octubre — Alibaba reivindica el primer puesto de Wan 3.0 en la nueva clasificación de texto a vídeo de Artificial Analysis, AA-Video-T2V v2.0, lanzada el 30 de septiembre con una nueva metodología: cada modelo se evalúa en 1080p con un conjunto de prompts renovado regularmente, y la sincronización del sonido cuenta en la puntuación. La disputa por el podio es reñida, con intervalos de confianza que se solapan.
| Modelo clasificado | Puntuación Elo | Intervalo de posición | Precio por API |
|---|---|---|---|
| Wan 3.0 | 1157 (±9) | 1 a 2 | 12,00 dólares por minuto |
| Utopai X (basado en MiniMax H3) | 1150 (±10) | 1 a 3 | Sin API pública |
| Dreamina Seedance 2.5 | 1144 (±9) | 2 a 4 | 34,12 dólares por minuto |
| MiniMax H3 (768p) | 1139 (±9) | 3 a 5 | 4,80 dólares por minuto |
La sorpresa de la clasificación es Utopai X, lanzado el 30 de septiembre por Utopai Studios, un estudio de cine y televisión nativo de IA. Tras un entrenamiento adicional sobre MiniMax H3, solo está disponible en la plataforma PAI del estudio (93 créditos por segundo de vídeo, suscripciones desde 15 dólares al mes), y supera al propio MiniMax H3.
🔗 Anuncio de @Alibaba_Wan en X · Clasificación AA-Video-T2V v2.0 · Utopai X según @ArtificialAnlys
Runway Labs presenta Project Continuum, interfaces generadas mediante vídeo en tiempo real
1 de octubre — Runway Labs, la unidad exploratoria de Runway, muestra Project Continuum, una aplicación de investigación que imagina un sistema operativo cuya interfaz se generaría mediante vídeo, en tiempo real, en la línea de Solaris, el modelo de mundo para interfaces presentado el 31 de agosto. Este primer avance describe cuatro formas de interactuar con el ordenador. Con Portals, un modelo de vídeo genera durante la navegación superposiciones animadas e interactivas, con bordes difuminados para señalar el contenido generado. Las interfaces de vídeo reactivas (Responsive Video Interfaces) se reorganizan al cambiar su tamaño y responden a los clics. Interactive Worlds transforma un contenido multimedia en una simulación interactiva, tanto para personas como para agentes. Visual Thinking, por último, es un arnés para agentes de código: un modelo de vídeo en tiempo real convierte en imágenes cada paso y cada llamada a una herramienta, para mantener al usuario involucrado en el proceso. Runway no ofrece acceso ni indica una fecha, un precio o el modelo subyacente.
Synthesia lanza Sessions, avatares que forman y entrevistan
1 de octubre — Synthesia lanza Sessions, una familia de productos construida sobre sus avatares interactivos: una videollamada cuyo interlocutor es un avatar que hace preguntas, escucha, rebate y sintetiza. Roleplay Sessions sirve para la formación: el avatar interpreta a un cliente, un cliente potencial o un colaborador, un coach de IA comenta cada intento y los responsables siguen las puntuaciones y el progreso en un panel de control. Survey Sessions transforma el cuestionario en una entrevista: el avatar entrevista a cientos de personas en paralelo, hace preguntas de seguimiento según las respuestas y luego entrega un informe de temas y sentimiento, con cada respuesta disponible para su consulta en una transcripción, en audio o en CSV. Se ofrece una prueba gratuita, sin precios detallados. Sessions se apoya en la Interactive Avatar API, que alcanzó la disponibilidad general el 16 de septiembre, y Synthesia promete otras variantes.
🔗 Anuncio de @synthesiaIO en X · Página de Synthesia Sessions
IA y ciencia: SynthID Bio añade marcas de agua a las proteínas, Matthew Schwartz describe una ciencia «con forma de Claude»
SynthID Bio: Google DeepMind añade marcas de agua a las proteínas diseñadas por IA
30 de septiembre — Google DeepMind presenta SynthID Bio, una familia de métodos de marcas de agua digitales (watermarking) para las creaciones biológicas generadas por IA, difundida en X el 1 de octubre. La entrada la presenta como una prueba de concepto: se inscribe una firma imperceptible en el código biológico, verificable tanto en el modelo digital como en la proteína sintetizada. Para las secuencias, el método orienta discretamente la elección de aminoácidos; para las estructuras 3D, se ajusta una pequeña parte de la red de difusión de AlphaFold 3. En el laboratorio, con tres dianas (VEGF-A, el dominio RBD de la proteína spike del SARS-CoV-2 y PD-L1), las proteínas de unión con marcas de agua igualaron a las versiones convencionales en tasa de éxito, afinidad y diversidad de secuencias. Lo que está en juego es la bioseguridad: una señal automática ayudaría a los proveedores de síntesis de ADN a verificar el origen de una secuencia desconocida. Google DeepMind publica su artículo de métodos, el código, los datos in vitro y los pesos para la investigación; junto con el Hie lab de Stanford y el Arc Institute, el enfoque ya se extiende al genoma de un bacteriófago diseñado por Evo 2. La robustez frente a una alteración deliberada sigue siendo el principal reto.
🔗 Entrada de Google DeepMind sobre SynthID Bio
La ciencia «con forma de Claude»: la entrada invitada de Matthew Schwartz
1 de octubre — El blog Anthropic Science publica una entrada invitada de Matthew Schwartz, físico de Harvard, que precisa que trabaja como investigador visitante en Anthropic. En ella describe un «desajuste de impedancia» entre científicos e IA: trabajar con un modelo como con un colaborador humano no permite sacarle el máximo partido, y conviene buscar problemas «con forma de Claude», en los que una técnica conocida de matemáticas, física o informática resuelve de una vez una cuestión de otro campo. A partir de ello desarrolló BootLoops, un arnés open source de cálculo exacto compatible con cualquier modelo; BootLoops no es un proyecto de Anthropic, sino que lo mantiene Schwartz. En física, se han resuelto de principio a fin 30 integrales, de las cuales 15 nunca se habían calculado; en ecología, los árboles de Barro Colorado Island cambian 4,5 veces más rápido de lo que permite la teoría neutra; en lingüística, la base AccStack cubre el acento léxico de 6 072 lenguas. Balance: 36 manuscritos en 18 campos con 19 coautores en tres meses. Schwartz también señala las limitaciones: Claude no tiene sentido del tiempo, le gusta «declarar la victoria», y sus resultados fuera de la física resultaban poco interesantes antes de que un experto los reorientara.
🔗 Ciencia con forma de Claude (blog Anthropic Science)
Modelos abiertos y entrenamiento: Olmo-core 3 de Ai2, Clef y Clef-flash de Cloudflare, el RL con múltiples arneses de FineEnvs
Olmo-core 3: Ai2 publica una pila de entrenamiento MoE abierta que apunta a más de un billón de parámetros
1 de octubre — Ai2 publica Olmo-core 3, una nueva versión del framework que entrena sus modelos Olmo, reconstruida en torno a un sistema de entrenamiento de mezcla de expertos (mixture-of-experts, MoE) completamente abierto. Es uno de los sistemas de la próxima generación de Olmo, que pasará a MoE y debe convertirse, según Ai2, en el más capaz de los Olmo. La implementación anterior, basada en FSDP, reunía y luego volvía a dividir los pesos en cada lote; Olmo-core 3 pasa a DDP, mantiene a los expertos en sus GPU y les envía los datos.
| Medición publicada por Ai2 | Valor medido |
|---|---|
| MoE de 47 mil millones de parámetros en ocho B300, prueba preliminar | 52 000 frente a 19 400 tokens/s por GPU, unas 2,7 veces |
| MXFP8 frente a BF16, en cuatro B300 | Aproximadamente un 21 % más de rendimiento |
| Modelo de 1 200 mil millones de parámetros en 512 GPU | 858 TFLOP/s por GPU como máximo, enrutamiento aleatorio |
Ai2 precisa que la medición con 1 200 mil millones de parámetros evalúa el sistema, no la calidad de un modelo entrenado. Se publican el código (versión 3.0.0), el informe técnico y una demostración interactiva.
🔗 Entrada de Ai2 sobre Olmo-core 3 · Release Olmo-core v3.0.0
Clef y Clef-flash: Cloudflare libera dos modelos de decisión compatibles con Jev
1 de octubre — El equipo de Workers AI de Cloudflare publica Clef y Clef-flash, sus primeros modelos entrenados internamente, en el ámbito abierto por Jev, el modelo System One de Typesafe AI: reciben un estado (texto, JSON, imagen o vídeo) y un esquema de preguntas tipadas, y devuelven en una sola pasada una probabilidad para cada opción permitida. Clef se ha postentrenado a partir de Qwen3.8-27B, mientras que Clef-flash se basa en Qwen3.5-9B. Alojados en Workers AI con una API compatible con la de Jev, se publican en Hugging Face bajo la licencia Apache 2.0 según el artículo, con una ventana de 64k tokens frente a los 32k de Jev. Las cifras, seleccionadas por Cloudflare, son dispares:
| Prueba y métrica | Puntuación de Clef | Puntuación de Clef-flash | Puntuación de Jev |
|---|---|---|---|
| BFCL, casos exactos | 98,47 | 98,76 | 95,75 |
| BANKING77, macro-F1 | 94,20 | 90,93 | 79,74 |
| When2Call, exactitud | 72,37 | 65,58 | 80,97 |
| BRIGHT, nDCG@10 | 45,91 | 39,26 | 47,52 |
| Latencia mediana | 209,3 ms | 38,8 ms | 524,1 ms |
Cloudflare afirma que Clef lidera el Jev Decision Index, un puesto que Liquid AI reivindicaba para d1 dos días antes, y lanza un servicio de ajuste fino por refuerzo de Clef con los datos del cliente.
🔗 Artículo de Cloudflare sobre Clef · Clef en Hugging Face
FineEnvs entrena un modelo por refuerzo en cuatro arneses de agentes a la vez
1 de octubre — Un mismo modelo no se comporta de la misma manera según el arnés que lo controla: los pesos de LFM2.5-2.6B, de Liquid AI, resuelven el 62 % de las tareas con Mini-SWE-Agent, pero el 33 % con Claude Code. La organización FineEnvs publica en Hugging Face una guía para entrenar un modelo mediante aprendizaje por refuerzo directamente en los arneses de los desarrolladores, sin modificar su código. Un proxy de captura añadido a OpenEnv se presenta al arnés como un proveedor de modelos (formatos OpenAI, Anthropic o Gemini) y registra los tokens y las probabilidades exactas producidos por vLLM; Harbor proporciona tareas y entornos aislados, y TRL entrena con GRPO asíncrono. Entrenado en cuatro arneses a la vez, LFM2.5-2.6B pasa del 42 % al 54 % de media, y una pequeña bonificación para las soluciones que consumen menos recursos reduce un 31 % sus llamadas a herramientas en las tareas ya resueltas. Imitar a un modelo más grande no basta: un ajuste fino supervisado con 3 189 rollouts de Qwen3.8-27B se estanca en el 47,5 %. Se publican el proxy, el entrenador, las tareas, los datos y los modelos entrenados.
🔗 La guía definitiva de RL con múltiples arneses
Grok 4.7 en versión preliminar en la plataforma de agentes de Google Cloud
1 de octubre — SpaceXAI anuncia que Grok 4.7 está disponible en Gemini Enterprise Agent Platform, la plataforma de agentes de Google Cloud. La ficha del modelo, fechada el 30 de septiembre, lo sitúa en versión preliminar bajo el identificador grok-4.7 y lo describe como un modelo de xAI diseñado para el código y el trabajo de conocimiento, que dedica más tiempo a las tareas difíciles y verifica su propio trabajo. Acepta texto e imágenes como entrada y solo devuelve texto; admite llamadas a funciones, salida estructurada y razonamiento, pero no predicciones por lotes.
| Dato publicado por Google Cloud | Valor para Grok 4.7 |
|---|---|
| Longitud del contexto | 524 288 tokens |
| Cuotas por minuto | 13 solicitudes, 188 000 tokens de entrada y 16 000 tokens de salida |
| Tipos de uso | Solo cuota fija, sin pago por uso ni rendimiento aprovisionado |
| Regiones de servicio | Multirregión de Estados Unidos y punto de conexión global |
| Precio por millón de tokens | 2 dólares de entrada, 6 de salida, 0,50 en caché por debajo de 200 000 tokens de entrada, el doble por encima |
La tabla de precios coincide con la de la API de xAI. Lanzado el 21 de septiembre, Grok 4.7 había llegado a Amazon Bedrock el 28 de septiembre, y Grok 4.6 se había incorporado a la misma plataforma de Google el 21 de agosto.
🔗 Ficha de Grok 4.7 en Google Cloud · Anuncio de @SpaceXAI en X
GitHub endurece las medidas para la notificación privada de vulnerabilidades ante los informes generados por IA
1 de octubre — GitHub publica en el mismo minuto dos medidas para la notificación privada de vulnerabilidades (private vulnerability reporting), con una constatación común: los mantenedores de proyectos open source reciben cada vez más informes de baja calidad, automatizados o generados por IA, que eclipsan los que importan.
A single free-text box made it easy to submit low-quality or AI-generated reports and hard for you to find the signal in them.
🇪🇸 Una simple área de texto libre facilitaba el envío de informes de baja calidad o generados por IA y te dificultaba identificar lo esencial en ellos. — GitHub Changelog, Formularios estructurados para los informes privados de vulnerabilidades
Un formulario estructurado. De forma predeterminada, el informante debe rellenar cuatro campos obligatorios: un resumen, detalles, una prueba de concepto de al menos 150 caracteres y el impacto, que se fusionan en la descripción del aviso de seguridad que el mantenedor revisa como antes. Cada repositorio puede adaptar el formulario mediante un archivo .github/VULNERABILITY_REPORT.yml, o aplicarlo a todos sus repositorios desde el repositorio .github de la organización; los mantenedores pueden exigir una categoría CWE, algo que una organización o una empresa puede imponer mediante una política. Una casilla permite al informante declarar que ha recibido ayuda de la IA para encontrar la vulnerabilidad o redactar su informe. En la API REST también se aplica un formulario personalizado, pero no el formulario predeterminado, para no romper las integraciones existentes.
Un límite diario. El número de nuevos informes que una misma cuenta puede enviar cada día queda limitado, tanto a un repositorio como en el conjunto de GitHub; los comentarios en avisos existentes no se ven afectados. Los administradores pueden establecer su propio límite y eximir a informantes de confianza, y GitHub no especifica la cifra del límite predeterminado. Ambas medidas afectan a los repositorios públicos que tienen activada la notificación privada, en GitHub Free, Pro, Team y Enterprise Cloud.
🔗 Límites de frecuencia para los informes privados de vulnerabilidades
Agentes de código: Codex CLI 0.160.0, Delta 0.18 y Antigravity 2.19.1
Codex CLI 0.160.0: el historial del centro de comando y las sesiones fuera de un proyecto
1 de octubre — OpenAI publica Codex CLI 0.160.0, la primera versión estable desde la 0.159.3 del día anterior, con 55 PR enumeradas desde la 0.159.0. El centro de comando de agentes (agent command center) incorpora una acción para mostrar tareas más antiguas (Mostrar más), que se puede usar con el teclado. Las sesiones pueden iniciarse fuera de un proyecto, con la configuración predeterminada del espacio de trabajo cuando la política de la organización lo permite, y los permisos guardados se restauran al reanudar la sesión. La revisión de aprobación Guardian recibe dos capacidades opcionales: recuperar instrucciones dadas anteriormente por el usuario e incorporar el contexto de los traspasos entre agentes. En pantalla completa, los terminales locales Linux X11 permiten seleccionar la transcripción y pegar con el clic central. Entre las correcciones, los mensajes en cola se reanudan tras una reconexión sin enviarse por duplicado, y una serie de arreglos aborda el entorno aislado de Windows y los bloqueos de SQLite durante la inicialización.
Delta 0.18: los hilos se ejecutan en los worktrees Git existentes y llega una CLI
30 de septiembre — Zed publica la versión 0.18.0 de Delta, su entorno multijugador para programar con agentes: 23 novedades, 41 mejoras, 51 correcciones y una eliminación. La principal novedad se había anunciado sin fecha el 28 de septiembre: un hilo ahora puede ejecutarse en cualquier worktree Git existente que ya esté vinculado y transmitir esa copia de trabajo a los nuevos hilos creados a partir de él. Delta también se controla desde el terminal: una CLI delta se instala en macOS, Windows y Linux, y los comandos delta auth gestionan la cuenta con sesión iniciada. En cuanto a los modelos, la versión añade los modelos Gemini de Google AI Studio, permite acceder a GPT-6 Sol, GPT-6 Luna y Claude Opus 5.5 con una clave API, y acepta en la aplicación de escritorio cualquier proveedor compatible con OpenAI o Anthropic. El trabajo en hilos incorpora una búsqueda en todos los subhilos y marcadores; en cambio, los subhilos ya no publican sus mensajes de progreso en el hilo padre, donde solo siguen apareciendo los resultados de Land Changes.
🔗 Notas de la versión de Delta 0.18.0
Antigravity 2.19.1: escribir directamente a los subagentes
30 de septiembre — Antigravity 2.19.1 permite enviar un mensaje directamente a un subagente desde el cuadro de entrada, sin pasar por el agente principal; la CLI ya lo ofrecía con su sintaxis @ desde sus versiones 1.2.8 y 1.2.9. La versión añade la exportación a PDF del Markdown renderizado en los artefactos y el panel lateral, incluidos tablas, bloques de código y diagramas, y una opción para deshacer cambios limitada a la conversación; entre sus cinco correcciones, los agentes personalizados por fin respetan las reglas globales y las del proyecto. El despliegue es gradual y puede tardar unos días. La CLI había recibido el 27 de septiembre una versión 1.2.12 que había pasado desapercibida: una sesión iniciada con una clave GEMINI_API_KEY ahora se detiene inmediatamente cuando la API Gemini indica que se ha agotado la cuota diaria, se ha alcanzado un límite de gasto o se han agotado los créditos de prepago, en lugar de encadenar durante varios minutos intentos destinados al fracaso.
🔗 Registro de cambios de la aplicación Antigravity · Registro de cambios de la CLI Antigravity
Breves
- Copilot CLI 1.0.90 y 1.0.91 — La 1.0.90 pasa a estable el 30 de septiembre con GPT-6.1 Sol en el selector de modelos y correcciones de MCP y de reanudación de sesiones; la 1.0.91, del 1 de octubre, añade los comandos
copilot sandbox capara gestionar el certificado del proxy de su entorno aislado. 🔗 fuente - Codex CLI 0.159.3 — Publicada el 30 de septiembre a las 22 h 57 UTC, solo contiene un backport: las sesiones locales con sesión iniciada mediante ChatGPT pueden mostrar recordatorios opcionales para completar la configuración de la seguridad de la cuenta, un cambio también incorporado en la 0.160.0. 🔗 fuente
- Nightly de Gemini CLI — La v0.64.0-nightly del 1 de octubre corrige un bloqueo con un consumo del 100 % del procesador en modo headless y hace atómicas las escrituras de las herramientas de archivos; las versiones estable y preliminar no cambian. 🔗 fuente
- Zed 1.23.1 en versión preliminar — Publicada el 30 de septiembre, muestra los archivos JSONL y NDJSON en forma de tabla, añade el ajuste
agent.max_idle_retained_threadsy vuelve a intentar automáticamente las solicitudes cuando un modelo de Google AI está sobrecargado. 🔗 fuente - Copilot en VS Code en septiembre — El resumen mensual de las versiones 1.136 a 1.140 destaca algunas novedades que habían pasado desapercibidas, como la reanudación en VS Code de una conversación de Codex iniciada en la app ChatGPT, una insignia de aplicación en versión preliminar y chats abiertos sin espacio de trabajo. 🔗 fuente
- Planificar en grupo en Delta — En el blog de Delta, Nathan Sobo cuenta cómo tres miembros del equipo planifican en un mismo hilo con Fable y después Astra, con un subhilo y un subagente aislados, en lugar de hacerlo en un archivo
plan.md; no se anuncia ninguna función nueva. 🔗 fuente - Innate en un vídeo de Cursor — Cursor publica un breve retrato en vídeo de Innate, un equipo de siete personas que construye robots para la vida cotidiana y cuyo cofundador, Vignesh Anand, afirma que realiza el trabajo de 50, sin detallar cómo usa Cursor. 🔗 fuente
- Recuperar en lugar de compactar — David Corvoysier, desarrollador de funes, mide con Claude Code que recuperar la sesión anterior mediante su herramienta permite encontrar las respuestas correctas con 8, 4 y 3 veces menos tokens ponderados que al conservar todo el contexto, en tres tareas que él mismo eligió. 🔗 fuente
- Nuevo panel de GitHub — La vista que reúne sesiones de agentes activas, issues y pull requests, con un máximo de 12 elementos por lista, se convierte en la vista predeterminada para todos; el feed de noticias pasa a una pestaña Feed y la presentación anterior sigue disponible. 🔗 fuente
- API de fusión asíncrona — Pasa a disponibilidad general y se convierte en la vía recomendada para fusionar mediante programación, en lugar del endpoint REST síncrono y las mutaciones GraphQL; es la única API de fusión que gestiona las pull requests apiladas. 🔗 fuente
- Dist-tags de npm sin token — Las configuraciones de publicación de confianza de npm pueden recibir un permiso opcional, desactivado por defecto, para gestionar los dist-tags con credenciales OIDC de corta duración en lugar de un token de acceso de larga duración. 🔗 fuente
- Retención de GitHub Actions — Checks, ejecuciones de workflow y estados, incluidos los de aplicaciones de terceros, siguen ahora la configuración de retención de los artefactos y los registros y se eliminan al superarla, con un máximo de 90 días para los repositorios públicos y sin posibilidad de restauración. 🔗 fuente
- Code scanning y repositorios inactivos — Los análisis semanales programados de code scanning y de GitHub Code Quality solo se inician después de un análisis activado por un push o una pull request, para evitar que un repositorio inactivo siga pareciendo activo durante seis meses más. 🔗 fuente
- Cobertura de código — La acción
upload-code-coveragede GitHub Code Quality ya no hace fallar la CI al hacer push a una rama que aún no tiene una pull request abierta. 🔗 fuente - Declaraciones de accesibilidad — Un archivo
ACCESSIBILITY.mdsituado en la raíz, en.github/o endocs/se destaca en la página de inicio del repositorio, en todos los planes de github.com, y llegará a GitHub Enterprise Server 3.24. 🔗 fuente - Actions Runner Controller 0.15.0 — El controlador Kubernetes de los runners autoalojados actualiza los recursos in situ al instalar versiones de corrección, permite configurar el tiempo de espera para la detención, los límites del cliente Kubernetes y la concurrencia de los controladores, y reduce sus solicitudes. 🔗 fuente
- Grok Bot toma la iniciativa — El Bot principal del usuario identifica ahora el trabajo del que puede liberarlo y propone encargarse de él; el despliegue se extiende durante unas horas y estas sugerencias no cuentan para el consumo, sin especificar planes ni países. 🔗 fuente
- Genspark y Azure Cosmos DB — Un artículo del blog de Azure Cosmos DB, escrito desde la perspectiva de Genspark, explica cómo algunos procesos en segundo plano pasan por índices secundarios globales para dejar de ralentizar las sesiones de agentes en directo; no se aporta ninguna cifra. 🔗 fuente
- Testimonio en Genspark — Seulki Kang, con quince años de experiencia en marketing, dice preparar un conjunto completo de materiales para cursos en 5 horas en lugar de 30 conectando sus documentos anteriores a SecondBrain y después a AI Slides; no hay ninguna novedad de producto. 🔗 fuente
- Albertsons y OpenAI — El minorista con más de 2 200 tiendas amplía su alianza, de ChatGPT Enterprise para determinados equipos a la API para sus experiencias de cliente y sus análisis promocionales, y destaca su plugin Safeway en ChatGPT, anunciado el 5 de agosto. 🔗 fuente
- El complemento eterno — OpenAI publica el primer ensayo de una serie sobre la próxima economía, firmado por Hemanth Asirvatham y Elliott Mokski, quienes aclaran que hablan a título personal: la mayor parte de la inteligencia de las máquinas podría dedicarse a la ejecución en lugar de a los grandes avances. 🔗 fuente
- Perplexity y los consultores — Una guía compara diez herramientas de IA para consultores, de AlphaSense a Qwilr, con precios verificados en septiembre; su FAQ recuerda que Perplexity entrena sus modelos con los datos de los usuarios del plan gratuito, salvo que se opongan. 🔗 fuente
- Luma Variants — Presentada el día anterior sin detalles, la función se lanza para todos los usuarios de Luma: a partir de un anuncio estático aprobado, produce sus variantes en cinco formatos estándar, de 9:16 a 16:9, y en varios idiomas, sin precio anunciado. 🔗 fuente
- HeyGen Professional Voice Clone — Según su resumen de septiembre, HeyGen ofrece a través de la API su clon de voz más fiel, entrenado con al menos 20 minutos de grabaciones (1 a 10 archivos), tras una versión preliminar privada lanzada el 9 de septiembre. 🔗 fuente
- Pika y sus aplicaciones — Pika afirma contar con más de 40 aplicaciones en su nueva plataforma y presenta dos: Podcast Video, que hace debatir a dos personajes, y Color Grade, que ajusta el color de una imagen o un clip, sin fecha ni precio. 🔗 fuente
- ElevenLabs en el Benelux — ElevenLabs abre oficinas en Bruselas y Ámsterdam y prevé triplicar sus equipos allí; en el operador KPN, el reconocimiento de códigos postales pasa del 64 % al 82 % y el agente de verificación procesa unas 60 000 llamadas por semana. 🔗 Países Bajos · 🔗 Bélgica
- Skills DOCA de NVIDIA — Con 65 prompts reales de desarrolladores, los agentes de código equipados con estas skills para las DPU BlueField cumplen el 100 % de los criterios de la rúbrica de evaluación, frente al 19 % sin ellas; están publicadas en GitHub. 🔗 fuente
- DIN Deploy — NVIDIA publica ejemplos C++ open source para ejecutar modelos localmente con ONNX Runtime y TensorRT RTX, en Windows y Linux; en un DGX Spark, Parakeet TDT transcribe 206 veces más rápido que en tiempo real en la GPU, frente a 14 veces en la CPU. 🔗 fuente
- Nemotron 3.5 ASR y dialectos saudíes — Un tutorial de NVIDIA afina el modelo con los dialectos najdi y hijazi: la tasa de error por palabra pasa del 55,05 % al 29,96 % en 12 000 pasos con dos RTX PRO 6000, mientras que el inglés y el árabe de FLEURS incluso mejoran ligeramente. 🔗 fuente
- Recomendador HSTU en Dynamo-Triton — NVIDIA sirve un recomendador generativo HSTU con PyTorch AOTInductor y un cache KV: en el mejor caso, en una RTX PRO 6000, hasta 4,47 y 5,93 veces más rápido según el número de capas, es decir, 0,423 y 0,678 ms por solicitud. 🔗 fuente
- Rentabilidad de las fábricas de IA — En un artículo de opinión, NVIDIA cifra una fábrica de IA en unos 60 millones de dólares por megavatio y retoma los datos de SemiAnalysis: Vera Rubin NVL72 resulta hasta 45 veces más barato por millón de tokens que GB300 NVL72 con DeepSeek V4 Pro, frente a 35 veces el 24 de agosto. 🔗 fuente
- huggingface_hub 2.1.0 — La biblioteca vuelve a ejecutar automáticamente los Jobs fallidos, los reprograma sin volver a crearlos, consulta la cuota restante de ZeroGPU y descarga los archivos Xet mediante
hf_xet: un parquet de 2 Go pasa de unos 120 a 7 segundos en HF Jobs; tres cambios que rompen la compatibilidad. 🔗 fuente - ML Intern y MCP — Hugging Face conecta fuentes de datos MCP a ML Intern, el modo de HuggingChat que entrena modelos, para afinar modelos abiertos con datos propios de negocio; ninguna cifra oficial acompaña el anuncio. 🔗 fuente
- Hugging Face y el Open Source for Science Fund — Los dos socios quieren identificar las bibliotecas de las que más dependen los colaboradores de modelos científicos y apoyar a sus mantenedores, sin importe ni calendario. 🔗 fuente
- Un millón de entrenamientos con TRL — Según la telemetría citada por Quentin Gallouédec, la biblioteca de postentrenamiento de Hugging Face registra un millón de entrenamientos al mes, con el objetivo de alcanzar un millón por semana; no se ha publicado cómo se contabilizan. 🔗 fuente
- El millón de conjuntos de datos del Hub — Tres autores muestran que las cuentas de organizaciones publican aproximadamente el 19 % de los conjuntos, pero concentran la mitad de las descargas, y que Estados Unidos posee 390 de los 1 000 conjuntos más descargados. 🔗 fuente
- Ocho VLM en una RTX 3090 — Aakash Gupta, de ThinkEvolve, muestra que, con la misma exactitud, Qwen3-VL-8B procesa cada solicitud 2,2 veces más rápido que Qwen3.8-27B, pero tarda 18,88 horas frente a 7,53 en un trabajo de 7 329 llamadas, al no reutilizar el cache de prefijo. 🔗 fuente
- GLiNER2.5-Decide frente a layax — Aravind Vijayakumar no logra certificar ningún umbral de confianza para el modelo de Fastino, frente a 10 pruebas de 10 para layax, su propia herramienta, de 20 a 23 puntos más exacta y unas cinco veces más rápida. 🔗 fuente
- David Ha y los orquestadores — En un artículo de opinión para Nikkei Asia, el cofundador y CEO de Sakana AI considera que el valor pasará de los pesos de un modelo a la inteligencia que combina varios modelos, y define la soberanía como la solidez de la cadena de suministro. 🔗 fuente
- Difusión de vídeo en TPU — Tres ingenieros de Google reducen el tiempo de eliminación de ruido de un vídeo 1440p de 2 471 a 1 461 segundos en ocho chips TPU v6e, es decir, 1,69 veces más rápido, gracias a la atención dispersa de Sparse VideoGen y a un kernel Splash Attention optimizado. 🔗 fuente
Qué significa
Los agentes de código se vuelven programables por quienes los usan. Con los mods, Claude Code expone sus eventos internos a pequeñas funciones TypeScript, hasta el punto de convertir sus propias funciones en mods reemplazables; con los workflows dinámicos, GitHub hace que la orquestación de los subagentes se escriba en código, en lugar de dejar que Copilot decida la división de tareas cada vez. La guía de FineEnvs recuerda por qué el harness cuenta tanto como el modelo: los mismos pesos resuelven el 62 % de las tareas en un harness y el 33 % en otro. La contrapartida es la confianza. Un mod tiene el mismo acceso a la máquina que Claude Code, copilot workflow run no muestra ninguna solicitud de confirmación, y el control de las aplicaciones de escritorio puede actuar sobre cuentas con sesión iniciada. Los dos proveedores responden desactivando por defecto el control del escritorio, con una comprobación antes de la instalación (claude plugin validate) para los mods y con reglas empresariales que tienen prioridad.
La IA también impone nuevos filtros a quienes reciben sus resultados. GitHub estructura y limita la notificación privada de vulnerabilidades porque los informes generados por IA desbordan a los mantenedores; Google DeepMind propone incorporar marcas de agua a las proteínas diseñadas por IA para que los proveedores de síntesis de ADN sepan de dónde procede una secuencia desconocida. En ambos casos, el objetivo no es prohibir la IA, sino hacer visible su uso: una casilla para declarar la ayuda de la IA por un lado, una firma verificable por el otro.
En las empresas, la adopción se mide ahora en usos concretos. Barclays fija el objetivo de que el 50 % de los desarrolladores use Claude Code a finales de 2026 y hace clasificar 120 000 correos electrónicos al día, American Express convierte su tarjeta Business en una puerta de entrada a las Skills de Perplexity Computer, con créditos gratuitos incluidos, y Anthropic usa sus límites de uso como palanca al reducir a la mitad, durante dos semanas, el consumo asociado al trabajo que sigue a la creación de un artefacto. Para el público general, los asistentes se integran en acciones concretas: leerle un menú a una persona ciega, probarse una prenda antes de comprarla, trazar un gráfico bursátil en la conversación.
Por último, las cifras de los modelos se interpretan junto con su protocolo. Ai2 aclara que su medición con 1 200 mil millones de parámetros evalúa el sistema y no un modelo entrenado, Cloudflare elige sus benchmarks y reconoce que Jev sigue por delante en When2Call y BRIGHT, y la clasificación de vídeo de Artificial Analysis sitúa a Wan 3.0 en cabeza con intervalos de confianza que se solapan. FLUX 3 Image sigue un camino que se ha vuelto habitual: pesos comerciales bajo licencia de inmediato, pesos abiertos más adelante, sin fecha.
Fuentes
- Personaliza Claude Code con mods en TypeScript (claude.com)
- Guía de inicio de los mods en claude.dev
- Documentación de los mods de Claude Code
- Reacción de Boris Cherny en X
- Notas de la versión de Claude Code 2.1.287
- Changelog de GitHub sobre el control de aplicaciones de escritorio
- Changelog de GitHub sobre los workflows dinámicos
- Anuncio de FLUX 3 Image por @bfl_ai
- Página del modelo FLUX 3 Image
- Guided Vision en Gemini Live (blog de Google)
- Notas de la versión de ChatGPT
- Gráficos interactivos de Perplexity Computer
- Oferta de artefactos anunciada por @claudeai
- Condiciones de la oferta de artefactos (centro de ayuda de Claude)
- Barclays y Claude (Anthropic)
- Publicación de Perplexity sobre American Express
- Página de American Express como socio de Perplexity
- Anuncio de Wan 3.0 por @Alibaba_Wan
- Clasificación AA-Video-T2V v2.0 de Artificial Analysis
- Utopai X en la clasificación de Artificial Analysis
- Project Continuum por @runwayml
- Anuncio de Sessions por @synthesiaIO
- Página de Synthesia Sessions
- SynthID Bio (Google DeepMind)
- Ciencia moldeada por Claude (Anthropic Science)
- Olmo-core 3 (Ai2)
- Release de Olmo-core v3.0.0
- Clef y Clef-flash (blog de Cloudflare)
- Clef en Hugging Face
- Guía de RL con múltiples harnesses de FineEnvs
- Ficha de Grok 4.7 en Google Cloud
- Anuncio de Grok 4.7 en Google Cloud por @SpaceXAI
- Formularios estructurados para informes privados de vulnerabilidades
- Límites diarios de informes privados de vulnerabilidades
- Codex CLI 0.160.0
- Notas de la versión de Delta 0.18.0
- Changelog de la aplicación Antigravity
- Changelog de la CLI de Antigravity
- Copilot CLI 1.0.91
- Codex CLI 0.159.3
- Nightly de Gemini CLI del 1 de octubre
- Versión preliminar de Zed 1.23.1
- Resumen de septiembre de Copilot en VS Code
- Planificar en grupo en Delta
- Perfil de Innate por Cursor
- Banco de pruebas de memoria de sesiones con funes
- Nuevo panel de GitHub
- API de fusión asíncrona de GitHub
- Dist-tags y publicación de confianza de npm
- Retención de GitHub Actions
- Code scanning y repositorios inactivos
- Envíos de cobertura de código
- Declaraciones de accesibilidad de los repositorios
- Actions Runner Controller 0.15.0
- Sugerencias de Grok Bot
- Genspark y Azure Cosmos DB
- Testimonio de Seulki Kang (Genspark)
- Albertsons Companies y OpenAI
- El complemento eterno (OpenAI)
- Guía de Perplexity sobre herramientas de IA para consultores
- Luma Variants
- Resumen de septiembre de HeyGen
- Aplicaciones de Pika
- ElevenLabs en los Países Bajos
- ElevenLabs en Bélgica
- Skills DOCA de NVIDIA
- DIN Deploy de NVIDIA
- Nemotron 3.5 ASR y dialectos saudíes
- Sistema de recomendación HSTU en Dynamo-Triton
- Rentabilidad de las fábricas de IA (NVIDIA)
- huggingface_hub 2.1.0
- ML Intern y fuentes de datos MCP
- Open Source for Science Fund y Hugging Face
- Un millón de entrenamientos con TRL
- El millón de conjuntos de datos del Hub
- Ocho VLM evaluados en una RTX 3090
- GLiNER2.5-Decide frente a layax
- Artículo de opinión de David Ha compartido por Sakana AI
- Difusión de vídeo acelerada en TPU