ai-powered-markdown-translatorArtikel översatt från franska till svenska med gpt-6.1-sol.
Mistral öppnar en förhandsversion av Mistral Large 4, en multimodal modell med 1 000 miljarder parametrar vars API är tillgängligt för alla från och med i dag och vars vikter utlovas till slutet av oktober. Anthropic integrerar Claude i Google Docs, Sheets och Slides och omarbetar sitt program för cyberverifiering till tre åtkomstnivåer, samtidigt som Google DeepMind släpper EmbeddingGemma 2, en öppen och multimodal modell för embeddings som får plats på en telefon. Även beslutsmodellerna har sin dag: OpenAI öppnar sitt Decisions-API i offentlig beta, Perplexity halverar sitt pris och en rankning från communityn skiljer dem åt.
Mistral Large 4: 1 000 miljarder parametrar i förhandsversion, vikter utlovade till slutet av oktober
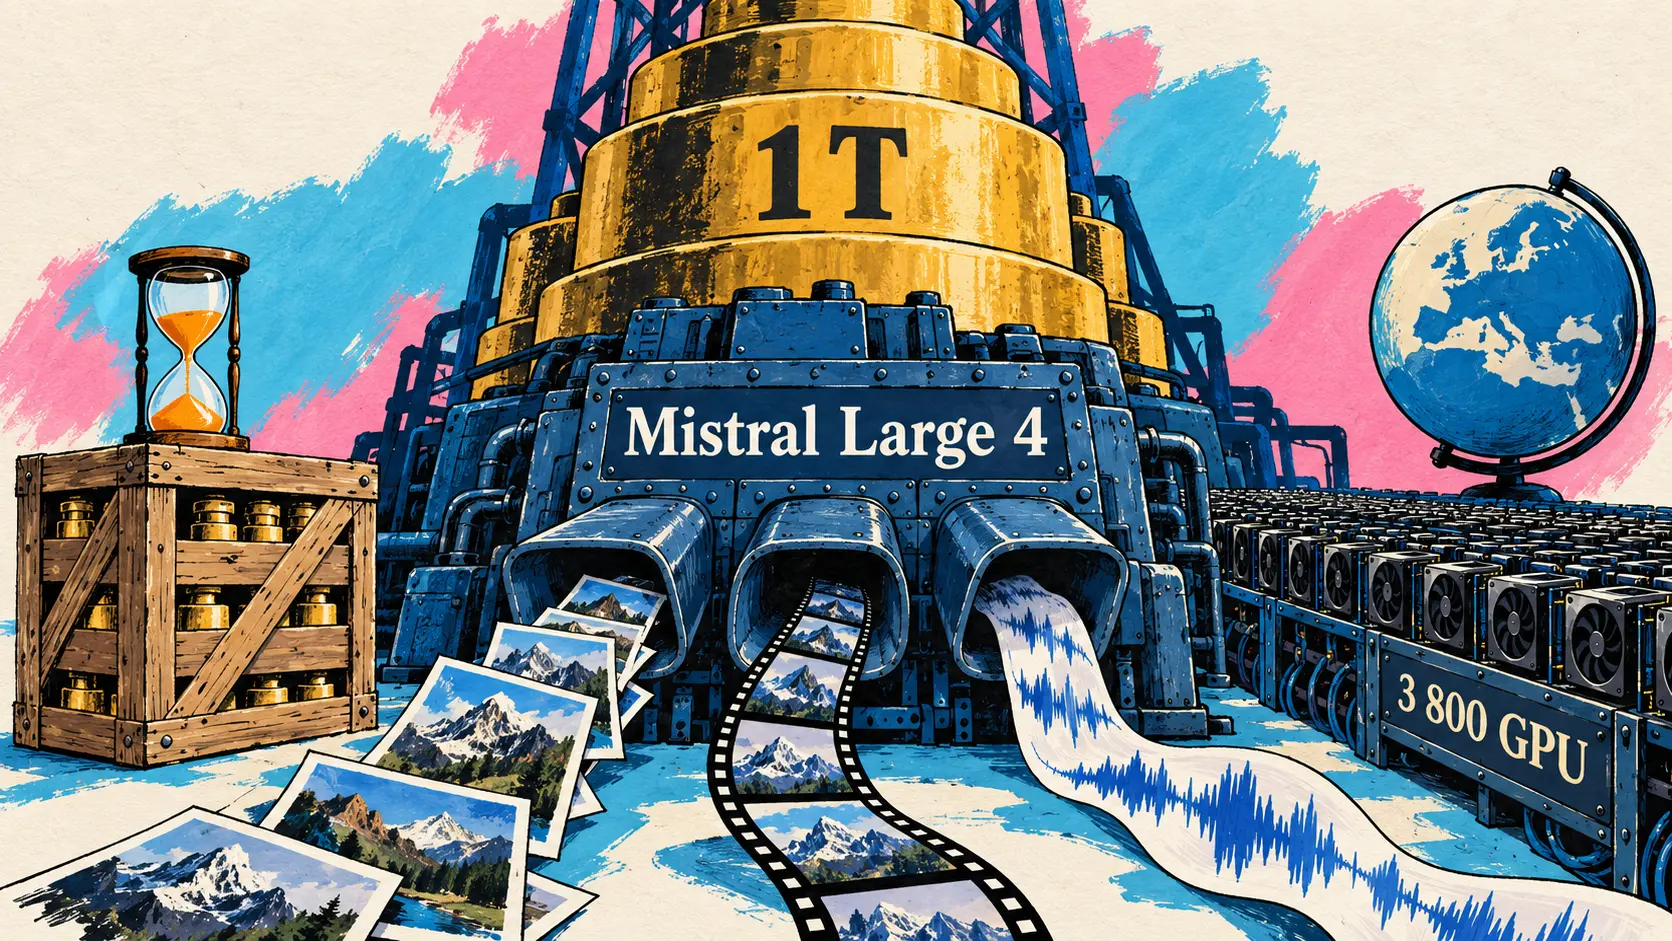
6 oktober — Mistral AI lanserar en offentlig förhandsversion av Mistral Large 4, med smeknamnen ML4 och, ”mycket officiellt”, Chonk. Det är företagets största modell hittills: en expertblandning (Mixture-of-Experts) som är multimodal från grunden och har 1 000 miljarder parametrar (1T), varav 49 miljarder aktiva enligt lanseringsinlägget, och som förenar instruktionsföljande, resonemang och agentiska förmågor i ett kontextfönster på en miljon tokens. Dokumentationssidan anger andra siffror utan att förklara skillnaden: 1 050 miljarder parametrar, varav 52 miljarder aktiva, samt en bildencoder med 1,6 miljarder.
API:et är öppet för alla från och med i dag på Mistral Studio, men vikterna har ännu inte publicerats: Mistral lovar att släppa dem senast i slutet av oktober, tillsammans med detaljer om arkitekturen och efterträningen. Under tiden testas modellen under verkliga förhållanden av cybersäkerhetsansvariga, verifierade partner och statliga myndigheter, som får tillgång till den med minskad moderering. ML4 tränades från grunden på 3 800 NVIDIA Grace Blackwell-GPU:er i Mistrals europeiska datacenter, som också driver förhandsversionen. Företaget planerar en europeisk driftsättning som det sköter från början till slut, under europeisk lagstiftning, och presenterar modellen som den första milstolpen i den färdplan som finansieras av dess Series D-runda på 3 miljarder euro.
Cybersäkerhet är huvudargumentet. Enligt Mistral är ML4 bland de fem främsta modellerna i Artificial Analysis Cyber Index och når 82 % på ett av dess tester, som går ut på att återskapa en verklig sårbarhet i en open source-programvara och sedan åtgärda den, det bästa resultatet bland alla modeller. Företaget hävdar att Claude Opus 5.5 och GPT-6 Astra får nära noll på samma test eftersom de vägrar utföra uppgiften.
| Utvärderat benchmark | Resultat enligt Mistral | Jämförelse som Mistral anger |
|---|---|---|
| DeepSWE v1.1 | 61,7 % | — |
| Coding Agent Index (kombinerat) | 49,8 % | före DeepSeek V4 Pro 0813 och Qwen3.8 Max |
| Surge AI:s blinda mänskliga utvärdering (kod, av 5) | 3,74, 2:a av 5 | efter Claude Opus 5 (4,22) |
| Cybench (40 utmaningar) | 93 % | — |
| AA Cyber Index, återskapa och sedan åtgärda en sårbarhet | 82 % | bästa resultatet bland alla modeller |
| AutomationBench (657 verksamhetsprocesser) | 59,9 % | före Kimi K3, MiMo-V2.6-Pro och DeepSeek V4 Pro |
Inlägget och dokumentationssidan skiljer sig också åt när det gäller priset: kortet i inlägget visar 1,36 dollar per miljon tokens för indata och 4,18 dollar för utdata, medan dokumentationssidan stryker över dessa priser och visar ett halverat pris bredvid, utan tidsangivelse eller förklaring.
| Egenskap hos ML4 | Enligt lanseringsinlägget | Enligt dokumentationssidan |
|---|---|---|
| Totalt antal parametrar | 1 000 miljarder | 1 050 miljarder |
| Aktiva parametrar | 49 miljarder | 52 miljarder |
| Indata, per miljon tokens | 1,36 dollar | 0,68 dollar (1,36 överstruket) |
| Utdata, per miljon tokens | 4,18 dollar | 2,09 dollar (4,18 överstruket) |
Alla dessa resultat kommer från Mistral, som påpekar att förhandsversionens förstärkningsinlärning fortsätter utan tecken på mättnad och förväntar sig snabba framsteg under de kommande veckorna.
🔗 Mistrals inlägg om Mistral Large 4 🔗 Mistral Large 4 i dokumentationen
Claude for Google Workspace: Claude flyttar in i Docs, Sheets och Slides
6 oktober — Anthropic lanserar Claude for Google Workspace, ett tillägg (add-on) som öppnar Claude i en sidopanel i Google Docs, Sheets och Slides, i offentlig beta för alla betalabonnemang. Claude läser den öppna filen, ser den aktuella markeringen (text, celler eller bilder) och ändrar filen direkt.
| Google-app | Vad Claude gör där |
|---|---|
| Docs | Rättningar och stiländringar direkt i dokumentet, förslagskort att tillämpa eller ignorera vid mer omfattande omskrivningar |
| Sheets | Formler, pivottabeller, inbyggda diagram, nya flikar, bearbetning av ett cellområde med Python för sammanfogning eller rensning |
| Slides | Bilder som bygger på presentationens layouter och tema, kontroll av element som överlappar eller hamnar utanför |
Användaren väljer graden av autonomi: i läget ”fråga före ändringar” (Ask before edits), som är aktivt som standard, går varje ändring via ett godkännandekort; i läget ”acceptera alla ändringar” (Accept all edits) fortsätter Claude utan att stanna. När panelen är ansluten till Claude-kontot använder den samma modeller, anslutningar och färdigheter (skills). För Enterprise-abonnemang gäller även Compliance API, kundhanterade krypteringsnycklar (CMEK) och export av granskningsloggar via OpenTelemetry för tillägget.
Claude now works inside Google Docs, Sheets, and Slides, and those files also open inside Claude. In Google Workspace, Claude sits in a sidebar next to your file, reads what you have open, and edits it in place. You can approve each edit before it lands.
🇸🇪 Claude fungerar nu i Google Docs, Sheets och Slides, och dessa filer kan också öppnas i Claude. I Google Workspace ligger Claude i en sidopanel bredvid din fil, läser det du har öppet och ändrar det direkt. Du kan godkänna varje ändring innan den tillämpas. — @claudeai på X
Stöd i den andra riktningen kommer samtidigt: nya anslutningar till Google Docs, Sheets och Slides, också i beta, gör det möjligt att skapa och ändra Google-filer från Claude genom att klistra in en länk eller be om ett nytt dokument. I konfigurationer som stöds öppnas filen i en panel bredvid konversationen, och Claudes åtkomst följer Googles delningsbehörigheter. Tillägget installeras från Google Workspace Marketplace (Extensions > Claude > Open Claude), och administratörer kan distribuera det från Google Admin-konsolen; på Team och Enterprise måste en ägare först aktivera anslutningarna. Google Workspace ansluter sig därmed till Microsoft 365, där Claude för Excel, PowerPoint och Word har varit allmänt tillgängligt sedan den 7 maj.
🔗 Anthropics inlägg om Claude for Google Workspace
Cyber Verification Program: Anthropic öppnar Opus 5.5, Sonnet 5.5 och Mythos 5.1 med tre åtkomstnivåer
6 oktober — Anthropic omarbetar sitt program för cyberverifiering (Cyber Verification Program, CVP), som ger verifierade säkerhetsexperter tillgång till funktioner som företagets modeller för allmänheten blockerar. Två upplägg har funnits parallellt i sex månader: Project Glasswing, som gav organisationer med ansvar för den mest kritiska programvaran tillgång till Claude Mythos, och ett CVP med en enda nivå som lättade på skyddsmekanismerna i Opus- och Sonnet-modellerna. De slås samman till tre nivåer, som alla ger tillgång till Claude Opus 5.5, Claude Sonnet 5.5, Claude Mythos 5.1 och kommande modeller. De allmänt tillgängliga modellerna (Opus 5.5, Fable 5.1, Sonnet 5.5) behåller försiktiga skyddsmekanismer som blockerar merparten av cybersäkerhetsarbetet.
| Åtkomstnivå | Användningsområden | Målgrupp och väntetid |
|---|---|---|
| Defense Access | Säkerhetscentral, incidenthantering, reverse engineering av skadlig programvara, sårbarhetsanalys | Säkerhetsteam, kritisk infrastruktur av alla storlekar, open source-underhållare, forskare; några dagar |
| Red Team Access | Defensiv användning samt auktoriserade penetrationstester och simulerade angreppsövningar (red teaming) | Endast organisationer, på system som de har tillstånd att testa; några veckor |
| Specialized Access | Tester av säkerhetskritiska system: flyg, elnät, telekom, interbanköverföringar, förvaltningsnätverk | Ett fåtal organisationer som granskas var för sig tillsammans med USA:s regering; Glasswing-medlemmar överförs |
I Red Team Access förblir åtgärder som kan orsaka fysisk skada eller omfattande störningar, som att driftsätta ransomware, blockerade i realtid. För att kontrollera sina inställningar lät Anthropic Opus 5.5 genomföra CyScenarioBench, en utvärdering av cyberoperationer i flera steg, med varje nivås skyddsmekanismer (10 utmaningar, 5 försök vardera).
| Konfiguration som Anthropic testade (Opus 5.5) | Resultat på CyScenarioBench (50 försök) |
|---|---|
| Utan CVP | Alla uppgifter blockerades redan vid första prompten |
| Defense Access | 46 försök blockerades i något skede, 4 lyckades |
| Red Team Access | Ingen blockering, 34 uppgifter löstes, motsvarande modellens 67,6 % utan skyddsmekanismer |
Inlägget ger också en första lägesbild av Glasswing, med siffror som enligt Anthropic är ofullständiga: minst 129 000 verifierade sårbarheter hittades av partner från april till juli, plus 5 500 genom Anthropics open source-analyser, varav fler än 33 000 klassades som kritiska eller allvarliga. Siffrorna bygger på 33 rapporter från partner, och Anthropic uppskattar att den verkliga effekten är ”minst fem gånger större”. I ett vittnesmål som publicerades samma dag säger Comcast att företaget hittade en kritisk autentiseringssårbarhet med Claude Mythos Preview när det utvärderade 258 system och omkring 170 miljoner kodrader, och en analytiker på Booz Allen granskade 138 kodförråd på tolv dagar.
Rent praktiskt kräver programmet att data lagras för att övervaka missbruk, i väntan på Enterprise Frontier Safeguards (EFS), som senare i höst gör det möjligt att lagra dessa data i ett moln som kunden kontrollerar; organisationer som redan använder Fable 5.1 eller Mythos 5.1 utan datalagring kan göra detsamma med CVP. Programmet är tillgängligt på Claude Platform, Vertex AI och Microsoft Foundry, och på Amazon Bedrock endast för kunder som uppfyller kraven för EFS. En individuell ansökan är bara möjlig för Defense Access, med ett betalabonnemang, och denna nivå måste senast den 15 december införa multifaktorautentisering som är motståndskraftig mot nätfiske och sluta använda API-nycklar. Ett webbinarium är planerat till den 14 oktober kl. 9 PT.
🔗 Anthropics inlägg om Cyber Verification Program 🔗 Hjälpsida för Cyber Verification Program 🔗 Comcast och Booz Allen med Claude Mythos
EmbeddingGemma 2: Googles öppna modell för embeddings blir multimodal
6 oktober — Google DeepMind släpper EmbeddingGemma 2, den andra generationen av sin öppna modell för embeddings, avsedd att köras på enheten. Den första EmbeddingGemma, som enligt Google laddats ner mer än 20 miljoner gånger, hanterade bara text; den nya projicerar text (inklusive kod), bilder, video och ljud, var för sig eller i kombination, till ett gemensamt rum med 768 dimensioner. Den bygger på Gemma 4:s arkitektur och släpps under Apache 2.0-licensen.
Meet EmbeddingGemma 2, our first natively multimodal open model for on-device embeddings. It expands beyond text to unify code, images, audio, and video in a shared space.
🇸🇪 Här är EmbeddingGemma 2, vår första öppna, nativt multimodala modell för embeddings på enheten. Den går bortom text och förenar kod, bilder, ljud och video i ett gemensamt rum. — @GoogleDeepMind på X
Modellen har 740 miljoner parametrar, men är modulär: en textkärna på 270M som vid behov kompletteras med en bildencoder (170M) och en ljudencoder (300M). En applikation för enbart text laddar alltså bara 270M parametrar. Med kvantisering mäter Google på en Pixel 11 Pro cirka 191 Mo aktivt RAM för textvikterna och 567 Mo för hela den multimodala modellen.
| Egenskap hos EmbeddingGemma 2 | Värde som Google anger |
|---|---|
| Totalt antal parametrar | 740M (text 270M, bild 170M, ljud 300M) |
| Vektorernas dimensioner | 768, kan trunkeras till 512, 256 eller 128 |
| Kontextfönster | 8K tokens, fyra gånger den första versionens |
| Aktivt RAM på Pixel 11 Pro (kvantiserat) | cirka 191 Mo för enbart text, 567 Mo för multimodalt bruk |
| MTEB Code | 78,68, jämfört med 68,76 för den första versionen |
| Flerspråkigt MTEB v2 | 61,36, jämfört med 61,15 för den första versionen |
Representationsinlärning i form av ”ryska dockor” (Matryoshka Representation Learning) gör det möjligt att förkorta vektorerna och minska lagringsbehovet med en faktor på upp till sex; enligt modellkortet påverkas kvaliteten endast marginellt ner till 256 dimensioner, och 128 dimensioner lämpar sig främst för användning med enbart text. Den tydligaste förbättringen gäller kod, med nästan tio poäng högre resultat på MTEB Code enligt Google, medan flerspråkig text ligger kvar på den tidigare nivån.
De avsedda användningsområdena är helt lokal sökning och retrieval-augmented generation (RAG), till exempel att hitta ett avsnitt i en video utifrån ett röstmeddelande. Eftersom modellen delar textsegmenteraren (tokenizer) och ljudencodern med Gemma 4 kan de två köras tillsammans med lägre minnesåtgång. Vikterna finns på Hugging Face och Kaggle; lanseringen i Model Garden i Gemini Enterprise Agent Platform har aviserats till ”snart”, utan datum. Modellen stöds från lanseringen av Transformers (version 5.19.0), sentence-transformers, MLX, vLLM, llama.cpp, Ollama och LM Studio, samt i webbläsaren med transformers.js.
🔗 Tillkännagivande på Googles blogg 🔗 Modellkort för EmbeddingGemma 2 🔗 Vikter på Hugging Face
Beslutsmodeller: OpenAI öppnar sitt Decisions API, Perplexity släpper Decider v1.1 och halverar priset, Decision Index 0.3 rangordnar dem
Beslutsmodeller, som väljer ett alternativ eller poängsätter indata i stället för att skriva ett fritt svar, har haft en händelserik dag: två leverantörer uppdaterar sina erbjudanden och priser, och kategorins communitydrivna rankning ändrar metod.
OpenAI:s Decisions API i öppen beta
6 oktober — En vecka efter att OpenAI:s Decisions API öppnades med begränsad åtkomst på DevDay går det över till öppen beta, med allmän tillgänglighet väntad ”under de kommande veckorna”. Det besvarar slutna frågor om en text, en bild eller båda med GPT-6 Luna, den enda tillgängliga modellen, via en särskild endpoint (POST /v1/decisions); enligt OpenAI kommer dess typade svar cirka 10 gånger snabbare än med Responses API. Dagens nyhet är priset: 0,10 dollar per miljon tokens i indata, utan avgift för utdata eller cache, med tillägg för regional bearbetning och lång kontext.
| Frågetyp | Avsedd användning | Returnerat resultat |
|---|---|---|
Predikat (predicate) | Kontrollera ett villkor, till exempel en skadad produkt på ett foto | Sannolikhet från 0 till 1 för att villkoret är sant |
Val (choice) | Välja ett alternativ från en angiven lista | Alternativet, sannolikheten för vart och ett och ett konfidensmått |
Poäng (score) | Bedöma på ordnade nivåer, till exempel hur allvarlig en incident är | Genomsnitt av nivåerna viktat med sannolikheterna |
Flera frågor kan gälla samma indata i ett enda anrop, och bilderna måste skickas i base64, utan URL till en lagrad bild eller fil-ID. API:et stöder att data inte sparas (Zero Data Retention) och HIPAA-användning för berättigade kunder, med datalagring i USA och Europa.
🔗 Guide till Decisions API 🔗 Ändringslogg för OpenAI:s API
Perplexitys pplx-decider-v1.1-27b och det halverade priset
6 oktober — Fem dagar efter lanseringen av sitt eget Decisions API uppdaterar Perplexity modellen som driver det, i en tråd från sitt utvecklarkonto, @perplexitydevs. pplx-decider-v1.1-27b släpps med öppna vikter under Apache 2.0-licensen på Hugging Face, behåller Qwen3.8-27B som bas från v1, läser text och bilder i en kontext på 250k tokens och tar bort den kausala masken (causal mask) i sina lager med fullständig attention. Decisions API, som nu använder denna modell, kostar 0,02 dollar per miljon tokens i indata, hälften av 0,04 dollar för v1, och utdata är fortsatt gratis.
| Kategori i Decision Index (modellkort på Hugging Face) | Jevs poäng | Poäng för v1 | Poäng för v1.1 |
|---|---|---|---|
| Kunskap (Knowledge) | 51,4 | 40,9 | 48,18 |
| Språk (Language) | 62,0 | 63,5 | 69,45 |
| Informationssökning (Retrieval) | 55,4 | 54,9 | 61,26 |
| Verktyg (Tools) | 75,1 | 79,3 | 78,88 |
| Konst (Arts) | 37,7 | 39,4 | 44,66 |
| Viktad totalpoäng | 57,9 | 56,4 | 61,56 |
Enligt modellkortet stiger totalpoängen från 56,4 till 61,56, över 57,9 för Jev, TypeSafe AI:s beslutsmodell, som dock fortfarande ligger före i kunskap. Perplexity uppger också att modellen får högst poäng i nya Decision Index 0.3. För att köra den på egen infrastruktur krävs en GPU som kan rymma cirka 49 Gio vikter samt den medföljande implementationen, eftersom vanlig kausal inferens inte återskapar det uppmätta beteendet.
🔗 Tråden från @perplexitydevs på X 🔗 pplx-decider-v1.1-27b på Hugging Face
Decision Index 0.3
6 oktober — apolinario, ingenjör på Hugging Face, publicerar version 0.3 av Decision Index, communityns rankning av öppna beslutsmodeller som reproducerar Jevs Decision Model. Den omfattar nu 112 modeller, varav 111 öppna reproduktioner, som körs på en NVIDIA RTX PRO 6000. Metoden ändras: den fullständiga poängen (Full score) kombinerar 37 offentliga benchmarks, privata tester som mäter samma färdigheter och privata uppgifter inom nya områden, så att placeringen speglar färdigheter och inte bara framgång i kända benchmarks. Även en flik för vision tillkommer.
| Visad placering | Rankad modell | Fullständig poäng |
|---|---|---|
| 1 | Perplexity Decider v1.1 (27B) | 62,8 |
| 2 | Fastino GLiDE utan resonemang (28B) | 60,2 |
| Referens | Jev | 60,1 |
| 3 | Torchcast Decision 27B | 59,9 |
| 4 | deck31b (Gemma 4 31B) | 59,0 |
De två poängen för Decider v1.1 ska inte blandas ihop: 61,56 är den som publiceras i Perplexitys modellkort, 62,8 den som denna rankning beräknar med sin nya metod. De privata testerna publiceras av naturliga skäl inte.
🔗 apolinarios tillkännagivande på X 🔗 Decision Index 0.3
Datorstyrning: OpenAI tränar GPT-6 Astra på Ironclads avtal
6 oktober — OpenAI inleder forskningssamarbeten med programvaruleverantörer för att göra sina agenter effektivare i verksamhetsprogram, som en del av arbetet med datorstyrning (computer use), och börjar med Ironclad, som är specialiserat på AI-stödd avtalshantering. Teamen har definierat 11 uppgifter inom juridik, försäljning och inköp, som enligt OpenAI tar 30 till 40 minuter var för en erfaren användare och utvärderas utifrån 8 till 50 kriterier. Ironclad tillhandahöll värdlagrade miljöer med sin programvara, där modellerna tränades med förstärkningsinlärning på syntetiska uppgifter hämtade från offentliga avtal i SEC:s EDGAR-databas.
| OpenAI:s mätning på de 11 uppgifterna | GPT-5.6 Sol (resonemang High) | GPT-6 Astra (resonemang Max) |
|---|---|---|
| Genomsnittlig poäng | 41,6 % | 55,0 % (+32 %) |
| Uppskattad genomsnittlig tid per försök (simulerad) | 37,0 minuter | 19,2 minuter (-48 %) |
GPT-6 Astra är OpenAI:s första frontier-modell som tränats på dessa uppgifter, och en intern modell som användes under utvecklingen når 63,7 %. Siffrorna kommer från OpenAI, och tiderna är simulerade utifrån antagna bearbetningshastigheter, inte uppmätta hos kunder. OpenAI uppmanar andra leverantörer att föreslå uppgifter som dagens agenter ännu inte klarar tillförlitligt.
🔗 OpenAI:s inlägg om samarbetet med Ironclad
API:er och plattformar: nivåer och BAA för OpenAI:s API, dokument och bilder i Perplexitys Agent API, GLM-5.3 på Bedrock
Fyra förändringar berör utvecklare som köper inferens: villkoren för åtkomst till OpenAI:s API, verktygen i Perplexitys Agent API och en ny öppen modell i AWS:s katalog.
Användningsnivåerna i OpenAI:s API minskar från fem till tre
6 oktober — OpenAI förenklar åtkomsten till de högsta anropsgränserna (rate limits) i sitt API: de fem betalda användningsnivåerna blir tre, Build, Launch och Grow. Den högsta, Grow, nås med sammanlagt 500 dollar i API-betalningar, jämfört med 1 000 dollar för den tidigare högsta nivån. Organisationer som redan ligger på en betald nivå flyttas över automatiskt utan att behöva göra något, och går sedan upp en nivå när deras sammanlagda kreditköp når trösklarna; gratisnivån har fortsatt ett tak på 100 dollar per månad.
| Användningsnivå | Tröskel för sammanlagda inköp | Månatligt användningstak | Astra, Sol och Terra (anrop och tokens per minut) | Luna (anrop och tokens per minut) |
|---|---|---|---|---|
| Build | 5 dollar | 500 dollar | 5 000 och 1 000 000 | 5 000 och 2 000 000 |
| Launch | 100 dollar | 5 000 dollar | 10 000 och 4 000 000 | 10 000 och 10 000 000 |
| Grow | 500 dollar | 200 000 dollar | 15 000 och 40 000 000 | 30 000 och 180 000 000 |
🔗 Tråden från @OpenAIDevs på X 🔗 Dokumentation om anropsgränser
BAA och HIPAA-efterlevnad via självbetjäning i OpenAI:s API
5 oktober — Organisationer som behandlar skyddade hälsouppgifter med OpenAI:s API kan nu själva underteckna det affärspartneravtal (Business Associate Agreement, BAA) som den amerikanska lagen HIPAA kräver. Under Settings > Organization > General accepterar en administratör standardavtalet för BAA och aktiverar stöd för HIPAA-efterlevnad, utan företagsavtal. Denna självbetjäning är reserverad för berättigade organisationer med en etablerad användningshistorik för API:et, och aktiveringen kan inte ångras via dessa inställningar. Anpassade avtalsvillkor kräver fortfarande en förfrågan via e-post, med svar inom en till två arbetsdagar. OpenAI påminner om att enbart underteckna ett BAA inte gör en applikation förenlig med kraven, och att inget BAA erbjuds för ChatGPT Business.
🔗 OpenAI:s hjälpartikel om BAA för API:et
Perplexitys Agent API läser dokument och söker efter bilder
5 oktober — Perplexitys API-ändringslogg får tre nya poster sent på kvällen. Agent API accepterar nu PDF-, DOC-, DOCX-, TXT- och RTF-dokument som indata, inbäddade i anropet eller angivna via en offentlig HTTPS-URL, med stöd som beror på vald modell och leverantör. Ett nytt verktyg, image_search, söker efter bilder på webben och returnerar strukturerade resultat, med bildens adress och adressen till dess ursprungssida: från 1 till 30 bilder per anrop, 5 som standard, filter för domäner och format samt säker sökning aktiverad som standard. Det kostar 2,50 dollar per 1 000 lyckade anrop, och misslyckade anrop debiteras inte. Den tredje posten korrigerar kostnadsredovisningen: svaren specificerar nu kostnaden för extraheringar som görs i sandboxmiljön, till GPT-6 Lunas oförändrade pris.
🔗 Ändringslogg för Perplexitys API 🔗 Dokumentation för verktyget image_search
Z.ai:s GLM-5.3 på Amazon Bedrock
6 oktober — Z.ai meddelar att GLM-5.3, företagets flaggskeppsmodell med öppna vikter, kommer till Amazon Bedrock; AWS:s modellkort daterar lanseringen till den 5 oktober. Det är en mixture-of-experts-modell med 744 miljarder parametrar, varav cirka 40 miljarder är aktiva per token, med en kontext på en miljon tokens och upp till 128 000 tokens i utdata. Åtkomsten är begränsad till berättigade kunder, som går via sitt kontoteam hos AWS, och modellen tillhandahålls endast genom inferens över regiongränser (profil US eller global), med cachelagring av prompts från 1 024 tokens och tjänstenivåerna Standard, Priority, Flex och Reserved. Modellkortet anger inget pris utan hänvisar till Bedrocks prissida. GLM-5.3 följer efter Kimi K3 (22 september) och Grok 4.7 (28 september), som kom till Bedrock under de senaste två veckorna.
🔗 Modellkort för GLM 5.3 på Amazon Bedrock 🔗 Z.ai:s tillkännagivande på X
Kodagenter: Claude Code 2.1.290 till 2.1.292, molnsessioner, Vibe CLI 2.26.0, Antigravity och Replit
Kodagenterna får fem uppdateringar, från terminalen till editorn: tre versioner av Claude Code på mindre än tjugo timmar, en guide till molnsessioner, en Vibe CLI vars nya gränssnitt i Rust byggs ut, tillägget Antigravity för VS Code och Replit, som ser alla användarens projekt.
Claude Code 2.1.290 till 2.1.292
5 och 6 oktober — Claude Code 2.1.290, som släpptes den 5 oktober kl. 23.33 UTC, är en omfattande version: 190 poster, varav 131 rättningar. claude attach och claude logs accepterar en del av en sessions namn i stället för dess identifierare, och /claude-api managed-agents-onboard omvandlar Managed Agents-modellen som beskrivs på en webbsida till ant apply-filer. Webbsökningsbudgeten för den interaktiva sessionen tar inte längre slut efter 200 anrop: den fylls på med 100 anrop per timme. På medelhög ansträngningsnivå (medium) rapporterar /code-review även avvikelser från konventionerna i CLAUDE.md för Opus 5.5 och Sonnet 5.5. I Slack får Claude Tag ett snabbläge (!fast), ett browser_batch-anrop i Claude in Chrome får 90 sekunder i stället för 60, och WebFetch kapar inte längre text över 100 000 tecken utan att meddela det. pyright och fler former av ps kräver tillstånd, och flera behörighetsbrister rättas: wildcards i rg och git grep som expanderas av shell, CLAUDE.md-filer som via länkar pekar utanför arbetskatalogerna, en organisationsmod som kringgås av en användarmod. Fyra timmar senare rättar 2.1.291 två regressioner, en som uppstod i 2.1.290 (svar på behörighetsfrågor som gick förlorade i molnsessioner) och en i 2.1.288 (de sista meddelandena i en session som gick förlorade vid avslut).
Den 6 oktober kl. 18.59 UTC lägger 2.1.292 (92 poster, varav 64 rättningar) till parametern effort i verktyget Agent för att starta en underagent med den begärda ansträngningsnivån, samt claude plugin install --marketplace, som lägger till marknadsplatsen (marketplace) vid behov och sedan installerar pluginet. Lokala MCP-servrar (stdio) förhandlar nu som standard om protokollet 2026-07-28 (MCP_PROTOCOL_NEGOTIATION=legacy för att återgå), CLAUDE_CODE_OVERLOADED_RETRY_BASE_DELAY_MS förlänger återförsöken vid 529-fel, och mods får en händelse för autokomplettering av prompten samt promptcache. På säkerhetssidan kringgår godkännanden från en PreToolUse-hook och auto-läget inte längre behörighetsfrågan vid läsning av nätverkssökvägar (UNC), och <system-reminder>-taggar som skrivs av en hook escapas innan de når Claude. Verktyget Artifact listar äntligen 200 artefakter i stället för 50, och Code Review redovisar sin statistik per repo. Varken 2.1.290 eller 2.1.292 har annonserats på X.
| Claude Code-version | Publiceringsdatum (UTC) | Antal poster | Viktigaste nyheten |
|---|---|---|---|
| 2.1.290 | 5 oktober, 23 h 33 | 190, varav 131 rättningar | Sessioner identifieras med namn, managed-agents-onboard, påfylld WebSearch-budget |
| 2.1.291 | 6 oktober, 3 h 55 | 2 rättningar | Två regressioner rättade |
| 2.1.292 | 6 oktober, 18 h 59 | 92, varav 64 rättningar | Underagenters ansträngningsnivå, plugin och marknadsplats i ett kommando, MCP 2026-07-28 |
🔗 Claude Code 2.1.290 🔗 Claude Code 2.1.291 🔗 Claude Code 2.1.292
Guiden till molnsessioner i Claude Code
6 oktober — Två veckor efter att förhandsversionen av molnsessioner i Claude Code släpptes publicerar Anthropic en praktisk guide av Addy Osmani på claude.dev. Varje uppgift körs på en ny virtuell maskin med cirka 4 vCPU, 16 GB RAM och 30 GB diskutrymme, med repot klonat på en ny branch, utan extra beräkningskostnad för abonnemangen Pro, Max, Team och Enterprise. Guiden beskriver sju användningsområden: beta av en lista med väntande uppgifter (backlog) parallellt, verifiera en rättning genom upprepade körningar, planera lokalt och sedan återuppta sessionen med claude --teleport, följa arbetet från telefonen, överlåta CI-fel och granskningskommentarer till Auto-fix, utlösa rutiner och köra osäker kod i en VM för engångsbruk. I demonstrationen var alla tre sessioner klara 87 sekunder efter den första starten, och ett projekt kan starta upp till 200 nya trådar (threads) per dag. Guiden beskriver också anslutningen till GitHub: att logga in med GitHub och att installera Claude GitHub-appen är två separata behörigheter, och endast den senare ger åtkomst till privata repon. Bonuskrediten på 100 dollar (Pro) eller 250 dollar (Max) måste hämtas ut före den 7 oktober kl. 23.59 PT och löper ut den 4 november.
🔗 Praktisk guide till molnsessioner på claude.dev 🔗 @ClaudeDevs påminnelse om bonuskrediten
Vibe CLI 2.26.0
6 oktober — Mistral släpper Vibe CLI 2.26.0, sin kodagent för kommandoraden, tretton dagar efter 2.25.8 och utan annonsering på X. Med 33 tillägg, 23 ändringar och 91 rättningar är uppdateringen omfattande: 72 av dess 147 poster gäller det nya gränssnittet som skrivits i Rust: guide vid första starten, röstläge (/voice), återkommande prompts som beskrivs på naturligt språk med /loop, överföring av sessionen till Vibe Code Web med /teleport och kommandot vibe update. Vibe körs nu alltid på Unified Harness, dess nya exekveringsmotor, och stannar med ett uttryckligt felmeddelande om den saknas, i stället för att utan förvarning falla tillbaka på den gamla motorn. Plugins kan inkludera en egen MCP-server, API-nyckeln för reservlösningen som lagras i ~/.vibe/.env kan nu bara läsas av sin ägare, och Rust CLI skickar nu sin användningstelemetri (starttid, använda kommandon, identifierad terminal) till Mistral.
🔗 Versionsinformation för Mistral Vibe v2.26.0
Antigravity-tillägget för VS Code 1.7.0
5 oktober — Google släpper version 1.7.0 av Antigravity-tillägget för Visual Studio Code, som tar in Google Antigravitys agenter i Microsofts editor (konversation i sidopanelen, granskning av diffar direkt i editorn, interaktiva planer), från och med VS Code 1.90. Enligt dess changelog har tillägget uppdaterats ungefär varje vecka sedan början av september, men det hade aldrig tidigare bevakats här. Version 1.7.0 (6 förbättringar, 9 rättningar) förbättrar kodgranskningen: besluten Accept och Reject kan ångras och göras om med tangentbordet, diffeditorn med jämförelse sida vid sida får knapparna Accept All och Reject All, och VS Codes automatiska sparande (Auto Save) kan inte längre skriva över eller avsluta en pågående granskning. I Windows meddelar systemets egna aviseringar när en uppgift är klar om fönstret inte ligger i förgrunden, och både Google Cloud Workstations och Cloud Shell får interaktiv autentisering. Samma dag uppdateras tillägget för Visual Studio till 1.0.261005.0 och bifogar diagnostikloggar till inskickad feedback.
🔗 Changelog för Google Antigravity
Replit och kontexten från alla projekt
6 oktober — Replit meddelar att det nu har tillgång till kontexten från en användares samtliga projekt. I en ny konversation kan man be det att hitta ett befintligt projekt, lägga till en funktion i det eller använda ett projekt som referens för ett annat; Replit läser då de berörda filerna och startar ändringarna som bakgrundsuppgifter (background tasks), med länkar för att granska ändringarna. Det valda exemplet går utöver ren kod: att använda färgpaletten från en « Partner Marketing Hub » i två andra projekt för ett kaffemärke. Tillkännagivandet består av en tweet med en video, utan blogginlägg, dokumentation eller prisuppgifter.
🔗 Replits tillkännagivande på X
Staplade pull requests i GitHub blir allmänt tillgängliga
6 oktober — GitHub gör staplade pull requests (stacked pull requests), som varit i offentlig förhandsversion sedan den 30 juli, tillgängliga för alla abonnemang på github.com: en stor ändring delas upp i mindre pull requests som granskas separat och sedan mergas tillsammans. GitHub Enterprise Server får dem i en kommande version. Enligt GitHub mergar repon som använder staplar 9 % mer kod än jämförbara repon, och mer än två tredjedelar av den översta 1 % av repona använder dem, med en förbättring på 5 % av tiden till merge.
Den slutliga versionen minskar friktionen vid merge. När huvudbranchen uppdateras behåller « Rebase stack » godkännandena för oförändrad kod och skapar signerade ersättningscommits; en stapel passerar merge-kön (merge queue) som en enda grupp, och en stapel vars basbranch raderas riktas om i stället för att stängas. Automatisk merge av en hel stapel kommer « under de kommande veckorna ». För användning på kommandoraden och av agenter stöder GitHub CLI-tillägget gh stack Git-worktrees.
🔗 GitHubs changelog om staplade pull requests
Flerspråkiga modeller: Tiny Aya L2-Thinker från Cohere och Falcon-OCR-Arabic från TII
Två små modeller riktar sig till språk som de stora modellerna hanterar sämre: den ena resonerar på användarens språk, den andra läser dokument på arabiska.
Tiny Aya L2-Thinker från Cohere
6 oktober — Cohere tar sig an språket som modeller resonerar på: när de får frågor på spanska, arabiska eller swahili tänker de flesta på engelska innan de svarar. Forskningsmodellen Tiny Aya L2-Thinker (3,35 miljarder parametrar) resonerar på promptens språk i mer än 93 % av fallen, över 60 språk. Receptet ligger i datablandningen: cirka 1,7 miljoner resonemangsexempel på engelska, genererade av gpt-oss-120b, får den att resonera på användarens språk i endast 12,8 % av fallen; cirka 5 000 översatta exempel per språk, för 44 språk, höjer andelen till 86,1 %, och flerspråkiga data utan resonemang utvidgar detta beteende till andra språk. Jämfört med dess tvilling som resonerar på engelska sjunker precisionen som mest med två till tre poäng på fem av sex benchmarks; endast PolyMath, med tävlingsmatematik, visar en tydligare nedgång eftersom ett steg med förstärkningsinlärning saknas. Modellen förbrukar i genomsnitt färre än 5 000 tokens för resonemang. Modeller och data publiceras på Hugging Face under den icke-kommersiella licensen CC-BY-NC 4.0; blogginlägget presenterar en arXiv-artikel från den 9 september.
🔗 Coheres forskningsinlägg om Tiny Aya L2-Thinker
Falcon-OCR-Arabic från TII
6 oktober — TII, institutet i Förenade Arabemiraten som utvecklar Falcon-modellerna, presenterar Falcon-OCR-Arabic på Hugging Faces blogg, en arabisk version av dess modell för textigenkänning Falcon OCR. Den behåller sina 270 miljoner parametrar och sin arkitektur med tidig fusion, och har anpassats genom övervakad finjustering på verkliga och syntetiska arabiska dokument, följt av förstärkningsinlärning. På en testsvit som TII självt byggt (11 974 verkliga dokument, 15 kategorier) kommer den på andra plats bland de 17 jämförda modellerna och på första plats för officiella dokument, administrativa formulär, kvitton och fakturor.
| Modell utvärderad av TII | Textnoggrannhet | Table TEDS-poäng |
|---|---|---|
| Gemini 3.5 Flash | 84,34 % | 51,30 % |
| Falcon-OCR-Arabic (270M) | 81,87 % | 59,95 % |
| Claude Opus 5.5 | 79,22 % | 43,98 % |
| GPT Astra | 75,02 % | 51,23 % |
| Chandra OCR 2 (bästa dedikerade OCR) | 61,67 % | 32,63 % |
Blogginlägget erbjuder endast en testmiljö (playground): inga vikter för Falcon-OCR-Arabic fanns på Hub vid vår kontroll, och ingen licens nämns.
🔗 TII:s blogginlägg om Falcon-OCR-Arabic
Hugging Face-bibliotek: Diffusers 0.41.0 integrerar Qwen-Image 2.1, Transformers v5.19.0 får EmbeddingGemma 2
Hugging Faces två stora modellbibliotek släpper en version samma dag.
Diffusers 0.41.0 och Qwen-Image 2.1
6 oktober — Diffusers 0.41.0, Hugging Faces bibliotek för diffusionsmodeller, integrerar Qwen-Image 2.1, Alibabas modell som förenar bildgenerering och bildredigering: den kan nu användas direkt för att generera, redigera, skapa bilder med transparent bakgrund (inbyggd RGBA-utdata) och träna LoRA, med en komponent för visuell generering på 7 miljarder parametrar. Teamet ändrar också utgivningstakten: liksom Transformers kommer Diffusers nu att anpassa sina minor-versioner till lanseringen av nya modeller, medan patch-versionerna förblir reserverade för rättningar. Inläsning med tensorparallellism gör att varje GPU bara behöver läsa sin del av vikterna, och versionen lägger till pipelines för LTX-2.5 DFR samt optimeringar för Cosmos 3. Stödet för ONNX markeras däremot som föråldrat till förmån för Optimum.
🔗 Versionsinformation för Diffusers 0.41.0
Transformers v5.19.0
6 oktober — Sex dagar efter v5.18.0 får Transformers v5.19.0 stöd för EmbeddingGemma 2, som presenterats ovan, med dess förkortningsbara vektorer och dess bild- och ljudencoders som kan inaktiveras vid inläsning. För distribuerad träning får expertparallellism tokendistribution (token dispatch), aktiverad som standard för Qwen3 MoE och Mellum: dess storlek behöver inte längre vara lika stor som tensorparallellismens, och Trainer fungerar med detta läge. Cachen kan nu konfigureras lager för lager, vilket är användbart för heterogena modeller, och kontinuerlig batchbearbetning (continuous batching) får stöd för XPU. Versionen innehåller sex ändringar som bryter bakåtkompatibiliteten, däribland att router-logits returneras för alla MoE och den gradvisa utfasningen av prefixet paged|.
🔗 Versionsinformation för Transformers v5.19.0
Röstagenter: ElevenLabs lanserar ElevenAgents Architect i Alpha
6 oktober — ElevenLabs integrerar en expert vid namn Architect i ElevenAgents, sin plattform för konversationsagenter, som hjälper team att bygga och förbättra sina röst- eller textagenter genom att tala eller skriva till den. Den känner till alla inställningar i ElevenAgents (kunskapsbas, prompts, flöden, röster, skyddsmekanismer, verktyg, simuleringar) och hur de samverkar. Man kan ge den en fråga, ett misslyckat test, en ökning av överföringar till en människa eller en observation från ElevenAgents Spotlight: den analyserar transkriptionerna, spårar grundorsaken, föreslår en ändring och skriver simuleringarna som validerar den. Den bygger också en agent utifrån en enkel beskrivning. Varje ändring kommer som ett versionshanterat utkast som kan återställas, och inget sätts i produktion utan godkännande. Architect är tillgängligt i produkten, men också via Claude, Claude Code, ChatGPT, Cursor och Grok Bot. Det är tillgängligt redan nu i Alpha, utan prisuppgifter eller resultatsiffror.
🔗 ElevenLabs blogginlägg om ElevenAgents Architect
Generativ video: FLUX 3 leder Physics-IQ Verified enligt Black Forest Labs
6 oktober — Black Forest Labs hävdar att de har förstaplatsen i Physics-IQ, Google DeepMinds benchmark som mäter videomodellers förståelse av den fysiska världen: modellen får se början av ett verkligt, filmat experiment och ska förutsäga fortsättningen (fluider, optik, fasta kroppars mekanik). Referensrankningen, Physics-IQ Verified, underhålls av Anates Labs. I kategorin video till video ligger FLUX 3 [large] klart före NVIDIA:s Cosmos3, till en högre kostnad per video.
| Modell och metod (video till video) | Physics-IQ Verified-poäng | Kostnad per normaliserad video |
|---|---|---|
| FLUX 3 [large], bästa av 8 genereringar | 64,35 % | 16,43 dollar |
| FLUX 3 [large] | 61,11 % | 2,08 dollar |
| Cosmos3 Super (NVIDIA) | 50,80 % | 0,82 dollar |
| Cosmos3 Nano (NVIDIA) | 43,00 % | 0,82 dollar |
I kategorin bild till video går FLUX 3 [large] också förbi Physis-Lang, metoden som NVIDIA placerade främst den 29 september. FLUX 3 [large] är en proprietär modell, och tråden anger varken tillgänglighetsdatum eller pris för den här varianten.
🔗 Tråden från @bfl_ai på X 🔗 Physics-IQ Verified-rankningen
Offentliga utvärderingar: GeoGuess Bench och RSI Arena
Två utvärderingar som är öppna för allmänheten går utanför de vanliga benchmarktesten: den ena låter modeller spela GeoGuessr, den andra låter allmänheten rösta om modeller som tränats av agenter.
GeoGuess Bench
6 oktober — Hassan, ansvarig för utvecklarupplevelsen på Together AI, publicerar GeoGuess Bench, ett personligt benchmark som låter modeller spela GeoGuessr: alla ser samma 210 gatubilder och placerar en kartnål som poängsätts enligt spelets formel, med upp till 25 000 poäng per spelomgång med fem rundor. Claude Opus 5.5 tar ledningen, strax före Claude Fable 5.1; överraskningen är Muse Glimmer 30B, Metas modell med öppna vikter, som kommer trea och slår GPT-6 Astra till ungefär 45 gånger lägre kostnad per spelomgång.
| Placering i GeoGuess Bench | Utvärderad modell | Poäng av 25 000 | Kostnad per spelomgång |
|---|---|---|---|
| 1 | Claude Opus 5.5 | 23 412 | 0,064 dollar |
| 2 | Claude Fable 5.1 | 23 307 | 0,115 dollar |
| 3 | Muse Glimmer 30B (öppen) | 22 407 | 0,0049 dollar |
| 4 | GPT-6 Astra | 21 562 | 0,223 dollar |
| 5 | GPT-6.1 Sol | 21 194 | 0,042 dollar |
| 6 | GLM-5.3 Flash (öppen) | 21 183 | 0,0087 dollar |
GLM-5.3 Flash presterar därmed lika bra som GPT-6.1 Sol till ungefär fem gånger lägre kostnad. Det är ett personligt projekt av en anställd på Together AI, som levererar inferens för öppna modeller, och inte en utvärdering från företaget; ingen Gemini-modell finns med, och koden är publicerad på GitHub.
🔗 Hassans tillkännagivande på X 🔗 GeoGuess Bench
RSI Arena
6 oktober — Zichen Chen tillkännager en ny omgång av RSI Arena (för rekursiv självförbättring, recursive self-improvement), den här gången med Hugging Face. AI-agenter har fått GPU:er och ett enda uppdrag: att träna bättre modeller. De har själva valt data, skrivit koden och genomfört experimenten. När den första träningsomgången är klar kommer allmänheten in i loopen: modellerna möts i dueller, alla röstar, och agenterna använder återkopplingen för nya experiment. Hugging Faces Inference Endpoints serverar varje modell live, och webbplatsen listar tio agenter, däribland GPT-6 Astra, Grok 4.7, DeepSeek V4.1 Flash, GLM-5.3 och Muse Spark 1.3; dess kontrollpanel visade API-utgifter på 286,60 dollar av 300 och 755,17 GPU-timmar av 1 000. Teamet lovar att publicera varje modell som agenterna tränat på Hub och, när experimentet är slut, alla artefakter: data, kod och varje agents fullständiga forskningsförlopp.
🔗 Zichen Chens tillkännagivande på X 🔗 RSI Arena
GPU-infrastruktur: NVIDIA publicerar AICR v1.0
6 oktober — NVIDIA publicerar version 1.0 av AI Cluster Runtime (AICR), ett öppet projekt som vill sätta stopp för GPU-kluster i Kubernetes som konfigureras genom försök och misstag. Ett accelererat kluster är beroende av dussintals komponenter med oberoende versioner (kärna, drivrutiner, container-runtime, nätverk, lagring, operatorer, bibliotek), och en kombination som fungerar på ett ställe kan fallera utan felmeddelande på ett annat. AICR svarar med versionslåsta och validerade recept som renderas för Helm, Argo CD, Flux eller Helmfile och åtföljs av signerade valideringsbevis från den testade hårdvaran. Version 1.0 fastställer ett kompatibilitetskontrakt: CLI, REST-API, Go-SDK, driftsättningspaketens struktur och artefaktschemana blir stabila gränssnitt, och varje inkompatibel ändring kommer att kräva en ny huvudversion. NVIDIA uppger att projektet har över 100 bidragsgivare, varav nästan hälften utanför företaget, och nämner integrationer hos Pulumi Labs och i Mirantis multiklusterhanterare k0rdent.
🔗 Inlägg på NVIDIA:s teknikblogg
Claude Startups: upp till 7 000 dollar i produkter och krediter, och en Startup Stack värd 45 000 dollar
6 oktober — Anthropic öppnar Claude Startups, sitt program för grundare som bygger på Claude, för fler startupföretag som grundats för mindre än fem år sedan eller fått finansiering under de senaste två åren.
| Förmån i programmet | Värde som Anthropic uppger |
|---|---|
| Ett år med Claude Team, upp till fem Premium-platser | 6 000 dollar (fem platser à 100 dollar per månad) |
| Engångskredit för API, tillgänglig direkt efter godkännandet | 1 000 dollar |
| Totalt för Claude-produkter och krediter | upp till 7 000 dollar |
| Claude Startup Stack (partnererbjudanden) | upp till 45 000 dollar |
Året med Claude Team gäller företag som är nya på Team, och det faktiska värdet beror på antalet platser och vilken typ de är. Claude Startup Stack, dagens nyhet, samlar rabatter och krediter från företag som bygger med Claude, däribland Linear, Lovable, ElevenLabs, Granola och Hex; maxbeloppet motsvarar det sammanlagda värdet av alla erbjudanden enligt listpriserna i september 2026, och alla erbjudanden kan inte kombineras. Programmet lägger till tider för samtal med Anthropics Applied AI-team, hjälp med att publicera en presentation på Claude Marketplace och tillgång till evenemang.
🔗 Anthropics inlägg om Claude Startups 🔗 Tråden från @claudeai om Claude Startup Stack
Kortnyheter
- Claude Projects och lokal mapp — Dan Fein på Anthropic meddelar att molnsessioner i Claude Projects kan ansluta till en godkänd mapp på datorn, som de bara kommer åt när en uppgift behöver det; utrullningen sker gradvis sedan den 5 oktober, och teamet är nästan framme (Nästan där), enligt Boris Cherny. 🔗 källa · 🔗 Boris Cherny
- Claude i gruppmeddelanden på Slack — Claude kan nu läggas till i Slacks gruppmeddelanden (group DMs) som vilken deltagare som helst; den svarar i en tråd som den fortsätter att följa och kan använda de personliga anslutningarna för den som ber den om hjälp, utan uppgifter om abonnemang eller tidsplan. 🔗 källa
- Boris Cherny och hans sätt att prompta — Boris Cherny låter Opus 5.5 bygga en interaktiv följesajt till ett avsnitt av podcasten Acquired om Home Depot, inklusive akvareller; enligt honom finns det ingen hemlighet bakom att prompta: säg till modellen vad du vill ha, hur mycket arbete den ska lägga på det och hur resultatet ska kontrolleras. 🔗 följesajt · 🔗 hans sätt att prompta
- Atlassian och OpenAI — Enligt ett nytt avtal kommer frontier-modellerna i GPT-6-familjen, däribland GPT-6 Astra, att driva agenterna på Atlassians plattform och i Rovo; över 3 000 utvecklare på Atlassian använder redan Codex, och djupare Jira-integrationer undersöks, utan att något belopp har offentliggjorts. 🔗 källa
- Codex-widgets i ChatGPT för iOS — Version 1.2026.267 av ChatGPT för iOS, från den 2 oktober, lägger till widgets på hemskärmen för de senaste Codex-uppgifterna från valda datorer, andra för återstående användning och dess återställning, även på låsskärmen, samt en inställning som håller tangentbordet öppet. 🔗 källa
- Gemini CLI v0.63.0 och v0.64.0-preview.0 — Den stabila versionen v0.63.0 återger exakt de 15 posterna från förhandsversionen den 29 september, och förhandsversionen v0.64.0-preview.0 samlar de 16 posterna från nattversionerna mellan den 30 september och den 3 oktober: inget nytt innehåll, och nattversionen från den 6 oktober är tom. 🔗 källa
- Mistrals Python-SDK 3.1.0 — Den här versionen, som genereras automatiskt från API:et, lägger till fjorton utvärderingsoperationer i beta i observability-modulen; metoderna
Runsflyttas tillWorkflows.runs, vilket kan göra att befintlig kod slutar fungera trots att bara minor-versionen har ändrats. 🔗 källa - Qwen Code v0.25.1-preview.0 — Dagen efter v0.25.0 kommer den här förhandsversionen med 13 funktioner och 27 rättningar, däribland en experimentell Kubernetes-runtime, Shell-kommandon och övervakning i bakgrunden för Managed Agent samt MCP-regler som inte längre tillåter en server med samma namn. 🔗 källa
- SpaceXAI:s TypeScript-SDK 0.2.2 — Den här versionen publicerades den 5 oktober utan tillkännagivande och innehåller bara en ändring: alternativet
retryBeforeOutputgäller också för ettcreate()-anrop utan kontinuerlig strömning (streaming) som förväntar sig JSON. 🔗 källa - Falcon-Emirati-7B, den emiratiska dialekten — TII specialiserar Falcon-H1-Arabic 7B på emiratarabiska: 84,83 % på Alyah, ett benchmark med 1 173 frågor, och en dialekttrohet på 0,52 jämfört med som bäst 0,05 för ALLaM, Gemma 3 27B, Jais-2 och Fanar-2, enligt en Gemini 3.7 Flash-domare; modellen erbjuds endast på TII:s chattplattform. 🔗 källa
- Datasets 5.1.0 — Biblioteket för dataset, som publicerades den 5 oktober, kan nu läsa Harbor-miljöer för förstärkningsinlärning, det kolumnbaserade formatet Vortex och fem biologiska format (FASTA, FASTQ, GenBank, PDB, mmCIF), och åtgärdar en sårbarhet som gjorde att ett arkiv kunde skriva till en intilliggande katalog. 🔗 källa
- TRL v1.14.2 — Den här patchen rättar ett träningsfel som uppstod utan varning: utan vLLM stannade GRPO, RLOO och Distillation inte vid turens slut för modeller som Gemma eller Phi-3.5 och tränades på all efterföljande text upp till maximal längd; även tre krascher åtgärdas. 🔗 källa
- Jev mot kampanjmejl — I ett communityinlägg sorterar Stephen Solka sina politiska mejl med Jev (99 rätta svar på 100 verkliga mejl, ett falskt positivt), och sedan med en SetFit-klassificerare med 22,6 miljoner parametrar som körs på CPU: 98 % i pilotutvärderingen, men 18 av 23 på svåra fall. 🔗 källa
- Open Together den 16 oktober — vLLM och Hugging Face arrangerar Open Together, en samling för open source-utvecklare som inleder Open Source AI Week fredagen den 16 oktober i San Francisco; enligt Jeff Boudier står 150 personer på väntelistan och kapaciteten har fördubblats. 🔗 källa · 🔗 Jeff Boudier
- Copilot CLI 1.0.93-2 — Den här förhandsversionen lägger till en företagsinställning,
permissions.limitTo, som begränsar nätverksanrop till administrerade domäner, lyfter fram GPT-6.1 Sol, GPT-6 Astra och Luna samt Claude 5.5-modellerna i modellväljaren och läser nu användarinställningar enbart från~/.copilot/settings.json. 🔗 källa - AI Scan i säkerhetsöversikten — Organisations- och företagsadministratörer kan nu se vilka repositorier som har aktiverat AI-analys av pull requests (AI Scan for pull requests) i GitHubs säkerhetsöversikt (security overview), med två filter och en kolumn i CSV-exporten. 🔗 källa
- Detektering av hemligheter: Lovable, Pydantic och Supabase — GitHubs detektering av hemligheter (secret scanning) känner igen fem nya typer av hemligheter, däribland Lovables API-nyckel, Logfire-token och nyckeln till Pydantic AI Gateway samt två Supabase-token; Lovable Labs ansluter också till dess partnerprogram. 🔗 källa
- Devins versionsanteckningar från den 5 oktober — Främst finslipning: en Terminal-flik i sessionens arbetsyta (att öppna Files eller Terminal väcker Devin), insatsnivåer för Devin Review som kan justeras via utlösande åtgärder samt kodanalyser (code scans) som kan hämtas med identifierare via API v3 eller Devins MCP. 🔗 källa
- Delta och dess egna worktrees — På Deltas blogg förklarar Conrad Irwin varför verktyget ersätter Git-worktrees: varje tråd har sin worktree registrerad i DeltaDB och replikerad mellan personer, agenter och maskiner, flera agenter arbetar på samma branch, och ett versionshanterat
.agents/prepare-skript förbereder varje checkout; inlägget åtföljs inte av någon ny version. 🔗 källa - v0: personliga konton blir teamutrymmen — Personliga v0-konton blir teamarbetsytor, med konversationer, projekt och inställningar som migreras automatiskt; dokumentationen reserverar dock vissa funktioner, som teammallar, för abonnemangen Plus, Business och Enterprise. 🔗 källa
- v0 och ChatGPT-abonnemanget på iOS — ChatGPT-abonnemanget, som v0 har accepterat sedan den 29 september, kan nu användas i dess iOS-app, utan prisuppgifter eller ytterligare detaljer. 🔗 källa
- Eleven v4 och Eleven v4 Turbo i topp — ElevenLabs meddelar att dess två talsyntesmodeller som lanserades den 28 september ligger på de två första platserna i Artificial Analysis rankning för talsyntes (text to speech); v4 låg redan först vid lanseringen. 🔗 källa
- HeyGen Video i 2K — En vecka efter lanseringen får HeyGen Video 2K-upplösning; HeyGen uppger att modellen ligger först i OpenRouters videorankning efter användning, utan något särskilt pris för 2K, medan katalogsidan fortfarande visar 0,01 dollar per sekund till slutet av oktober. 🔗 källa
- Nano Banana 2.1 på Pika — Pika lägger till Nano Banana 2.1, den nya versionen av Googles Nano Banana-modell, på sin plattform och i Pika API Club, med enligt Pika bättre visuell kvalitet och högre hastighet; inga priser eller kostnader i krediter anges. 🔗 källa
- DOCA GPUNetIO — NVIDIA gör DOCA GPUNetIO till den gemensamma implementationen av GPU-styrda nätverk (GDA-KI) för NCCL, NVSHMEM och NIXL/UCX, som fullständig version i DOCA SDK och som ett lättare open source-projekt med fokus på RDMA Verbs. 🔗 källa
- Green contexts i CUDA — Ett teknikinlägg från NVIDIA visar hur man reserverar SM för en kritisk uppgift: på en Blackwell-GPU med 148 SM svarar en kernel med 8 SM reserverade på 0,007 ms, jämfört med 0,140 ms med en prioriterad ström (stream) och 3,727 ms utan prioritet. 🔗 källa
- Öppna modeller hos telekomoperatörer — I ett ställningstagande hänvisar NVIDIA till sin telekomundersökning för 2026, där 89 % av de svarande anser att open source är viktigt, och till uttalanden från SoftBank, AT&T och Indosat; ingen ny produkt. 🔗 källa
- Perplexitys guide till samarbetsverktyg — Perplexity jämför tio samarbetsverktyg med IA (Slack, Loom, Confluence, Airtable, Notion, ClickUp, Asana, Monday.com, Trello, Miro), deras IA-funktioner och de abonnemang som inkluderar dem; inga produktnyheter. 🔗 källa
Vad det innebär
Beslutsmodeller blir en egen kategori, med ett eget priskrig och en egen rankning. Samma dag sätter OpenAI priset för sitt Decisions API till 0,10 dollar per miljon tokens i indata, och Perplexity sänker sitt till 0,02 dollar, hälften av priset för fem dagar sedan; ingen av dem tar betalt för utdata. Dessa modeller skriver inte texter, de väljer eller poängsätter: man betalar för läsningen och vill ha dem snabba, och OpenAI utlovar svar som är ungefär tio gånger snabbare än med dess Responses API. Decision Index 0.3 fungerar som gemenskapens domare, och dess nya privata halva ska mäta färdigheter snarare än förmågan att klara kända testsviter. Dess bedömning väger redan tungt i leverantörernas kommunikation: Perplexity hänvisar till den i sitt tillkännagivande, även om modellkortet anger en annan poäng än rankningen.
IA flyttar in i kontorsverktygen snarare än tvärtom. Claude kommer till Google Docs, Sheets och Slides efter Excel, PowerPoint och Word, ansluter till gruppmeddelanden i Slack, och GPT-6-modellerna ska driva Rovo-agenterna hos Atlassian. I dessa integrationer handlar frågan inte längre bara om modellens kvalitet utan också om kontroll: ett läge där varje ändring måste godkännas, anslutningar som följer Googles delningsbehörigheter och Enterprise-kontroller som tillämpas på tillägget. Samma logik genomsyrar dagens agentverktyg, från granskningsbeslut som går att ångra i Antigravity till versionshanterade utkast i ElevenAgents Architect.
Inom cybersäkerhet varierar tillgången med verifieringsnivån. Anthropics CVP ändrar inte modellen utan dess skyddsmekanismer: i CyScenarioBench går samma Opus 5.5 från uppgifter som blockeras redan vid första prompten utan verifiering till 34 av 50 framgångsrikt utförda uppgifter med Red Team Access. Mistral för fram ett annat argument, nämligen en modell som inte vägrar: företaget uppger ett resultat på 82 % i ett cybersäkerhetstest som Claude Opus 5.5 och GPT-6 Astra enligt företaget vägrar genomföra. De båda tillvägagångssätten möts på en punkt: den bredaste tillgången till cybersäkerhetsförmågor går först till verifierade yrkespersoner, antingen Mistrals partner innan vikterna publiceras eller deltagare i Anthropics program.
Modellerna sträcker sig också mot båda ytterligheterna i storlek. I den stora änden finns Mistral Large 4 och dess 1 000 miljarder parametrar, vars vikter utlovas till slutet av oktober; i den lilla finns EmbeddingGemma 2, som ryms i ungefär 567 MB RAM på en telefon, Tiny Aya L2-Thinker med sina 3,35 miljarder parametrar eller Falcon-OCR-Arabic med sina 270 miljoner, som än så länge bara finns som demonstration. Många av dagens siffror har dock mätts av leverantören själv: Mistrals resultat, förstaplatsen som Black Forest Labs uppger sig ha, TII:s egen testsvit, Perplexitys modellkort, Ironclads uppgifter som poängsatts av OpenAI eller förbättringarna vid sammanslagning som GitHub tillkännager. Det är ofta den enda mätningen som finns tillgänglig den dag något tillkännages; den skulle vinna på att kontrolleras mot oberoende utvärderingar, vilket just vikterna för Mistral Large 4 kommer att möjliggöra när de publicerats.
Källor
- Mistrals inlägg om Mistral Large 4
- Mistral Large 4:s modellkort i dokumentationen
- Anthropics inlägg om Claude for Google Workspace
- @claudeai på X, Claude for Google Workspace
- Anthropics inlägg om Cyber Verification Program
- Hjälpsida för Cyber Verification Program
- Comcast och Booz Allen med Claude Mythos
- EmbeddingGemma 2 på Googles blogg
- Modellkort för EmbeddingGemma 2
- @GoogleDeepMind på X, EmbeddingGemma 2
- EmbeddingGemma 2 på Hugging Face
- Guide till OpenAI:s Decisions API
- Ändringslogg för OpenAI:s API
- @perplexitydevs på X, pplx-decider-v1.1-27b
- pplx-decider-v1.1-27b på Hugging Face
- @multimodalart på X, Decision Index 0.3
- Decision Index 0.3
- OpenAI:s inlägg om samarbetet med Ironclad
- @OpenAIDevs på X, användningsnivåer
- Dokumentation om anropsgränser för OpenAI:s API
- OpenAI:s hjälpartikel om BAA för API:et
- Ändringslogg för Perplexitys API
- Dokumentation för Perplexitys verktyg image_search
- Modellkort för GLM 5.3 på Amazon Bedrock
- @Zai_org på X, GLM-5.3 på Bedrock
- Claude Code 2.1.290
- Claude Code 2.1.291
- Claude Code 2.1.292
- Praktisk guide till molnsessioner på claude.dev
- @ClaudeDevs på X, bonuskredit för molnsessioner
- Versionsinformation för Mistral Vibe v2.26.0
- Ändringslogg för Google Antigravity
- @Replit på X, kontext från alla projekt
- GitHubs ändringslogg om staplade pull requests
- Coheres forskningsinlägg om Tiny Aya L2-Thinker
- TII:s inlägg om Falcon-OCR-Arabic
- Versionsinformation för Diffusers 0.41.0
- Versionsinformation för Transformers v5.19.0
- ElevenLabs inlägg om ElevenAgents Architect
- @bfl_ai på X, FLUX 3 och Physics-IQ
- Rankningen Physics-IQ Verified
- @nutlope på X, GeoGuess Bench
- GeoGuess Bench
- @my_cat_can_code på X, RSI Arena
- RSI Arena
- AICR v1.0 på NVIDIAs teknikblogg
- Anthropics inlägg om Claude Startups
- @claudeai på X, Claude Startup Stack
- Dan Fein på X, Claude Projects och lokal mapp
- Boris Cherny på X, stegvis utrullning av Claude Projects
- Dan Fein på X, Claude i gruppmeddelanden i Slack
- Boris Cherny på X, kompletterande webbplats för Acquired
- Boris Cherny på X, hans sätt att prompta Claude
- Atlassian och OpenAI utökar sitt partnerskap
- Ändringslogg för ChatGPT och Codex, ChatGPT för iOS 1.2026.267
- Gemini CLI v0.63.0
- Mistrals Python-SDK v3.1.0
- Qwen Code v0.25.1-preview.0
- SpaceXAI:s TypeScript-SDK v0.2.2
- TII:s inlägg om Falcon-Emirati
- Datasets 5.1.0
- TRL v1.14.2
- Stephen Solkas inlägg
- @vllm_project på X, Open Together
- Jeff Boudier på X, väntelista för Open Together
- Copilot CLI 1.0.93-2
- GitHubs ändringslogg om aktiveringsstatus för AI Scan
- GitHubs ändringslogg om nya detektorer för hemligheter
- Versionsinformation för Devin från den 5 oktober
- Conrad Irwins inlägg på Deltas blogg
- Ändringslogg för v0, personliga konton blir teamarbetsytor
- @v0 på X, ChatGPT-abonnemang på iOS
- @ElevenLabs på X, Eleven v4 i täten
- @HeyGenDev på X, HeyGen Video i 2K
- @pika_labs på X, Nano Banana 2.1 på Pika
- DOCA GPUNetIO på NVIDIAs teknikblogg
- Green contexts på NVIDIAs teknikblogg
- Öppna modeller och telekomoperatörer, NVIDIAs blogg
- Perplexitys guide till samarbetsverktyg