ai-powered-markdown-translatorArtículo traducido del francés al español con gpt-6.1-sol.
Mistral lanza en versión preliminar Mistral Large 4, un modelo multimodal de 1 000 mil millones de parámetros cuya API está disponible para todos desde hoy y cuyos pesos se prometen para finales de octubre. Anthropic integra Claude en Google Docs, Sheets y Slides y reorganiza su programa de verificación de ciberseguridad en tres niveles de acceso, mientras Google DeepMind publica EmbeddingGemma 2, un modelo de embeddings abierto y multimodal que cabe en un teléfono. Los modelos de decisión también tienen su día: OpenAI abre su API Decisions en beta pública, Perplexity reduce su precio a la mitad y una clasificación comunitaria los compara.
Mistral Large 4: 1 000 mil millones de parámetros en versión preliminar, pesos prometidos para finales de octubre
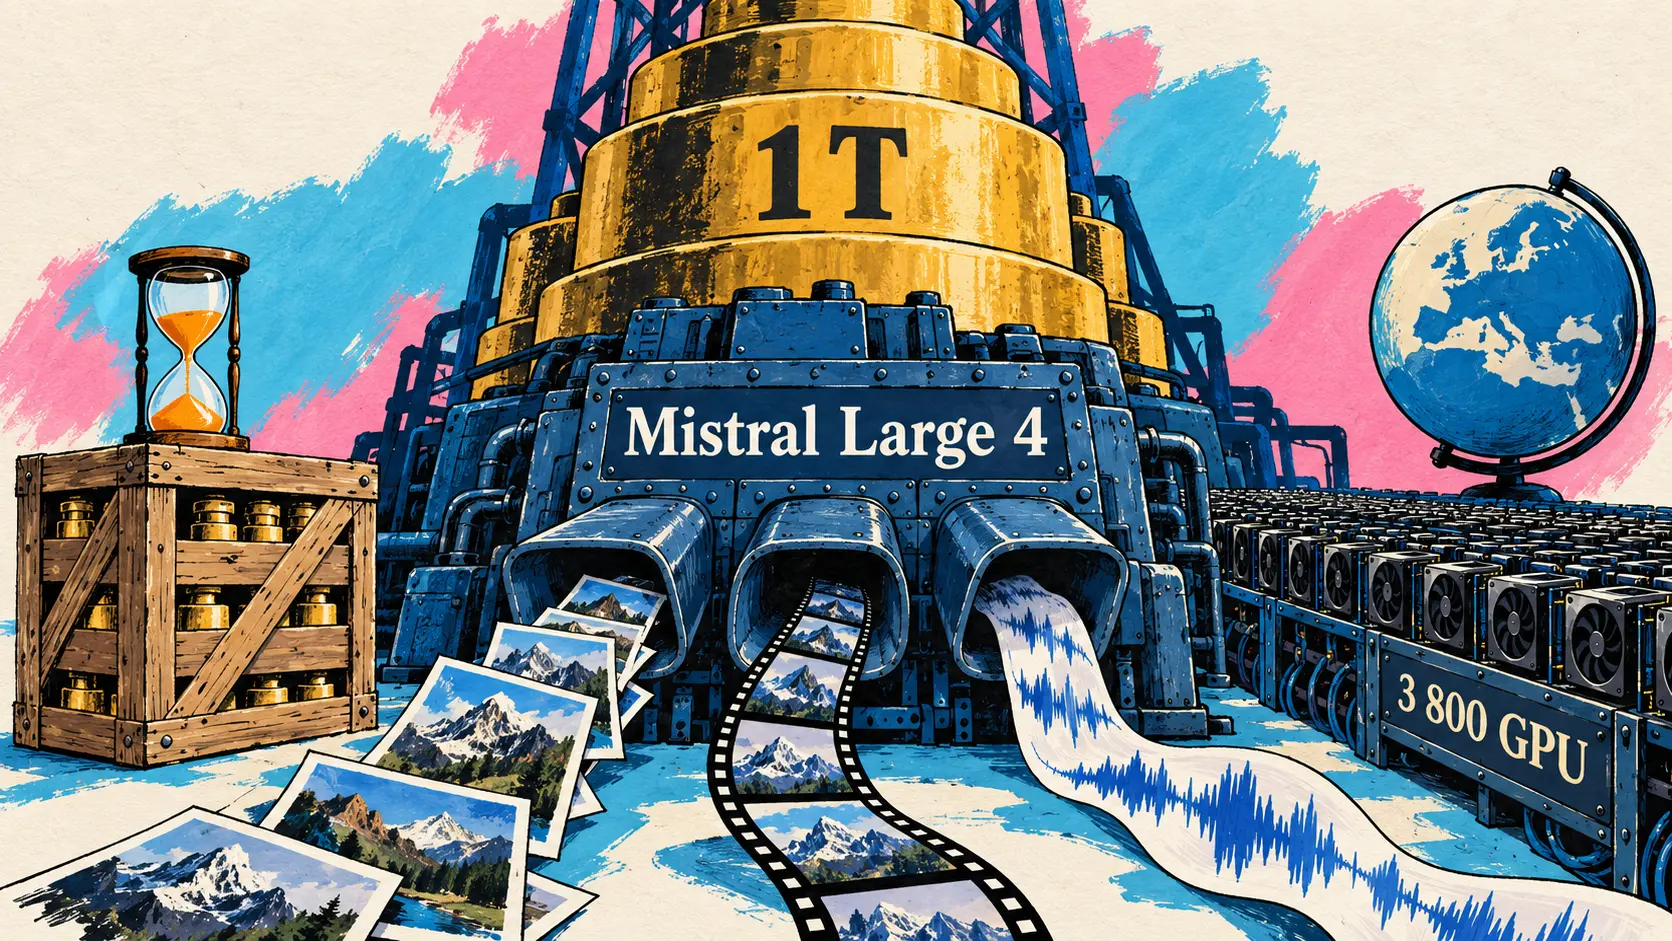
6 de octubre — Mistral AI lanza en versión preliminar pública Mistral Large 4, apodado ML4 y, «muy oficialmente», el Chonk. Es el mayor modelo de la empresa hasta la fecha: una mezcla de expertos (Mixture-of-Experts) nativamente multimodal de 1 000 mil millones de parámetros (1T), de los cuales 49 mil millones están activos según la publicación del anuncio, que reúne instrucciones, razonamiento y capacidades agénticas en un contexto de un millón de tokens. La ficha de la documentación ofrece otras cifras, sin explicar la diferencia: 1 050 mil millones de parámetros, de los cuales 52 mil millones están activos, más un codificador de visión de 1,6 mil millones.
La API está abierta a todos desde hoy en Mistral Studio, pero los pesos aún no se han publicado: Mistral los promete para finales de octubre, junto con detalles sobre la arquitectura y el posentrenamiento. Mientras tanto, responsables de ciberseguridad, socios verificados y autoridades estatales ponen a prueba el modelo en condiciones reales, con acceso sujeto a una moderación reducida. ML4 se ha entrenado desde cero con 3 800 GPU NVIDIA Grace Blackwell en los centros de datos europeos de Mistral, que también sirven la versión preliminar. La empresa prevé un despliegue europeo que operará de principio a fin, bajo la legislación europea, y presenta el modelo como el primer hito de la hoja de ruta financiada por su Serie D de 3 mil millones de euros.
La ciberseguridad es el principal argumento. Según Mistral, ML4 figura entre los cinco primeros modelos del Artificial Analysis Cyber Index y obtiene un 82 % en una de sus pruebas, que consiste en reproducir una vulnerabilidad real de un software open source y después corregirla, la mejor puntuación de todos los modelos. La empresa afirma que Claude Opus 5.5 y GPT-6 Astra obtienen cerca de cero en esa misma prueba porque rechazan la tarea.
| Benchmark evaluado | Puntuación anunciada por Mistral | Comparación citada por Mistral |
|---|---|---|
| DeepSWE v1.1 | 61,7 % | — |
| Coding Agent Index (combinado) | 49,8 % | por delante de DeepSeek V4 Pro 0813 y Qwen3.8 Max |
| Evaluación humana a ciegas de Surge AI (código, sobre 5) | 3,74, 2.º de 5 | por detrás de Claude Opus 5 (4,22) |
| Cybench (40 retos) | 93 % | — |
| AA Cyber Index, reproducir y después corregir una vulnerabilidad | 82 % | mejor puntuación de todos los modelos |
| AutomationBench (657 procesos de negocio) | 59,9 % | por delante de Kimi K3, MiMo-V2.6-Pro y DeepSeek V4 Pro |
La publicación y la ficha también difieren en el precio: la tarjeta de la publicación muestra 1,36 dólares por millón de tokens de entrada y 4,18 dólares de salida, mientras que la ficha tacha esas tarifas y muestra al lado un precio reducido a la mitad, sin precisar la duración ni dar explicaciones.
| Característica de ML4 | Según la publicación del anuncio | Según la ficha de la documentación |
|---|---|---|
| Parámetros totales | 1 000 mil millones | 1 050 mil millones |
| Parámetros activos | 49 mil millones | 52 mil millones |
| Entrada, por millón de tokens | 1,36 dólares | 0,68 dólares (1,36 tachado) |
| Salida, por millón de tokens | 4,18 dólares | 2,09 dólares (4,18 tachado) |
Todas estas puntuaciones son las de Mistral, que precisa que el aprendizaje por refuerzo de la versión preliminar continúa sin señales de saturación y espera avances rápidos en las próximas semanas.
🔗 Publicación de Mistral sobre Mistral Large 4 🔗 Ficha de Mistral Large 4 en la documentación
Claude for Google Workspace: Claude se integra en Docs, Sheets y Slides
6 de octubre — Anthropic lanza Claude for Google Workspace, un complemento (add-on) que abre Claude en un panel lateral de Google Docs, Sheets y Slides, en beta pública para todos los planes de pago. Claude lee el archivo abierto, ve la selección actual (texto, celdas o diapositivas) y modifica el archivo directamente.
| Aplicación de Google | Qué hace Claude en ella |
|---|---|
| Docs | Correcciones y cambios de estilo directamente, tarjetas de sugerencias que se pueden aplicar o ignorar para las reescrituras más profundas |
| Sheets | Fórmulas, tablas dinámicas, gráficos nativos, nuevas pestañas, procesamiento de un rango con Python para una unión o una limpieza |
| Slides | Diapositivas basadas en los diseños y el tema de la presentación, comprobación de los elementos que se superponen o se salen de los límites |
El usuario elige el grado de autonomía: en el modo «preguntar antes de modificar» (Ask before edits), activo por defecto, cada modificación pasa por una tarjeta de aprobación; en el modo «aceptar todo» (Accept all edits), Claude continúa sin detenerse. Conectado a la cuenta de Claude, el panel utiliza los mismos modelos, conectores y habilidades (skills). En los planes Enterprise, la Compliance API, las claves de cifrado gestionadas por el cliente (CMEK) y la exportación de auditoría OpenTelemetry también se aplican al complemento.
Claude now works inside Google Docs, Sheets, and Slides, and those files also open inside Claude. In Google Workspace, Claude sits in a sidebar next to your file, reads what you have open, and edits it in place. You can approve each edit before it lands.
🇪🇸 Claude ya funciona en Google Docs, Sheets y Slides, y estos archivos también se abren en Claude. En Google Workspace, Claude se sitúa en un panel lateral junto a tu archivo, lee lo que has abierto y lo modifica directamente. Puedes aprobar cada modificación antes de que se aplique. — @claudeai en X
La integración en sentido inverso llega al mismo tiempo: nuevos conectores de Google Docs, Sheets y Slides, también en beta, permiten crear y modificar archivos de Google desde Claude, pegando un enlace o solicitando un documento nuevo. En las configuraciones compatibles, el archivo se abre en un panel junto a la conversación, y el acceso de Claude respeta los permisos para compartir de Google. El complemento se instala desde Google Workspace Marketplace (Extensiones > Claude > Abrir Claude) y los administradores pueden desplegarlo desde la consola de Google Admin; en Team y Enterprise, un propietario debe activar primero los conectores. Google Workspace se suma así a Microsoft 365, donde Claude para Excel, PowerPoint y Word está en disponibilidad general desde el 7 de mayo.
🔗 Publicación de Anthropic sobre Claude for Google Workspace
Cyber Verification Program: Anthropic abre Opus 5.5, Sonnet 5.5 y Mythos 5.1 en tres niveles de acceso
6 de octubre — Anthropic reorganiza su programa de verificación de ciberseguridad (Cyber Verification Program, CVP), que ofrece a los profesionales de seguridad verificados capacidades que sus modelos para el público general bloquean. Desde hacía seis meses coexistían dos iniciativas: Project Glasswing, que daba acceso a Claude Mythos a las organizaciones responsables del software más crítico, y un CVP de un único nivel que reducía las salvaguardas de los modelos Opus y Sonnet. Ambas se fusionan en tres niveles, que dan acceso a Claude Opus 5.5, Claude Sonnet 5.5, Claude Mythos 5.1 y a los modelos futuros. Los modelos en disponibilidad general (Opus 5.5, Fable 5.1, Sonnet 5.5) mantienen, por su parte, salvaguardas prudentes que bloquean la mayor parte del trabajo de ciberseguridad.
| Nivel de acceso | Usos cubiertos | Público destinatario y plazo |
|---|---|---|
| Defense Access | Centro de operaciones de seguridad, respuesta a incidentes, ingeniería inversa de software malicioso, análisis de vulnerabilidades | Equipos de seguridad, infraestructuras críticas de cualquier tamaño, mantenedores open source, investigadores; unos días |
| Red Team Access | Usos defensivos, además de pruebas de intrusión y ejercicios de ataque simulado (red teaming) autorizados | Solo organizaciones, en los sistemas que están autorizadas a probar; unas semanas |
| Specialized Access | Pruebas de sistemas críticos para la seguridad: aviación, redes eléctricas, telecomunicaciones, transferencias interbancarias, redes administrativas | Algunas organizaciones examinadas una a una con el gobierno estadounidense; miembros de Glasswing transferidos |
En Red Team Access, las acciones que pueden causar daños físicos o una interrupción masiva, como desplegar ransomware, siguen bloqueadas en tiempo real. Para comprobar su configuración, Anthropic sometió a Opus 5.5 a CyScenarioBench, una evaluación de operaciones de ciberseguridad en varias etapas, con las salvaguardas de cada nivel (10 retos, 5 intentos cada uno).
| Configuración probada por Anthropic (Opus 5.5) | Resultado en CyScenarioBench (50 intentos) |
|---|---|
| Sin CVP | Todas las tareas bloqueadas desde el primer prompt |
| Defense Access | 46 intentos bloqueados en algún momento, 4 completados con éxito |
| Red Team Access | Ningún bloqueo, 34 tareas completadas con éxito, el equivalente al 67,6 % del modelo sin salvaguardas |
La publicación también presenta un primer balance de Glasswing, con cifras parciales según Anthropic: al menos 129 000 vulnerabilidades verificadas encontradas por los socios de abril a julio, más 5 500 mediante los análisis open source de Anthropic, de las cuales más de 33 000 se clasificaron como críticas o de gravedad alta. Estas cifras se basan en 33 informes de socios, y Anthropic estima que el impacto real es «al menos cinco veces mayor». En un testimonio publicado el mismo día, Comcast afirma haber encontrado con Claude Mythos Preview una vulnerabilidad crítica de autenticación al evaluar 258 sistemas y unos 170 millones de líneas de código, y un analista de Booz Allen revisó 138 repositorios en doce días.
En la práctica, el programa exige la retención de datos para vigilar los abusos, a la espera de Enterprise Frontier Safeguards (EFS), que permitirá más adelante este otoño conservar esos datos en un cloud controlado por el cliente; las organizaciones que ya utilizan Fable 5.1 o Mythos 5.1 con retención cero pueden hacer lo mismo con el CVP. El programa está disponible en Claude Platform, Vertex AI y Microsoft Foundry, y en Amazon Bedrock solo para los clientes que cumplen los requisitos de EFS. Solo se puede presentar una solicitud individual para Defense Access, con un plan de pago, y este nivel deberá adoptar para el 15 de diciembre una autenticación multifactor resistente al phishing y dejar de usar las claves API. Está previsto un seminario web el 14 de octubre a las 9 h PT.
🔗 Publicación de Anthropic sobre el Cyber Verification Program 🔗 Página de ayuda del Cyber Verification Program 🔗 Comcast y Booz Allen con Claude Mythos
EmbeddingGemma 2: el modelo abierto de embeddings de Google se vuelve multimodal
6 de octubre — Google DeepMind publica EmbeddingGemma 2, la segunda generación de su modelo abierto de embeddings diseñado para ejecutarse en el dispositivo. El primer EmbeddingGemma, descargado más de 20 millones de veces según Google, solo procesaba texto; el nuevo proyecta texto (incluido código), imágenes, vídeo y audio, por separado o combinados, en un mismo espacio de 768 dimensiones. Basado en la arquitectura de Gemma 4, se publica bajo la licencia Apache 2.0.
Meet EmbeddingGemma 2, our first natively multimodal open model for on-device embeddings. It expands beyond text to unify code, images, audio, and video in a shared space.
🇪🇸 Presentamos EmbeddingGemma 2, nuestro primer modelo abierto nativamente multimodal para embeddings en el dispositivo. Va más allá del texto para unificar código, imágenes, audio y vídeo en un espacio compartido. — @GoogleDeepMind en X
El modelo tiene 740 millones de parámetros, pero es modular: un núcleo de texto de 270M al que se añaden bajo demanda un codificador de visión (170M) y un codificador de audio (300M). Por tanto, una aplicación que solo usa texto carga únicamente 270M parámetros. Con cuantización, Google mide en un Pixel 11 Pro unos 191 Mo de RAM activa para los pesos de texto y 567 Mo para el modelo multimodal completo.
| Característica de EmbeddingGemma 2 | Valor anunciado por Google |
|---|---|
| Parámetros totales | 740M (texto 270M, visión 170M, audio 300M) |
| Dimensiones de los vectores | 768, truncables a 512, 256 o 128 |
| Ventana de contexto | 8K tokens, cuatro veces la de la primera versión |
| RAM activa en Pixel 11 Pro (cuantizado) | unos 191 Mo solo con texto, 567 Mo en multimodal |
| MTEB Code | 78,68, frente a 68,76 de la primera versión |
| MTEB multilingüe v2 | 61,36, frente a 61,15 de la primera versión |
El aprendizaje de representaciones «en muñecas rusas» (Matryoshka Representation Learning) permite acortar los vectores, con unas necesidades de almacenamiento hasta seis veces menores; según la ficha del modelo, la calidad apenas se ve afectada hasta las 256 dimensiones, y las 128 dimensiones son adecuadas sobre todo para usos solo de texto. La mejora más clara corresponde al código, con casi diez puntos más en MTEB Code según Google, mientras que el texto multilingüe se mantiene en el nivel anterior.
Los usos previstos son la búsqueda y la generación aumentada por recuperación (RAG) totalmente locales, por ejemplo, encontrar un fragmento de un vídeo a partir de una nota de voz. Como el modelo comparte el segmentador de texto (tokenizer) y el codificador de audio de Gemma 4, ambos pueden ejecutarse juntos con un consumo de memoria reducido. Los pesos están disponibles en Hugging Face y Kaggle; su llegada al Model Garden de Gemini Enterprise Agent Platform se anuncia para «pronto», sin fecha. El modelo es compatible desde su lanzamiento con Transformers (versión 5.19.0), sentence-transformers, MLX, vLLM, llama.cpp, Ollama y LM Studio, así como en el navegador con transformers.js.
🔗 Anuncio en el blog de Google 🔗 Ficha del modelo EmbeddingGemma 2 🔗 Pesos en Hugging Face
Modelos de decisión: OpenAI abre su API Decisions, Perplexity publica Decider v1.1 y reduce su precio a la mitad, el Decision Index 0.3 los clasifica
Los modelos de decisión, que eligen una opción o puntúan una entrada en lugar de redactar una respuesta libre, han tenido su día: dos proveedores revisan su oferta y sus tarifas, y la clasificación comunitaria de la categoría cambia de metodología.
La API Decisions de OpenAI en beta pública
6 de octubre — Una semana después de abrirse con acceso limitado en el DevDay, la API Decisions de OpenAI pasa a beta pública, con disponibilidad general prevista «en las próximas semanas». Responde a preguntas cerradas sobre un texto, una imagen o ambos, con GPT-6 Luna, el único modelo disponible, a través de un punto de acceso específico (POST /v1/decisions); según OpenAI, sus respuestas tipadas llegan unas 10 veces más rápido que con la Responses API. La novedad del día es la tarifa: 0,10 dólares por millón de tokens de entrada, sin cobro por la salida ni por la caché, más los recargos por procesamiento regional y contexto largo.
| Tipo de pregunta | Uso previsto | Resultado devuelto |
|---|---|---|
Predicado (predicate) | Comprobar una condición, como un producto dañado en una foto | Probabilidad de 0 a 1 de que la condición sea verdadera |
Elección (choice) | Elegir una opción de una lista proporcionada | La opción, la probabilidad de cada una y un índice de confianza |
Puntuación (score) | Puntuar en niveles ordenados, como la gravedad de un incidente | Media de los niveles ponderada por las probabilidades |
Varias preguntas pueden referirse a la misma entrada en una sola solicitud, y las imágenes deben enviarse en base64, sin URL alojada ni identificador de archivo. La API admite la retención cero de datos (Zero Data Retention) y los usos sujetos a HIPAA para los clientes que cumplan los requisitos, con residencia de datos en Estados Unidos y Europa.
🔗 Guía de la API Decisions 🔗 Changelog de la API de OpenAI
pplx-decider-v1.1-27b de Perplexity y la reducción del precio a la mitad
6 de octubre — Cinco días después de lanzar su propia Decisions API, Perplexity actualiza el modelo que la hace funcionar, en un hilo de su cuenta para desarrolladores, @perplexitydevs. Publicado con pesos abiertos bajo la licencia Apache 2.0 en Hugging Face, pplx-decider-v1.1-27b mantiene la base Qwen3.8-27B de la v1, lee texto e imágenes en un contexto de 250k tokens y elimina la máscara causal (causal mask) de sus capas de atención completa. La Decisions API, que ahora sirve este modelo, cuesta 0,02 dólares por millón de tokens de entrada, la mitad de los 0,04 dólares de la v1, y la salida sigue siendo gratuita.
| Categoría del Decision Index (ficha de Hugging Face) | Puntuación de Jev | Puntuación de la v1 | Puntuación de la v1.1 |
|---|---|---|---|
| Conocimientos (Knowledge) | 51,4 | 40,9 | 48,18 |
| Lenguaje (Language) | 62,0 | 63,5 | 69,45 |
| Recuperación de información (Retrieval) | 55,4 | 54,9 | 61,26 |
| Herramientas (Tools) | 75,1 | 79,3 | 78,88 |
| Artes (Arts) | 37,7 | 39,4 | 44,66 |
| Puntuación global ponderada | 57,9 | 56,4 | 61,56 |
Según la ficha del modelo, la puntuación global pasa de 56,4 a 61,56, por delante de los 57,9 de Jev, el modelo de decisión de TypeSafe AI, que, sin embargo, sigue por delante en conocimientos. Perplexity también afirma obtener la mejor puntuación del nuevo Decision Index 0.3. Para alojarlo por cuenta propia, se necesita una GPU capaz de albergar unos 49 Gio de pesos y la implementación proporcionada, porque una inferencia causal estándar no reproduce el comportamiento medido.
🔗 El hilo de @perplexitydevs en X 🔗 pplx-decider-v1.1-27b en Hugging Face
El Decision Index 0.3
6 de octubre — apolinario, ingeniero de Hugging Face, publica la versión 0.3 del Decision Index, la clasificación comunitaria de los modelos de decisión abiertos que reproducen el Decision Model de Jev. Ahora cuenta con 112 modelos, de los cuales 111 son reproducciones abiertas, que se ejecutan en una NVIDIA RTX PRO 6000. La metodología cambia: la puntuación completa (Full score) combina 37 bancos de pruebas públicos, pruebas privadas que miden las mismas competencias y tareas privadas procedentes de nuevos ámbitos, para que la posición refleje competencias y no solo el éxito en bancos de pruebas conocidos. También aparece una pestaña de visión.
| Puesto mostrado | Modelo clasificado | Puntuación completa |
|---|---|---|
| 1 | Perplexity Decider v1.1 (27B) | 62,8 |
| 2 | Fastino GLiDE sin razonamiento (28B) | 60,2 |
| Referencia | Jev | 60,1 |
| 3 | Torchcast Decision 27B | 59,9 |
| 4 | deck31b (Gemma 4 31B) | 59,0 |
Las dos puntuaciones de Decider v1.1 no deben confundirse: 61,56 es la que publica la ficha de Perplexity, 62,8 la que calcula esta clasificación con su nueva metodología. Las pruebas privadas, por su propia naturaleza, no se publican.
🔗 El anuncio de apolinario en X 🔗 El Decision Index 0.3
Control del ordenador: OpenAI entrena GPT-6 Astra con los contratos de Ironclad
6 de octubre — OpenAI inicia colaboraciones de investigación con proveedores de software para que sus agentes sean más eficaces en el software empresarial, una iniciativa de control del ordenador (computer use), y comienza con Ironclad, especialista en contratos asistidos por IA. Los equipos han definido 11 tareas de los ámbitos jurídico, comercial y de compras, de entre 30 y 40 minutos cada una para un usuario experimentado según OpenAI, evaluadas con entre 8 y 50 criterios. Ironclad ha proporcionado entornos alojados de su software, donde los modelos se han entrenado mediante aprendizaje por refuerzo con tareas sintéticas extraídas de contratos públicos de la base EDGAR de la SEC.
| Medición de OpenAI en las 11 tareas | GPT-5.6 Sol (razonamiento High) | GPT-6 Astra (razonamiento Max) |
|---|---|---|
| Puntuación media | 41,6 % | 55,0 % (+32 %) |
| Tiempo medio estimado por intento (simulado) | 37,0 minutos | 19,2 minutos (-48 %) |
GPT-6 Astra es el primer modelo de vanguardia de OpenAI entrenado con estas tareas, y un modelo interno utilizado durante su desarrollo alcanza el 63,7 %. Estas cifras son de OpenAI, y los tiempos se simulan a partir de velocidades de procesamiento supuestas, no se miden en clientes. OpenAI invita a otros proveedores a proponer tareas que los agentes actuales todavía no resuelven de forma fiable.
🔗 Publicación de OpenAI sobre su colaboración con Ironclad
API y plataformas: niveles y BAA de la API de OpenAI, documentos e imágenes en la Agent API de Perplexity, GLM-5.3 en Bedrock
Cuatro cambios afectan a los desarrolladores que compran inferencia: las condiciones de acceso a la API de OpenAI, las herramientas de la Agent API de Perplexity y un nuevo modelo abierto en el catálogo de AWS.
Los niveles de uso de la API de OpenAI pasan de cinco a tres
6 de octubre — OpenAI simplifica el acceso a los límites de frecuencia (rate limits) más elevados de su API: los cinco niveles de uso de pago se convierten en tres, Build, Launch y Grow. El más alto, Grow, se obtiene con 500 dólares de pagos acumulados por la API, frente a los 1 000 dólares del antiguo nivel más alto. Las organizaciones que ya están en un nivel de pago cambian automáticamente, sin tener que hacer nada, y después suben de nivel cuando sus compras acumuladas de créditos alcanzan los umbrales; el nivel gratuito sigue limitado a 100 dólares al mes.
| Nivel de uso | Umbral de compras acumuladas | Límite de uso mensual | Astra, Sol y Terra (solicitudes y tokens por minuto) | Luna (solicitudes y tokens por minuto) |
|---|---|---|---|---|
| Build | 5 dólares | 500 dólares | 5 000 y 1 000 000 | 5 000 y 2 000 000 |
| Launch | 100 dólares | 5 000 dólares | 10 000 y 4 000 000 | 10 000 y 10 000 000 |
| Grow | 500 dólares | 200 000 dólares | 15 000 y 40 000 000 | 30 000 y 180 000 000 |
🔗 El hilo de @OpenAIDevs en X 🔗 Documentación de los límites de frecuencia
El BAA y el cumplimiento de HIPAA mediante autoservicio en la API de OpenAI
5 de octubre — Las organizaciones que procesan datos de salud protegidos con la API de OpenAI ya pueden firmar por sí mismas el acuerdo de socio comercial (Business Associate Agreement, BAA) que exige la ley estadounidense HIPAA. En Settings > Organization > General, un administrador acepta el BAA estándar y activa el soporte de cumplimiento de HIPAA, sin contrato empresarial. Este autoservicio está reservado a las organizaciones que cumplen los requisitos y tienen un historial consolidado de uso de la API, y la activación no puede revertirse desde estos ajustes. Las cláusulas personalizadas siguen requiriendo una solicitud por correo electrónico, con respuesta en uno o dos días laborables. OpenAI recuerda que firmar el BAA no hace que una aplicación cumpla la normativa por sí solo, y que no se ofrece ningún BAA para ChatGPT Business.
🔗 Artículo de ayuda de OpenAI sobre el BAA de la API
La Agent API de Perplexity lee documentos y busca imágenes
5 de octubre — El changelog de la API de Perplexity recibe tres entradas a última hora de la noche. La Agent API ahora acepta como entrada documentos PDF, DOC, DOCX, TXT y RTF, integrados en la solicitud o indicados mediante una URL HTTPS pública, con compatibilidad según el modelo y el proveedor elegidos. Una nueva herramienta, image_search, busca imágenes en la web y devuelve resultados estructurados, con la dirección de la imagen y la de su página de origen: de 1 a 30 imágenes por llamada, 5 por defecto, filtros de dominios y formatos, y búsqueda segura activada por defecto. Cuesta 2,50 dólares por cada 1 000 invocaciones exitosas, y las llamadas fallidas no se cobran. La tercera entrada corrige el cálculo de los costes: las respuestas ahora detallan el coste de las extracciones realizadas en el entorno aislado, con la tarifa de GPT-6 Luna sin cambios.
🔗 Changelog de la API de Perplexity 🔗 Documentación de la herramienta image_search
GLM-5.3 de Z.ai en Amazon Bedrock
6 de octubre — Z.ai anuncia la llegada de GLM-5.3, su modelo insignia de pesos abiertos, a Amazon Bedrock; la ficha de AWS fecha el lanzamiento el 5 de octubre. Es una mezcla de expertos de 744 mil millones de parámetros, de los cuales unos 40 mil millones están activos por token, con un contexto de un millón de tokens y hasta 128 000 tokens de salida. El acceso está reservado a los clientes que cumplen los requisitos, que deben recurrir a su equipo de cuenta de AWS, y el modelo solo se sirve mediante inferencia entre regiones (perfil US o global), con almacenamiento de prompts en caché a partir de 1 024 tokens y los niveles de servicio Standard, Priority, Flex y Reserved. La ficha no indica ningún precio y remite a la página de tarifas de Bedrock. GLM-5.3 sigue a Kimi K3 (22 de septiembre) y Grok 4.7 (28 de septiembre), que llegaron a Bedrock en las dos últimas semanas.
🔗 Ficha de GLM 5.3 en Amazon Bedrock 🔗 El anuncio de Z.ai en X
Agentes de código: Claude Code 2.1.290 a 2.1.292, sesiones cloud, Vibe CLI 2.26.0, Antigravity y Replit
Los agentes de código reciben cinco actualizaciones, del terminal al editor: tres versiones de Claude Code en menos de veinte horas, una guía de las sesiones cloud, una Vibe CLI cuya nueva interfaz en Rust se amplía, la extensión Antigravity para VS Code y un Replit que ve todos los proyectos del usuario.
Claude Code 2.1.290 a 2.1.292
5 y 6 de octubre — Publicada el 5 de octubre a las 23 h 33 UTC, Claude Code 2.1.290 es una versión extensa: 190 entradas, de las cuales 131 son correcciones. claude attach y claude logs aceptan parte del nombre de una sesión en lugar de su identificador, y /claude-api managed-agents-onboard transforma el modelo Managed Agents descrito en una página web en archivos ant apply. El presupuesto de búsqueda web de la sesión interactiva ya no se agota tras 200 llamadas: se recarga a un ritmo de 100 llamadas por hora. En el nivel de esfuerzo medio (medium), /code-review también señala las desviaciones de las convenciones de CLAUDE.md en Opus 5.5 y Sonnet 5.5. En Slack, Claude Tag incorpora un modo rápido (!fast), una llamada browser_batch de Claude in Chrome dispone de 90 segundos en lugar de 60, y WebFetch ya no recorta silenciosamente el texto que supera los 100 000 caracteres. pyright y más formas de ps solicitan permiso, y se corrigen varias vulnerabilidades de permisos: comodines de rg y git grep expandidos por el shell, archivos CLAUDE.md enlazados fuera de los directorios de trabajo y un mod de la organización eludido por un mod de usuario. Cuatro horas después, la 2.1.291 corrige dos regresiones, una aparecida con la 2.1.290 (respuestas a las solicitudes de permiso perdidas en las sesiones cloud) y otra con la 2.1.288 (los últimos mensajes de una sesión perdidos al salir).
El 6 de octubre a las 18 h 59 UTC, la 2.1.292 (92 entradas, de las cuales 64 son correcciones) añade un parámetro effort a la herramienta Agent, para iniciar un subagente con el nivel de esfuerzo solicitado, y claude plugin install --marketplace, que añade el mercado (marketplace) si es necesario y luego instala el plugin. Los servidores MCP locales (stdio) ahora negocian por defecto el protocolo 2026-07-28 (MCP_PROTOCOL_NEGOTIATION=legacy para volver al anterior), CLAUDE_CODE_OVERLOADED_RETRY_BASE_DELAY_MS prolonga los reintentos ante errores 529, y los mods incorporan un evento de autocompletado del prompt y el cache de prompt. En cuanto a seguridad, las aprobaciones de un hook PreToolUse y el modo auto ya no eluden la solicitud de permiso para leer rutas de red (UNC), y las etiquetas <system-reminder> escritas por un hook se escapan antes de llegar a Claude. La herramienta Artifact por fin enumera 200 artefactos en lugar de 50, y Code Review desglosa sus estadísticas por repositorio. Ni la 2.1.290 ni la 2.1.292 se han anunciado en X.
| Versión de Claude Code | Fecha de publicación (UTC) | Número de entradas | Novedad principal |
|---|---|---|---|
| 2.1.290 | 5 de octubre, 23 h 33 | 190, de las cuales 131 son correcciones | Sesiones identificadas por su nombre, managed-agents-onboard, presupuesto de WebSearch recargado |
| 2.1.291 | 6 de octubre, 3 h 55 | 2 correcciones | Dos regresiones corregidas |
| 2.1.292 | 6 de octubre, 18 h 59 | 92, de las cuales 64 son correcciones | Esfuerzo de los subagentes, plugin y mercado en un solo comando, MCP 2026-07-28 |
🔗 Claude Code 2.1.290 🔗 Claude Code 2.1.291 🔗 Claude Code 2.1.292
La guía de las sesiones cloud de Claude Code
6 de octubre — Dos semanas después del lanzamiento de la versión preliminar de las sesiones cloud de Claude Code, Anthropic publica en claude.dev una guía práctica firmada por Addy Osmani. Cada tarea se ejecuta en una máquina virtual nueva con aproximadamente 4 vCPU, 16 Go de RAM y 30 Go de disco, con el repositorio clonado en una nueva rama, sin coste adicional de cómputo en los planes Pro, Max, Team y Enterprise. La guía describe siete usos: vaciar en paralelo una lista de tareas pendientes (backlog), comprobar una corrección mediante ejecuciones repetidas, planificar en local y luego retomar la sesión con claude --teleport, seguir el progreso desde el teléfono, encargar los fallos de CI y los comentarios de revisión a Auto-fix, activar rutinas y ejecutar código poco seguro en una VM desechable. En su demostración, las tres sesiones terminaron 87 segundos después del primer inicio, y un proyecto puede iniciar hasta 200 nuevos hilos (threads) al día. La guía también detalla la conexión con GitHub: identificarse con GitHub e instalar la aplicación Claude GitHub son dos permisos distintos, y solo el segundo da acceso a los repositorios privados. El crédito adicional de 100 dólares (Pro) o 250 dólares (Max) puede solicitarse antes del 7 de octubre a las 23 h 59 PT y caduca el 4 de noviembre.
🔗 Guía práctica de las sesiones cloud en claude.dev 🔗 El recordatorio de @ClaudeDevs sobre el crédito adicional
Vibe CLI 2.26.0
6 de octubre — Mistral publica Vibe CLI 2.26.0, su agente de código de línea de comandos, trece días después de la 2.25.8 y sin anuncio en X. Con 33 incorporaciones, 23 cambios y 91 correcciones, la actualización es considerable: 72 de sus 147 entradas corresponden a la nueva interfaz escrita en Rust: asistente de primer inicio, modo de voz (/voice), prompts recurrentes descritos en lenguaje natural con /loop, envío de la sesión a Vibe Code Web con /teleport y comando vibe update. Vibe ahora se ejecuta siempre sobre Unified Harness, su nuevo motor de ejecución, y se detiene con un error explícito si falta, en lugar de recurrir silenciosamente al motor anterior. Los plugins pueden incluir su propio servidor MCP, la clave API de respaldo almacenada en ~/.vibe/.env ahora solo puede ser leída por su propietario, y la Rust CLI ahora transmite su telemetría de uso (tiempo de inicio, comandos utilizados, terminal detectado) a Mistral.
🔗 Notas de la versión de Mistral Vibe v2.26.0
La extensión Antigravity para VS Code 1.7.0
5 de octubre — Google publica la versión 1.7.0 de la extensión Antigravity para Visual Studio Code, que incorpora los agentes de Google Antigravity al editor de Microsoft (conversación en un panel lateral, revisión de diffs en línea, planes interactivos), a partir de VS Code 1.90. Actualizada aproximadamente cada semana desde principios de septiembre según su changelog, nunca se había cubierto aquí. Esta 1.7.0 (6 mejoras, 9 correcciones) mejora la revisión de código: las decisiones Accept y Reject se deshacen y rehacen con el teclado, el editor de diff en paralelo incorpora botones Accept All y Reject All, y el guardado automático (Auto Save) de VS Code ya no puede sobrescribir ni cerrar una revisión en curso. En Windows, las notificaciones nativas indican que una tarea ha terminado cuando la ventana no está en primer plano, y tanto Google Cloud Workstations como Cloud Shell reciben autenticación interactiva. El mismo día, la extensión para Visual Studio pasa a la 1.0.261005.0 y adjunta registros de diagnóstico a los comentarios enviados.
🔗 Changelog de Google Antigravity
Replit y el contexto de todos los proyectos
6 de octubre — Replit anuncia que ahora dispone del contexto de todos los proyectos de un usuario. Desde una nueva conversación, se le puede pedir que encuentre un proyecto existente, que le añada una funcionalidad o que use un proyecto como referencia para otro; Replit lee entonces los archivos correspondientes e inicia las modificaciones como tareas en segundo plano (background tasks), con enlaces para revisar los cambios. El ejemplo elegido va más allá del código puro: aplicar la paleta de colores de un «Partner Marketing Hub» a otros dos proyectos de una marca de café. El anuncio se limita a un tweet acompañado de un vídeo, sin artículo, documentación ni precios.
Las pull requests apiladas de GitHub pasan a disponibilidad general
6 de octubre — GitHub pone las pull requests apiladas (stacked pull requests) a disposición de todos los planes de github.com, tras estar en versión preliminar pública desde el 30 de julio: un cambio grande se divide en pull requests más pequeñas, que se revisan por separado y luego se fusionan juntas. GitHub Enterprise Server las recibirá en una próxima versión. Según GitHub, los repositorios que usan pilas fusionan un 9 % más de código que repositorios comparables, y más de dos tercios del 1 % de los repositorios más destacados las utilizan, con una mejora del 5 % en el tiempo hasta la fusión.
La versión final reduce las fricciones de la fusión. Cuando la rama principal avanza, «Rebase stack» conserva las aprobaciones del código que no ha cambiado y produce commits de reemplazo firmados; una pila atraviesa la cola de fusión (merge queue) como un único grupo, y una pila cuya rama base se elimina se redirige a otra rama en lugar de cerrarse. La fusión automática de una pila completa llegará «en las próximas semanas». Para el uso desde la línea de comandos y los agentes, la extensión gh stack de GitHub CLI admite worktrees de Git.
🔗 Changelog de GitHub sobre las pull requests apiladas
Modelos multilingües: Tiny Aya L2-Thinker de Cohere y Falcon-OCR-Arabic de TII
Dos modelos pequeños se centran en idiomas que los grandes modelos atienden peor: uno razona en el idioma del usuario y el otro lee documentos en árabe.
Tiny Aya L2-Thinker de Cohere
6 de octubre — Cohere aborda el idioma en el que razonan los modelos: cuando se les pregunta en español, árabe o suajili, la mayoría piensa en inglés antes de responder. Su modelo de investigación Tiny Aya L2-Thinker (3,35 mil millones de parámetros) razona en el idioma del prompt más del 93 % del tiempo, en 60 idiomas. La clave está en la mezcla de datos: unos 1,7 millones de ejemplos de razonamiento en inglés, generados por gpt-oss-120b, solo hacen que razone en el idioma del usuario el 12,8 % del tiempo; unos 5 000 ejemplos traducidos por idioma, en 44 idiomas, elevan esta tasa al 86,1 %, y los datos multilingües sin razonamiento extienden este comportamiento a otros idiomas. Frente a su gemelo que razona en inglés, la precisión disminuye como máximo entre dos y tres puntos en cinco de los seis benchmarks; solo PolyMath, de matemáticas de competición, registra una caída más pronunciada, por la ausencia de una etapa de aprendizaje por refuerzo. El modelo consume menos de 5 000 tokens de razonamiento de media. Los modelos y los datos se publican en Hugging Face bajo la licencia no comercial CC-BY-NC 4.0; el artículo presenta un trabajo de arXiv del 9 de septiembre.
🔗 Artículo de investigación de Cohere sobre Tiny Aya L2-Thinker
Falcon-OCR-Arabic de TII
6 de octubre — TII, el instituto emiratí que desarrolla los modelos Falcon, presenta en el blog de Hugging Face Falcon-OCR-Arabic, una versión árabe de su modelo de reconocimiento de texto Falcon OCR. Conserva sus 270 millones de parámetros y su arquitectura de fusión temprana, y se ha adaptado mediante un ajuste supervisado con documentos árabes reales y sintéticos, seguido de aprendizaje por refuerzo. En un banco de pruebas creado por el propio TII (11 974 documentos reales, 15 categorías), queda segundo entre los 17 modelos comparados y primero en documentos oficiales, formularios administrativos, recibos y facturas.
| Modelo evaluado por TII | Precisión del texto | Puntuación Table TEDS |
|---|---|---|
| Gemini 3.5 Flash | 84,34 % | 51,30 % |
| Falcon-OCR-Arabic (270M) | 81,87 % | 59,95 % |
| Claude Opus 5.5 | 79,22 % | 43,98 % |
| GPT Astra | 75,02 % | 51,23 % |
| Chandra OCR 2 (mejor OCR especializado) | 61,67 % | 32,63 % |
El artículo solo ofrece un espacio de prueba (playground): no había pesos de Falcon-OCR-Arabic en el Hub cuando lo consultamos, y no se menciona ninguna licencia.
🔗 El artículo de TII sobre Falcon-OCR-Arabic
Bibliotecas de Hugging Face: Diffusers 0.41.0 integra Qwen-Image 2.1, Transformers v5.19.0 incorpora EmbeddingGemma 2
Las dos grandes bibliotecas de modelos de Hugging Face publican una versión el mismo día.
Diffusers 0.41.0 y Qwen-Image 2.1
6 de octubre — Diffusers 0.41.0, la biblioteca de Hugging Face para modelos de difusión, integra Qwen-Image 2.1, el modelo de Alibaba que reúne generación y edición de imágenes: ahora puede utilizarse directamente para generar, editar, producir imágenes con fondo transparente (salida RGBA nativa) y entrenar LoRA, con un componente de generación visual de 7 mil millones de parámetros. El equipo también cambia de ritmo: como Transformers, Diffusers ajustará sus versiones menores a la llegada de nuevos modelos, mientras que las versiones de corrección seguirán reservadas a las correcciones. La carga con paralelismo tensorial permite que cada GPU lea únicamente su parte de los pesos, y la versión añade los pipelines LTX-2.5 DFR y optimizaciones para Cosmos 3. Como contrapartida, el soporte de ONNX queda obsoleto en favor de Optimum.
🔗 Notas de la versión de Diffusers 0.41.0
Transformers v5.19.0
6 de octubre — Seis días después de la v5.18.0, Transformers v5.19.0 incorpora EmbeddingGemma 2, presentado más arriba, con sus vectores que pueden acortarse y sus codificadores de visión y audio que pueden desactivarse al cargarlo. En cuanto al entrenamiento distribuido, el paralelismo de expertos incorpora una distribución de tokens (token dispatch), activada por defecto para Qwen3 MoE y Mellum: su tamaño ya no tiene que ser igual al del paralelismo tensorial, y el Trainer funciona con este modo. El cache ahora se configura capa por capa, algo útil para los modelos heterogéneos, y el procesamiento continuo por lotes (continuous batching) admite XPU. La versión incluye seis cambios que rompen la compatibilidad, entre ellos la devolución de los logits del enrutador para todos los MoE y la eliminación progresiva del prefijo paged|.
🔗 Notas de la versión de Transformers v5.19.0
Agentes de voz: ElevenLabs lanza ElevenAgents Architect en Alpha
6 de octubre — ElevenLabs integra en ElevenAgents, su plataforma de agentes conversacionales, un experto llamado Architect, que ayuda a los equipos a construir y mejorar sus agentes de voz o texto hablándole o escribiéndole. Conoce todos los ajustes de ElevenAgents (base de conocimientos, prompts, encadenamientos, voces, salvaguardas, herramientas, simulaciones) y cómo interactúan. Se le puede plantear una pregunta, una prueba fallida, un aumento de las transferencias a un humano o una observación de ElevenAgents Spotlight: analiza las transcripciones, identifica la causa, propone una modificación y escribe las simulaciones que la validan. También construye un agente a partir de una simple descripción. Cada cambio llega como un borrador versionado y reversible, y nada pasa a producción sin aprobación. Architect es accesible desde el producto, pero también desde Claude, Claude Code, ChatGPT, Cursor y Grok Bot. Ya está disponible en Alpha, sin precios ni cifras de resultados.
🔗 Artículo de ElevenLabs sobre ElevenAgents Architect
Vídeo generativo: FLUX 3 lidera Physics-IQ Verified según Black Forest Labs
6 de octubre — Black Forest Labs reivindica el primer puesto en Physics-IQ, el benchmark de Google DeepMind que mide la comprensión del mundo físico por parte de los modelos de vídeo: se muestra al modelo el inicio de un experimento real grabado y debe predecir su continuación (fluidos, óptica, mecánica de sólidos). La clasificación de referencia, Physics-IQ Verified, está a cargo de Anates Labs. En la modalidad de vídeo a vídeo, FLUX 3 [large] supera claramente a Cosmos3 de NVIDIA, con un coste por vídeo más elevado.
| Modelo y método (vídeo a vídeo) | Puntuación Physics-IQ Verified | Coste por vídeo normalizado |
|---|---|---|
| FLUX 3 [large], mejor de 8 generaciones | 64,35 % | 16,43 dólares |
| FLUX 3 [large] | 61,11 % | 2,08 dólares |
| Cosmos3 Super (NVIDIA) | 50,80 % | 0,82 dólar |
| Cosmos3 Nano (NVIDIA) | 43,00 % | 0,82 dólar |
En la modalidad de imagen a vídeo, FLUX 3 [large] también supera a Physis-Lang, el método que NVIDIA situaba en cabeza el 29 de septiembre. FLUX 3 [large] es un modelo propietario, y el hilo no ofrece ni fecha de disponibilidad ni precio para esta variante.
🔗 El hilo de @bfl_ai en X 🔗 Clasificación Physics-IQ Verified
Evaluaciones públicas: GeoGuess Bench y RSI Arena
Dos evaluaciones abiertas al público se apartan de los benchmarks habituales: una hace que los modelos jueguen a GeoGuessr y la otra permite al público votar sobre modelos entrenados por agentes.
GeoGuess Bench
6 de octubre — Hassan, responsable de la experiencia de desarrollador en Together AI, publica GeoGuess Bench, un banco de pruebas personal que hace que los modelos jueguen a GeoGuessr: cada uno ve las mismas 210 fotos de calles y coloca un marcador que se puntúa según la fórmula del juego, hasta 25 000 puntos por partida de cinco rondas. Claude Opus 5.5 se sitúa en cabeza, justo por delante de Claude Fable 5.1; la sorpresa la da Muse Glimmer 30B, el modelo de pesos abiertos de Meta, tercero y por delante de GPT-6 Astra, con un coste por partida unas 45 veces menor.
| Puesto en GeoGuess Bench | Modelo evaluado | Puntuación sobre 25 000 | Coste por partida |
|---|---|---|---|
| 1 | Claude Opus 5.5 | 23 412 | 0,064 dólar |
| 2 | Claude Fable 5.1 | 23 307 | 0,115 dólar |
| 3 | Muse Glimmer 30B (abierto) | 22 407 | 0,0049 dólar |
| 4 | GPT-6 Astra | 21 562 | 0,223 dólar |
| 5 | GPT-6.1 Sol | 21 194 | 0,042 dólar |
| 6 | GLM-5.3 Flash (abierto) | 21 183 | 0,0087 dólar |
GLM-5.3 Flash rinde así al mismo nivel que GPT-6.1 Sol con un coste unas cinco veces menor. Se trata del proyecto personal de un empleado de Together AI, proveedor de inferencia de modelos abiertos, y no de una evaluación de la empresa; no aparece ningún modelo Gemini y el código está publicado en GitHub.
🔗 El anuncio de Hassan en X 🔗 GeoGuess Bench
RSI Arena
6 de octubre — Zichen Chen anuncia una nueva ronda de RSI Arena (por automejora recursiva, recursive self-improvement), esta vez con Hugging Face. Los agentes de IA recibieron GPU y una única misión, entrenar mejores modelos: eligieron ellos mismos los datos, escribieron el código y realizaron los experimentos. Una vez terminada la primera ronda de entrenamiento, el público entra en el ciclo: los modelos se enfrentan en duelos, cada persona vota y los agentes utilizan estos comentarios para nuevos experimentos. Los Inference Endpoints de Hugging Face ofrecen acceso a cada modelo en tiempo real, y el sitio enumera diez agentes, entre ellos GPT-6 Astra, Grok 4.7, DeepSeek V4.1 Flash, GLM-5.3 y Muse Spark 1.3; su panel de control mostraba 286,60 dólares de gastos de API de un total de 300 y 755,17 horas GPU de 1 000. El equipo promete publicar en el Hub cada modelo entrenado por los agentes y, al final del experimento, todos los artefactos: datos, código y trayectoria de investigación completa de cada agente.
🔗 El anuncio de Zichen Chen en X 🔗 RSI Arena
Infraestructura GPU: NVIDIA publica AICR v1.0
6 de octubre — NVIDIA publica la versión 1.0 de AI Cluster Runtime (AICR), un proyecto abierto que pretende acabar con los clústeres de GPU de Kubernetes configurados por ensayo y error. Un clúster acelerado depende de decenas de componentes con versiones independientes (núcleo, controladores, entornos de contenedores, red, almacenamiento, operadores, bibliotecas), y una combinación que funciona en un lugar puede fallar silenciosamente en otro. AICR responde con recetas validadas y con versiones fijadas, generadas para Helm, Argo CD, Flux o Helmfile y acompañadas de pruebas de validación firmadas sobre el hardware probado. La v1.0 establece un contrato de compatibilidad: la CLI, la API REST, el SDK Go, la estructura de los paquetes de despliegue y los esquemas de artefactos se convierten en interfaces estables, y cualquier cambio incompatible exigirá una nueva versión mayor. NVIDIA afirma contar con más de 100 colaboradores, de los cuales casi la mitad son externos a la empresa, y cita integraciones en Pulumi Labs y en el gestor multiclúster k0rdent de Mirantis.
🔗 Artículo del blog técnico de NVIDIA
Claude Startups: hasta 7 000 dólares en productos y créditos, y una Startup Stack de 45 000 dólares
6 de octubre — Anthropic amplía el acceso a Claude Startups, su programa para fundadores que desarrollan sobre Claude, a empresas emergentes fundadas hace menos de cinco años o financiadas durante los dos últimos años.
| Ventaja del programa | Valor anunciado por Anthropic |
|---|---|
| Un año de Claude Team, hasta cinco licencias Premium | 6 000 dólares (cinco licencias a 100 dólares al mes) |
| Crédito API único, disponible desde la aprobación | 1 000 dólares |
| Total de productos y créditos Claude | hasta 7 000 dólares |
| Claude Startup Stack (ofertas de socios) | hasta 45 000 dólares |
El año de Claude Team se aplica a empresas nuevas en Team, y su valor real depende del número y el tipo de licencias. Claude Startup Stack, la novedad del día, reúne descuentos y créditos de empresas que desarrollan con Claude, entre ellas Linear, Lovable, ElevenLabs, Granola y Hex; su límite corresponde al valor acumulado de todas las ofertas a los precios de catálogo de septiembre de 2026, y estas ofertas no son todas acumulables. El programa añade sesiones de intercambio con el equipo Applied AI de Anthropic, ayuda para publicar una ficha en Claude Marketplace y acceso a eventos.
🔗 Artículo de Anthropic sobre Claude Startups 🔗 El hilo de @claudeai sobre Claude Startup Stack
Breves
- Claude Projects y carpeta local — Dan Fein, de Anthropic, anuncia que las sesiones cloud de Claude Projects pueden conectarse a una carpeta autorizada del ordenador, a la que solo acceden cuando una tarea lo necesita; el despliegue es progresivo desde el 5 de octubre, y el equipo ya casi lo ha conseguido (Ya casi), según Boris Cherny. 🔗 fuente · 🔗 Boris Cherny
- Claude en los mensajes de grupo de Slack — Claude ya puede añadirse a los mensajes de grupo (group DMs) de Slack como cualquier participante; responde en un hilo que sigue atendiendo y puede usar los conectores personales de quien le hace la petición, sin detalles sobre los planes ni el calendario. 🔗 fuente
- Boris Cherny y su forma de crear prompts — Boris Cherny encarga a Opus 5.5 la creación de un sitio complementario interactivo de un episodio del podcast Acquired dedicado a Home Depot, acuarelas incluidas; según él, no hay ningún secreto para crear prompts: decir al modelo qué se quiere, cuánto esfuerzo dedicarle y cómo verificar el resultado. 🔗 sitio complementario · 🔗 su forma de crear prompts
- Atlassian y OpenAI — En virtud de un nuevo acuerdo, los modelos de frontera de la familia GPT-6, entre ellos GPT-6 Astra, impulsarán los agentes de la plataforma de Atlassian y de Rovo; más de 3 000 desarrolladores de Atlassian ya utilizan Codex y se estudian integraciones más avanzadas con Jira, sin que se haya comunicado el importe. 🔗 fuente
- Widgets de Codex en ChatGPT para iOS — La versión 1.2026.267 de ChatGPT para iOS, del 2 de octubre, añade widgets para la pantalla de inicio con las tareas recientes de Codex de los ordenadores seleccionados, otros para la cuota de uso restante y su restablecimiento, también en la pantalla de bloqueo, y un ajuste que mantiene abierto el teclado. 🔗 fuente
- Gemini CLI v0.63.0 y v0.64.0-preview.0 — La versión estable v0.63.0 reproduce sin cambios las 15 entradas de la versión preliminar del 29 de septiembre, y la versión preliminar v0.64.0-preview.0 agrupa las 16 entradas de las versiones nocturnas del 30 de septiembre al 3 de octubre: no hay contenido inédito, y la versión nocturna del 6 de octubre está vacía. 🔗 fuente
- SDK Python de Mistral 3.1.0 — Generada automáticamente a partir de la API, esta versión añade en beta catorce operaciones de evaluación en el módulo de observabilidad; los métodos
Runspasan aWorkflows.runs, lo que puede romper código existente pese a un simple cambio de versión menor. 🔗 fuente - Qwen Code v0.25.1-preview.0 — Al día siguiente de la v0.25.0, esta versión preliminar incorpora 13 funciones y 27 correcciones, entre ellas un entorno de ejecución Kubernetes experimental, comandos Shell y supervisión en segundo plano para Managed Agent, y reglas MCP que ya no autorizan un servidor con el mismo nombre. 🔗 fuente
- SDK TypeScript de SpaceXAI 0.2.2 — Publicada el 5 de octubre sin anuncio, esta versión solo contiene un cambio: la opción
retryBeforeOutputtambién se aplica a una llamadacreate()sin transmisión continua (streaming) que espera JSON. 🔗 fuente - Falcon-Emirati-7B, el dialecto emiratí — TII especializa Falcon-H1-Arabic 7B en árabe emiratí: 84,83 % en Alyah, un banco de pruebas de 1 173 preguntas, y una fidelidad al dialecto de 0,52 frente a 0,05 como máximo para ALLaM, Gemma 3 27B, Jais-2 y Fanar-2, según un juez Gemini 3.7 Flash; el modelo solo se ofrece en la plataforma de chat de TII. 🔗 fuente
- Datasets 5.1.0 — Publicada el 5 de octubre, la biblioteca de conjuntos de datos ahora lee los entornos de aprendizaje por refuerzo Harbor, el formato columnar Vortex y cinco formatos biológicos (FASTA, FASTQ, GenBank, PDB, mmCIF), y corrige una vulnerabilidad que permitía a un archivo comprimido escribir en un directorio vecino. 🔗 fuente
- TRL v1.14.2 — Este parche corrige un error que alteraba el entrenamiento sin avisar: sin vLLM, GRPO, RLOO y Distillation no se detenían al final del turno para modelos como Gemma o Phi-3.5 y aprendían todo el texto posterior hasta la longitud máxima; también se corrigen tres cierres inesperados. 🔗 fuente
- Jev contra los correos de campaña — En un artículo de la comunidad, Stephen Solka clasifica sus correos políticos con Jev (99 respuestas correctas sobre 100 correos reales, un falso positivo), y luego con un clasificador SetFit de 22,6 millones de parámetros que funciona en CPU: 98 % en la evaluación piloto, pero 18 de 23 en casos difíciles. 🔗 fuente
- Open Together el 16 de octubre — vLLM y Hugging Face organizan Open Together, un encuentro de desarrolladores open source que abrirá Open Source AI Week el viernes 16 de octubre en San Francisco; según Jeff Boudier, hay 150 personas en la lista de espera y la capacidad se ha duplicado. 🔗 fuente · 🔗 Jeff Boudier
- Copilot CLI 1.0.93-2 — Esta versión preliminar añade un ajuste empresarial,
permissions.limitTo, que restringe las solicitudes de red a dominios gestionados, destaca GPT-6.1 Sol, GPT-6 Astra y Luna y los modelos Claude 5.5 en el selector, y ya solo lee los ajustes de usuario en~/.copilot/settings.json. 🔗 fuente - AI Scan en la vista general de seguridad — Los administradores de organizaciones y empresas ahora ven, en la vista general de seguridad (security overview) de GitHub, qué repositorios han activado el análisis por IA de pull requests (AI Scan for pull requests), con dos filtros y una columna en la exportación CSV. 🔗 fuente
- Detección de secretos: Lovable, Pydantic y Supabase — La detección de secretos (secret scanning) de GitHub reconoce cinco nuevos tipos de secretos, entre ellos la clave de API de Lovable, el token Logfire y la clave de Pydantic AI Gateway, así como dos tokens Supabase; Lovable Labs también se incorpora a su programa de colaboración. 🔗 fuente
- Notas de la versión de Devin del 5 de octubre — Sobre todo, retoques: una pestaña Terminal en el espacio de trabajo de la sesión (abrir Files o Terminal despierta a Devin), niveles de esfuerzo para Devin Review ajustables mediante las acciones de activación, y análisis de código (code scans) recuperables por identificador a través de la API v3 o del MCP de Devin. 🔗 fuente
- Delta y sus propios worktrees — En el blog de Delta, Conrad Irwin explica por qué la herramienta sustituye los worktrees de Git: cada hilo tiene su worktree registrado en DeltaDB y replicado entre personas, agentes y máquinas, varios agentes trabajan en la misma rama y un script
.agents/prepareversionado prepara cada checkout; artículo sin nueva versión. 🔗 fuente - v0: cuentas personales en espacios de equipo — Las cuentas personales de v0 se convierten en espacios de trabajo de equipo, con conversaciones, proyectos y ajustes migrados automáticamente; la documentación reserva, sin embargo, ciertas funciones, como las plantillas de equipo, a los planes Plus, Business y Enterprise. 🔗 fuente
- v0 y la suscripción a ChatGPT en iOS — La suscripción a ChatGPT, aceptada por v0 desde el 29 de septiembre, ya puede usarse en su aplicación iOS, sin precio ni detalles adicionales. 🔗 fuente
- Eleven v4 y Eleven v4 Turbo en cabeza — ElevenLabs anuncia que sus dos modelos de síntesis de voz lanzados el 28 de septiembre ocupan los dos primeros puestos de la clasificación de síntesis de voz (text to speech) de Artificial Analysis; v4 ya ocupaba el primer puesto en el lanzamiento. 🔗 fuente
- HeyGen Video en 2K — Una semana después de su lanzamiento, HeyGen Video pasa a resolución 2K; HeyGen afirma que ocupa el primer puesto de la clasificación de vídeo de OpenRouter por uso, sin una tarifa específica para 2K, mientras que la página del catálogo sigue mostrando 0,01 dólar por segundo hasta finales de octubre. 🔗 fuente
- Nano Banana 2.1 en Pika — Pika añade a su plataforma y a su Pika API Club Nano Banana 2.1, la nueva versión del modelo Nano Banana de Google, con una mejor calidad visual y más velocidad, según Pika; no se indica ninguna tarifa ni coste en créditos. 🔗 fuente
- DOCA GPUNetIO — NVIDIA convierte DOCA GPUNetIO en la implementación común de la red controlada por la GPU (GDA-KI) para NCCL, NVSHMEM y NIXL/UCX, en una versión completa dentro del SDK DOCA y en un proyecto open source más ligero, centrado en RDMA Verbs. 🔗 fuente
- Green contexts de CUDA — Un artículo técnico de NVIDIA muestra cómo reservar SM para una tarea crítica: en una GPU Blackwell de 148 SM, un kernel con 8 SM reservados responde en 0,007 ms, frente a 0,140 ms con un flujo (stream) prioritario y 3,727 ms sin prioridad. 🔗 fuente
- Modelos abiertos en los operadores de telecomunicaciones — En un artículo de posicionamiento, NVIDIA cita su encuesta de telecomunicaciones de 2026, en la que el 89 % de los encuestados considera importante el open source, y los testimonios de SoftBank, AT&T e Indosat; ningún producto nuevo. 🔗 fuente
- Guía de Perplexity sobre herramientas de colaboración — Perplexity compara diez herramientas de colaboración con IA (Slack, Loom, Confluence, Airtable, Notion, ClickUp, Asana, Monday.com, Trello, Miro), sus funciones de IA y los planes que las incluyen; ninguna novedad de producto. 🔗 fuente
Qué significa
Los modelos de decisión se convierten en una categoría por derecho propio, con su guerra de precios y su clasificación. El mismo día, OpenAI fija el precio de su API Decisions en 0,10 dólares por millón de tokens de entrada, y Perplexity reduce el suyo a 0,02 dólares, la mitad que hace cinco días; ninguno de los dos cobra por la salida. Estos modelos no redactan, eligen o puntúan: se les paga por la lectura y se busca que sean rápidos, y OpenAI promete respuestas aproximadamente diez veces más rápidas que con su Responses API. El Decision Index 0.3 sirve de árbitro comunitario, y su nueva mitad privada pretende medir capacidades en lugar del éxito en benchmarks conocidos. Su veredicto ya influye en la comunicación de los proveedores: Perplexity lo cita en su anuncio, aunque la ficha de su modelo ofrece una puntuación distinta de la que aparece en la clasificación.
La IA se instala en las herramientas de oficina en lugar de que ocurra lo contrario. Claude llega a Google Docs, Sheets y Slides después de Excel, PowerPoint y Word, se incorpora a los mensajes de grupo de Slack, y los modelos GPT-6 impulsarán los agentes de Rovo en Atlassian. En estas integraciones, la cuestión ya no es solo la calidad del modelo, sino el control: un modo que exige aprobar cada modificación, conectores que respetan los permisos de uso compartido de Google y controles Enterprise aplicados al módulo. La misma lógica recorre las herramientas de agentes del día, desde las decisiones de revisión que pueden anularse en Antigravity hasta los borradores con control de versiones de ElevenAgents Architect.
En ciberseguridad, el acceso se concede por niveles según la verificación. El CVP de Anthropic no cambia el modelo, sino sus salvaguardas: en CyScenarioBench, el mismo Opus 5.5 pasa de tareas bloqueadas desde el primer prompt sin verificación a 34 tareas completadas de 50 en Red Team Access. Mistral plantea otro argumento, el de un modelo que no se niega: afirma alcanzar un 82 % en una prueba de ciberseguridad que Claude Opus 5.5 y GPT-6 Astra, según Mistral, se niegan a realizar. Los dos enfoques coinciden en un punto: el acceso más amplio a las capacidades de ciberseguridad pasa primero por profesionales verificados, socios de Mistral antes de la publicación de los pesos o miembros del programa de Anthropic.
Los modelos también se expanden hacia ambos extremos de tamaño. En el extremo superior, Mistral Large 4 y sus 1 000 mil millones de parámetros, cuyos pesos se han prometido para finales de octubre; en el inferior, EmbeddingGemma 2, que cabe en unos 567 Mo de RAM en un teléfono, Tiny Aya L2-Thinker y sus 3,35 mil millones de parámetros, o Falcon-OCR-Arabic y sus 270 millones, por ahora solo en demostración. Sin embargo, muchas de las cifras del día las mide el propio proveedor: las puntuaciones de Mistral, el primer puesto que reivindica Black Forest Labs, el benchmark interno de TII, la ficha de Perplexity, las tareas de Ironclad puntuadas por OpenAI o las mejoras en las fusiones anunciadas por GitHub. A menudo es la única medición disponible el día de un anuncio; convendrá contrastarla con evaluaciones independientes, algo que precisamente permitirán los pesos de Mistral Large 4 una vez publicados.
Fuentes
- Artículo de Mistral sobre Mistral Large 4
- Ficha de Mistral Large 4 en la documentación
- Artículo de Anthropic sobre Claude for Google Workspace
- @claudeai en X, Claude for Google Workspace
- Artículo de Anthropic sobre el Cyber Verification Program
- Página de ayuda del Cyber Verification Program
- Comcast y Booz Allen con Claude Mythos
- EmbeddingGemma 2 en el blog de Google
- Ficha del modelo EmbeddingGemma 2
- @GoogleDeepMind en X, EmbeddingGemma 2
- EmbeddingGemma 2 en Hugging Face
- Guía de la API Decisions de OpenAI
- Changelog de la API de OpenAI
- @perplexitydevs en X, pplx-decider-v1.1-27b
- pplx-decider-v1.1-27b en Hugging Face
- @multimodalart en X, Decision Index 0.3
- El Decision Index 0.3
- Artículo de OpenAI sobre su colaboración con Ironclad
- @OpenAIDevs en X, niveles de uso
- Documentación de los límites de tasa de la API de OpenAI
- Artículo de ayuda de OpenAI sobre el BAA de la API
- Changelog de la API de Perplexity
- Documentación de la herramienta image_search de Perplexity
- Ficha de GLM 5.3 en Amazon Bedrock
- @Zai_org en X, GLM-5.3 en Bedrock
- Claude Code 2.1.290
- Claude Code 2.1.291
- Claude Code 2.1.292
- Guía práctica de las sesiones cloud en claude.dev
- @ClaudeDevs en X, crédito adicional de las sesiones cloud
- Notas de la versión de Mistral Vibe v2.26.0
- Changelog de Google Antigravity
- @Replit en X, contexto de todos los proyectos
- Changelog de GitHub sobre las pull requests apiladas
- Artículo de investigación de Cohere sobre Tiny Aya L2-Thinker
- El artículo de TII sobre Falcon-OCR-Arabic
- Notas de la versión de Diffusers 0.41.0
- Notas de la versión de Transformers v5.19.0
- Artículo de ElevenLabs sobre ElevenAgents Architect
- @bfl_ai en X, FLUX 3 y Physics-IQ
- Clasificación de Physics-IQ Verified
- @nutlope en X, GeoGuess Bench
- GeoGuess Bench
- @my_cat_can_code en X, RSI Arena
- RSI Arena
- AICR v1.0 en el blog técnico de NVIDIA
- Artículo de Anthropic sobre Claude Startups
- @claudeai en X, Claude Startup Stack
- Dan Fein en X, Claude Projects y carpeta local
- Boris Cherny en X, despliegue progresivo de Claude Projects
- Dan Fein en X, Claude en los mensajes de grupo de Slack
- Boris Cherny en X, sitio complementario de Acquired
- Boris Cherny en X, su forma de escribir prompts para Claude
- Atlassian y OpenAI amplían su colaboración
- Changelog de ChatGPT y Codex, ChatGPT para iOS 1.2026.267
- Gemini CLI v0.63.0
- SDK de Python de Mistral v3.1.0
- Qwen Code v0.25.1-preview.0
- SDK de TypeScript de SpaceXAI v0.2.2
- El artículo de TII sobre Falcon-Emirati
- Datasets 5.1.0
- TRL v1.14.2
- El artículo de Stephen Solka
- @vllm_project en X, Open Together
- Jeff Boudier en X, lista de espera de Open Together
- Copilot CLI 1.0.93-2
- Changelog de GitHub sobre el estado de activación de AI Scan
- Changelog de GitHub sobre los nuevos detectores de secretos
- Notas de la versión de Devin del 5 de octubre
- Artículo de Conrad Irwin en el blog de Delta
- Changelog de v0, cuentas personales en espacios de equipo
- @v0 en X, suscripción a ChatGPT en iOS
- @ElevenLabs en X, Eleven v4 a la cabeza
- @HeyGenDev en X, HeyGen Video en 2K
- @pika_labs en X, Nano Banana 2.1 en Pika
- DOCA GPUNetIO en el blog técnico de NVIDIA
- Green contexts en el blog técnico de NVIDIA
- Modelos abiertos y operadores de telecomunicaciones, blog de NVIDIA
- Guía de Perplexity sobre herramientas de colaboración