ai-powered-markdown-translatorArtykuł przetłumaczony z fr na pl za pomocą gpt-6.1-sol.
Mistral udostępnia w wersji zapoznawczej Mistral Large 4, multimodalny model o 1 000 miliardach parametrów, którego API jest dostępne dla wszystkich już dziś, a wagi mają zostać opublikowane pod koniec października. Anthropic wprowadza Claude do Google Docs, Sheets i Slides oraz przebudowuje swój program weryfikacji w zakresie cyberbezpieczeństwa, tworząc trzy poziomy dostępu, a Google DeepMind publikuje EmbeddingGemma 2, otwarty, multimodalny model embeddingów, który mieści się na telefonie. Modele decyzyjne również mają swój dzień: OpenAI udostępnia API Decisions w publicznej wersji beta, Perplexity obniża swoją cenę o połowę, a ranking społeczności porównuje ich wyniki.
Mistral Large 4: 1 000 miliardów parametrów w wersji zapoznawczej, wagi zapowiedziane na koniec października
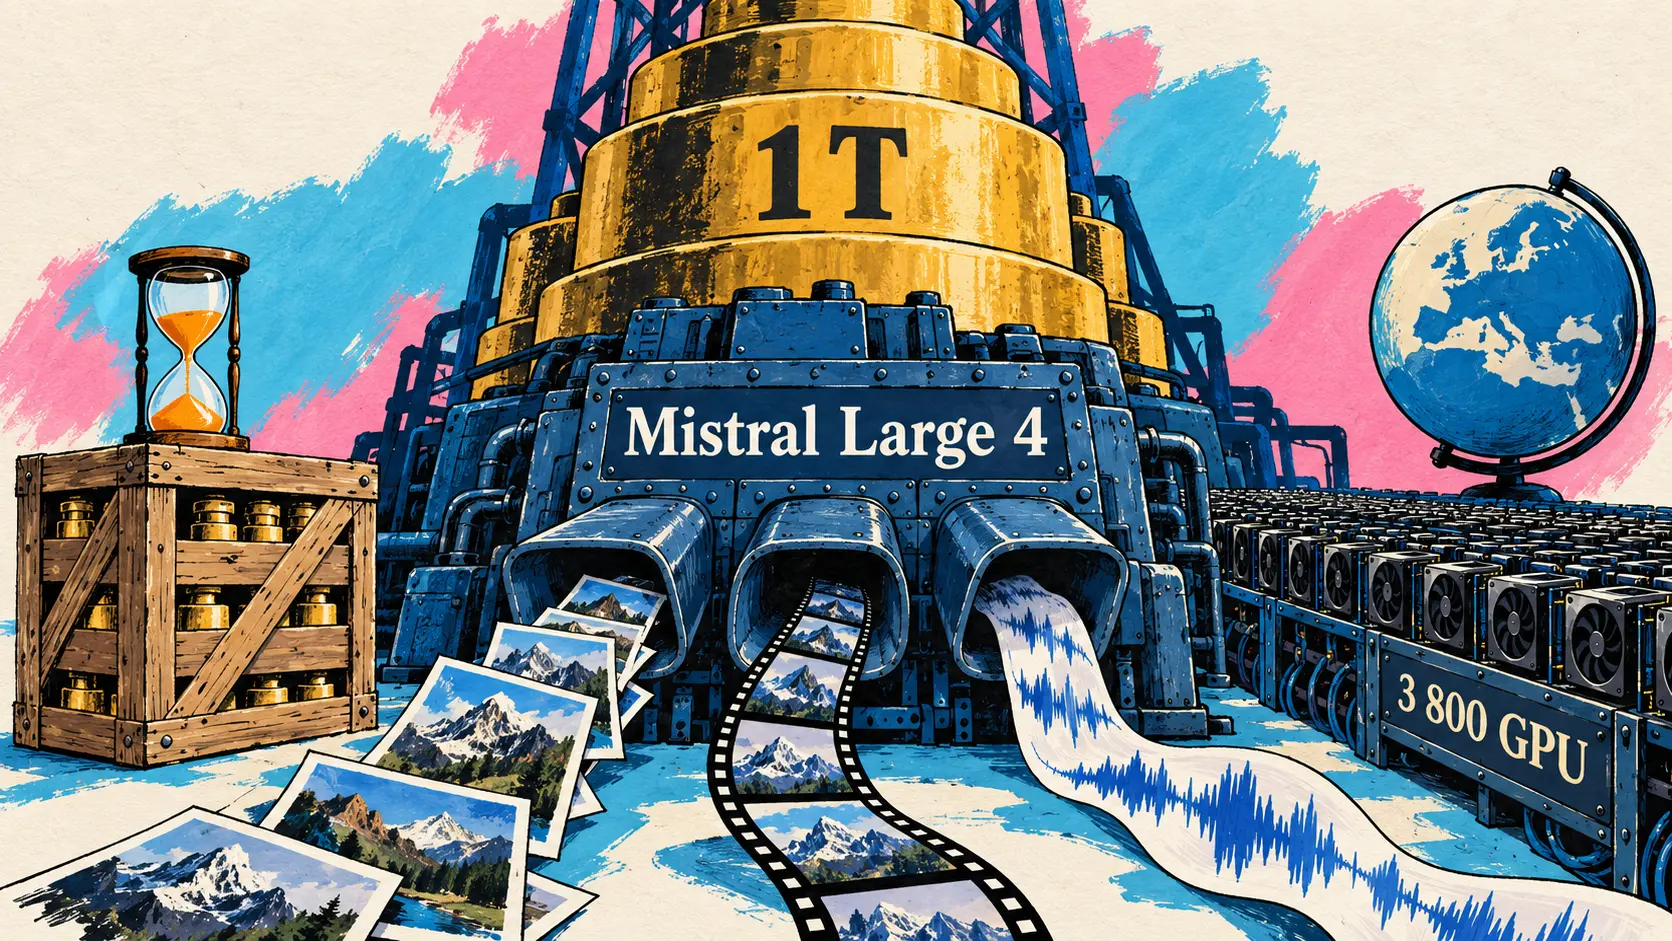
6 października — Mistral AI udostępnia publiczną wersję zapoznawczą Mistral Large 4, nazywanego ML4 oraz, « bardzo oficjalnie », Chonk. To największy dotychczasowy model firmy: natywnie multimodalna mieszanka ekspertów (Mixture-of-Experts) o 1 000 miliardach parametrów (1T), z których według wpisu zapowiadającego model 49 miliardów jest aktywnych. Łączy wykonywanie instrukcji, rozumowanie i możliwości agentowe w kontekście o długości miliona tokenów. Karta w dokumentacji podaje inne liczby, nie wyjaśniając rozbieżności: 1 050 miliardów parametrów, w tym 52 miliardy aktywnych, oraz enkoder wizyjny o 1,6 miliarda parametrów.
API jest dostępne dla wszystkich już dziś w Mistral Studio, ale wagi nie zostały jeszcze opublikowane: Mistral zapowiada ich udostępnienie do końca października wraz ze szczegółami architektury i treningu uzupełniającego. Tymczasem model jest testowany w rzeczywistych warunkach przez osoby odpowiedzialne za cyberbezpieczeństwo, zweryfikowanych partnerów i organy państwowe, które korzystają z niego przy ograniczonej moderacji. ML4 trenowano od zera na 3 800 GPU NVIDIA Grace Blackwell w europejskich centrach danych Mistral, które obsługują również wersję zapoznawczą. Firma planuje europejskie wdrożenie, którym będzie zarządzać od początku do końca i które będzie podlegać prawu europejskiemu. Przedstawia model jako pierwszy kamień milowy planu rozwoju finansowanego z rundy D o wartości 3 miliardów euro.
Cyberbezpieczeństwo jest głównym argumentem. Według Mistral ML4 znajduje się w pierwszej piątce modeli w Artificial Analysis Cyber Index i uzyskuje 82 % w jednym z jego testów, polegającym na odtworzeniu rzeczywistej luki w oprogramowaniu open source, a następnie jej naprawieniu. To najlepszy wynik spośród wszystkich modeli. Firma twierdzi, że Claude Opus 5.5 i GPT-6 Astra osiągają w tym samym teście wyniki bliskie zeru, ponieważ odmawiają wykonania zadania.
| Oceniany benchmark | Wynik podany przez Mistral | Porównanie przytoczone przez Mistral |
|---|---|---|
| DeepSWE v1.1 | 61,7 % | — |
| Coding Agent Index (łączny) | 49,8 % | przed DeepSeek V4 Pro 0813 i Qwen3.8 Max |
| Ocena przez ludzi w teście ślepym Surge AI (kod, w skali do 5) | 3,74, 2. miejsce na 5 | za Claude Opus 5 (4,22) |
| Cybench (40 wyzwań) | 93 % | — |
| AA Cyber Index, odtworzenie, a następnie naprawienie luki | 82 % | najlepszy wynik spośród wszystkich modeli |
| AutomationBench (657 procesów biznesowych) | 59,9 % | przed Kimi K3, MiMo-V2.6-Pro i DeepSeek V4 Pro |
Wpis i karta różnią się również ceną: karta we wpisie podaje 1,36 dolara za milion tokenów wejściowych i 4,18 dolara za milion tokenów wyjściowych, natomiast karta w dokumentacji przekreśla te stawki i obok podaje ceny o połowę niższe, bez informacji o okresie ich obowiązywania ani wyjaśnienia.
| Cecha ML4 | Według wpisu zapowiadającego model | Według karty w dokumentacji |
|---|---|---|
| Łączna liczba parametrów | 1 000 miliardów | 1 050 miliardów |
| Aktywne parametry | 49 miliardów | 52 miliardy |
| Dane wejściowe, za milion tokenów | 1,36 dolara | 0,68 dolara (1,36 przekreślone) |
| Dane wyjściowe, za milion tokenów | 4,18 dolara | 2,09 dolara (4,18 przekreślone) |
Wszystkie te wyniki pochodzą od Mistral, które zaznacza, że uczenie ze wzmocnieniem wersji zapoznawczej trwa nadal bez oznak nasycenia, i oczekuje szybkich postępów w nadchodzących tygodniach.
🔗 Wpis Mistral o Mistral Large 4 🔗 Karta Mistral Large 4 w dokumentacji
Claude for Google Workspace: Claude trafia do Docs, Sheets i Slides
6 października — Anthropic wprowadza Claude for Google Workspace, dodatek (add-on), który udostępnia Claude w panelu bocznym Google Docs, Sheets i Slides, w publicznej wersji beta we wszystkich płatnych planach. Claude odczytuje otwarty plik, widzi bieżące zaznaczenie (tekst, komórki lub slajdy) i edytuje plik bezpośrednio.
| Aplikacja Google | Co robi w niej Claude |
|---|---|
| Docs | Poprawki i zmiany stylu bezpośrednio w dokumencie, karty sugestii do zastosowania lub zignorowania przy bardziej rozległych przeróbkach tekstu |
| Sheets | Formuły, tabele przestawne, natywne wykresy, nowe karty, przetwarzanie zakresu przez Python w celu wykonania złączenia lub oczyszczenia danych |
| Slides | Slajdy tworzone na podstawie układów i motywu prezentacji, kontrola elementów, które nachodzą na siebie lub wychodzą poza obszar slajdu |
Użytkownik wybiera stopień autonomii: w domyślnie aktywnym trybie « pytaj przed edycją » (Ask before edits) każda zmiana przechodzi przez kartę zatwierdzenia; w trybie « akceptuj wszystkie zmiany » (Accept all edits) Claude wykonuje kolejne zmiany bez zatrzymywania się. Po połączeniu z kontem Claude panel korzysta z tych samych modeli, konektorów i umiejętności (skills). W planach Enterprise Compliance API, klucze szyfrowania zarządzane przez klienta (CMEK) i eksport danych audytowych OpenTelemetry obejmują również dodatek.
Claude now works inside Google Docs, Sheets, and Slides, and those files also open inside Claude. In Google Workspace, Claude sits in a sidebar next to your file, reads what you have open, and edits it in place. You can approve each edit before it lands.
🇵🇱 Claude działa teraz w Google Docs, Sheets i Slides, a pliki te otwierają się również w Claude. W Google Workspace Claude znajduje się w panelu bocznym obok Twojego pliku, odczytuje to, co masz otwarte, i edytuje plik bezpośrednio. Możesz zatwierdzić każdą zmianę, zanim zostanie zastosowana. — @claudeai na X
Jednocześnie pojawia się integracja w odwrotnym kierunku: nowe konektory Google Docs, Sheets i Slides, również w wersji beta, umożliwiają tworzenie i edytowanie plików Google z poziomu Claude po wklejeniu linku lub poproszeniu o nowy dokument. W obsługiwanych konfiguracjach plik otwiera się w panelu obok rozmowy, a dostęp Claude podlega uprawnieniom udostępniania Google. Dodatek instaluje się z Google Workspace Marketplace (Extensions > Claude > Open Claude), a administratorzy mogą go wdrożyć z konsoli Google Admin; w planach Team i Enterprise właściciel musi najpierw włączyć konektory. Google Workspace dołącza tym samym do Microsoft 365, gdzie Claude dla programów Excel, PowerPoint i Word jest ogólnie dostępny od 7 maja.
🔗 Wpis Anthropic o Claude for Google Workspace
Cyber Verification Program: Anthropic udostępnia Opus 5.5, Sonnet 5.5 i Mythos 5.1 na trzech poziomach dostępu
6 października — Anthropic przebudowuje swój program weryfikacji w zakresie cyberbezpieczeństwa (Cyber Verification Program, CVP), który udostępnia zweryfikowanym specjalistom ds. bezpieczeństwa możliwości blokowane w jego modelach dla szerokiego grona użytkowników. Przez sześć miesięcy współistniały dwa rozwiązania: Project Glasswing, dający dostęp do Claude Mythos organizacjom odpowiedzialnym za oprogramowanie o najbardziej krytycznym znaczeniu, oraz jednopoziomowy CVP, który łagodził zabezpieczenia modeli Opus i Sonnet. Łączą się one w trzy poziomy, z których każdy daje dostęp do Claude Opus 5.5, Claude Sonnet 5.5, Claude Mythos 5.1 oraz przyszłych modeli. Modele ogólnie dostępne (Opus 5.5, Fable 5.1, Sonnet 5.5) zachowują ostrożnie ustawione zabezpieczenia, które blokują większość prac z zakresu cyberbezpieczeństwa.
| Poziom dostępu | Obsługiwane zastosowania | Grupa docelowa i czas oczekiwania |
|---|---|---|
| Defense Access | Centrum operacji bezpieczeństwa, reagowanie na incydenty, inżynieria wsteczna złośliwego oprogramowania, analiza podatności | Zespoły bezpieczeństwa, infrastruktura krytyczna dowolnej wielkości, opiekunowie projektów open source, badacze; kilka dni |
| Red Team Access | Zastosowania obronne oraz autoryzowane testy penetracyjne i ćwiczenia symulowanych ataków (red teaming) | Wyłącznie organizacje, na systemach, które mają prawo testować; kilka tygodni |
| Specialized Access | Testowanie systemów bezpieczeństwa: lotnictwo, sieci elektroenergetyczne, telekomunikacja, przelewy międzybankowe, sieci administracji publicznej | Nieliczne organizacje oceniane indywidualnie wspólnie z rządem USA; przeniesieni członkowie Glasswing |
W Red Team Access działania mogące spowodować szkody fizyczne lub zakłócenia na masową skalę, takie jak uruchomienie ransomware, pozostają blokowane w czasie rzeczywistym. Aby sprawdzić swoje ustawienia, Anthropic przetestowało Opus 5.5 za pomocą CyScenarioBench, oceny wieloetapowych operacji w zakresie cyberbezpieczeństwa, z zabezpieczeniami każdego poziomu (10 wyzwań, po 5 prób).
| Konfiguracja testowana przez Anthropic (Opus 5.5) | Wynik w CyScenarioBench (50 prób) |
|---|---|
| Bez CVP | Wszystkie zadania zablokowane już przy pierwszym prompt |
| Defense Access | 46 prób zablokowanych na pewnym etapie, 4 zakończone powodzeniem |
| Red Team Access | Brak blokad, 34 zadania zakończone powodzeniem, co odpowiada wynikowi 67,6 % modelu bez zabezpieczeń |
Wpis przedstawia również pierwsze podsumowanie Glasswing, z danymi, które według Anthropic są częściowe: co najmniej 129 000 zweryfikowanych podatności wykrytych przez partnerów od kwietnia do lipca oraz 5 500 w analizach projektów open source prowadzonych przez Anthropic, z czego ponad 33 000 zaklasyfikowano jako krytyczne lub wysokiego ryzyka. Dane te opierają się na 33 raportach partnerów, a Anthropic ocenia, że rzeczywisty wpływ jest « co najmniej pięciokrotnie większy ». W relacji opublikowanej tego samego dnia Comcast informuje o wykryciu dzięki Claude Mythos Preview krytycznej luki w uwierzytelnianiu podczas oceny 258 systemów i około 170 milionów linii kodu, a analityk Booz Allen przejrzał 138 repozytoriów w dwanaście dni.
W praktyce program wymaga przechowywania danych w celu monitorowania nadużyć do czasu wdrożenia Enterprise Frontier Safeguards (EFS), które w dalszej części tej jesieni pozwoli przechowywać te dane w chmurze kontrolowanej przez klienta; organizacje korzystające już z Fable 5.1 lub Mythos 5.1 w trybie zerowej retencji mogą korzystać z CVP na tych samych zasadach. Program jest dostępny na Claude Platform, Vertex AI i Microsoft Foundry, a na Amazon Bedrock wyłącznie dla klientów kwalifikujących się do EFS. Indywidualne zgłoszenie jest możliwe tylko do Defense Access, w ramach płatnego planu, a na tym poziomie do 15 grudnia trzeba będzie wdrożyć uwierzytelnianie wieloskładnikowe odporne na phishing i zrezygnować z kluczy API. Webinar zaplanowano na 14 października o godz. 9 PT.
🔗 Wpis Anthropic o Cyber Verification Program 🔗 Strona pomocy Cyber Verification Program 🔗 Comcast i Booz Allen z Claude Mythos
EmbeddingGemma 2: otwarty model embeddingów Google staje się multimodalny
6 października — Google DeepMind publikuje EmbeddingGemma 2, drugą generację swojego otwartego modelu embeddingów zaprojektowanego do działania na urządzeniu. Pierwszy EmbeddingGemma, według Google pobrany ponad 20 milionów razy, przetwarzał wyłącznie tekst; nowy odwzorowuje tekst (w tym kod), obrazy, wideo i audio, osobno lub w połączeniu, w tej samej przestrzeni o 768 wymiarach. Zbudowany na architekturze Gemma 4, zostaje udostępniony na licencji Apache 2.0.
Meet EmbeddingGemma 2, our first natively multimodal open model for on-device embeddings. It expands beyond text to unify code, images, audio, and video in a shared space.
🇵🇱 Oto EmbeddingGemma 2, nasz pierwszy otwarty, natywnie multimodalny model do tworzenia embeddingów na urządzeniu. Wykracza poza tekst, łącząc kod, obrazy, audio i wideo we wspólnej przestrzeni. — @GoogleDeepMind na X
Model liczy 740 milionów parametrów, ale jest modułowy: rdzeń tekstowy o 270M parametrów, do którego w razie potrzeby dołączają enkoder obrazu (170M) i enkoder audio (300M). Aplikacja obsługująca wyłącznie tekst ładuje więc tylko 270M parametrów. Po kwantyzacji Google mierzy na Pixel 11 Pro około 191 Mo aktywnej pamięci RAM dla wag części tekstowej i 567 Mo dla pełnego modelu multimodalnego.
| Cecha EmbeddingGemma 2 | Wartość podana przez Google |
|---|---|
| Łączna liczba parametrów | 740M (tekst 270M, obraz 170M, audio 300M) |
| Wymiary wektorów | 768, z możliwością skrócenia do 512, 256 lub 128 |
| Okno kontekstu | 8K tokens, czterokrotność okna pierwszej wersji |
| Aktywna pamięć RAM na Pixel 11 Pro (po kwantyzacji) | około 191 Mo tylko dla tekstu, 567 Mo dla wszystkich modalności |
| MTEB Code | 78,68, wobec 68,76 dla pierwszej wersji |
| MTEB wielojęzyczny v2 | 61,36, wobec 61,15 dla pierwszej wersji |
Uczenie reprezentacji „na wzór matrioszek” (Matryoshka Representation Learning) pozwala skracać wektory, zmniejszając zapotrzebowanie na miejsce nawet sześciokrotnie; według karty modelu jakość pozostaje niewiele zmieniona do 256 wymiarów, a 128 wymiarów nadaje się przede wszystkim do zastosowań wyłącznie tekstowych. Najwyraźniejsza poprawa dotyczy kodu: według Google wynik MTEB Code wzrasta o niemal dziesięć punktów, podczas gdy wynik dla tekstu wielojęzycznego pozostaje na wcześniejszym poziomie.
Docelowe zastosowania to wyszukiwanie i generowanie wspomagane wyszukiwaniem (RAG) działające całkowicie lokalnie, na przykład odnajdywanie fragmentu wideo na podstawie notatki głosowej. Ponieważ model współdzieli tokenizer tekstu (tokenizer) i enkoder audio z Gemma 4, oba modele mogą działać razem przy mniejszym zużyciu pamięci. Wagi są dostępne na Hugging Face i Kaggle; udostępnienie w Model Garden platformy Gemini Enterprise Agent Platform zapowiedziano „wkrótce”, bez podania daty. Od premiery model obsługują Transformers (wersja 5.19.0), sentence-transformers, MLX, vLLM, llama.cpp, Ollama i LM Studio, a także transformers.js w przeglądarce.
🔗 Ogłoszenie na blogu Google 🔗 Karta modelu EmbeddingGemma 2 🔗 Wagi na Hugging Face
Modele decyzyjne: OpenAI otwiera API Decisions, Perplexity publikuje Decider v1.1 i obniża cenę o połowę, Decision Index 0.3 tworzy ich ranking
Modele decyzyjne, które wybierają opcję lub oceniają dane wejściowe zamiast pisać swobodną odpowiedź, miały swój dzień: dwóch dostawców zmienia ofertę i ceny, a społecznościowy ranking tej kategorii zmienia metodologię.
API Decisions od OpenAI w publicznej wersji beta
6 października — Tydzień po udostępnieniu ograniczonego dostępu na DevDay API Decisions od OpenAI przechodzi do publicznej wersji beta, a ogólna dostępność jest oczekiwana „w najbliższych tygodniach”. Odpowiada na pytania zamknięte dotyczące tekstu, obrazu lub obu tych formatów, korzystając z GPT-6 Luna, jedynego dostępnego modelu, przez dedykowany punkt końcowy (POST /v1/decisions); według OpenAI odpowiedzi o określonym typie docierają około 10 razy szybciej niż przez Responses API. Dzisiejszą nowością jest cena: 0,10 dolara za milion tokenów wejściowych, bez opłat za wyjście ani cache, z dodatkowymi opłatami za przetwarzanie regionalne i długi kontekst.
| Typ pytania | Docelowe zastosowanie | Zwracany wynik |
|---|---|---|
Predykat (predicate) | Sprawdzenie warunku, na przykład uszkodzenia produktu na zdjęciu | Prawdopodobieństwo od 0 do 1, że warunek jest prawdziwy |
Wybór (choice) | Wybranie opcji z podanej listy | Opcja, prawdopodobieństwo każdej z nich i wskaźnik pewności |
Ocena (score) | Ocena na uporządkowanej skali, na przykład powagi incydentu | Średnia poziomów ważona prawdopodobieństwami |
W jednym żądaniu można zadać kilka pytań dotyczących tych samych danych wejściowych, a obrazy trzeba wysyłać w base64, bez adresu URL hostowanego obrazu ani identyfikatora pliku. API obsługuje brak przechowywania danych (Zero Data Retention) i zastosowania objęte HIPAA dla uprawnionych klientów, z przechowywaniem danych w Stanach Zjednoczonych i Europie.
🔗 Przewodnik po API Decisions 🔗 Changelog API OpenAI
pplx-decider-v1.1-27b od Perplexity i cena obniżona o połowę
6 października — Pięć dni po uruchomieniu własnego Decisions API Perplexity aktualizuje obsługujący je model, informując o tym w wątku na swoim koncie dla deweloperów, @perplexitydevs. Opublikowany z otwartymi wagami na licencji Apache 2.0 na Hugging Face, pplx-decider-v1.1-27b zachowuje bazę Qwen3.8-27B z v1, czyta tekst i obrazy w kontekście o długości 250k tokenów oraz usuwa maskę przyczynową (causal mask) w warstwach pełnej atencji. Decisions API, które teraz udostępnia ten model, kosztuje 0,02 dolara za milion tokenów wejściowych, o połowę mniej niż 0,04 dolara w v1, a wyjście pozostaje bezpłatne.
| Kategoria Decision Index (karta Hugging Face) | Wynik Jev | Wynik v1 | Wynik v1.1 |
|---|---|---|---|
| Wiedza (Knowledge) | 51,4 | 40,9 | 48,18 |
| Język (Language) | 62,0 | 63,5 | 69,45 |
| Wyszukiwanie informacji (Retrieval) | 55,4 | 54,9 | 61,26 |
| Narzędzia (Tools) | 75,1 | 79,3 | 78,88 |
| Sztuka (Arts) | 37,7 | 39,4 | 44,66 |
| Łączny wynik ważony | 57,9 | 56,4 | 61,56 |
Według karty modelu łączny wynik wzrasta z 56,4 do 61,56, przewyższając 57,9 uzyskane przez Jev, model decyzyjny TypeSafe AI, który jednak nadal prowadzi w kategorii wiedzy. Perplexity twierdzi również, że osiąga najlepszy wynik w nowym Decision Index 0.3. Do samodzielnego hostowania potrzebny jest GPU mieszczący około 49 Gio wag oraz dostarczona implementacja, ponieważ standardowa inferencja przyczynowa nie odtwarza zmierzonego zachowania.
🔗 Wątek @perplexitydevs na X 🔗 pplx-decider-v1.1-27b na Hugging Face
Decision Index 0.3
6 października — apolinario, inżynier w Hugging Face, publikuje wersję 0.3 Decision Index, społecznościowego rankingu otwartych modeli decyzyjnych odtwarzających Decision Model Jev. Obejmuje on teraz 112 modeli, w tym 111 otwartych reprodukcji, działających na NVIDIA RTX PRO 6000. Zmienia się metodologia: pełny wynik (Full score) łączy 37 publicznych benchmarków, prywatne testy mierzące te same umiejętności oraz prywatne zadania z nowych dziedzin, tak aby pozycja odzwierciedlała umiejętności, a nie tylko sukcesy w znanych benchmarkach. Pojawia się również zakładka dotycząca rozumienia obrazów.
| Wyświetlana pozycja | Model w rankingu | Pełny wynik |
|---|---|---|
| 1 | Perplexity Decider v1.1 (27B) | 62,8 |
| 2 | Fastino GLiDE bez rozumowania (28B) | 60,2 |
| Punkt odniesienia | Jev | 60,1 |
| 3 | Torchcast Decision 27B | 59,9 |
| 4 | deck31b (Gemma 4 31B) | 59,0 |
Dwóch wyników Decider v1.1 nie należy utożsamiać: 61,56 to wynik opublikowany w karcie Perplexity, a 62,8 to wynik obliczony w tym rankingu według nowej metodologii. Prywatne testy, z samej swojej natury, nie są publikowane.
🔗 Ogłoszenie apolinario na X 🔗 Decision Index 0.3
Sterowanie komputerem: OpenAI trenuje GPT-6 Astra na umowach w Ironclad
6 października — OpenAI rozpoczyna współpracę badawczą z dostawcami oprogramowania, aby zwiększyć skuteczność swoich agentów w aplikacjach biznesowych w ramach prac nad sterowaniem komputerem (computer use), zaczynając od Ironclad, specjalisty od obsługi umów wspomaganej przez AI. Zespoły zdefiniowały 11 zadań z obszaru prawa, sprzedaży i zakupów, z których każde według OpenAI wymaga od doświadczonego użytkownika od 30 do 40 minut i jest oceniane według od 8 do 50 kryteriów. Ironclad udostępnił hostowane środowiska swojego oprogramowania, w których modele trenowano za pomocą uczenia ze wzmocnieniem na syntetycznych zadaniach opartych na publicznych umowach z bazy EDGAR należącej do SEC.
| Pomiar OpenAI dla 11 zadań | GPT-5.6 Sol (rozumowanie High) | GPT-6 Astra (rozumowanie Max) |
|---|---|---|
| Średni wynik | 41,6 % | 55,0 % (+32 %) |
| Szacowany średni czas jednej próby (symulowany) | 37,0 minut | 19,2 minut (-48 %) |
GPT-6 Astra jest pierwszym modelem klasy frontier OpenAI trenowanym na tych zadaniach, a wewnętrzny model używany podczas jego rozwoju osiąga 63,7 %. Te liczby pochodzą od OpenAI, a czasy są symulowane na podstawie założonych prędkości przetwarzania, nie mierzone u klientów. OpenAI zachęca innych dostawców do proponowania zadań, z którymi obecni agenci nie radzą sobie jeszcze niezawodnie.
🔗 Wpis OpenAI o współpracy z Ironclad
API i platformy: poziomy i BAA w API OpenAI, dokumenty i obrazy w Agent API Perplexity, GLM-5.3 na Bedrock
Cztery zmiany dotyczą deweloperów kupujących inferencję: warunków dostępu do API OpenAI, narzędzi Agent API Perplexity i nowego otwartego modelu w katalogu AWS.
Liczba poziomów korzystania z API OpenAI spada z pięciu do trzech
6 października — OpenAI upraszcza dostęp do najwyższych limitów przepustowości (rate limits) swojego API: pięć płatnych poziomów korzystania zmienia się w trzy — Build, Launch i Grow. Najwyższy, Grow, można uzyskać po dokonaniu łącznie płatności za API na 500 dolarów, wobec 1 000 dolarów wymaganych dla poprzedniego najwyższego poziomu. Organizacje korzystające już z płatnego poziomu przechodzą automatycznie, bez żadnych działań ze swojej strony, a następnie awansują na wyższe poziomy, gdy łączna wartość zakupionych kredytów osiągnie progi; poziom bezpłatny nadal ma limit 100 dolarów miesięcznie.
| Poziom korzystania | Próg łącznych zakupów | Miesięczny limit wykorzystania | Astra, Sol i Terra (żądania i tokeny na minutę) | Luna (żądania i tokeny na minutę) |
|---|---|---|---|---|
| Build | 5 dolarów | 500 dolarów | 5 000 i 1 000 000 | 5 000 i 2 000 000 |
| Launch | 100 dolarów | 5 000 dolarów | 10 000 i 4 000 000 | 10 000 i 10 000 000 |
| Grow | 500 dolarów | 200 000 dolarów | 15 000 i 40 000 000 | 30 000 i 180 000 000 |
🔗 Wątek @OpenAIDevs na X 🔗 Dokumentacja limitów przepustowości
Samoobsługowe BAA i zgodność z HIPAA w API OpenAI
5 października — Organizacje przetwarzające chronione dane zdrowotne za pomocą API OpenAI mogą teraz samodzielnie podpisać umowę z partnerem biznesowym (Business Associate Agreement, BAA), wymaganą przez amerykańską ustawę HIPAA. W Settings > Organization > General administrator akceptuje standardową BAA i włącza obsługę zgodności z HIPAA, bez umowy korporacyjnej. Ta samoobsługa jest dostępna tylko dla uprawnionych organizacji z ugruntowaną historią korzystania z API, a aktywacji nie można cofnąć w tych ustawieniach. Indywidualne klauzule nadal wymagają zgłoszenia e-mailem, z odpowiedzią w ciągu jednego do dwóch dni roboczych. OpenAI przypomina, że samo podpisanie BAA nie zapewnia zgodności aplikacji z przepisami oraz że BAA nie jest oferowana dla ChatGPT Business.
🔗 Artykuł pomocy OpenAI o BAA dla API
Agent API Perplexity czyta dokumenty i wyszukuje obrazy
5 października — Późnym wieczorem w changelogu API Perplexity pojawiają się trzy wpisy. Agent API przyjmuje teraz jako dane wejściowe dokumenty PDF, DOC, DOCX, TXT i RTF, dołączone do żądania lub wskazane publicznym adresem URL HTTPS, przy czym obsługa zależy od wybranego modelu i dostawcy. Nowe narzędzie, image_search, wyszukuje obrazy w internecie i zwraca ustrukturyzowane wyniki z adresem obrazu oraz strony, z której pochodzi: od 1 do 30 obrazów na wywołanie, domyślnie 5, filtry domen i formatów oraz domyślnie włączone bezpieczne wyszukiwanie. Kosztuje 2,50 dolara za 1 000 udanych wywołań, a nieudane wywołania nie są naliczane. Trzeci wpis koryguje rozliczanie kosztów: odpowiedzi podają teraz szczegółowo koszt ekstrakcji wykonywanych w sandboxie, przy niezmienionej stawce GPT-6 Luna.
🔗 Changelog API Perplexity 🔗 Dokumentacja narzędzia image_search
GLM-5.3 od Z.ai na Amazon Bedrock
6 października — Z.ai ogłasza udostępnienie GLM-5.3, swojego flagowego modelu z otwartymi wagami, na Amazon Bedrock; karta AWS podaje datę premiery 5 października. To model o architekturze mieszanki ekspertów z 744 miliardami parametrów, z których około 40 miliardów jest aktywnych na token, z kontekstem o długości miliona tokenów i wyjściem do 128 000 tokenów. Dostęp jest zarezerwowany dla uprawnionych klientów, którzy kontaktują się ze swoim zespołem obsługi konta AWS, a model jest udostępniany wyłącznie w ramach inferencji międzyregionalnej (profil US lub global), z buforowaniem promptów od 1 024 tokenów i poziomami usługi Standard, Priority, Flex oraz Reserved. Karta nie podaje ceny i odsyła do strony cennika Bedrock. GLM-5.3 dołącza po Kimi K3 (22 września) i Grok 4.7 (28 września), które trafiły na Bedrock w ciągu ostatnich dwóch tygodni.
🔗 Karta GLM 5.3 na Amazon Bedrock 🔗 Ogłoszenie Z.ai na X
Agenci programistyczni: Claude Code 2.1.290 do 2.1.292, sesje w chmurze, Vibe CLI 2.26.0, Antigravity i Replit
Agenci programistyczni otrzymują pięć aktualizacji, od terminala po edytor: trzy wersje Claude Code w mniej niż dwadzieścia godzin, przewodnik po sesjach w chmurze, Vibe CLI z rozwijanym nowym interfejsem w Rust, rozszerzenie Antigravity do VS Code oraz Replit, który widzi wszystkie projekty użytkownika.
Claude Code od 2.1.290 do 2.1.292
5 i 6 października — Opublikowane 5 października o 23:33 UTC wydanie Claude Code 2.1.290 jest obszerne: 190 pozycji, w tym 131 poprawek. claude attach i claude logs przyjmują fragment nazwy sesji zamiast jej identyfikatora, a /claude-api managed-agents-onboard przekształca model Managed Agents opisany na stronie internetowej w pliki ant apply. Limit wyszukiwania w internecie w sesji interaktywnej nie wyczerpuje się już po 200 wywołaniach: odnawia się w tempie 100 wywołań na godzinę. Przy średnim poziomie wysiłku (medium) /code-review sygnalizuje też odstępstwa od konwencji z CLAUDE.md podczas korzystania z Opus 5.5 i Sonnet 5.5. W Slack Claude Tag zyskuje tryb szybki (!fast), wywołanie browser_batch w Claude in Chrome ma do dyspozycji 90 sekund zamiast 60, a WebFetch nie ucina już po cichu tekstu przekraczającego 100 000 znaków. pyright oraz więcej wariantów ps wymagają zgody. Naprawiono też kilka luk w systemie uprawnień związanych z rozwijaniem symboli wieloznacznych rg i git grep przez shell, dowiązaniami do CLAUDE.md spoza katalogów roboczych oraz obchodzeniem modu organizacji przez mod użytkownika. Cztery godziny później wersja 2.1.291 naprawia dwie regresje: jedną wprowadzoną w 2.1.290 (gubienie odpowiedzi na prośby o zgodę w sesjach w chmurze), a drugą w 2.1.288 (gubienie ostatnich wiadomości sesji przy zamykaniu).
6 października o 18:59 UTC wersja 2.1.292 (92 pozycje, w tym 64 poprawki) dodaje parametr effort do narzędzia Agent, umożliwiający uruchomienie subagenta z żądanym poziomem wysiłku, oraz claude plugin install --marketplace, które w razie potrzeby dodaje sklep z rozszerzeniami (marketplace), a następnie instaluje plugin. Lokalne serwery MCP (stdio) negocjują teraz domyślnie protokół 2026-07-28 (MCP_PROTOCOL_NEGOTIATION=legacy pozwala wrócić do poprzedniego), CLAUDE_CODE_OVERLOADED_RETRY_BASE_DELAY_MS wydłuża ponawianie prób przy błędach 529, a mody zyskują zdarzenie autouzupełniania promptu i cache promptu. W kwestii bezpieczeństwa zgody udzielane przez hook PreToolUse i tryb auto nie omijają już prośby o zgodę na odczyt ścieżek sieciowych (UNC), a tagi <system-reminder> zapisywane przez hook mają kodowane znaki specjalne, zanim trafią do Claude. Narzędzie Artifact wyświetla wreszcie 200 artefaktów zamiast 50, a Code Review przedstawia statystyki w podziale na repozytoria. Ani wersja 2.1.290, ani 2.1.292 nie zostały ogłoszone na X.
| Wersja Claude Code | Data publikacji (UTC) | Liczba pozycji | Główna nowość |
|---|---|---|---|
| 2.1.290 | 5 października, 23 h 33 | 190, w tym 131 poprawek | Sesje wskazywane nazwą, managed-agents-onboard, odnawiany limit WebSearch |
| 2.1.291 | 6 października, 3 h 55 | 2 poprawki | Naprawione dwie regresje |
| 2.1.292 | 6 października, 18 h 59 | 92, w tym 64 poprawki | Poziom wysiłku subagentów, plugin i sklep z rozszerzeniami w jednej komendzie, MCP 2026-07-28 |
🔗 Claude Code 2.1.290 🔗 Claude Code 2.1.291 🔗 Claude Code 2.1.292
Przewodnik po sesjach Claude Code w chmurze
6 października — Dwa tygodnie po udostępnieniu wersji preview sesji Claude Code w chmurze Anthropic publikuje na claude.dev praktyczny przewodnik autorstwa Addy’ego Osmaniego. Każde zadanie działa na nowej maszynie wirtualnej z około 4 vCPU, 16 GB RAM i 30 GB przestrzeni dyskowej, z repozytorium sklonowanym na nową gałąź, bez dodatkowych opłat za moc obliczeniową w planach Pro, Max, Team i Enterprise. Przewodnik opisuje siedem zastosowań: równoległe realizowanie listy zaległych zadań (backlog), potwierdzanie skuteczności poprawki przez wielokrotne uruchomienia, planowanie lokalnie, a następnie wznawianie sesji za pomocą claude --teleport, śledzenie postępów z telefonu, powierzanie Auto-fix błędów CI i uwag z przeglądu kodu, uruchamianie rutynowych zadań oraz wykonywanie potencjalnie niebezpiecznego kodu w jednorazowej VM. W demonstracji wszystkie trzy sesje zakończyły się 87 sekund po uruchomieniu pierwszej, a jeden projekt może uruchomić do 200 nowych wątków (threads) dziennie. Przewodnik szczegółowo opisuje też połączenie z GitHub: logowanie przez GitHub i instalacja aplikacji Claude GitHub to dwa odrębne uprawnienia, a tylko drugie daje dostęp do prywatnych repozytoriów. Bonusowe środki w wysokości 100 dolarów (Pro) lub 250 dolarów (Max) trzeba odebrać przed 7 października o 23:59 PT; wygasają 4 listopada.
🔗 Praktyczny przewodnik po sesjach w chmurze na claude.dev 🔗 Przypomnienie od @ClaudeDevs o bonusowych środkach
Vibe CLI 2.26.0
6 października — Mistral publikuje Vibe CLI 2.26.0, swojego agenta do programowania działającego w wierszu poleceń, trzynaście dni po wersji 2.25.8 i bez ogłoszenia na X. Aktualizacja jest obszerna: 33 dodatki, 23 zmiany i 91 poprawek. 72 ze 147 pozycji dotyczą nowego interfejsu napisanego w Rust: kreatora pierwszego uruchomienia, trybu głosowego (/voice), cyklicznych promptów opisanych językiem naturalnym za pomocą /loop, przesyłania sesji do Vibe Code Web za pomocą /teleport oraz komendy vibe update. Vibe działa teraz zawsze na Unified Harness, swoim nowym silniku wykonawczym, i zatrzymuje się z jednoznacznym błędem, jeśli go brakuje, zamiast po cichu wracać do starego silnika. Pluginy mogą zawierać własny serwer MCP, zapasowy klucz API przechowywany w ~/.vibe/.env może odczytać już tylko jego właściciel, a Rust CLI przesyła teraz do Mistral telemetrię użytkowania (czas uruchamiania, używane komendy, wykryty terminal).
🔗 Informacje o wydaniu Mistral Vibe v2.26.0
Rozszerzenie Antigravity dla VS Code 1.7.0
5 października — Google publikuje wersję 1.7.0 rozszerzenia Antigravity dla Visual Studio Code, które wprowadza agentów Google Antigravity do edytora Microsoft (rozmowa w panelu bocznym, przegląd diffów bezpośrednio w edytorze, interaktywne plany), począwszy od VS Code 1.90. Według changelogu rozszerzenie jest aktualizowane mniej więcej co tydzień od początku września; dotąd nie było tu opisywane. Wersja 1.7.0 (6 ulepszeń, 9 poprawek) usprawnia przegląd kodu: decyzje Accept i Reject można cofać i ponawiać za pomocą klawiatury, edytor diffów wyświetlanych obok siebie zyskuje przyciski Accept All i Reject All, a automatyczny zapis (Auto Save) w VS Code nie może już nadpisać ani zamknąć trwającego przeglądu. W Windows natywne powiadomienia informują o zakończeniu zadania, gdy okno nie jest na pierwszym planie, a Google Cloud Workstations i Cloud Shell otrzymują interaktywne uwierzytelnianie. Tego samego dnia rozszerzenie dla Visual Studio przechodzi do wersji 1.0.261005.0 i dołącza logi diagnostyczne do przesyłanych opinii.
🔗 Changelog Google Antigravity
Replit i kontekst wszystkich projektów
6 października — Replit ogłasza, że dysponuje teraz kontekstem wszystkich projektów użytkownika. W nowej rozmowie można poprosić go o odnalezienie istniejącego projektu, dodanie do niego funkcji lub wykorzystanie jednego projektu jako punktu odniesienia dla innego; Replit odczytuje wtedy odpowiednie pliki i uruchamia zmiany jako zadania w tle (background tasks), udostępniając linki do ich przeglądu. Wybrany przykład wykracza poza samo programowanie: zastosowanie palety kolorów z „Partner Marketing Hub” w dwóch innych projektach marki kawowej. Ogłoszenie ogranicza się do tweeta z filmem, bez wpisu na blogu, dokumentacji ani cennika.
Pull requests ułożone w stosy na GitHub stają się ogólnodostępne
6 października — GitHub udostępnia we wszystkich planach github.com pull requests ułożone w stosy (stacked pull requests), dostępne w publicznej wersji preview od 30 lipca: duża zmiana jest dzielona na mniejsze pull requests, które są przeglądane osobno, a następnie scalane razem. GitHub Enterprise Server otrzyma je w jednej z kolejnych wersji. Według GitHub repozytoria korzystające ze stosów scalają o 9 % więcej kodu niż porównywalne repozytoria, a używa ich ponad dwie trzecie repozytoriów z czołowego 1 %, przy czasie do scalenia krótszym o 5 %.
Ostateczna wersja usprawnia scalanie. Gdy w gałęzi głównej pojawiają się nowe zmiany, „Rebase stack” zachowuje zatwierdzenia niezmienionego kodu i tworzy podpisane commity zastępujące dotychczasowe; stos przechodzi przez kolejkę scalania (merge queue) jako jedna grupa, a stos, którego gałąź bazowa została usunięta, otrzymuje nową gałąź docelową zamiast zostać zamknięty. Automatyczne scalanie całego stosu pojawi się „w ciągu najbliższych tygodni”. Na potrzeby pracy w wierszu poleceń i agentów rozszerzenie gh stack dla GitHub CLI obsługuje worktrees Git.
🔗 Changelog GitHub dotyczący pull requests ułożonych w stosy
Modele wielojęzyczne: Tiny Aya L2-Thinker od Cohere i Falcon-OCR-Arabic od TII
Dwa małe modele są skierowane do języków, które duże modele obsługują gorzej: jeden rozumuje w języku użytkownika, drugi odczytuje dokumenty po arabsku.
Tiny Aya L2-Thinker od Cohere
6 października — Cohere zajmuje się językiem, w którym rozumują modele: zapytane po hiszpańsku, arabsku lub suahili, większość z nich myśli po angielsku, zanim odpowie. Badawczy model Tiny Aya L2-Thinker (3,35 miliarda parametrów) rozumuje w języku promptu w ponad 93 % przypadków, w 60 językach. Kluczem jest mieszanka danych: około 1,7 miliona przykładów rozumowania po angielsku, wygenerowanych przez gpt-oss-120b, sprawia, że model rozumuje w języku użytkownika zaledwie w 12,8 % przypadków; około 5 000 przetłumaczonych przykładów na język, dla 44 języków, podnosi ten wskaźnik do 86,1 %, a wielojęzyczne dane bez rozumowania rozszerzają to zachowanie na inne języki. W porównaniu z bliźniaczym modelem rozumującym po angielsku dokładność spada najwyżej o dwa do trzech punktów w pięciu z sześciu benchmarków; tylko w PolyMath, obejmującym matematykę konkursową, spadek jest wyraźniejszy ze względu na brak etapu uczenia przez wzmacnianie. Model zużywa średnio mniej niż 5 000 tokenów na rozumowanie. Modele i dane opublikowano na Hugging Face na niekomercyjnej licencji CC-BY-NC 4.0; wpis przedstawia artykuł arXiv z 9 września.
🔗 Wpis badawczy Cohere o Tiny Aya L2-Thinker
Falcon-OCR-Arabic od TII
6 października — TII, instytut ze Zjednoczonych Emiratów Arabskich rozwijający modele Falcon, przedstawia na blogu Hugging Face Falcon-OCR-Arabic, arabską wersję swojego modelu rozpoznawania tekstu Falcon OCR. Zachowuje on 270 milionów parametrów i architekturę z wczesną fuzją; został dostosowany przez nadzorowany fine-tuning na rzeczywistych i syntetycznych dokumentach arabskich, a następnie przez uczenie przez wzmacnianie. Na benchmarku zbudowanym przez samo TII (11 974 rzeczywiste dokumenty, 15 kategorii) zajmuje drugie miejsce wśród 17 porównywanych modeli, a pierwsze w przypadku dokumentów urzędowych, formularzy administracyjnych, paragonów i faktur.
| Model oceniany przez TII | Dokładność tekstu | Wynik Table TEDS |
|---|---|---|
| Gemini 3.5 Flash | 84,34 % | 51,30 % |
| Falcon-OCR-Arabic (270M) | 81,87 % | 59,95 % |
| Claude Opus 5.5 | 79,22 % | 43,98 % |
| GPT Astra | 75,02 % | 51,23 % |
| Chandra OCR 2 (najlepszy wyspecjalizowany OCR) | 61,67 % | 32,63 % |
Wpis udostępnia jedynie środowisko testowe (playground): w momencie naszego sprawdzenia na Hub nie było żadnych wag Falcon-OCR-Arabic i nie podano żadnej licencji.
🔗 Wpis TII o Falcon-OCR-Arabic
Biblioteki Hugging Face: Diffusers 0.41.0 dodaje obsługę Qwen-Image 2.1, Transformers v5.19.0 przyjmuje EmbeddingGemma 2
Dwie główne biblioteki modeli Hugging Face publikują nowe wersje tego samego dnia.
Diffusers 0.41.0 i Qwen-Image 2.1
6 października — Diffusers 0.41.0, biblioteka Hugging Face dla modeli dyfuzyjnych, dodaje obsługę Qwen-Image 2.1, modelu Alibaba łączącego generowanie i edycję obrazów: można go teraz używać bezpośrednio do generowania, edycji, tworzenia obrazów z przezroczystym tłem (natywne wyjście RGBA) i trenowania LoRA, z komponentem generowania obrazów o 7 miliardach parametrów. Zespół zmienia też rytm wydań: podobnie jak Transformers, Diffusers będzie teraz dostosowywać wydania minor do pojawiania się nowych modeli, a wydania patch pozostaną zarezerwowane dla poprawek. Ładowanie w trybie równoległości tensorowej pozwala każdemu GPU odczytywać tylko swoją część wag, a wersja dodaje pipelines LTX-2.5 DFR i optymalizacje dla Cosmos 3. Jednocześnie obsługa ONNX zostaje oznaczona jako przestarzała na rzecz Optimum.
🔗 Informacje o wydaniu Diffusers 0.41.0
Transformers v5.19.0
6 października — Sześć dni po v5.18.0 Transformers v5.19.0 przyjmuje przedstawiony wcześniej EmbeddingGemma 2, z wektorami, które można skracać, oraz enkoderami obrazu i dźwięku, które można wyłączyć podczas ładowania. W treningu rozproszonym równoległość ekspertów zyskuje dystrybucję tokenów (token dispatch), włączoną domyślnie dla Qwen3 MoE i Mellum: rozmiar równoległości ekspertów nie musi już być równy rozmiarowi równoległości tensorowej, a Trainer działa w tym trybie. Cache można teraz konfigurować warstwa po warstwie, co przydaje się w modelach heterogenicznych, a ciągłe przetwarzanie wsadowe (continuous batching) obsługuje XPU. Wersja zawiera sześć zmian naruszających kompatybilność, w tym zwracanie logitów routera dla wszystkich MoE i stopniowe wycofywanie prefiksu paged|.
🔗 Informacje o wydaniu Transformers v5.19.0
Agenci głosowi: ElevenLabs udostępnia ElevenAgents Architect w wersji Alpha
6 października — ElevenLabs wprowadza do ElevenAgents, swojej platformy agentów konwersacyjnych, eksperta o nazwie Architect, który pomaga zespołom budować i ulepszać agentów głosowych lub tekstowych poprzez rozmowę głosową albo tekstową. Zna wszystkie ustawienia ElevenAgents (baza wiedzy, prompty, przepływy, głosy, zabezpieczenia, narzędzia, symulacje) i sposób, w jaki na siebie oddziałują. Można przedstawić mu pytanie, nieudany test, wzrost liczby przekazań rozmowy człowiekowi lub spostrzeżenie z ElevenAgents Spotlight: analizuje transkrypcje, ustala przyczynę, proponuje zmianę i pisze symulacje, które ją weryfikują. Buduje też agenta na podstawie samego opisu. Każda zmiana pojawia się jako wersjonowany szkic i można ją cofnąć, a nic nie trafia do środowiska produkcyjnego bez zatwierdzenia. Architect jest dostępny z poziomu produktu, a także przez Claude, Claude Code, ChatGPT, Cursor i Grok Bot. Jest dostępny już teraz w wersji Alpha, bez cennika ani danych o wynikach.
🔗 Wpis ElevenLabs o ElevenAgents Architect
Generowanie wideo: FLUX 3 na czele Physics-IQ Verified według Black Forest Labs
6 października — Black Forest Labs deklaruje pierwsze miejsce w Physics-IQ, benchmarku Google DeepMind mierzącym rozumienie świata fizycznego przez modele wideo: modelowi pokazuje się początek sfilmowanego rzeczywistego eksperymentu, a on ma przewidzieć jego dalszy przebieg (płyny, optyka, mechanika ciał stałych). Ranking referencyjny Physics-IQ Verified prowadzi Anates Labs. W kategorii wideo na wideo FLUX 3 [large] wyraźnie wyprzedza Cosmos3 od NVIDIA, przy wyższym koszcie pojedynczego wideo.
| Model i metoda (wideo na wideo) | Wynik Physics-IQ Verified | Koszt znormalizowanego wideo |
|---|---|---|
| FLUX 3 [large], najlepszy wynik z 8 generacji | 64,35 % | 16,43 dolara |
| FLUX 3 [large] | 61,11 % | 2,08 dolara |
| Cosmos3 Super (NVIDIA) | 50,80 % | 0,82 dolara |
| Cosmos3 Nano (NVIDIA) | 43,00 % | 0,82 dolara |
W kategorii obraz na wideo FLUX 3 [large] również wyprzedza Physis-Lang, metodę, którą NVIDIA umieszczała na pierwszym miejscu 29 września. FLUX 3 [large] jest modelem własnościowym, a wątek nie podaje ani daty dostępności, ani ceny tego wariantu.
🔗 Wątek @bfl_ai na X 🔗 Ranking Physics-IQ Verified
Publiczne ewaluacje: GeoGuess Bench i RSI Arena
Dwie ewaluacje otwarte dla publiczności wychodzą poza typowe benchmarki: jedna każe modelom grać w GeoGuessr, druga pozwala publiczności głosować na modele trenowane przez agenty.
GeoGuess Bench
6 października — Hassan, odpowiedzialny za doświadczenia deweloperów w Together AI, publikuje GeoGuess Bench, autorski benchmark, w którym modele grają w GeoGuessr: każdy ogląda te same 210 zdjęć ulic i umieszcza pinezkę ocenianą według wzoru z gry, z możliwością zdobycia do 25 000 punktów w grze złożonej z pięciu rund. Claude Opus 5.5 wychodzi na prowadzenie, tuż przed Claude Fable 5.1; zaskoczeniem jest Muse Glimmer 30B, model Meta z otwartymi wagami, który zajmuje trzecie miejsce przed GPT-6 Astra przy około 45 razy niższym koszcie gry.
| Miejsce w GeoGuess Bench | Oceniany model | Wynik na 25 000 | Koszt gry |
|---|---|---|---|
| 1 | Claude Opus 5.5 | 23 412 | 0,064 dolara |
| 2 | Claude Fable 5.1 | 23 307 | 0,115 dolara |
| 3 | Muse Glimmer 30B (otwarty) | 22 407 | 0,0049 dolara |
| 4 | GPT-6 Astra | 21 562 | 0,223 dolara |
| 5 | GPT-6.1 Sol | 21 194 | 0,042 dolara |
| 6 | GLM-5.3 Flash (otwarty) | 21 183 | 0,0087 dolara |
GLM-5.3 Flash dorównuje więc GPT-6.1 Sol przy około pięć razy niższym koszcie. Jest to osobisty projekt pracownika Together AI, dostawcy usług inferencji dla otwartych modeli, a nie ewaluacja przeprowadzona przez firmę; nie ma w niej żadnego modelu Gemini, a kod opublikowano na GitHub.
🔗 Ogłoszenie Hassana na X 🔗 GeoGuess Bench
RSI Arena
6 października — Zichen Chen ogłasza nową rundę RSI Arena (od rekurencyjnego samodoskonalenia, recursive self-improvement), tym razem we współpracy z Hugging Face. Agenty AI otrzymały GPU i jedno zadanie: trenować lepsze modele. Samodzielnie wybrały dane, napisały kod i przeprowadziły eksperymenty. Po zakończeniu pierwszej rundy treningu do pętli włącza się publiczność: modele pojedynkują się ze sobą, każdy głosuje, a agenty wykorzystują te opinie w kolejnych eksperymentach. Inference Endpoints od Hugging Face udostępniają każdy model na żywo, a witryna wymienia dziesięć agentów, w tym GPT-6 Astra, Grok 4.7, DeepSeek V4.1 Flash, GLM-5.3 i Muse Spark 1.3; jej panel pokazywał wydatki na API w wysokości 286,60 dolara z 300 oraz wykorzystanie 755,17 godziny GPU z 1 000. Zespół obiecuje opublikować na Hub każdy model wytrenowany przez agenty, a na koniec eksperymentu wszystkie artefakty: dane, kod i pełną ścieżkę badawczą każdego agenta.
🔗 Ogłoszenie Zichena Chena na X 🔗 RSI Arena
Infrastruktura GPU: NVIDIA publikuje AICR v1.0
6 października — NVIDIA publikuje wersję 1.0 AI Cluster Runtime (AICR), otwartego projektu, który ma położyć kres konfigurowaniu klastrów Kubernetes z GPU metodą prób i błędów. Klaster wykorzystujący akceleratory zależy od dziesiątek komponentów z niezależnymi wersjami (jądro, sterowniki, środowiska kontenerów, sieć, pamięć masowa, operatory, biblioteki), a kombinacja działająca w jednym miejscu może w innym zawieść bez żadnego komunikatu. AICR odpowiada na to zweryfikowanymi konfiguracjami z ustalonymi wersjami, generowanymi dla Helm, Argo CD, Flux lub Helmfile i uzupełnionymi podpisanymi dowodami walidacji na testowanym sprzęcie. Wersja v1.0 ustala kontrakt zgodności: CLI, API REST, SDK Go, struktura pakietów wdrożeniowych i schematy artefaktów stają się stabilnymi interfejsami, a każda zmiana naruszająca zgodność będzie wymagała nowej wersji głównej. NVIDIA deklaruje ponad 100 współtwórców, z których blisko połowa pochodzi spoza firmy, i wymienia integracje w Pulumi Labs oraz w narzędziu Mirantis k0rdent do zarządzania wieloma klastrami.
🔗 Wpis na blogu technicznym NVIDIA
Claude Startups: do 7 000 dolarów w produktach i kredytach oraz Startup Stack o wartości 45 000 dolarów
6 października — Anthropic rozszerza dostęp do Claude Startups, programu dla założycieli tworzących na bazie Claude, na startupy założone mniej niż pięć lat temu lub finansowane w ciągu ostatnich dwóch lat.
| Korzyść z programu | Wartość deklarowana przez Anthropic |
|---|---|
| Rok Claude Team, do pięciu licencji Premium | 6 000 dolarów (pięć licencji po 100 dolarów miesięcznie) |
| Jednorazowy kredyt na API, dostępny od zatwierdzenia | 1 000 dolarów |
| Łączna wartość produktów i kredytów Claude | do 7 000 dolarów |
| Claude Startup Stack (oferty partnerów) | do 45 000 dolarów |
Rok Claude Team przysługuje firmom, które dopiero zaczynają korzystać z Team, a jego rzeczywista wartość zależy od liczby i rodzaju licencji. Claude Startup Stack, dzisiejsza nowość, obejmuje zniżki i kredyty od firm tworzących z Claude, w tym Linear, Lovable, ElevenLabs, Granola i Hex; maksymalna kwota odpowiada łącznej wartości wszystkich ofert według cen katalogowych z września 2026, a nie wszystkie oferty można ze sobą łączyć. Program dodaje terminy rozmów z zespołem Applied AI w Anthropic, pomoc w publikacji wpisu w Claude Marketplace oraz dostęp do wydarzeń.
🔗 Wpis Anthropic o Claude Startups 🔗 Wątek @claudeai o Claude Startup Stack
Krótkie wiadomości
- Claude Projects i lokalny folder — Dan Fein z Anthropic ogłasza, że sesje Claude Projects w chmurze mogą łączyć się z zatwierdzonym folderem na komputerze, do którego uzyskują dostęp tylko wtedy, gdy wymaga tego zadanie; stopniowe wdrażanie trwa od 5 października, a według Borisa Cherny’ego zespół jest już blisko celu (Już prawie). 🔗 źródło · 🔗 Boris Cherny
- Claude w grupowych wiadomościach Slack — Claude można teraz dodawać do grupowych wiadomości prywatnych (group DMs) w Slack jak każdego innego uczestnika; odpowiada w wątku, który dalej śledzi, i może używać osobistych konektorów osoby, która go wywołuje, bez szczegółów dotyczących planów i harmonogramu. 🔗 źródło
- Boris Cherny i jego sposób promptowania — Boris Cherny zleca Opus 5.5 stworzenie interaktywnej strony towarzyszącej odcinkowi podcastu Acquired o Home Depot, wraz z akwarelami; według niego promptowanie nie ma żadnego sekretu: wystarczy powiedzieć modelowi, czego się chce, ile wysiłku ma na to przeznaczyć i jak sprawdzić wynik. 🔗 strona towarzysząca · 🔗 jego sposób promptowania
- Atlassian i OpenAI — Na mocy nowej umowy najbardziej zaawansowane modele z rodziny GPT-6, w tym GPT-6 Astra, będą zasilać agenty platformy Atlassian i Rovo; ponad 3 000 deweloperów Atlassian korzysta już z Codex, a głębsze integracje z Jira są rozważane; kwoty nie ujawniono. 🔗 źródło
- Widżety Codex w ChatGPT na iOS — Wersja 1.2026.267 ChatGPT na iOS z 2 października dodaje widżety ekranu głównego dla ostatnich zadań Codex z wybranych komputerów, inne pokazujące pozostały limit użycia i jego resetowanie, dostępne także na ekranie blokady, oraz ustawienie utrzymujące otwartą klawiaturę. 🔗 źródło
- Gemini CLI v0.63.0 i v0.64.0-preview.0 — Stabilna wersja v0.63.0 powtarza bez zmian 15 pozycji z wersji przedpremierowej z 29 września, a wersja przedpremierowa v0.64.0-preview.0 zbiera 16 pozycji z nocnych wydań od 30 września do 3 października: nie ma żadnych nowych treści, a nocna wersja z 6 października jest pusta. 🔗 źródło
- SDK Python Mistral 3.1.0 — Ta wersja, wygenerowana automatycznie na podstawie API, dodaje w wersji beta czternaście operacji ewaluacji w module obserwowalności; metody
Runstrafiają podWorkflows.runs, co może zepsuć istniejący kod mimo zmiany jedynie wersji podrzędnej. 🔗 źródło - Qwen Code v0.25.1-preview.0 — Dzień po v0.25.0 ta wersja przedpremierowa przynosi 13 funkcji i 27 poprawek, w tym eksperymentalne środowisko uruchomieniowe Kubernetes, polecenia Shell i monitorowanie w tle dla Managed Agent oraz reguły MCP, które nie zezwalają już na serwer o tej samej nazwie. 🔗 źródło
- SDK TypeScript SpaceXAI 0.2.2 — Ta wersja, opublikowana 5 października bez ogłoszenia, zawiera tylko jedną zmianę: opcja
retryBeforeOutputma zastosowanie także do wywołaniacreate()bez przesyłania strumieniowego (streaming), które oczekuje JSON. 🔗 źródło - Falcon-Emirati-7B, dialekt emiracki — TII dostosowuje Falcon-H1-Arabic 7B do emirackiej odmiany arabskiego: 84,83 % na Alyah, benchmarku z 1 173 pytaniami, oraz zgodność z dialektem na poziomie 0,52 wobec maksymalnie 0,05 dla ALLaM, Gemma 3 27B, Jais-2 i Fanar-2, według oceny Gemini 3.7 Flash pełniącego rolę sędziego; model jest dostępny wyłącznie na platformie czatu TII. 🔗 źródło
- Datasets 5.1.0 — Opublikowana 5 października biblioteka zbiorów danych odczytuje teraz środowiska uczenia przez wzmacnianie Harbor, format kolumnowy Vortex i pięć formatów biologicznych (FASTA, FASTQ, GenBank, PDB, mmCIF) oraz usuwa lukę pozwalającą archiwum zapisywać pliki w sąsiednim katalogu. 🔗 źródło
- TRL v1.14.2 — Ta poprawka naprawia błąd, który po cichu zniekształcał trening: bez vLLM, GRPO, RLOO i Distillation nie zatrzymywały się na końcu tury w przypadku modeli takich jak Gemma czy Phi-3.5 i trenowały na całym dalszym tekście aż do maksymalnej długości; naprawiono też trzy błędy powodujące awarie. 🔗 źródło
- Jev kontra e-maile z kampanii wyborczych — We wpisie społecznościowym Stephen Solka sortuje swoje e-maile polityczne za pomocą Jev (99 poprawnych odpowiedzi na 100 rzeczywistych e-maili, jeden wynik fałszywie dodatni), a następnie klasyfikatora SetFit z 22,6 miliona parametrów, działającego na procesorze: 98 % w pilotażowej ewaluacji, ale 18 z 23 w trudnych przypadkach. 🔗 źródło
- Open Together 16 października — vLLM i Hugging Face organizują Open Together, spotkanie deweloperów open source, które otworzy Open Source AI Week w piątek 16 października w San Francisco; według Jeffa Boudiera na liście oczekujących jest 150 osób, a liczbę miejsc podwojono. 🔗 źródło · 🔗 Jeff Boudier
- Copilot CLI 1.0.93-2 — Ta wersja przedpremierowa dodaje ustawienie firmowe,
permissions.limitTo, które ogranicza żądania sieciowe do zarządzanych domen, wyróżnia GPT-6.1 Sol, GPT-6 Astra i Luna oraz modele Claude 5.5 na liście wyboru, a ustawienia użytkownika odczytuje już tylko z~/.copilot/settings.json. 🔗 źródło - AI Scan w przeglądzie bezpieczeństwa — Administratorzy organizacji i przedsiębiorstw widzą teraz w przeglądzie bezpieczeństwa (security overview) GitHub, które repozytoria mają włączoną analizę pull requests przez AI (AI Scan for pull requests), z dwoma filtrami i kolumną w eksporcie CSV. 🔗 źródło
- Wykrywanie sekretów: Lovable, Pydantic i Supabase — Wykrywanie sekretów (secret scanning) w GitHub rozpoznaje pięć nowych typów sekretów, w tym klucz API Lovable, token Logfire i klucz Pydantic AI Gateway, a także dwa tokeny Supabase; Lovable Labs dołącza również do programu partnerskiego GitHub. 🔗 źródło
- Informacje o wydaniu Devin z 5 października — Głównie dopracowanie szczegółów: karta Terminal w przestrzeni roboczej sesji (otwarcie Files lub Terminal wybudza Devin), poziomy wysiłku dla Devin Review ustawiane za pomocą akcji wyzwalających oraz analizy kodu (code scans) możliwe do pobrania po identyfikatorze przez API v3 lub MCP Devin. 🔗 źródło
- Delta i własne worktrees — Na blogu Delta Conrad Irwin wyjaśnia, dlaczego narzędzie zastępuje worktrees Git: każdy wątek ma swój worktree zapisany w DeltaDB i replikowany między osobami, agentami i maszynami, kilka agentów pracuje na tej samej gałęzi, a wersjonowany skrypt
.agents/prepareprzygotowuje każdy checkout; wpis bez nowej wersji. 🔗 źródło - v0: konta osobiste stają się zespołowymi przestrzeniami roboczymi — Konta osobiste v0 stają się zespołowymi przestrzeniami roboczymi, z automatyczną migracją rozmów, projektów i ustawień; dokumentacja zastrzega jednak niektóre funkcje, takie jak szablony zespołowe, dla planów Plus, Business i Enterprise. 🔗 źródło
- v0 i subskrypcja ChatGPT na iOS — Subskrypcji ChatGPT, obsługiwanej przez v0 od 29 września, można teraz używać w jego aplikacji na iOS, bez informacji o cenie i dodatkowych szczegółów. 🔗 źródło
- Eleven v4 i Eleven v4 Turbo na czele — ElevenLabs ogłasza, że jego dwa modele syntezy mowy, wprowadzone 28 września, zajmują dwa pierwsze miejsca w rankingu syntezy mowy (text to speech) Artificial Analysis; v4 zajmował tam pierwsze miejsce już w dniu premiery. 🔗 źródło
- HeyGen Video w 2K — Tydzień po premierze HeyGen Video przechodzi na rozdzielczość 2K; według HeyGen zajmuje pierwsze miejsce w rankingu wideo OpenRouter pod względem wykorzystania, bez osobnej ceny dla 2K, a strona katalogowa nadal podaje 0,01 dolara za sekundę do końca października. 🔗 źródło
- Nano Banana 2.1 w Pika — Pika dodaje do swojej platformy i Pika API Club model Nano Banana 2.1, nową wersję modelu Nano Banana od Google, która według Pika zapewnia wyższą jakość obrazu i większą szybkość; nie podano ceny ani kosztu w kredytach. 🔗 źródło
- DOCA GPUNetIO — NVIDIA czyni DOCA GPUNetIO wspólną implementacją sieci sterowanej przez GPU (GDA-KI) dla NCCL, NVSHMEM i NIXL/UCX, w pełnej wersji w SDK DOCA oraz jako lżejszy projekt open source skupiony na RDMA Verbs. 🔗 źródło
- Green contexts w CUDA — Wpis techniczny NVIDIA pokazuje, jak zarezerwować SM dla zadania krytycznego: na GPU Blackwell ze 148 SM jądro korzystające z 8 zarezerwowanych SM odpowiada w 0,007 ms, wobec 0,140 ms przy strumieniu (stream) priorytetowym i 3,727 ms bez priorytetu. 🔗 źródło
- Otwarte modele u operatorów telekomunikacyjnych — We wpisie przedstawiającym stanowisko NVIDIA powołuje się na swoje badanie sektora telekomunikacyjnego z 2026 roku, w którym 89 % respondentów uznaje open source za ważne, oraz na wypowiedzi SoftBank, AT&T i Indosat; bez nowych produktów. 🔗 źródło
- Przewodnik Perplexity po narzędziach do współpracy — Perplexity porównuje dziesięć narzędzi do współpracy wyposażonych w IA (Slack, Loom, Confluence, Airtable, Notion, ClickUp, Asana, Monday.com, Trello, Miro), ich funkcje IA oraz plany, które je obejmują; bez nowości produktowych. 🔗 źródło
Co to oznacza
Modele decyzyjne stają się odrębną kategorią, z własną wojną cenową i rankingiem. Tego samego dnia OpenAI ustala cenę swojego API Decisions na 0,10 dolara za milion tokenów wejściowych, a Perplexity obniża swoją do 0,02 dolara, o połowę mniej niż pięć dni temu; żadna z tych firm nie pobiera opłat za tokeny wyjściowe. Te modele nie piszą, lecz wybierają lub oceniają: płaci się za to, co odczytują, i oczekuje się od nich szybkości, a OpenAI obiecuje odpowiedzi około dziesięciokrotnie szybsze niż w Responses API. Decision Index 0.3 pełni rolę społecznościowego arbitra, a jego nowa prywatna połowa ma mierzyć umiejętności zamiast wyników na znanych benchmarkach. Jego werdykt już wpływa na komunikację twórców: Perplexity powołuje się na niego w swoim ogłoszeniu, choć karta jego modelu podaje inny wynik niż ranking.
IA zadomawia się w narzędziach biurowych, a nie odwrotnie. Claude trafia do Google Docs, Sheets i Slides po wcześniejszym wejściu do Excel, PowerPoint i Word, dołącza do wiadomości grupowych w Slack, a modele GPT-6 będą zasilać agentów Rovo w Atlassian. W tych integracjach liczy się już nie tylko jakość modelu, lecz także kontrola: tryb wymagający zatwierdzenia każdej zmiany, konektory respektujące uprawnienia udostępniania Google, mechanizmy kontroli Enterprise stosowane do modułu. Ta sama logika przewija się przez dzisiejsze narzędzia dla agentów, od decyzji podejmowanych podczas przeglądu, które można cofnąć w Antigravity, po wersjonowane szkice w ElevenAgents Architect.
W cyberbezpieczeństwie poziom dostępu zależy od weryfikacji. CVP od Anthropic nie zmienia modelu, lecz jego zabezpieczenia: na CyScenarioBench ten sam Opus 5.5 przechodzi od zadań blokowanych już przy pierwszym prompcie bez weryfikacji do 34 pomyślnie wykonanych zadań na 50 w Red Team Access. Mistral przedstawia inny argument, dotyczący modelu, który nie odmawia: deklaruje wynik 82 % w teście cyber, do którego, według firmy, Claude Opus 5.5 i GPT-6 Astra odmawiają przystąpienia. Oba podejścia łączy jeden punkt: najszerszy dostęp do możliwości cyber uzyskują najpierw zweryfikowani specjaliści, będący partnerami Mistral przed publikacją wag lub członkami programu Anthropic.
Modele rozwijają się także na obu krańcach skali rozmiarów. Na górnym końcu Mistral Large 4 i jego 1 000 miliardów parametrów, których wagi zapowiedziano na koniec października; na dolnym EmbeddingGemma 2, który mieści się w około 567 Mo pamięci RAM na telefonie, Tiny Aya L2-Thinker i jego 3,35 miliarda parametrów czy Falcon-OCR-Arabic i jego 270 milionów, na razie jedynie w formie demonstracji. Wiele podanych dziś wartości mierzą jednak sami twórcy: wyniki Mistral, pierwsze miejsce deklarowane przez Black Forest Labs, własny benchmark TII, karta Perplexity, zadania Ironclad oceniane przez OpenAI czy korzyści ze scalania ogłoszone przez GitHub. Często jest to jedyny pomiar dostępny w dniu ogłoszenia; warto będzie go zweryfikować za pomocą niezależnych ocen, co umożliwią właśnie wagi Mistral Large 4 po ich publikacji.
Źródła
- Wpis Mistral o Mistral Large 4
- Karta Mistral Large 4 w dokumentacji
- Wpis Anthropic o Claude for Google Workspace
- @claudeai na X, Claude for Google Workspace
- Wpis Anthropic o Cyber Verification Program
- Strona pomocy Cyber Verification Program
- Comcast i Booz Allen z Claude Mythos
- EmbeddingGemma 2 na blogu Google
- Karta modelu EmbeddingGemma 2
- @GoogleDeepMind na X, EmbeddingGemma 2
- EmbeddingGemma 2 na Hugging Face
- Przewodnik po API Decisions od OpenAI
- Changelog API OpenAI
- @perplexitydevs na X, pplx-decider-v1.1-27b
- pplx-decider-v1.1-27b na Hugging Face
- @multimodalart na X, Decision Index 0.3
- Decision Index 0.3
- Wpis OpenAI o współpracy z Ironclad
- @OpenAIDevs na X, poziomy wykorzystania
- Dokumentacja limitów przepustowości API OpenAI
- Artykuł pomocy OpenAI o BAA dla API
- Changelog API Perplexity
- Dokumentacja narzędzia image_search od Perplexity
- Karta GLM 5.3 w Amazon Bedrock
- @Zai_org na X, GLM-5.3 na Bedrock
- Claude Code 2.1.290
- Claude Code 2.1.291
- Claude Code 2.1.292
- Praktyczny przewodnik po sesjach cloud na claude.dev
- @ClaudeDevs na X, dodatkowy kredyt na sesje cloud
- Informacje o wydaniu Mistral Vibe v2.26.0
- Changelog Google Antigravity
- @Replit na X, kontekst wszystkich projektów
- Changelog GitHub dotyczący pull requests ułożonych w stos
- Wpis badawczy Cohere o Tiny Aya L2-Thinker
- Wpis TII o Falcon-OCR-Arabic
- Informacje o wydaniu Diffusers 0.41.0
- Informacje o wydaniu Transformers v5.19.0
- Wpis ElevenLabs o ElevenAgents Architect
- @bfl_ai na X, FLUX 3 i Physics-IQ
- Ranking Physics-IQ Verified
- @nutlope na X, GeoGuess Bench
- GeoGuess Bench
- @my_cat_can_code na X, RSI Arena
- RSI Arena
- AICR v1.0 na blogu technicznym NVIDIA
- Wpis Anthropic o Claude Startups
- @claudeai na X, Claude Startup Stack
- Dan Fein na X, Claude Projects i folder lokalny
- Boris Cherny na X, stopniowe wdrażanie Claude Projects
- Dan Fein na X, Claude w wiadomościach grupowych Slack
- Boris Cherny na X, witryna towarzysząca Acquired
- Boris Cherny na X, jego sposób tworzenia promptów dla Claude
- Atlassian i OpenAI rozszerzają partnerstwo
- Changelog ChatGPT i Codex, ChatGPT na iOS 1.2026.267
- Gemini CLI v0.63.0
- SDK Python od Mistral v3.1.0
- Qwen Code v0.25.1-preview.0
- SDK TypeScript od SpaceXAI v0.2.2
- Wpis TII o Falcon-Emirati
- Datasets 5.1.0
- TRL v1.14.2
- Wpis Stephena Solki
- @vllm_project na X, Open Together
- Jeff Boudier na X, lista oczekujących na Open Together
- Copilot CLI 1.0.93-2
- Changelog GitHub dotyczący stanu włączenia AI Scan
- Changelog GitHub dotyczący nowych detektorów sekretów
- Informacje o wydaniu Devin z 5 października
- Wpis Conrada Irwina na blogu Delta
- Changelog v0, przekształcanie kont osobistych w przestrzenie zespołowe
- @v0 na X, subskrypcja ChatGPT na iOS
- @ElevenLabs na X, Eleven v4 na czele
- @HeyGenDev na X, HeyGen Video w 2K
- @pika_labs na X, Nano Banana 2.1 na Pika
- DOCA GPUNetIO na blogu technicznym NVIDIA
- Green contexts na blogu technicznym NVIDIA
- Otwarte modele i operatorzy telekomunikacyjni, blog NVIDIA
- Przewodnik Perplexity po narzędziach do współpracy