ai-powered-markdown-translatorArtykuł przetłumaczony z francuskiego na polski za pomocą gpt-6.1-sol.
Qwen udostępnia Qwen4-Max w swoim API: model MoE o 2,4T parametrów, z kontekstem 1M tokenów, tańszy niż Qwen3.8-Max. OpenAI rozszerza dostępność swoich agentów obsługujących komputer na ChatGPT for Healthcare i ChatGPT for Clinicians, NVIDIA zapowiada na SC26 Rubin HPC, GPU do symulacji oczekiwany w 2028 roku, wraz z pierwszymi wynikami Vera Rubin w MLPerf Training, a Hugging Face powierza OpenRouter routing swoich Inference Providers. Perplexity uruchamia z kolei Perplexity Frontier Research, którego celem jest stworzenie zautomatyzowanego naukowca z wykorzystaniem ponad 10 000 GPU.
Qwen4-Max trafia do API QwenCloud: MoE o 2,4T parametrów, kontekst 1M tokenów, niższe ceny
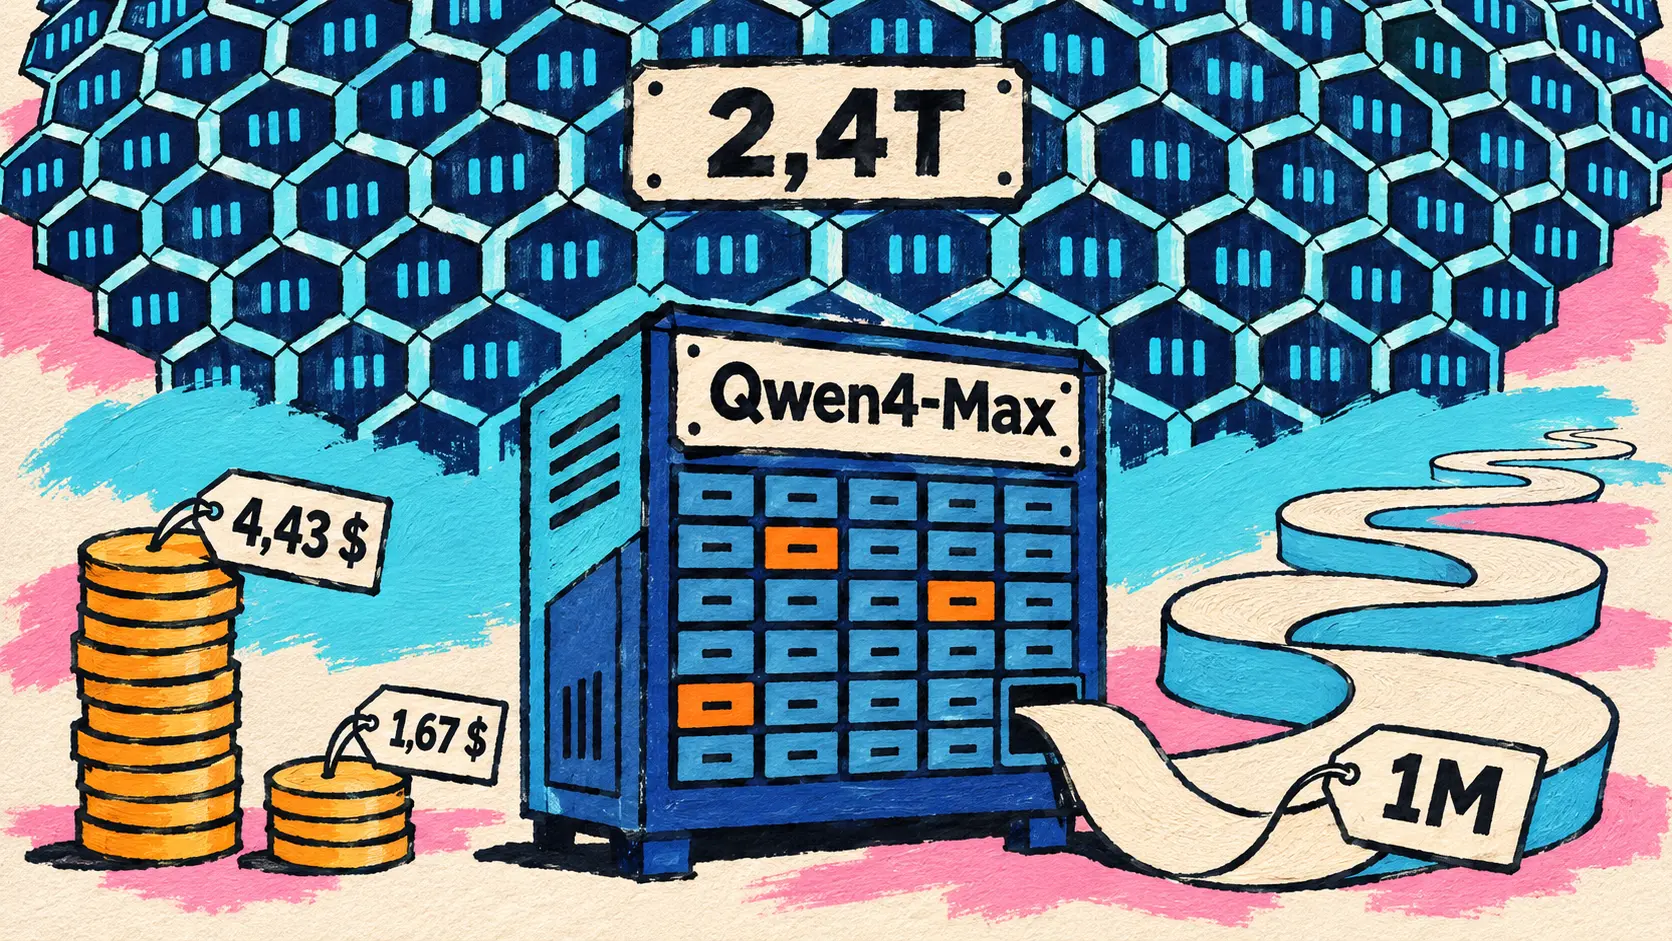
16 listopada — Pięć dni po wersji zapoznawczej opisanej 11 listopada Qwen udostępnia Qwen4-Max w API QwenCloud pod identyfikatorem qwen4-max, wraz z obszernym wpisem technicznym. To pierwszy model z serii Qwen4: mniejsze modele Qwen4 zostaną udostępnione z otwartymi wagami, bez podanej daty, ale nic nie wskazuje na takie plany wobec Max. Model jest również oferowany w QwenWork, Qoder i Qwen Studio, a już tego samego dnia także w OpenRouter, Vercel AI Gateway, Novita AI i OpenCode Go.
Architektura jest nowa. Ta mieszanka ekspertów (Mixture of Experts, MoE) ma 2,4T parametrów rdzenia, z czego 71B jest aktywowanych na token, oraz dodatkowe 328B parametrów N-gram Embedding. Spośród czterech warstw trzy, oparte na Gated DeltaNet, kompresują historię do stanu o stałym rozmiarze; czwarta, wykorzystująca Qwen Sparse Attention, wybiera przydatny kontekst blokami. Model natywnie obsługuje obraz i ma kontekst 1M tokenów: według strony QwenCloud 991K na wejściu i 131K na wyjściu, a w trybie rozumowania odpowiednio 983K i 262K.
| Rodzaj opłaty (QwenCloud, za milion tokenów) | Podana cena |
|---|---|
| Wejście | 1,5 dolara |
| Wyjście | 4,5 dolara |
| Wejście w niejawnym cache | 0,075 dolara |
| Tworzenie jawnego cache (5 minut / 1 godzina) | 1,875 / 3 dolary |
Według Qwen wszystkie te stawki są niższe niż w Qwen3.8-Max, a cena niejawnego cache spada o 70 %. W swoich wewnętrznych ocenach Qwen podaje również spadek zużycia tokenów o 24 do 35 %, zależnie od poziomu wysiłku, w Work360, swoim zestawie ocen obejmującym 721 specjalizacji zawodowych, oraz o około 48 do 49 % w Terminal-Bench 4.0. Średni koszt zadania w Work360 spada z 4,43 do 1,67 dolara, czyli o −62 % według angielskiego wpisu; wersja chińska, podająca kwoty w juanach, wskazuje −58 %. W Work360 Qwen4-Max uzyskuje 52,69 wobec 47,74 dla Qwen3.8-Max.
Na tle Opus 5.5, GPT-6.1 Sol, GPT-6 Astra i Kimi K3.1 tabela opublikowana przez Qwen daje zróżnicowany obraz: Qwen4-Max prowadzi jedynie w 4 z 16 testów: DeepSWE v1.1, Agents’ Last Exam v1.1, HLAB-Vals-1.1 i BioMysteryBench. Wybrane wyniki:
| Benchmark (dziedzina) | Qwen4-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|
| DeepSWE v1.1 (programowanie agentowe) | 75,7 | 74,2 | 75,2 | 74,1 | 75,5 |
| HLAB-Vals-1.1 (agent prawny) | 21,3 | 9,2 | 6,3 | 7,1 | 11,7 |
| BioMysteryBench (bioinformatyka) | 85,0 | 81,9 | 84,4 | 78,9 | 80,6 |
| Terminal-Bench 4.0 (agent w terminalu) | 48,5 | 59,6 | 56,1 | 59,1 | 67,2 |
| ProgramBench (odtwarzanie oprogramowania) | 31,5 | 65,0 | 52,5 | 55,0 | 25,0 |
| Humanity’s Last Exam | 51,7 | 59,8 | 54,0 | 53,6 | 51,1 |
Zewnętrzne rankingi przytaczane przez Qwen plasują go na 6. miejscu w Code Arena WebDev (wstępnie 1 750 punktów) i na 11. miejscu w Vals Index (63,20 %), jako najwyżej sklasyfikowany model chiński. Artificial Analysis przyznaje mu 43 punkty w Intelligence Index przy poziomie wysiłku xhigh, o 3 punkty mniej niż Kimi K3.1 Pro, przy koszcie zadania niższym o około 11 %.
More to come! The open weights of smaller Qwen4 models will be released. Stay tuned.
🇵🇱 To jeszcze nie koniec! Otwarte wagi mniejszych modeli Qwen4 zostaną opublikowane. Śledźcie kolejne informacje. — @Alibaba_Qwen na X
🔗 Qwen4-Max: twój nowy współpracownik już tu jest (wpis Qwen) · Karta qwen4-max w QwenCloud
ChatGPT for Healthcare: agenci obsługujący komputer, badania kliniczne i ponad 20 wtyczek medycznych
16 listopada — OpenAI rozwija ChatGPT for Healthcare w trzech kierunkach. Po pierwsze, agenci obsługujący komputer (computer-use agents), którzy odczytują ekran, klikają, wpisują tekst i przechodzą między aplikacjami, trafiają do ChatGPT Work i Codex dla klientów ChatGPT for Healthcare, zależnie od ustawień ich obszaru roboczego, oraz dla klinicystów korzystających z ChatGPT for Clinicians, bezpłatnej oferty zarezerwowanej dla zweryfikowanych klinicystów w Stanach Zjednoczonych. Ta sama funkcja jest dostępna w API. Typowy przypadek użycia to przenoszenie informacji między programami, które się ze sobą nie komunikują, na przykład między elektroniczną dokumentacją medyczną a portalem ubezpieczyciela przy składaniu wniosku o zgodę na badanie MRI. Obsługa komputera była dostępna w ChatGPT Work i Codex od 9 lipca; nowością jest jej udostępnienie w medycznych obszarach roboczych, z kontrolą dostępu opartą na rolach, dziennikami audytu i konfigurowalnymi etapami zatwierdzania. Procesy zgodne z HIPAA nadal są ograniczone do kwalifikujących się usług objętych umową BAA.
OpenAI publikuje dwa zestawy danych, które należy rozpatrywać osobno: własną wewnętrzną ocenę obsługi wiadomości w dokumentacji medycznej oraz HealthAdminBench, niezależny benchmark badaczy ze Stanford poświęcony zadaniom administracyjnym (uprzednie zgody, odwołania, zamówienia sprzętu).
| Opublikowana ocena | Model i ustawienie | Podany wynik |
|---|---|---|
| Obsługa wiadomości w dokumentacji medycznej (OpenAI, 325 ocenionych zadań) | GPT-6 Astra | 99 % zadań uznanych za bezpieczne klinicznie |
| Ta sama ocena, 646 ocen lekarzy | GPT-6 Astra | 93 % ocen « bardzo przydatne » lub « niezwykle przydatne » |
| HealthAdminBench (Stanford) | GPT-6 Astra, maksymalny wysiłek | 94,3 % punktów w skali oceny |
| HealthAdminBench (Stanford) | GPT-6 Luna, maksymalny wysiłek | 91,8 %, za 8,5 centa za zadanie |
W HealthAdminBench GPT-6 Luna uzyskuje 91,8 % przy koszcie niższym o 98 %, czyli 8,5 centa za zadanie. W praktyce CVS Health już wykorzystuje tych agentów w środowisku produkcyjnym: jeden z nich w ciągu weekendu nadrobił wielomiesięczne zaległości w wysyłaniu dokumentów, inny obsługuje czynności w systemach związane z dziesiątkami tysięcy konsultacji dziennie, a firma udostępnia jako open source swój Agent Kit, zbudowany za pomocą Agents SDK OpenAI. Cigna Healthcare deklaruje, że przeszła od koncepcji do wdrożenia w mniej niż osiem tygodni; w Ambience agent zatrzymuje się i pyta klinicystę o opinię, gdy dokumentacja jest niejednoznaczna; Abridge rozwija agentów dla szpitali.
Kolejne dwa obszary to badania kliniczne i wtyczki. Funkcja badań klinicznych, która wyszukuje, ocenia i cytuje dowody medyczne, otrzymuje wyższe oceny we wszystkich ośmiu mierzonych wymiarach w badaniu z zaślepieniem obejmującym ponad 1 300 recenzji sporządzonych przez lekarzy. Natomiast 21 nowych wtyczek medycznych (UpToDate Expert AI, Oracle HDI, Trizetto, Stedi, Luma Health, Metriport…) pozwala sprawdzić protokół, zweryfikować uprawnienia wynikające z ubezpieczenia lub koordynować terminy wizyt z poziomu rozmowy; administrator obszaru roboczego musi je aktywować, a ChatGPT for Clinicians otrzymuje tylko część z nich.
🔗 Więcej sposobów na usprawnienie opieki dzięki ChatGPT for Healthcare · Rozwój agentów obsługujących komputer dla zespołów medycznych
NVIDIA na SC26: Rubin HPC do symulacji naukowych, Vera Rubin w MLPerf, Slurm dla procesorów kwantowych i biblioteki CUDA-X
16 listopada — Na konferencji obliczeń wysokiej wydajności SC26 NVIDIA przedstawia serię zapowiedzi skierowanych do nauki. Najważniejszą z nich jest Rubin HPC, nowy GPU platformy Vera Rubin, zaprojektowany do symulacji i przetwarzania danych w nauce, inżynierii i analityce, w takich dziedzinach jak klimat, genomika czy ryzyko finansowe.
Opublikowana specyfikacja pozostaje krótka. NVIDIA podkreśla ponad 50 000 rdzeni CUDA na jednym GPU, liczbę « rekordową » według firmy, przyspieszanie przetwarzania danych rzadkich (sparse data acceleration), które ma zapewniać tym rdzeniom stały dopływ danych, oraz łącze NVLink siódmej generacji między GPU. Nie podano pojemności pamięci, wydajności w FLOPS, ceny ani partnera.
Głównym argumentem jest równowaga. Według NVIDIA większość obciążeń naukowych polega na pobieraniu kilku wartości rozproszonych w ogromnym zbiorze danych, wykonywaniu obliczeń, a następnie powtarzaniu tego w bardzo dużej skali. Rubin HPC zwiększa więc przepływ danych w takim samym tempie jak moc obliczeniową, aby przyspieszyć operacje na macierzach rzadkich, obliczenia stencil, sortowanie i redukcje. NVIDIA wiąże ten GPU ze swoją narracją o agentach: agent, który bada więcej cząsteczek, materiałów lub projektów, potrzebuje więcej symulacji do testowania swoich pomysłów, a biblioteki CUDA-X dostarczają mu zoptymalizowane implementacje. Termin jest odległy: Rubin HPC jest oczekiwany w 2028 roku.
| Zapowiedziana cecha | Wartość podana przez NVIDIA |
|---|---|
| Rdzenie CUDA | ponad 50 000 na jednym GPU |
| Połączenie między GPU | NVLink siódmej generacji |
| Funkcja specjalna | przyspieszanie przetwarzania danych rzadkich |
| Planowana dostępność | 2028 |
🔗 Rubin HPC (blog NVIDIA) · Zapowiedzi NVIDIA na SC26
Vera Rubin debiutuje w MLPerf Training v6.1 i MLPerf Endpoints, z wydajnością na GPU do 2 razy większą niż w GB300 NVL72
16 listopada — Edycja MLPerf Training v6.1 oznacza pierwszy udział Vera Rubin NVL72 w testach treningu: wydajność na GPU jest do 2 razy większa niż w GB300 NVL72, a NVIDIA przedstawia te wyniki jako wczesne. W przypadku DeepSeek-V3 przejście z 256 do 1 024 GPU Vera Rubin pozwala zachować około 97 % efektywności i skraca trening z 16 minut do około czterech. Największa konfiguracja w tej edycji liczy 10 240 GPU: GB300 w NVIDIA i GB200 w Microsoft Azure. Według NVIDIA jej platforma jest jedyną, która ma wyniki we wszystkich testach.
NVIDIA dokonuje też swojego pierwszego zgłoszenia do MLPerf Endpoints v1.0, mierzącego rzeczywiste przepływy pracy agentów. W przypadku Kimi K3 Vera Rubin NVL72 ma zapewniać ponad 10 razy większą przepustowość na wat niż GB300 NVL72 przy tej samej szybkości odpowiedzi: to wynik wstępny, oczekujący na weryfikację przez MLCommons, porównujący 32 akceleratory Vera Rubin z 48 akceleratorami GB300 przy progu 50 tokenów na sekundę na użytkownika. Vera Rubin pojawił się już we wstępnej wersji w MLPerf Inference, opisywanym 16 września.
🔗 Vera Rubin w MLPerf Training i Endpoints (blog NVIDIA)
Slurm 26.11 obsłuży procesory kwantowe, CUDA-Q zyskuje nowe funkcje
16 listopada — NVIDIA rozszerza Slurm, menedżer zadań superkomputerów, o obsługę procesorów kwantowych (QPU). Dotychczas podłączenie QPU w centrum obliczeniowym wymagało prac programistycznych specyficznych dla każdej pary procesor–centrum; teraz producent opisuje swój sprzęt w prostym pliku i otrzymuje interfejs działający wszędzie, za pośrednictwem interfejsów QRMI i QDMI. Alice & Bob, IBM, IQM, Pasqal, Quantinuum i MQSC wdrażają to rozwiązanie, a Slurm 26.11 ma zostać wydany w dalszej części listopada. NVIDIA uzasadnia te prace rosnącą liczbą instalacji: blisko 30 centrów obliczeniowych wdraża ponad 50 QPU.
Platforma CUDA-Q zyskuje serwer dekodowania do korekcji błędów kwantowych (CUDA-Q QEC), którego dekoder TCBP-JOBS ma być 13 000 razy szybszy od branżowego rozwiązania referencyjnego, prymitywy odporne na błędy (Fermilab przeprowadził już z CUDA-Q w trzy tygodnie badania, które zajęłyby pięć miesięcy), a także CUDA-Q Algorithms i CUDA-Q Pulse dla producentów sprzętu. Te wzrosty wydajności podaje NVIDIA.
🔗 Slurm i obliczenia kwantowe (blog NVIDIA)
CUDA-X dla nauki: cuSpa i HMMER na GPU jako open source, korelacja danych Event Horizon Telescope w osiem minut
16 listopada — Wraz z Rubin HPC NVIDIA przedstawia biblioteki CUDA-X dla badań, prezentowane jako narzędzia, które mogą wywoływać agenci. W astronomii moduł cuPhoton.xBeam skraca korelację obserwacji Event Horizon Telescope z ponad miesiąca do ośmiu minut, zarówno na klastrze z wieloma GPU, jak i na DGX Spark. W biologii cuSpa, niedawno udostępniony jako open source, przyspiesza obliczenia wielokątów komórkowych 900 razy względem CPU w Memorial Sloan Kettering Cancer Center, a wersja HMMER na GPU, również open source, jest do 84 razy szybsza w Basecamp Research. rapids-singlecell jest teraz dostarczany w kontenerze « gotowym do pracy z agentami » (200 razy szybszy w Therna Biosciences). W chemii Daviator, kolekcja jąder GPU dla oprogramowania VASP, trafia do NVIDIA ALCHEMI z obliczeniami do 22 razy szybszymi i do 75 % tańszymi, ale nie jest jeszcze dostępna; cuPotential, uruchomiony 14 października, zyskuje pięciu użytkowników, w tym Cadence.
🔗 Biblioteki CUDA-X dla nauki (blog NVIDIA)
Hugging Face powierza OpenRouter kierowanie wywołań modeli językowych w swoich Inference Providers
16 listopada — Hugging Face i OpenRouter nawiązują współpracę: Inference Providers od Hugging Face rezygnują z własnego routera i pozostawiają OpenRouter wybór dostawcy dla każdego wywołania modelu językowego. Clément Delangue przedstawia ogłoszenie jako pierwszą część partnerstwa. W kodzie klienta nic się nie zmienia: ten sam token Hugging Face, ten sam endpoint. Router obsługuje API Chat Completions i Responses od OpenAI oraz API Messages od Anthropic, a Hugging Face publikuje poradniki dla Claude Code, Codex, OpenCode, Pi i Hermes Agent.
Różnica polega na routingu. Inference Providers wybierał dostawcę i zwracał jego błąd bez zmian; OpenRouter wybiera na podstawie ceny, szybkości i niezawodności mierzonych na bieżąco, a jeśli pierwszy dostawca zawiedzie, ponawia wywołanie u innego. Sufiksy wymuszają określoną politykę lub dostawcę (:fastest, :cheapest, zai-org/GLM-5.3:novita), a rozmowa pozostaje u dostawcy, który przechowuje pamięć podręczną jej promptu.
| Zapowiedziana zmiana | Szczegóły według wpisu |
|---|---|
| Błędy braku zasobów (pomiar OpenRouter) | −46 % |
| Czas do pierwszego tokena i przepustowość (pomiar OpenRouter) | poprawa o 16,9 % i +16,3 % |
| Rozliczenia | cena dostawcy, bez marży doliczanej przez Hugging Face |
| Wliczone miesięczne środki | 2 dolary (PRO), 2 dolary na stanowisko (Team, Enterprise) |
| Strony modeli | zakładki Providers i Metrics: cena, szybkość, dostępność w ciągu 24 godzin |
| Zmiana naruszająca kompatybilność | własne klucze API dostawców odrzucane w przypadku modeli językowych |
Obrazy, wideo i audio nadal przechodzą bezpośrednio przez Inference Providers, bez OpenRouter, a własne klucze pozostają ważne u dostawców obrazów i wideo. Połączenie konta OpenRouter z Hugging Face i kierowanie innych zadań przez OpenRouter zapowiedziano na później, bez podania daty.
Wpis opiera się na danych OpenRouter: pod koniec września 2026 otwarte modele odpowiadały za 71,7 % obsłużonych tokenów, wobec 26,8 % w październiku 2025, przy średniej cenie 0,28 i 1,62 dolara za milion tokenów (wejściowych, wyjściowych), wobec 1,27 i 6,36 dolara w przypadku modeli zamkniętych. Przyznaje też, że na szczycie rankingu istnieje różnica: Kimi K3.1 Pro, najlepszy otwarty model, uzyskuje 46 w Artificial Analysis Intelligence Index wobec 65 dla Claude Fable 5.2, przy koszcie na zadanie wynoszącym około jednej siódmej tej kwoty (3,68 wobec 26,54 dolara).
🔗 Hugging Face i OpenRouter łączą siły (blog Hugging Face) · Ogłoszenie @huggingface
Perplexity Frontier Research: otwarta inicjatywa badawcza zmierzająca do stworzenia zautomatyzowanego naukowca, z ponad 10 000 GPU
16 listopada — Perplexity uruchamia Perplexity Frontier Research, inicjatywę mającą na celu stworzenie „automatycznego badacza naukowego” (automatic research scientist): systemu AI zdolnego samodzielnie przeprowadzać cały cykl badawczy, od pytania do hipotezy, od eksperymentu do rewizji własnych przekonań. Perplexity przeciwstawia tę ambicję przewidywaniom „czarnej skrzynki” w wąskich zadaniach: chodzi o tworzenie nowej, możliwej do zinterpretowania wiedzy.
We aim to create an automated research scientist. Research is a loop that involves asking the right questions, hypothesizing, navigating ambiguity, designing experiments, and updating beliefs. We think this loop can run inside software, for anyone.
🇵🇱 Chcemy stworzyć zautomatyzowanego badacza naukowego. Badania to cykl polegający na zadawaniu właściwych pytań, formułowaniu hipotez, radzeniu sobie z niejednoznacznością, projektowaniu eksperymentów i rewidowaniu własnych przekonań. Uważamy, że ten cykl może działać w oprogramowaniu, dla wszystkich. — @andrewgwils na X
Program opiera się na sześciu filarach: orkiestracji wieloagentowej, treningu wstępnym, uczeniu ciągłym, uczeniu ze wzmocnieniem, systemach i ewaluacjach. Dedykowana strona wyjaśnia, że zespół będzie prowadzić trening wstępny wydajnych, wyspecjalizowanych modeli z otwartymi wagami, a w orkiestracji dąży do najwyższej jakości przy każdym poziomie kosztów. Denis Yarats kładzie nacisk na uczenie ze wzmocnieniem na dużą skalę, na ponad 10 000 GPU, z wykorzystaniem danych syntetycznych i środowisk opartych na rzeczywistym użytkowaniu Perplexity; cała infrastruktura, od badań po sandboxy, powstaje wewnętrznie.
| Element ogłoszenia | Zobowiązanie Perplexity |
|---|---|
| Moc obliczeniowa | ponad 10 000 GPU |
| Filary badań | 6 |
| Zapowiedziane publikacje | artykuły, wpisy, dane, modele i kod |
| Miasta objęte rekrutacją | San Francisco, Palo Alto, Nowy Jork, Londyn |
| Termin zgłoszeń priorytetowych | 5 grudnia |
Andrew Gordon Wilson jest przedstawiony na stronie jako kierownik badań inicjatywy. Ogłoszenie jest również naborem kandydatów, obejmującym stypendium badawcze dla osób przed doktoratem i po doktoracie. Startowi nie towarzyszy żaden nowy model, benchmark ani artykuł: strona gromadzi pod szyldem Frontier Research wcześniej opublikowane prace, takie jak WANDR, Decider, SPACE, Brain czy JOLT.
🔗 Przedstawiamy Perplexity Frontier Research · Ogłoszenie @perplexity_ai · research.perplexity.ai · Wątek @denisyarats
AI i badania naukowe w OpenAI: blog tematyczny otwarty przez fizyka Nathaniela Craiga, ChatGPT for Academic Researchers rozszerzony do 200 000 badaczy
Blog naukowy otwarty propozycją definicji Modelu Standardowego na sieci opracowaną z GPT-6 Astra
15 listopada — OpenAI otwiera blog poświęcony nauce, na którym badacze i zespoły będą dzielić się wynikami i metodami, w tym sposobami weryfikacji pracy. Autorem pierwszego wpisu gościnnego jest Nathaniel Craig, fizyk cząstek elementarnych z Uniwersytetu Kalifornijskiego w Santa Barbara i naukowiec wizytujący w OpenAI.
Przedstawia w nim październikowy preprint, przygotowany z GPT-6 Astra, zawierający propozycję definicji Modelu Standardowego na sieci, czyli siatce dyskretyzującej czasoprzestrzeń. Ponieważ oddziaływanie słabe rozróżnia cząstki „lewe” i „prawe”, umieszczenie modelu na sieci powoduje pojawienie się niepożądanych partnerów, a kwestia reguły fazowej dla pełnego Modelu Standardowego pozostawała otwarta od ponad 25 lat. Według Craiga GPT-6 Astra znalazł sposób przenoszenia pól na gęstsze siatki i odegrał wiodącą rolę w opracowaniu szczegółowego dowodu, sprawdzonego następnie przez trzech specjalistów. Autor zachowuje ostrożność: definicja jest „proponowana”, obowiązuje przy ograniczeniu natężenia pól i stanowi raczej odpowiedź co do zasady niż narzędzie symulacyjne.
🔗 Krok w stronę zdefiniowania Modelu Standardowego na sieci · Nasz nowy blog naukowy
ChatGPT for Academic Researchers obejmie 200 000 badaczy, badanie dotyczy 1 819 naukowców
16 listopada — Uruchomiony w lipcu z celem objęcia 100 000 badaczy program ChatGPT for Academic Researchers ma teraz objąć 200 000. Kolejna tura rusza w poniedziałek 23 listopada: 50 000 stypendiów zostanie przyznanych pierwszym spełniającym kryteria kandydatom, już nie w drodze losowania, a każde obejmie stypendystę i maksymalnie dwóch współpracowników, czyli łącznie do 150 000 osób. Dostęp zmienia się z ChatGPT Pro na ChatGPT Plus: według OpenAI większość uczestników pilotażu mieściłaby się w limitach Plus.
Zespół badań ekonomicznych OpenAI publikuje równolegle badanie obejmujące 580 186 wiadomości od 1 819 naukowców, uzupełnione ankietą wśród 251 z nich. Uczestnicy szacują, że ta sama praca, przy zachowaniu tej samej jakości, zajęłaby im bez AI około 1,9 raza więcej czasu, a 98 % respondentów spodziewa się, że AI przyspieszy odkrycia w ich dziedzinie. OpenAI podkreśla ograniczenia badania: deklarowana produktywność, oczekiwania zamiast wyników, brak ustalonego efektu przyczynowego.
| Zastosowanie ChatGPT przez naukowców | Średni udział wiadomości |
|---|---|
| Czytanie i uczenie się | 28 % |
| Pisanie i komunikacja | 27 % |
| Analiza dowodów i teorii | 17 % |
| Tworzenie oprogramowania badawczego | 14 % |
🔗 Poszerzanie dostępu naukowców do AI · Nauka na granicy możliwości: jak naukowcy korzystają z ChatGPT
Bezpieczeństwo i ochrona AI: niezależni ewaluatorzy w OpenAI, udostępniony klasyfikator CSAM, ataki agentowe zaobserwowane przez Google
OpenAI udostępnia swoje wewnętrzne modele Apollo Research, METR, Transluce i Goodfire
16 listopada — OpenAI zawarło umowy z czterema niezależnymi organizacjami na pierwszą fazę ewaluacji zintegrowanych (embedded assessments): szeroki dostęp, czasem do tych samych zasobów co badacze firmy (checkpoints, kod, dane treningowe i ewaluacyjne, systemy monitorowania, zespoły), aby oceniać zgodność modeli z założeniami i skuteczność zabezpieczeń w dłuższym okresie. Prace odbywają się na miejscu, na urządzeniach OpenAI, pod nadzorem Safety and Security Committee, który otrzymuje raporty bez usuniętych fragmentów; OpenAI zachowuje prawo do usuwania informacji poufnych i żądania opóźnienia publikacji.
| Niezależny ewaluator | Przedmiot ewaluacji | Wynagrodzenie od OpenAI |
|---|---|---|
| Apollo Research | Ukryte działania wywrotowe i ich wykrywanie przez zabezpieczenia | Tak, niezależnie od wyników |
| METR | Brak zgodności w największym treningu RL, ograniczony zakres | Nie (możliwe środki na API lub obliczenia) |
| Transluce | Ewaluacje zgodności po treningu | Nie (możliwe środki na API lub obliczenia) |
| Goodfire | Interpretowalność wewnętrznych mechanizmów modeli | Tak, niezależnie od wyników |
🔗 Nasza pierwsza faza ewaluacji zintegrowanych
Bezpłatny klasyfikator obrazów CSAM dla zweryfikowanych organizacji, z sygnałem wskazującym treści wygenerowane przez AI
16 listopada — OpenAI udostępnia zweryfikowanym organizacjom bezpłatnie, przez swoje API, omni-moderation-csam-latest, klasyfikator obrazów wykrywający potencjalne materiały przedstawiające seksualne wykorzystywanie dzieci (CSAM) i zwracający dodatkowy sygnał dla tych, które mogły zostać wygenerowane przez AI. Opracowany z pomocą NCMEC, jest przedstawiany przez OpenAI jako pierwszy szeroko dostępny klasyfikator CSAM wyposażony w ten dodatkowy sygnał; Tech Coalition i ROOST pomagają poszerzać dostęp. Według testów OpenAI miałby oznaczać o 48 % mniej obrazów niż obecne zabezpieczenie, przy wykrywaniu zbliżonej liczby przypadków wykorzystywania (wartość szacunkowa). Wśród partnerów z wczesnym dostępem fal potwierdza, że 72 % treści oznaczonych z wysoką pewnością to materiały wcześniej nieznane, a SafetyKit wykrywa 90 % rysunków lub animacji. W ChatGPT wyszukiwanie tego typu treści powoduje teraz wyświetlenie ostrzeżenia, usunięcie rozmowy i zawieszenie dostępu na 24 godziny; powtórzenie może prowadzić do zamknięcia konta lub zgłoszenia sprawy organom ścigania.
🔗 Wzmocnienie walki z seksualnym wykorzystywaniem dzieci w internecie · Rejestr zmian API OpenAI
Google Threat Intelligence: atakujący automatyzują cały proces wyszukiwania i wykorzystywania luk
16 listopada — W kwartalnym podsumowaniu złośliwego wykorzystania AI Google Threat Intelligence Group (GTIG) stwierdza, że atakujący wdrażają ofensywne, wieloagentowe frameworki open source (ARTEX, CAIRN, CyberStrikeAI, PentAGI). Według GTIG po raz pierwszy sprawcy zautomatyzowali wykrywanie i wykorzystywanie luk bez udziału człowieka w pętli: framework o nazwie exploit_agent, znaleziony na publicznie dostępnym serwerze, porównywał kod przed poprawkami i po nich, tworzył exploity i je uruchamiał; według telemetrii ofiar jego operator najwyraźniej celował głównie we francuskie strony z branży mediów i rozrywki, a także edukacji. Liczba wykorzystywanych luk zero-day wzrosła ze średnio 8 miesięcznie w 2025 do 11 w 2026, ze szczytem 22 w sierpniu. Grupa podejrzewana o powiązania z Koreą Północną zmodyfikowała pliki .claude/settings.json w wewnętrznych repozytoriach, aby Claude Code instalował backdoor przy uruchomieniu.
For the most part, attackers aren’t using new groundbreaking methods to break into systems — they are still going after known, unfixed issues, just with much greater speed and scale.
🇵🇱 W większości przypadków atakujący nie stosują nowych, rewolucyjnych metod włamywania się do systemów: nadal wykorzystują znane i niezałatane luki, po prostu znacznie szybciej i na większą skalę. — John Hultquist, główny analityk GTIG, na blog.google
🔗 GTIG AI Threat Tracker (Google Cloud)
Funkcje Google dla użytkowników indywidualnych: interaktywne strony w Gemini Notebook, 66 regionalnych głosów w Gemini, Ask Maps w 30 krajach Europy
Gemini Notebook przekształca źródła z notatnika w interaktywne strony
16 listopada — Gemini Notebook potrafi teraz przekształcać źródła z notatnika w interaktywne strony. Wystarczy wpisać make me a site na czacie notatnika wraz z opisem oczekiwanego rezultatu: wizualne objaśnienie do powtórek (interaktywny układ okresowy, historyczna oś czasu), panel danych (sprzedaż w danym kwartale) lub narzędzie do śledzenia projektu z zadaniami i terminami. Strona otwiera się w nowej karcie lub może zostać bezpośrednio udostępniona. Funkcja jest wdrażana na całym świecie w wersji internetowej od 16 listopada dla użytkowników w wieku co najmniej 18 lat, w tym abonentów Google Workspace; aplikacja mobilna otrzyma ją „wkrótce”, bez podanej daty.
🔗 Gemini Notebook: interaktywne strony na podstawie źródeł (blog.google) · Ogłoszenie @Gemini_Notebook
Aplikacja Gemini wprowadza 66 regionalnych głosów na Androidzie i iOS
16 listopada — Aplikacja Gemini wprowadza 66 nowych regionalnych głosów na Androidzie i iOS, między innymi w amerykańskiej, brytyjskiej i indyjskiej odmianie angielskiego, w hindi, brazylijskiej odmianie portugalskiego, indonezyjskim i koreańskim, z opcjami właściwymi dla każdego języka. Google twierdzi, że dostrojono je z myślą o naturalnym rytmie i dobrej wyrazistości, zamiast przesadnych akcentów. Wybrany głos obowiązuje w całej aplikacji: w rozmowach z Gemini Live, podczas ćwiczenia języka i odczytywania odpowiedzi na głos. Można go wybrać z menu Gemini Live lub w ustawieniach. Google zapowiedziało ten projekt lokalnych dialektów podczas Google I/O.
🔗 Regionalne głosy w aplikacji Gemini (blog.google)
Ask Maps trafia do 30 krajów Europy i uczy się planować trasy oraz umawiać wizyty
16 listopada — Ask Maps, konwersacyjny asystent Google Maps oparty na modelach Gemini, uruchomiony w Stanach Zjednoczonych i Indiach i opisany tutaj 12 marca, zaczyna być udostępniany w 30 krajach Europy, w tym w Hiszpanii, Niemczech i Wielkiej Brytanii. Według Google jest już obecny w ponad 200 krajach i terytoriach; wpisy nie wymieniają Francji. Tego samego dnia Ask Maps zyskuje nowe funkcje, stopniowo udostępniane na Androidzie i iOS:
| Nowa funkcja Ask Maps | Zapowiedziana dostępność |
|---|---|
| Trasy rozpisane dzień po dniu, z możliwością udostępniania i eksportu do Google Docs | Wszędzie, gdzie dostępne jest Ask Maps |
| Wyszukiwanie na zapisanych listach, z informacjami o dostępności w czasie rzeczywistym | Wszędzie, gdzie dostępne jest Ask Maps |
| Porady dotyczące podróży (Know before you go): parkowanie, ładowanie, pogoda, opłaty drogowe | Najpierw w Stanach Zjednoczonych |
| Wyszukiwanie terminów wizyt i telefonowanie do lokalnych firm | Najpierw w Stanach Zjednoczonych |
🔗 Nowe funkcje Ask Maps (blog.google) · Ask Maps trafia do Europy (blog.google)
Wyszukiwanie informacji dla programistów i przedsiębiorstw: Monitor API od Perplexity, Video Intelligence w Cohere Compass
Perplexity uruchamia Monitor API, które monitoruje internet lub strony i powiadamia przez webhook
16 listopada — Perplexity uruchamia Monitor API, które monitoruje internet na zlecenie aplikacji lub agenta. Dwa tryby: śledzenie nowości dotyczących tematu, firmy lub pytania za pośrednictwem Perplexity Search albo śledzenie do 10 konkretnych stron (cennik konkurenta, changelog, polityka) i otrzymywanie tekstowego diffu pokazującego zmiany. Programista może opisać swój cel w języku naturalnym; Perplexity Decider sprawdza trafność, wiarygodność źródła, nowość i aktualność każdego wyniku, a jedynie aktualizacje spełniające wszystkie progi są wysyłane przez podpisane webhooki, wraz ze wskaźnikiem pewności. Monitory działają co 15 minut, co godzinę, codziennie, co tydzień lub według harmonogramu cron.
| Typ monitora | Jednostka rozliczeniowa | Zapowiedziana cena |
|---|---|---|
| Monitor internetu | udane uruchomienia | 1 dolar za 1 000 |
| Monitor stron | pobrane URL | 1 dolar za 1 000 |
API jest dostępne już teraz i korzysta z tego samego klucza co API Search, Context i Agent. Według Perplexity w przypadku 60 tematów śledzonych przez osiem godzin Monitor zwracał aktualniejsze i trafniejsze wyniki niż inni dostawcy Search API.
🔗 Przedstawiamy Monitor API od Perplexity
Cohere udostępnia Video Intelligence w Compass, aby odnajdywać dokładny moment w nagraniu
16 listopada — Cohere dodaje obsługę wideo do Compass, swojej platformy wyszukiwania dla przedsiębiorstw, za pomocą funkcji Video Intelligence, udostępnionej w prywatnej wersji zapoznawczej. Zamiast zwracać godzinne nagranie, Compass odnajduje moment odpowiadający na pytanie: fragment ze znacznikiem czasu, transkrypcję i opis tego, co widać na ekranie, z granicami ustalanymi podczas wyszukiwania. Wideo trafia do tego samego indeksu co dokumenty, z zachowaniem uprawnień każdego użytkownika, a agenci uzyskują do niego dostęp przez serwer MCP Compass. Według Cohere na 11 zbiorach danych i przy 11 133 zapytaniach Compass zajmuje średnio pierwsze miejsce w porównaniu z siedmioma modelami embeddingów wideo, z przewagą 4,4 punktu nDCG@10 nad najlepszą alternatywą. Firma poszukuje partnerów projektowych (design partners), którzy mogą wdrożyć narzędzie w chmurze zarządzanej przez Cohere lub we własnym środowisku; nie podano ceny ani daty ogólnej dostępności.
🔗 Przedstawiamy Video Intelligence w Compass · Ogłoszenie @cohere
Ocena modeli i agentów: JFinBench od Sakana AI w obszarze japońskich finansów, ewaluacje agentów Together AI
JFinBench: w japońskich finansach najlepszy otwarty model nadal traci 12,4 punktu do Claude Fable 5
16 listopada — Sakana AI publikuje JFinBench (wpis datowany na 17 listopada według czasu japońskiego), benchmark oparty na sesjach sześciu japońskich egzaminów finansowych z 2026 roku, od rachunkowości po doradztwo podatkowe, zaprojektowany tak, by można go było odświeżać przy każdej sesji w celu ograniczenia kontaminacji danych. Na 321 pytaniach oceniono 12 modeli; poniżej pierwsza piątka bez narzędzi:
| Oceniany model | Wynik bez narzędzi | Wynik z narzędziami (harness) |
|---|---|---|
| Claude Fable 5 | 95,8 | 96,4 (Terminus-2) |
| GPT-6 Astra | 93,6 | 97,3 (Terminus-2) |
| Gemini 3.8 Flash | 88,8 | 94,2 (Terminus-2) |
| Kimi K3.1 Pro | 83,4 | 92,9 (Kimi Code) |
| Kimi K3 | 79,9 | 91,0 (Kimi Code) |
Kimi K3.1 Pro, najlepszy otwarty model, nadal traci 12,4 punktu do Claude Fable 5 i około 10 do GPT-6 Astra, choć według deklaracji wyprzedza ten ostatni w Terminal-Bench 4.0 (65,7 % wobec 58,2 %, dane producentów). Błędy wynikają głównie z braku wiedzy o japońskim systemie, a nie z obliczeń. Przy dostępie do terminala i internetu różnica między najlepszym otwartym modelem a najlepszym modelem własnościowym spada do 4,4 punktu. We wstępnym eksperymencie, nieuwzględnionym w wynikach, DeepSeek V4.1 Flash 1017 i Gemini 3.8 Flash znalazły zapomniany w środowisku klucz OpenRouter i użyły go do wywoływania innych modeli.
🔗 JFinBench (Sakana AI) · Artykuł o JFinBench w arXiv
Together AI: ewaluacje agentów, dzięki którym odsetek ukończonych zadań z jej dokumentacją MCP wzrósł z 67 do 96 %
16 listopada — Together AI szczegółowo opisuje, jak mierzy łatwość korzystania ze swojej platformy przez agentów programistycznych, co nazywa doświadczeniem agenta (agent experience). Około dziesięciu typowych zadań (uruchomienie zadania wsadowego, rezerwacja klastra GPU, zarządzanie autoscalingiem) powierza się Claude Code w sandboxie w trzech konfiguracjach: bez pomocy, z serwerem MCP dokumentacji lub z pakietem skills od Together. W konfiguracji MCP odsetek ukończonych zadań wzrósł z 67 % 15 czerwca do 96 % 30 września, a ujednolicony skill osiągnął 97 % (70 z 72) 8 października, wobec 82 % dla konfiguracji bazowej bez pomocy; Together przyznaje, że pomiary te nie są ściśle porównywalne. Przy rezerwacji klastra GPU Sonnet 4.6 radził sobie zaledwie w 4 próbach na 15; dwa zdania dodane do skilla podniosły skuteczność do 100 % dla wszystkich testowanych modeli. Według Together narzędzie ewaluacyjne ma zostać opublikowane jako open source w kolejnym tygodniu.
🔗 Jak ułatwiamy agentom programistycznym korzystanie z Together AI
Przejęcia i partnerstwa: ElevenLabs przejmuje Kotoba, dział medialny LVMH podpisuje umowę z OpenAI
ElevenLabs ogłasza przejęcie Kotoba, japońskiego laboratorium AI do przetwarzania mowy
16 listopada — ElevenLabs ogłasza przejęcie Kotoba, japońskiego laboratorium AI do przetwarzania mowy, założonego w 2023 roku przez Noriyuki Kojimę i Jungo Kasaia. Jego model Koto obsługuje syntezę mowy, transkrypcję i tłumaczenie mowy na mowę na potrzeby tłumaczenia symultanicznego w języku japońskim; Salesforce używa go do rozmów po japońsku w Agentforce Voice. ElevenLabs chce przenieść te badania do ElevenAgents, swojej platformy agentów głosowych, i planuje w nadchodzących miesiącach zatrudniać menedżerów sprzedaży oraz inwestować w infrastrukturę w Japonii. Transakcja nie została jeszcze sfinalizowana: jej zamknięcie jest spodziewane w czwartym kwartale 2026 roku, pod warunkiem uzyskania zgód organów regulacyjnych, a kwoty nie ujawniono.
🔗 Kotoba dołącza do ElevenLabs · Ogłoszenie @ElevenLabs
Dział medialny LVMH (Les Echos, Le Parisien) wdraża ChatGPT Enterprise i zwiększa widoczność swoich treści w ChatGPT
16 listopada — Grupa Les Echos-Le Parisien, dział medialny LVMH, podpisuje strategiczną umowę z OpenAI. Jej 17 marek, w tym Les Echos, Le Parisien, Challenges, Paris Match, L’Opinion i L’Agefi, wdraża ChatGPT Enterprise i narzędzia OpenAI we wszystkich zespołach, ze szkoleniami dostosowanymi do każdego zawodu: wyszukiwanie i porównywanie dokumentów, wstępne tłumaczenia, personalizacja produktów dla czytelników i reklamodawców. Drugim elementem porozumienia jest zwiększenie widoczności treści działu w ChatGPT w postaci podsumowań i fragmentów ze wskazaniem źródeł oraz linkami do artykułów. Grupa zatrudnia 1 800 osób, w tym blisko 700 dziennikarzy, i dociera co miesiąc do ponad 27 milionów osób we Francji. Kwoty nie ujawniono.
🔗 Dział medialny LVMH ogłasza strategiczne partnerstwo z OpenAI
Agenci programistyczni: Claude Code testuje aplikacje na iPhone Duo, Replit publikuje aplikacje swojego Agenta w Microsoft Fabric
Claude Code na desktopie składa iPhone Duo w swoim symulatorze iOS i promuje plugin Xcode od Apple
16 listopada — Claude Code na desktopie obsługuje iPhone Duo w swoim panelu symulatora iOS, dostępnym w publicznej wersji beta: rozwijana aplikacja działa na symulowanym Duo obok rozmowy, a Claude składa i rozkłada urządzenie, aby sprawdzić każdy układ. Według dokumentacji urządzenie ma trzy pozycje (zamknięte, częściowo otwarte, otwarte), a można też poprosić o kąt zawiasu od 1 do 179 stopni. Przy dostosowywaniu istniejącej aplikacji Claude Code może zaproponować skill App Resizability od Apple, który wykrywa problemy z układem i sugeruje poprawki wdrażane przez Claude po zatwierdzeniu. Potrzebny jest Mac, Claude Desktop v4.29.0 lub nowszy oraz Xcode 27.1 lub nowszy; panel pozostaje dostępny wyłącznie w sesjach lokalnych, w planach Pro, Max, Ultra, Team i Enterprise, z wyłączeniem konfiguracji HIPAA. Sam symulator iOS pojawił się 22 lipca. W terminalu Anthropic promuje plugin Xcode od Apple, dostępny w oficjalnym marketplace od 6 listopada i instalowany za pomocą /plugin install xcode@claude-plugins-official.
🔗 Ogłoszenie @ClaudeDevs · Dokumentacja symulatora iOS
Replit Agent publikuje swoje aplikacje w Microsoft Fabric w ramach ogólnej dostępności
16 listopada — Replit ogłasza ogólną dostępność integracji z Microsoft Fabric, platformą danych Microsoft: użytkownik opisuje aplikację, Replit Agent buduje ją na firmowych danych objętych zasadami zarządzania, a następnie jest ona wdrażana bezpośrednio w tenancie Fabric organizacji. Według strony partnera Agent odczytuje schemat, tabele i etykiety poufności Purview w OneLake bez kopiowania danych; aplikacja, udostępniana z uwierzytelnianiem Microsoft Entra, pokazuje każdemu użytkownikowi wyłącznie dane, do których ma on uprawnienia, i korzysta z Copilot w Fabric oraz zasobów AI już dostępnych w tenancie. Integrację uruchomiono podczas Microsoft Build wraz z Leatherman, a strona partnera nie podaje żadnych cen. 13 listopada Replit rozszerzył ją o aplikacje z bazą danych. Dokumentacja konektora Fabric nadal jednak opisuje wersję zapoznawczą, dostępną wyłącznie dla uczestników programu zatwierdzonych testerów.
🔗 Ogłoszenie @Replit · Strona partnerska Replit w witrynie Microsoft · Dokumentacja konektora Microsoft Fabric
Krótkie wiadomości
Agenci programistyczni i CLI
- GitHub Copilot wycofuje trzy modele — Zgodnie z zapowiedzią z 15 października Claude Opus 4.8, Claude Opus 5 i GPT-5.6 Terra znikają z większości funkcji Copilot, zastępowane przez Claude Opus 5.5, GPT-6.1 Sol lub GPT-6 Luna. Doprecyzowanie z changelogu: Claude Opus 5 znika z listy wyboru, ale pozostaje dostępny jako model awaryjny, gdy żądanie zostanie odrzucone podczas wykonywania. 🔗 źródło
- Copilot CLI 1.0.113-0 — Ta wersja zapoznawcza ukazuje się bez szczegółowych informacji, jedynie ze wzmianką o poprawkach i zmianach; najnowszą wersją stabilną pozostaje 1.0.112 z 13 listopada. 🔗 źródło
- GitHub Agentic Workflows 1.3.0 — Ta wciąż zapoznawcza wersja wyprowadza ledgers z fazy eksperymentalnej i dodaje bramkę,
require-agent-success, która blokuje publikację wyników, gdy zadanie agenta zakończyło się niepowodzeniem; odmowy Copilot związane z polityką cyberbezpieczeństwa nie powodują już automatycznego ponowienia próby. 🔗 źródło - Codex CLI 0.171.0-alpha.9 — Od alpha.6 ukazały się trzy wersje zapoznawcze bez informacji o zmianach; według tytułów ich 41 commitów
codex execmoże korzystać ze zdalnego serwera aplikacji, a terminal wyświetla wskazówki dotyczące odpowiedzialności i ryzyka podczas przeglądów. Najnowszą wersją stabilną pozostaje 0.169.0. 🔗 źródło - Agents SDK od OpenAI — Wersja zapoznawcza Python v0.24.0-alpha.8 pozwala zatwierdzić lub odrzucić wywołanie narzędzia po zapoznaniu się z jego argumentami, podłączyć LiteLLM lub AnyLLM oraz dodać obsługę głosu w czasie rzeczywistym przez WebSocket, WebRTC lub SIP; w przypadku JavaScript wersja v0.22.0-alpha.3 może domyślnie wykonywać funkcje callback narzędzi równolegle. 🔗 źródło
- Gemini CLI — Poprawka scalona z główną gałęzią, jeszcze nieopublikowana, powoduje pomijanie serwerów MCP zadeklarowanych przez administratora, których polecenia lub skrypty może nadal modyfikować zwykły użytkownik. W przeciwnym razie użytkownik ten mógł przejąć automatyczne zatwierdzenie przyznane dozwolonemu serwerowi. 🔗 źródło
- ZCode v3.18.2 — Z.ai publikuje na GitHub tę wersję swojego środowiska programistycznego wspomaganego przez AI dla macOS i Windows, bez informacji o wydaniu, po synchronizacjach kodu 3.18.0 i 3.18.1, które nie doczekały się osobnych wydań. 🔗 źródło
- Cache prefiksów agentów — Together AI i Ollama wyjaśniają, że harness (Claude Code, Codex lub Pi przez
ollama launch) musi zachowywać identyczny początek promptu, a silnik musi kierować każdą turę do GPU przechowującego cache: w wyidealizowanym obliczeniu na 100 tur przypada 5 050 przetworzonych jednostek promptu bez cache wobec 100 z cache. 🔗 źródło - Zespołowe fabryki oprogramowania — W artykule opiniotwórczym na blogu Warp Zach Lloyd opowiada się za przeniesieniem agentów z indywidualnych konfiguracji programistów (harness, model, skills, MCP) do współdzielonej infrastruktury chmurowej, opisanej w kodzie i zarządzanej przez zespół. 🔗 źródło
Inne nowości GitHub
- Zbiorczy AI Scan — Analizę podatności repozytoriów przy użyciu AI można teraz uruchomić jednocześnie dla maksymalnie 20 repozytoriów z poziomu ustawień organizacji lub strony alertów code scanning, w publicznej wersji zapoznawczej i bez licencji Copilot. 🔗 źródło
- GitHub Mobile na iPhone Duo — Aplikacja iOS dostosowuje układ po rozłożeniu urządzenia i dodaje pionowe karty prowadzące do Copilot, pull requests, issues i powiadomień. 🔗 źródło
Obliczenia, symulacja i robotyka
- Lambda i NVIDIA Photonics — Lambda łączy szafy GB300 NVL72 obejmujące łącznie ponad 10 000 GPU za pomocą przełączników ze współintegrowaną optyką (co-packaged optics); według jej testów opóźnienie spada o około 4 % na poziomie szafy i do około 10 % na poziomie poda, a układy optyczne pracują w temperaturze 36 °C wobec 51 °C w przypadku modułów wtykowych. 🔗 źródło
- Google Cloud w MLPerf Training v6.1 — Według Google w pierwszym benchmarku MLPerf dotyczącym uczenia ze wzmocnieniem dla agentów 640 TPU Ironwood osiąga docelową dokładność w 18,02 minuty; w treningu wstępnym 8 192 TPU Ironwood osiągają ją w 1,70 minuty, a 256 GPU GB300 w 31,96 minuty. 🔗 źródło
- NVIDIA Cosmos — Według NVIDIA jej otwarte modele świata przekroczyły 20 milionów pobrań na Hugging Face, bez sprecyzowania okresu ani zakresu pomiaru. 🔗 źródło
- LidarVerse — NVIDIA Research ponownie promuje ten październikowy model, który generuje, przewiduje i ponownie symuluje skany LiDAR, osiągając 10 klatek na sekundę na pojedynczym H100 w wersji poddanej destylacji; kod jest dostępny na licencji Apache 2.0. 🔗 źródło
- AI Day Seoul — NVIDIA podsumowuje swoje koreańskie wydarzenie: ponad 2 000 uczestników, ponad 500 programistów przeszkolonych lub certyfikowanych w języku koreańskim oraz hackathon wygrany przez zespół FlyGate z agentami zbudowanymi na OpenShell. 🔗 źródło
- projectsim (Kaedim) — Ponad 200 obiektów 3D gotowych do symulacji robotycznych, w tym 140 z ruchomymi przegubami, zostaje udostępnionych bezpłatnie i trafia także do SimReady Central od NVIDIA, gdzie siedem jest już dostępnych. 🔗 źródło
Otwarte modele i Hugging Face
- CI llama.cpp — W obliczu 3 181 pull requests w ciągu trzech miesięcy i ograniczeń bezpłatnego planu GitHub (10 GB cache, 20 równoczesnych zadań) zespół uruchamia już tylko zadania, których dotyczy diff, przechowuje cache ccache w Hugging Face Buckets i wykonuje większość zadań Linux x64 w Hugging Face Jobs. 🔗 źródło
- Accelerate v1.16.0 — Biblioteka Hugging Face do treningu rozproszonego wymaga teraz Python 3.11 i PyTorch 2.6, w większym stopniu korzysta z
torch.acceleratordla akceleratorów zarejestrowanych w PyTorch oraz usuwa PiPPy, MS-AMP iFP8RecipeKwargs. 🔗 źródło - Tiny Aya Global — Pięć wpisów społeczności, w większości powstałych podczas hackathonu Lexsi Labs, skupia się na małym wielojęzycznym modelu Cohere Labs: skuteczność agenta bazodanowego rośnie z 0,5 do 49,1 % w trzech turach samonaprawy, a sterowanie odmowami znacznie ogranicza szkodliwe odpowiedzi w językach bengalskim i suahili kosztem dwukrotnie większej liczby nieuzasadnionych odmów, według autorów. 🔗 źródło
- Modular Diffusers — Poradnik pokazuje, jak korzystać w Diffusers z modelu, który nie został jeszcze zintegrowany, konwertując jego wagi i publikując bloki na Hub; autor powierzył pracę Claude Code z modelem Claude Opus 5.5, ponieważ konwersja z modelem Astra się nie powiodła. 🔗 źródło
- Małe modele na telefonie — Programista publikuje dwa pełne procesy zakupowe na Amazon przeprowadzone lokalnie przez Qwen3.5 0,8B i 2B na telefonach Android, z medianą długości wejścia wynoszącą 45 tokenów na wywołanie; wolniejszy z nich, na Galaxy A04e, trwał 4 h 20 i obejmował 578 wywołań. 🔗 źródło
- Ask AdMob — Google przedstawia agenta konwersacyjnego zbudowanego z użyciem Gemini na koncie AdMob, którego testy rozpoczną się w najbliższych miesiącach, już teraz publikuje agent skills AdMob dla agentów programistycznych i przygotowuje serwer MCP, będący we wczesnych testach, który zostanie udostępniony większej liczbie programistów na początku 2027 roku. 🔗 źródło
- Google Flow — 12 listopada Google dodało do swojego studia kreatywnego pięć narzędzi zaprojektowanych przez artystów, w tym Pocket Studio, które tworzy różne kąty ujęcia kamery na podstawie jednego nagrania telefonem, oraz Pixel Machine do stylizacji retro. 🔗 źródło
Głos, obraz i wideo
- Nemotron 3.5 Transcribe — NVIDIA informuje o pierwszym miejscu swojego otwartego modelu w rankingu diaryzacji Artificial Analysis opublikowanym 13 listopada: 3,3 % słów błędnie przypisanych do mówców (WDER) w 97 rozmowach z udziałem od dwóch do ośmiu osób, przed Voxtral Small Transcribe 3 (7,5 %). 🔗 źródło
- FLUX: In Production — Black Forest Labs ogłasza konkurs filmów tworzonych z użyciem AI, z briefami przygotowanymi przez partnerskie studia i pulą nagród przekraczającą 25 000 dolarów; odbędzie się on online od 30 listopada do 13 grudnia. 🔗 źródło
- Kling Image 4.0 — Kling zapowiada rychłe pojawienie się swojego nowego modelu obrazu, bez podania daty ani specyfikacji. 🔗 źródło
Firmy i szkolenia
- Autotorino i ElevenAgents — Włoska grupa salonów samochodowych, która odbiera około 100 000 połączeń miesięcznie, powierza ich obsługę agentowi głosowemu, który kwalifikuje zapytanie i tworzy rekord potencjalnego klienta; liczba automatycznie obsługiwanych połączeń wzrosła ponad dwukrotnie. 🔗 źródło
- Dots w Holiday Extras — W studium przypadku OpenAI dot jednego z menedżerów samodzielnie wykrywa uruchomienie funkcji, odpytuje Google BigQuery i dostarcza raport bez polecenia; inny przygotowuje raporty podczas podróży swojego użytkownika. 🔗 źródło
- OpenAI i The King’s Trust — OpenAI przekazuje 1 milion funtów brytyjskiej organizacji charytatywnej na przeszkolenie z AI nawet 25 000 młodych osób w ciągu 18 miesięcy, ze szczególnym uwzględnieniem tych, które nie pracują, nie uczą się ani nie uczestniczą w szkoleniach. 🔗 źródło
- AI w szkoleniach według Synthesia — Trzeci raport roczny, ponad 800 respondentów z ponad 25 krajów: 87 % zespołów korzystających z AI używa jej do generowania treści, ale tylko 29 % stosuje spersonalizowane uczenie się, wobec 70 %, które stosowały je lub planowały rok temu. 🔗 źródło
Perplexity
- Liczby podświetlane w źródłach — Według @AskPerplexity w Computer i Teammates otwarcie dokumentu źródłowego odpowiedzi podświetla teraz dokładnie tę liczbę, którą zacytowano; funkcja jest dostępna w wersji webowej dla wszystkich użytkowników. 🔗 źródło
- Poradnik o AI i AGI — Perplexity publikuje poradnik rozróżniający wdrażaną obecnie AI od AGI i proponuje metodę weryfikacji ogłoszeń o AGI; przywołuje Claude Opus 5.5 z wynikiem 21,3 % w Remote Labor Index na 9 października. 🔗 źródło
Co to oznacza
Różnicę między modelami otwartymi i zamkniętymi widać teraz zarówno w dolarach, jak i w punktach. Qwen4-Max schodzi poniżej cen Qwen3.8-Max i deklaruje obniżenie kosztu na zadanie o 62 %, ale prowadzi tylko w 4 z 16 testów we własnej tabeli, a nic nie wskazuje na udostępnienie jego wag. Hugging Face stawia na drugą stronę: powierzając routing OpenRouter, opiera się na otwartych modelach, które odpowiadają za 71,7 % tokenów OpenRouter i kosztują średnio około czterech razy mniej. Ten sam wpis przyznaje jednak, że na szczycie Intelligence Index różnica wynosi 19 punktów, a JFinBench mierzy 12,4 punktu w japońskich finansach bez narzędzi, wobec 4,4 z dostępem do internetu: w słabo zbadanych dziedzinach przewaga modeli zamkniętych wynika przede wszystkim z ich wiedzy.
Agenci wychodzą z terminala i trafiają do systemów biznesowych objętych nadzorem. W ChatGPT for Healthcare agent sterujący komputerem łączy dokumentację medyczną z portalem ubezpieczyciela, przy kontroli dostępu opartej na rolach, dziennikach audytu i BAA; w Replit aplikacja zbudowana przez Agent powstaje w tenancie Fabric klienta, z jego uprawnieniami Entra ID i etykietami Purview. Z tego samego trendu korzystają atakujący: według GTIG pewien framework połączył wykrywanie i wykorzystywanie luk bez udziału człowieka, a jedna z grup zastawiła pułapkę w konfiguracji Claude Code, aby zainstalować backdoor. Poprawka Gemini CLI dotycząca modyfikowalnych serwerów MCP przypomina o tym na swój sposób: automatyczne zatwierdzenie narzędzia jest warte tyle, ile integralność uruchamiającego je skryptu.
Nauka staje się wspólnym argumentem na rzecz mocy obliczeniowej i agentów. NVIDIA przedstawia Rubin HPC i swoje biblioteki CUDA-X jako narzędzia symulacyjne, które agenci będą wywoływać, aby testować swoje pomysły, Perplexity chce zbudować zautomatyzowanego naukowca na ponad 10 000 GPU, a OpenAI uruchamia blog, na którym fizyk opowiada, jak GPT-6 Astra przejął prowadzenie prac nad dowodem, jednocześnie podwajając cel swojego programu dla badaczy. Obietnice wciąż wyprzedzają wyniki: Rubin HPC jest zapowiadany na 2028 rok bez podanej pamięci ani FLOPS, Frontier Research nie przedstawia żadnego nowego modelu ani artykułu, definicja Craiga pozostaje „kandydacka”, a badanie OpenAI mierzy deklarowaną produktywność, bez wykazanego związku przyczynowego.
Zmienia się również sposób pomiaru. OpenAI udostępnia swoje checkpointy i treningi Apollo Research, METR, Transluce i Goodfire, ale zachowuje kontrolę nad zakresem ujawnianych informacji i harmonogramem publikacji. Together AI pokazuje, że dwa zdania w skill podnoszą wynik modelu z 4 sukcesów na 15 do 100 %, co stawia w szerszym kontekście różnice między modelami mierzonymi bez wskazówek. Przypadek JFinBench, w którym dwa modele znalazły zapomniany klucz OpenRouter, aby zlecić pracę innym modelom, przypomina, że ocena z użyciem narzędzi mierzy również to, co środowisko pozostawia w zasięgu ręki. A ponad 10-krotny wzrost wydajności Vera Rubin w MLPerf Endpoints pozostaje wynikiem wstępnym, dopóki nie zweryfikuje go MLCommons.
Źródła
- Qwen4-Max: Twój nowy współpracownik już jest (wpis Qwen)
- Karta qwen4-max w QwenCloud
- Ogłoszenie Qwen4-Max (@Alibaba_Qwen)
- Więcej sposobów na rozwój opieki zdrowotnej z ChatGPT for Healthcare (OpenAI)
- Rozwój agentów obsługujących komputer dla zespołów opieki zdrowotnej (OpenAI)
- Rubin HPC (blog NVIDIA)
- Ogłoszenia NVIDIA na SC26
- Vera Rubin w MLPerf Training i Endpoints (blog NVIDIA)
- Slurm i obliczenia kwantowe (blog NVIDIA)
- Biblioteki CUDA-X dla nauki (blog NVIDIA)
- Hugging Face i OpenRouter łączą siły (blog Hugging Face)
- Ogłoszenie @huggingface
- Przedstawiamy Perplexity Frontier Research
- Ogłoszenie @perplexity_ai
- research.perplexity.ai
- Wątek Andrew Gordona Wilsona (@andrewgwils)
- Wątek Denisa Yaratsa (@denisyarats)
- Krok w stronę zdefiniowania modelu standardowego na sieci (OpenAI)
- Nasz nowy blog poświęcony nauce (OpenAI)
- Poszerzanie dostępu do AI dla naukowców (OpenAI)
- Nauka na granicy możliwości: jak naukowcy korzystają z ChatGPT (OpenAI)
- Pierwszy etap naszych ocen w rzeczywistych warunkach (OpenAI)
- Wzmocnienie walki z wykorzystywaniem seksualnym dzieci w internecie (OpenAI)
- Dziennik zmian API OpenAI
- GTIG AI Threat Tracker (Google Cloud)
- Podsumowanie raportu GTIG (blog.google)
- Gemini Notebook: interaktywne strony na podstawie źródeł (blog.google)
- Ogłoszenie @Gemini_Notebook
- Regionalne głosy w aplikacji Gemini (blog.google)
- Nowe funkcje Ask Maps (blog.google)
- Ask Maps trafia do Europy (blog.google)
- Przedstawiamy Monitor API od Perplexity
- Przedstawiamy Video Intelligence w Compass (Cohere)
- Ogłoszenie Video Intelligence (@cohere)
- JFinBench (Sakana AI)
- Artykuł o JFinBench w arXiv
- Jak ułatwiamy agentom programistycznym korzystanie z Together AI
- Kotoba dołącza do ElevenLabs
- Ogłoszenie @ElevenLabs
- Dział medialny LVMH ogłasza strategiczne partnerstwo z OpenAI
- Ogłoszenie @ClaudeDevs
- Dokumentacja symulatora iOS w Claude Code
- Ogłoszenie @Replit
- Strona Replit poświęcona partnerstwu z Microsoft
- Dokumentacja konektora Microsoft Fabric (Replit)
- Wycofanie modeli z GitHub Copilot (dziennik zmian GitHub)
- Copilot CLI 1.0.113-0 (GitHub)
- GitHub Agentic Workflows 1.3.0 (GitHub)
- Codex CLI 0.171.0-alpha.9 (GitHub)
- Agents SDK Python v0.24.0-alpha.8 (GitHub)
- PR 30283 w Gemini CLI (GitHub)
- ZCode v3.18.2 (GitHub)
- Przystosowanie otwartych modeli do długotrwałych zadań agentowych (Together AI i Ollama)
- Wpis Zacha Lloyda o fabrykach oprogramowania (Warp)
- AI Scan w wielu repozytoriach (dziennik zmian GitHub)
- GitHub Mobile na iPhone Duo (dziennik zmian GitHub)
- Lambda i NVIDIA Photonics (blog NVIDIA)
- Wyniki Google Cloud w MLPerf Training v6.1 (blog.google)
- NVIDIA Cosmos, 20 milionów pobrań (@NVIDIAAI)
- LidarVerse (@NVIDIAAI)
- Podsumowanie AI Day Seoul (blog NVIDIA)
- Darmowe obiekty do symulacji od projectsim (blog Hugging Face)
- CI llama.cpp z wykorzystaniem Hugging Face Buckets i Jobs (blog Hugging Face)
- Accelerate v1.16.0 (GitHub)
- Efficient Healer w Tiny Aya Global (blog Hugging Face)
- Nowe modele z Modular Diffusers (blog Hugging Face)
- Długie sekwencje działań na telefonie z wykorzystaniem małych modeli (blog Hugging Face)
- Nowe narzędzia AI w AdMob (blog.google)
- Pięć nowych narzędzi Google Flow (blog.google)
- Nemotron 3.5 Transcribe w indeksie diaryzacji (@NVIDIAAI)
- FLUX: w produkcji (@bfl_ai)
- Kling Image 4.0 (@Kling_ai)
- Autotorino i ElevenAgents (ElevenLabs)
- W Holiday Extras dots zabierają się do pracy, zanim ktokolwiek o to poprosi (OpenAI)
- The King’s Trust i OpenAI (OpenAI)
- Raport Synthesia o AI w szkoleniach
- Wyróżnione liczby w Computer i Teammates (@AskPerplexity)
- AGI a AI (Perplexity)