ai-powered-markdown-translatorArtikel vertaald van het Frans naar het Nederlands met gpt-6.1-sol.
Qwen stelt Qwen4-Max beschikbaar via zijn API: een MoE-model met 2,4T parameters en een context van 1M tokens, tegen een lager tarief dan Qwen3.8-Max. OpenAI breidt zijn agents die de computer bedienen uit naar ChatGPT for Healthcare en ChatGPT for Clinicians, NVIDIA kondigt op SC26 Rubin HPC aan, een GPU voor simulaties die in 2028 wordt verwacht, samen met de eerste resultaten van Vera Rubin in MLPerf Training, en Hugging Face vertrouwt de routing van zijn Inference Providers toe aan OpenRouter. Perplexity lanceert op zijn beurt Perplexity Frontier Research, dat met meer dan 10 000 GPU’s een geautomatiseerde wetenschapper wil ontwikkelen.
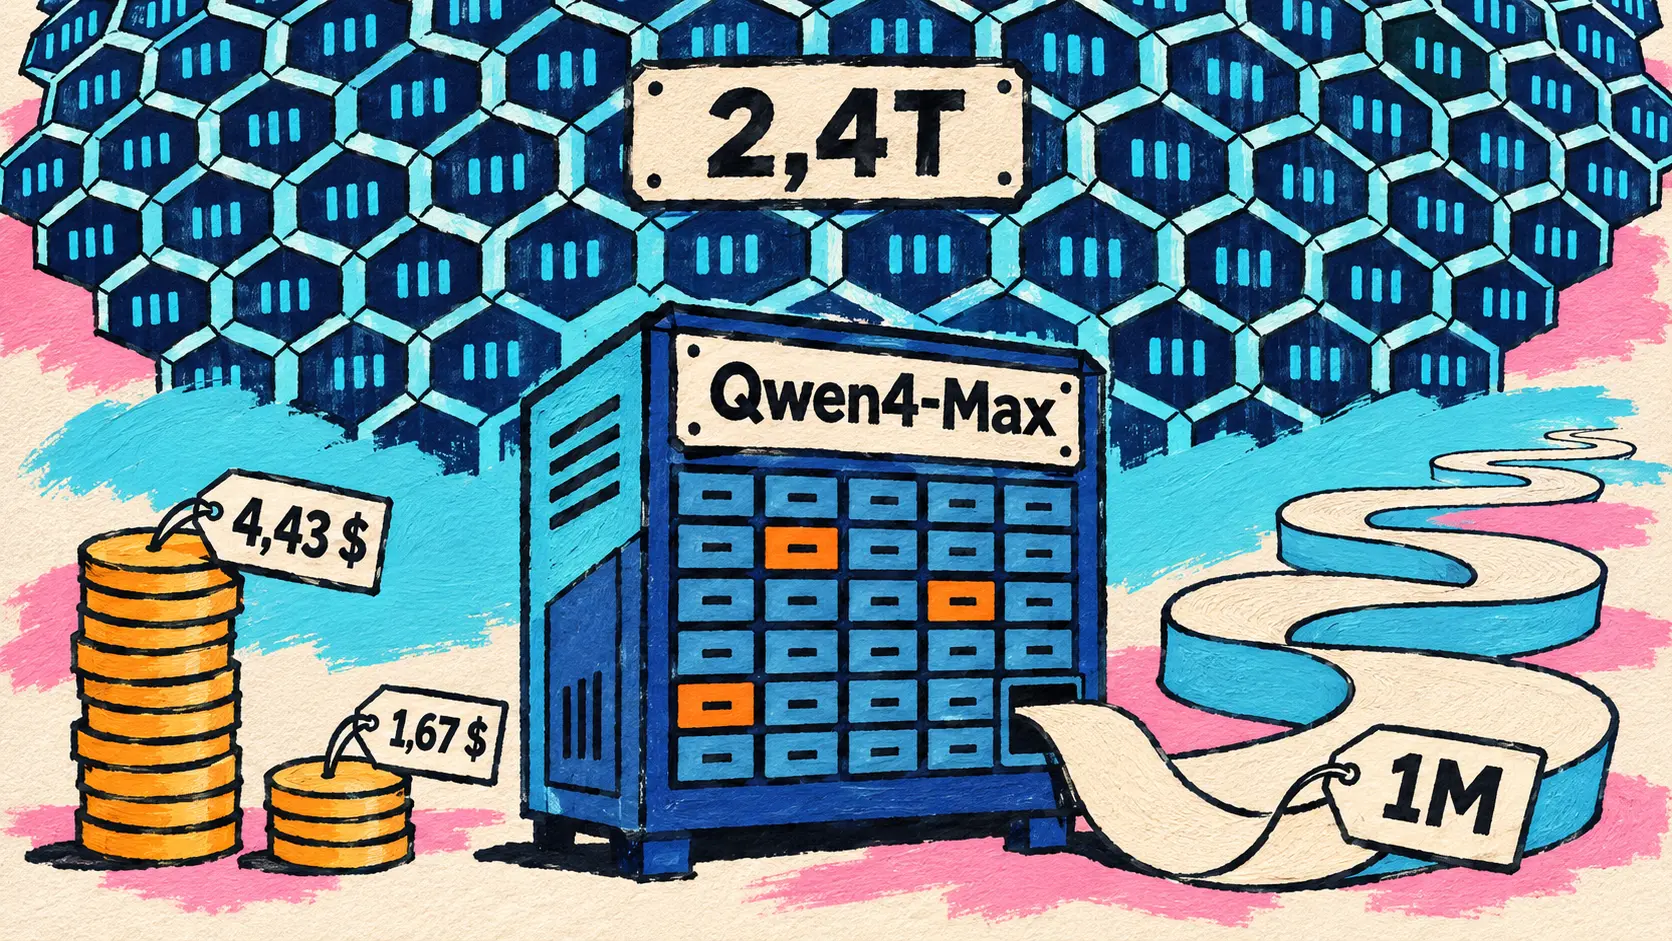
Qwen4-Max verschijnt in de API van QwenCloud: MoE met 2,4T parameters, context van 1M tokens, lagere tarieven
16 november — Vijf dagen na de preview waarover op 11 november werd bericht, stelt Qwen Qwen4-Max beschikbaar in de API van QwenCloud onder de identifier qwen4-max, met een uitgebreid technisch blogbericht. Het is het eerste model uit de Qwen4-serie: kleinere Qwen4-modellen zullen met open gewichten worden uitgebracht, zonder aangekondigde datum, maar voor Max is zoiets niet aangekondigd. Het model wordt ook aangeboden in QwenWork, Qoder en Qwen Studio, en vanaf dezelfde dag bij OpenRouter, Vercel AI Gateway, Novita AI en OpenCode Go.
De architectuur is nieuw. Dit mengsel van experts (Mixture of Experts, MoE) telt 2,4T parameters in de backbone, waarvan 71B per token worden geactiveerd, plus 328B parameters voor N-gram Embedding. Van elke vier lagen comprimeren drie Gated DeltaNet-lagen de geschiedenis tot een toestand met een vaste grootte; de vierde, met Qwen Sparse Attention, selecteert de relevante context in blokken. Het model heeft native vision en een context van 1M tokens: 991K voor invoer en 131K voor uitvoer, 983K en 262K in de redeneermodus, volgens de QwenCloud-pagina.
| Tarieftype (QwenCloud, per miljoen tokens) | Aangekondigde prijs |
|---|---|
| Invoer | 1,5 dollar |
| Uitvoer | 4,5 dollars |
| Invoer via impliciete cache | 0,075 dollar |
| Expliciete cache aanmaken (5 minuten / 1 uur) | 1,875 / 3 dollars |
Volgens Qwen liggen al deze tarieven lager dan die van Qwen3.8-Max, waarbij de prijs voor de impliciete cache met 70 % daalt. In zijn interne evaluaties meldt Qwen ook een daling van het tokenverbruik met 24 tot 35 %, afhankelijk van de redeneerinspanning, op Work360, zijn evaluatiekader met 721 beroepsspecialismen, en met ongeveer 48 tot 49 % op Terminal-Bench 4.0. De gemiddelde kosten van een Work360-taak dalen van 4,43 naar 1,67 dollar, oftewel −62 % volgens het Engelse blogbericht; de Chinese versie, in yuan, vermeldt −58 %. Op Work360 behaalt Qwen4-Max 52,69 tegenover 47,74 voor Qwen3.8-Max.
Vergeleken met Opus 5.5, GPT-6.1 Sol, GPT-6 Astra en Kimi K3.1 laat de door Qwen gepubliceerde tabel een gemengd beeld zien: Qwen4-Max staat slechts op 4 van de 16 tests bovenaan, namelijk DeepSWE v1.1, Agents’ Last Exam v1.1, HLAB-Vals-1.1 en BioMysteryBench. Een selectie:
| Benchmark (domein) | Qwen4-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|
| DeepSWE v1.1 (agentisch programmeren) | 75,7 | 74,2 | 75,2 | 74,1 | 75,5 |
| HLAB-Vals-1.1 (juridische agent) | 21,3 | 9,2 | 6,3 | 7,1 | 11,7 |
| BioMysteryBench (bio-informatica) | 85,0 | 81,9 | 84,4 | 78,9 | 80,6 |
| Terminal-Bench 4.0 (agentische terminaltaken) | 48,5 | 59,6 | 56,1 | 59,1 | 67,2 |
| ProgramBench (softwarereplicatie) | 31,5 | 65,0 | 52,5 | 55,0 | 25,0 |
| Humanity’s Last Exam | 51,7 | 59,8 | 54,0 | 53,6 | 51,1 |
De ranglijsten van derden die Qwen aanhaalt, plaatsen het model op de 6e plaats in Code Arena WebDev (1 750 voorlopige punten) en op de 11e plaats in de Vals Index (63,20 %), als hoogst geplaatste Chinese model. Artificial Analysis geeft het 43 punten op zijn Intelligence Index bij redeneerinspanning xhigh, 3 punten achter Kimi K3.1 Pro, met ongeveer 11 % lagere kosten per taak.
More to come! The open weights of smaller Qwen4 models will be released. Stay tuned.
🇳🇱 Het is nog niet voorbij! De open gewichten van kleinere Qwen4-modellen worden gepubliceerd. Blijf op de hoogte. — @Alibaba_Qwen op X
🔗 Qwen4-Max: je nieuwe teamgenoot is er (Qwen-blogbericht) · Specificaties van qwen4-max op QwenCloud
ChatGPT for Healthcare: agents die de computer bedienen, klinisch onderzoek en meer dan 20 zorgplugins
16 november — OpenAI breidt ChatGPT for Healthcare in drie richtingen uit. Ten eerste komen de agents voor computerbediening (computer-use agents), die het scherm lezen, klikken, typen en tussen applicaties schakelen, beschikbaar in ChatGPT Work en Codex voor klanten van ChatGPT for Healthcare, afhankelijk van de instellingen van hun werkomgeving, en voor clinici van ChatGPT for Clinicians, het gratis aanbod dat is voorbehouden aan geverifieerde clinici in de Verenigde Staten. Dezelfde mogelijkheid is beschikbaar via de API. Een typisch gebruiksscenario: informatie overbrengen tussen softwarepakketten die niet met elkaar communiceren, zoals het elektronisch patiëntendossier en het portaal van een verzekeraar voor een machtigingsaanvraag voor een MRI. Computerbediening bestond sinds 9 juli in ChatGPT Work en Codex; nieuw is de beschikbaarheid ervan in zorgomgevingen, met toegangsbeheer op basis van rollen, auditlogs en instelbare goedkeuringsstappen. Workflows die aan HIPAA voldoen, blijven beperkt tot diensten die hiervoor in aanmerking komen en onder een BAA vallen.
OpenAI publiceert twee reeksen cijfers, die afzonderlijk moeten worden bekeken: zijn interne evaluatie van het berichtenverkeer binnen het medisch dossier, en HealthAdminBench, een onafhankelijke benchmark van onderzoekers van Stanford voor administratieve taken (voorafgaande machtigingen, bezwaarschriften, bestellingen van apparatuur).
| Gepubliceerde evaluatie | Model en instelling | Aangekondigd resultaat |
|---|---|---|
| Berichtenverkeer binnen het medisch dossier (OpenAI, 325 beoordeelde taken) | GPT-6 Astra | 99 % van de taken als klinisch veilig beoordeeld |
| Dezelfde evaluatie, 646 beoordelingen door artsen | GPT-6 Astra | 93 % « zeer » of « uiterst » nuttig |
| HealthAdminBench (Stanford) | GPT-6 Astra, maximale redeneerinspanning | 94,3 % van de punten op het beoordelingsschema |
| HealthAdminBench (Stanford) | GPT-6 Luna, maximale redeneerinspanning | 91,8 %, voor 8,5 cents per taak |
Op HealthAdminBench behaalt GPT-6 Luna 91,8 % tegen 98 % lagere kosten, oftewel 8,5 cent per taak. In de praktijk gebruikt CVS Health deze agents al in productie: één agent heeft in één weekend een maandenlange achterstand bij het verzenden van documenten weggewerkt, een andere voert de systeemstappen voor tienduizenden consulten per dag uit, en het bedrijf publiceert zijn Agent Kit, gebouwd met de Agents SDK van OpenAI, als open source. Cigna Healthcare zegt in minder dan acht weken van concept naar ingebruikname te zijn gegaan; bij Ambience stopt de agent en vraagt hij de clinicus om advies wanneer het dossier onduidelijk is; Abridge ontwikkelt agents voor het ziekenhuis.
Dan volgen de twee andere onderdelen. Klinisch onderzoek, dat medisch bewijs zoekt, beoordeelt en citeert, krijgt hogere scores op alle acht gemeten dimensies in een blinde evaluatie met meer dan 1 300 beoordelingen door artsen. En 21 nieuwe zorgplugins (UpToDate Expert AI, Oracle HDI, Trizetto, Stedi, Luma Health, Metriport…) maken het mogelijk om vanuit het gesprek een protocol te raadplegen, de aanspraak op verzekeringsdekking te controleren of afspraken te coördineren; de beheerder van de werkomgeving moet ze activeren, en ChatGPT for Clinicians krijgt er slechts een deel van.
🔗 Meer manieren om de zorg vooruit te helpen met ChatGPT for Healthcare · Verdere ontwikkeling van agents voor computerbediening voor zorgteams
NVIDIA op SC26: Rubin HPC voor wetenschappelijke simulatie, Vera Rubin in MLPerf, Slurm voor quantumprocessors en CUDA-X-bibliotheken
16 november — Op de conferentie voor high-performance computing SC26 doet NVIDIA een reeks aankondigingen gericht op de wetenschap. De belangrijkste is Rubin HPC, een nieuwe GPU binnen het Vera Rubin-platform, ontworpen voor simulatie en gegevensverwerking in wetenschap, techniek en data-analyse, op gebieden zoals klimaat, genomica of financieel risico.
De gepubliceerde specificaties blijven summier. NVIDIA benadrukt de meer dan 50 000 CUDA-cores op één GPU, volgens het bedrijf een « recordaantal », versnelling van sparse data (sparse data acceleration) om deze cores van gegevens te blijven voorzien, en een NVLink-verbinding van de zevende generatie tussen GPU’s. Geheugencapaciteit, rekenkracht in FLOPS, prijs en partners worden niet genoemd.
Het centrale argument is evenwicht. Volgens NVIDIA bestaan de meeste wetenschappelijke workloads uit het ophalen van enkele verspreide waarden uit een enorme dataset, daarmee rekenen, en dat vervolgens op zeer grote schaal herhalen. Rubin HPC laat daarom de gegevensverplaatsing meegroeien met de rekenkracht, om bewerkingen op ijle matrices, stencilberekeningen, sorteringen en reducties te versnellen. NVIDIA verbindt deze GPU aan zijn verhaal over agents: een agent die meer moleculen, materialen of ontwerpen verkent, heeft meer simulaties nodig om zijn ideeën te testen, en de CUDA-X-bibliotheken bieden hem de geoptimaliseerde implementaties. De planning ligt ver in de toekomst: Rubin HPC wordt in 2028 verwacht.
| Aangekondigd kenmerk | Door NVIDIA vermelde waarde |
|---|---|
| CUDA-cores | meer dan 50 000 op één GPU |
| Verbinding tussen GPU’s | NVLink van de zevende generatie |
| Specifieke functie | versnelling van sparse data |
| Verwachte beschikbaarheid | 2028 |
🔗 Rubin HPC (NVIDIA-blog) · De aankondigingen van NVIDIA op SC26
Vera Rubin debuteert in MLPerf Training v6.1 en MLPerf Endpoints, met per GPU tot 2 keer de prestaties van GB300 NVL72
16 november — De ronde MLPerf Training v6.1 markeert de eerste deelname van Vera Rubin NVL72 aan de trainingstests: tot 2 keer de prestaties per GPU van een GB300 NVL72, resultaten die NVIDIA als vroege resultaten presenteert. Op DeepSeek-V3 blijft de efficiëntie bij een opschaling van 256 naar 1 024 Vera Rubin-GPU’s op ongeveer 97 % en daalt de trainingstijd van 16 minuten naar ongeveer vier. De grootste configuratie in deze ronde telt 10 240 GPU’s, met GB300 bij NVIDIA en met GB200 bij Microsoft Azure. Volgens NVIDIA is zijn platform het enige met resultaten voor alle tests.
NVIDIA dient ook voor het eerst resultaten in voor MLPerf Endpoints v1.0, dat echte agentische workflows meet. Op Kimi K3 zou Vera Rubin NVL72 bij dezelfde antwoordsnelheid meer dan 10 keer de doorvoer per watt van een GB300 NVL72 leveren: een voorlopig resultaat, dat nog door MLCommons moet worden geverifieerd, waarbij 32 Vera Rubin-accelerators worden vergeleken met 48 GB300-accelerators bij de drempel van 50 tokens per seconde en per gebruiker. Vera Rubin was al als preview opgenomen in MLPerf Inference, waarover op 16 september werd bericht.
🔗 Vera Rubin in MLPerf Training en Endpoints (NVIDIA-blog)
Slurm 26.11 krijgt ondersteuning voor quantumprocessors, CUDA-Q wordt uitgebreid
16 november — NVIDIA breidt Slurm, de taakbeheerder voor supercomputers, uit naar quantumprocessors (QPU). Tot nu toe vereiste het aansluiten van een QPU in een rekencentrum specifieke ontwikkeling voor elke combinatie van processor en centrum; voortaan beschrijft een fabrikant zijn hardware in een eenvoudig bestand en krijgt hij een interface die overal werkt, via de interfaces QRMI en QDMI. Alice & Bob, IBM, IQM, Pasqal, Quantinuum en MQSC maken er gebruik van, en Slurm 26.11 moet later in november verschijnen. NVIDIA verklaart deze ontwikkeling vanuit de groei van het aantal installaties: bijna 30 rekencentra nemen meer dan 50 QPU in gebruik.
Het CUDA-Q-platform krijgt een decoderingsserver voor quantumfoutcorrectie (CUDA-Q QEC), waarvan de TCBP-JOBS-decoder 13 000 keer sneller zou zijn dan de referentie in de sector, fouttolerante primitives (Fermilab heeft met CUDA-Q in drie weken al studies uitgevoerd die anders vijf maanden zouden hebben gekost), evenals CUDA-Q Algorithms en CUDA-Q Pulse voor hardwarefabrikanten. Deze prestatiewinsten worden door NVIDIA geclaimd.
🔗 Slurm en quantumcomputing (NVIDIA-blog)
CUDA-X voor de wetenschap: cuSpa en HMMER op GPU beschikbaar als open source, de Event Horizon Telescope gecorreleerd in acht minuten
16 november — NVIDIA voorziet Rubin HPC van CUDA-X-bibliotheken voor onderzoek, gepresenteerd als tools die agents kunnen aanroepen. In de astronomie verkort de module cuPhoton.xBeam de correlatie van de waarnemingen van de Event Horizon Telescope van meer dan een maand tot acht minuten, zowel op een cluster met meerdere GPU’s als op een DGX Spark. In de biologie maakt cuSpa, dat sinds kort open source is, berekeningen van celpolygonen bij het Memorial Sloan Kettering Cancer Center 900 keer sneller dan op CPU, en is de GPU-versie van HMMER, eveneens open source, tot 84 keer sneller bij Basecamp Research. rapids-singlecell wordt nu geleverd in een container die « klaar is voor agents » (200 keer sneller bij Therna Biosciences). In de chemie komt Daviator, een verzameling GPU-kernels voor de VASP-software, naar NVIDIA ALCHEMI met berekeningen die tot 22 keer sneller en tot 75 % goedkoper zijn, maar het is nog niet beschikbaar; cuPotential, gelanceerd op 14 oktober, krijgt vijf nieuwe gebruikers, waaronder Cadence.
🔗 CUDA-X-bibliotheken voor de wetenschap (NVIDIA-blog)
Hugging Face vertrouwt de routing van de taalmodellen van zijn Inference Providers toe aan OpenRouter
16 november — Hugging Face en OpenRouter werken samen: de Inference Providers van Hugging Face stappen af van hun eigen router en laten OpenRouter voor elke aanroep van een taalmodel de aanbieder kiezen. Clément Delangue presenteert de aankondiging als het eerste deel van het partnerschap. Er verandert niets aan de clientcode: hetzelfde Hugging Face-token, hetzelfde endpoint. De router ondersteunt zowel de Chat Completions- en Responses-API’s van OpenAI als de Messages-API van Anthropic, en Hugging Face publiceert handleidingen voor Claude Code, Codex, OpenCode, Pi en Hermes Agent.
Het verschil zit in de routing. Inference Providers koos een aanbieder en gaf diens foutmelding ongewijzigd door; OpenRouter kiest op basis van live gemeten prijs, snelheid en betrouwbaarheid en probeert de aanroep bij een andere aanbieder opnieuw als de eerste faalt. Met suffixen kan een beleid of een aanbieder worden afgedwongen (:fastest, :cheapest, zai-org/GLM-5.3:novita), en een gesprek blijft bij de aanbieder die de promptcache ervan beheert.
| Aangekondigde wijziging | Details volgens de blogpost |
|---|---|
| Capaciteitsfouten (meting OpenRouter) | −46 % |
| Tijd tot het eerste token en doorvoersnelheid (meting OpenRouter) | verbeterd met 16,9 % en +16,3 % |
| Facturering | prijs van de aanbieder, zonder toeslag van Hugging Face |
| Inbegrepen maandelijkse credits | 2 dollar (PRO), 2 dollar per licentie (Team, Enterprise) |
| Modelpagina’s | tabbladen Providers en Metrics: prijs, snelheid, beschikbaarheid over 24 uur |
| Breaking change | persoonlijke API-sleutels van aanbieders worden geweigerd voor taalmodellen |
Beeld, video en audio blijven rechtstreeks via Inference Providers lopen, zonder OpenRouter, en persoonlijke sleutels blijven geldig voor aanbieders van beeld en video. Het koppelen van een OpenRouter-account aan Hugging Face en het via OpenRouter routeren van andere taken zijn aangekondigd voor later, zonder datum.
De blogpost baseert zich op cijfers van OpenRouter: open modellen waren eind september 2026 goed voor 71,7 % van de verwerkte tokens, tegenover 26,8 % in oktober 2025, tegen een gemiddelde prijs van 0,28 en 1,62 dollar per miljoen tokens (invoer, uitvoer), tegenover 1,27 en 6,36 dollar voor gesloten modellen. De blogpost erkent ook de kloof aan de top van de ranglijst: Kimi K3.1 Pro, het beste open model, scoort 46 op de Artificial Analysis Intelligence Index tegenover 65 voor Claude Fable 5.2, tegen ongeveer een zevende van de kosten per taak (3,68 tegenover 26,54 dollar).
🔗 Hugging Face en OpenRouter bundelen hun krachten (Hugging Face-blog) · Aankondiging van @huggingface
Perplexity Frontier Research: een open onderzoeksinitiatief dat streeft naar een geautomatiseerde wetenschapper, met meer dan 10 000 GPU
16 november — Perplexity lanceert Perplexity Frontier Research, een initiatief dat een «geautomatiseerde onderzoekswetenschapper» (automatic research scientist) wil bouwen: een AI-systeem dat zelfstandig de onderzoekscyclus kan doorlopen, van vraag naar hypothese, van experiment naar het herzien van zijn overtuigingen. Perplexity zet deze ambitie af tegen «black box»-voorspellingen voor afgebakende taken: het doel is nieuwe, interpreteerbare kennis te produceren.
We aim to create an automated research scientist. Research is a loop that involves asking the right questions, hypothesizing, navigating ambiguity, designing experiments, and updating beliefs. We think this loop can run inside software, for anyone.
🇳🇱 We willen een geautomatiseerde wetenschapper creëren. Onderzoek is een cyclus waarin je de juiste vragen stelt, hypothesen formuleert, met ambiguïteit omgaat, experimenten ontwerpt en je overtuigingen herziet. We denken dat die cyclus voor iedereen in software kan draaien. — @andrewgwils op X
Het programma is opgebouwd rond zes pijlers: orkestratie van meerdere agents, pretraining, continu leren, reinforcement learning, systemen en evaluaties. De bijbehorende website vermeldt dat het team efficiënte, gespecialiseerde modellen met open gewichten zal pretrainen en bij de orkestratie naar de beste kwaliteit voor elk kostenniveau streeft. Denis Yarats benadrukt reinforcement learning op grote schaal, op meer dan 10 000 GPU, gevoed met synthetische data en omgevingen die voortkomen uit het werkelijke gebruik van Perplexity; de volledige infrastructuur, van onderzoek tot sandboxes, is intern ontwikkeld.
| Onderdeel van de aankondiging | Toezegging van Perplexity |
|---|---|
| Rekenkracht | meer dan 10 000 GPU |
| Onderzoekspijlers | 6 |
| Toegezegde publicaties | artikelen, blogposts, data, modellen en code |
| Steden waar wordt geworven | San Francisco, Palo Alto, New York, Londen |
| Deadline voor prioritaire behandeling van sollicitaties | 5 december |
Andrew Gordon Wilson wordt op de website voorgesteld als onderzoeksleider van het initiatief. De aankondiging is ook een oproep om te solliciteren, met een onderzoeksbeurs voor predoctorale en postdoctorale trajecten. Bij de lancering verschijnt geen nieuw model, benchmark of artikel: de website groepeert onder de vlag Frontier Research eerder gepubliceerd onderzoek, zoals WANDR, Decider, SPACE, Brain of JOLT.
🔗 Introductie van Perplexity Frontier Research · Aankondiging van @perplexity_ai · research.perplexity.ai · Thread van @denisyarats
AI en wetenschappelijk onderzoek bij OpenAI: een aparte blog met een openingsbijdrage van natuurkundige Nathaniel Craig, ChatGPT for Academic Researchers uitgebreid naar 200 000 onderzoekers
Een wetenschapsblog die opent met een kandidaatdefinitie van het Standaardmodel op een rooster, opgesteld met GPT-6 Astra
15 november — OpenAI opent een blog over wetenschap, waar onderzoekers en teams resultaten en methoden zullen delen, inclusief manieren om het werk te controleren. De eerste gastbijdrage is geschreven door Nathaniel Craig, deeltjesfysicus aan de Universiteit van Californië in Santa Barbara en gastwetenschapper bij OpenAI.
Hij presenteert daarin een preprint uit oktober, opgesteld met GPT-6 Astra, die een kandidaatdefinitie van het Standaardmodel op een rooster voorstelt, een raster dat de ruimtetijd discretiseert. Omdat de zwakke wisselwerking onderscheid maakt tussen «linkse» en «rechtse» deeltjes, ontstaan bij het plaatsen op een rooster ongewenste partnerdeeltjes, en bleef de faseregel voor het volledige Standaardmodel al meer dan 25 jaar een open vraag. Volgens Craig vond GPT-6 Astra een manier om de velden naar fijnere roosters over te brengen en nam het de leiding bij het gedetailleerde bewijs, dat vervolgens door drie specialisten werd nagekeken. De auteur blijft voorzichtig: de definitie is een «kandidaat», geldt onder een bovengrens voor de veldsterkte en is eerder een principieel antwoord dan een simulatietool.
🔗 Een stap naar een definitie van het Standaardmodel op een rooster · Onze nieuwe wetenschapsblog
ChatGPT for Academic Researchers richt zich op 200 000 onderzoekers, een studie omvat 1 819 wetenschappers
16 november — Het programma ChatGPT for Academic Researchers ging in juli van start met een doel van 100 000 onderzoekers en richt zich nu op 200 000. De volgende ronde opent op maandag 23 november: 50 000 beurzen worden toegekend aan de eerste kandidaten die aan de voorwaarden voldoen, niet langer via loting, waarbij elke beurs de ontvanger en maximaal twee medewerkers dekt, dus in totaal maximaal 150 000 personen. De toegang verandert van ChatGPT Pro naar ChatGPT Plus: volgens OpenAI zouden de meeste deelnemers aan de pilot binnen de limieten van Plus zijn gebleven.
Het economisch onderzoeksteam van OpenAI publiceert daarnaast een studie van 580 186 berichten van 1 819 wetenschappers, aangevuld met een enquête onder 251 van hen. De deelnemers schatten dat hetzelfde werk, bij gelijke kwaliteit, zonder AI ongeveer 1,9 keer zoveel tijd zou hebben gekost, en 98 % van de respondenten verwacht dat AI ontdekkingen in hun vakgebied zal versnellen. OpenAI benadrukt de beperkingen: zelfgerapporteerde productiviteit, verwachtingen in plaats van resultaten, geen vastgesteld causaal effect.
| Gebruik van ChatGPT door wetenschappers | Gemiddeld aandeel van de berichten |
|---|---|
| Lezen en leren | 28 % |
| Schrijven en communiceren | 27 % |
| Analyse van bewijs en theorieën | 17 % |
| Ontwikkelen van onderzoekssoftware | 14 % |
🔗 Meer toegang tot AI voor wetenschappers · Wetenschap aan de grens: hoe wetenschappers ChatGPT gebruiken
Veiligheid en beveiliging van AI: onafhankelijke beoordelaars bij OpenAI, een opengestelde CSAM-classifier, aanvallen met agents waargenomen door Google
OpenAI stelt zijn interne modellen open voor Apollo Research, METR, Transluce en Goodfire
16 november — OpenAI heeft met vier onafhankelijke organisaties afspraken gemaakt voor een eerste fase van geïntegreerde beoordelingen (embedded assessments): verregaande toegang, soms tot dezelfde middelen als zijn onderzoekers (checkpoints, code, trainings- en evaluatiedata, monitoringsystemen, teams), om de alignment en de doeltreffendheid van de guardrails op langere termijn te beoordelen. Het werk vindt op locatie plaats, op apparaten van OpenAI, onder toezicht van het Safety and Security Committee, dat de ongecensureerde rapporten ontvangt; OpenAI behoudt het recht om vertrouwelijke informatie weg te laten en uitstel van publicatie te vragen.
| Onafhankelijke beoordelaar | Onderwerp van de beoordeling | Vergoeding door OpenAI |
|---|---|---|
| Apollo Research | Verborgen ondermijning en detectie door de guardrails | Ja, onafhankelijk van de resultaten |
| METR | Misalignment in de grootste RL-training, beperkte reikwijdte | Nee (API-credits of rekenkracht mogelijk) |
| Transluce | Alignmentbeoordelingen na de training | Nee (API-credits of rekenkracht mogelijk) |
| Goodfire | Interpreteerbaarheid van de interne werking van modellen | Ja, onafhankelijk van de resultaten |
🔗 Onze eerste fase van geïntegreerde beoordelingen
Een gratis CSAM-classifier voor afbeeldingen voor geverifieerde organisaties, met een signaal voor door AI gegenereerde content
16 november — OpenAI stelt via zijn API omni-moderation-csam-latest gratis beschikbaar aan geverifieerde organisaties, een afbeeldingsclassifier die potentieel materiaal van seksueel misbruik van kinderen (CSAM) herkent en een tweede signaal geeft voor materiaal dat door AI zou kunnen zijn gegenereerd. De classifier is ontworpen met hulp van NCMEC en wordt door OpenAI gepresenteerd als de eerste breed beschikbare CSAM-classifier met dit tweede signaal; de Tech Coalition en ROOST helpen de toegang uit te breiden. Volgens tests van OpenAI zou de classifier 48 % minder afbeeldingen markeren dan de huidige bescherming, terwijl hij ongeveer evenveel misbruik opspoort (een schatting). Bij de partners met vroege toegang bevestigt fal dat 72 % van de met hoge zekerheid gemarkeerde content niet eerder bekend was, en detecteert SafetyKit 90 % van de tekeningen of animaties. In ChatGPT leidt een zoekopdracht naar dit type content nu tot een waarschuwing, verwijdering van het gesprek en een toegangsschorsing van 24 uur; herhaling kan leiden tot sluiting van het account of een melding aan de autoriteiten.
🔗 De strijd tegen online seksueel misbruik van kinderen versterken · Changelog van de OpenAI-API
Google Threat Intelligence: aanvallers automatiseren het zoeken naar en misbruiken van kwetsbaarheden van begin tot eind
16 november — In zijn kwartaaloverzicht van kwaadaardig AI-gebruik stelt de Google Threat Intelligence Group (GTIG) vast dat aanvallers offensieve open source-frameworks met meerdere agents inzetten (ARTEX, CAIRN, CyberStrikeAI, PentAGI). Voor het eerst hebben actoren volgens GTIG het ontdekken en misbruiken van kwetsbaarheden geautomatiseerd zonder menselijke tussenkomst: een framework met de naam exploit_agent, aangetroffen op een blootgestelde server, vergeleek de code vóór en na patches, schreef exploits en voerde ze uit; op basis van telemetrie van de slachtoffers leek de operator zich vooral te richten op Franse media- en entertainmentsites, en op het onderwijs. Het aantal uitgebuite zero-days stijgt van gemiddeld 8 per maand in 2025 naar 11 in 2026, met een piek van 22 in augustus. Een vermoedelijk Noord-Koreaanse groep wijzigde .claude/settings.json-bestanden in interne repositories om Claude Code bij het opstarten een backdoor te laten installeren.
For the most part, attackers aren’t using new groundbreaking methods to break into systems — they are still going after known, unfixed issues, just with much greater speed and scale.
🇳🇱 Over het algemeen gebruiken aanvallers geen revolutionaire nieuwe methoden om systemen binnen te dringen: ze richten zich nog steeds op bekende, niet-gepatchte kwetsbaarheden, maar doen dat veel sneller en op veel grotere schaal. — John Hultquist, hoofdanalist, GTIG, op blog.google
🔗 GTIG AI Threat Tracker (Google Cloud)
Google-functies voor consumenten: interactieve sites in Gemini Notebook, 66 regionale stemmen in Gemini, Ask Maps in 30 Europese landen
Gemini Notebook zet bronnen uit een notitieboek om in interactieve sites
16 november — Gemini Notebook kan de bronnen uit een notitieboek nu omzetten in interactieve sites. Je hoeft alleen make me a site in de chat van het notitieboek te typen, samen met een beschrijving van wat je wilt: een visuele uitleg om leerstof te herhalen (een interactief periodiek systeem, een historische tijdlijn), een dashboard (de verkopen van een kwartaal) of een projecttracker met taken en deadlines. De site opent in een nieuw tabblad of kan rechtstreeks worden gedeeld. De functie wordt vanaf 16 november wereldwijd op het web uitgerold voor gebruikers van 18 jaar en ouder, inclusief Google Workspace-abonnees; de mobiele app volgt «binnenkort», zonder aangekondigde datum.
🔗 Gemini Notebook: interactieve sites op basis van bronnen (blog.google) · Aankondiging van @Gemini_Notebook
De Gemini-app rolt 66 regionale stemmen uit op Android en iOS
16 november — De Gemini-app rolt 66 nieuwe regionale stemmen uit op Android en iOS, onder meer in Amerikaans, Brits en Indiaas Engels, Hindi, Braziliaans Portugees, Indonesisch en Koreaans, met opties die specifiek zijn voor elke taal. Volgens Google zijn ze afgestemd op een natuurlijk spreekritme en goede verstaanbaarheid, in plaats van op overdreven accenten. De gekozen stem geldt in de hele app: gesprekken met Gemini Live, het oefenen van een taal, het hardop voorlezen van een antwoord. Je kiest de stem via het menu van Gemini Live of in de instellingen. Google had dit project voor lokale dialecten al aangekondigd op Google I/O.
🔗 De regionale stemmen van de Gemini-app (blog.google)
Ask Maps komt naar 30 Europese landen en leert routes en afspraken te plannen
16 november — Ask Maps, de gespreksassistent van Google Maps die gebruikmaakt van de Gemini-modellen, werd gelanceerd in de Verenigde Staten en India en hier op 12 maart besproken, en wordt nu uitgerold naar 30 Europese landen, waaronder Spanje, Duitsland en het Verenigd Koninkrijk. Volgens Google is de assistent inmiddels beschikbaar in meer dan 200 landen en gebieden; de blogberichten noemen Frankrijk niet. Op dezelfde dag krijgt Ask Maps nieuwe functies, die worden uitgerold op Android en iOS:
| Nieuwe functie van Ask Maps | Aangekondigde beschikbaarheid |
|---|---|
| Reisroutes per dag, deelbaar en exporteerbaar naar Google Docs | Overal waar Ask Maps beschikbaar is |
| Zoeken in opgeslagen lijsten, met actuele beschikbaarheid | Overal waar Ask Maps beschikbaar is |
| Reisadvies (Know before you go): parkeren, opladen, weer, tol | Eerst in de Verenigde Staten |
| Afspraken zoeken en lokale bedrijven bellen | Eerst in de Verenigde Staten |
🔗 De nieuwe functies van Ask Maps (blog.google) · Ask Maps komt naar Europa (blog.google)
Informatie zoeken voor ontwikkelaars en bedrijven: de Monitor API van Perplexity, Video Intelligence in Cohere Compass
Perplexity lanceert de Monitor API, die het web of pagina’s monitort en meldingen via webhook verstuurt
16 november — Perplexity lanceert de Monitor API, die het web monitort namens een applicatie of agent. Twee modi: via Perplexity Search nieuwe ontwikkelingen rond een onderwerp, bedrijf of vraag volgen, of maximaal 10 specifieke pagina’s volgen (prijzen van een concurrent, changelog, beleid) en een diff in tekstvorm ontvangen van wat er is veranderd. De ontwikkelaar kan zijn doel in natuurlijke taal beschrijven; Perplexity Decider controleert bij elk resultaat de relevantie, de legitimiteit van de bron, de nieuwheidswaarde en de actualiteit, en alleen updates die aan alle drempelwaarden voldoen, worden via ondertekende webhooks met een betrouwbaarheidsscore verstuurd. De monitors draaien elke 15 minuten, elk uur, elke dag, elke week of volgens een cron.
| Type monitor | Factureringseenheid | Aangekondigde prijs |
|---|---|---|
| Webmonitor | geslaagde uitvoeringen | 1 dollar per 1 000 |
| Paginamonitor | opgehaalde URL’s | 1 dollar per 1 000 |
De API is per direct beschikbaar, met dezelfde sleutel als de API’s Search, Context en Agent. Volgens Perplexity leverde Monitor bij 60 onderwerpen die acht uur lang werden gevolgd actuelere en relevantere resultaten op dan andere aanbieders van Search API’s.
🔗 Introductie van de Monitor API van Perplexity
Cohere stelt Video Intelligence beschikbaar in Compass om het exacte moment in een video terug te vinden
16 november — Cohere voegt video toe aan Compass, zijn zoekplatform voor bedrijven, met Video Intelligence, dat beschikbaar is als besloten preview. In plaats van een opname van een uur terug te geven, vindt Compass het moment dat de vraag beantwoordt: een fragment met tijdstempel, een transcriptie en een beschrijving van wat er op het scherm te zien is, waarbij het begin en einde tijdens de zoekopdracht worden bepaald. Video wordt samen met documenten in één index opgenomen, die de toegangsrechten van elke gebruiker respecteert, en agents krijgen er toegang toe via de MCP-server van Compass. Op 11 datasets en 11 133 zoekopdrachten eindigt Compass volgens Cohere gemiddeld op de eerste plaats tegenover zeven modellen voor video-embeddings, met een voorsprong van 4,4 nDCG@10-punten op het beste alternatief. Het bedrijf werft ontwikkelpartners (design partners), die de tool in de beheerde cloud van Cohere of in hun eigen omgeving kunnen uitrollen; er wordt geen prijs of datum voor algemene beschikbaarheid genoemd.
🔗 Introductie van Video Intelligence in Compass · Aankondiging van @cohere
Modellen en agents evalueren: JFinBench van Sakana AI over de Japanse financiële sector, de agentevaluaties van Together AI
JFinBench: in de Japanse financiële sector blijft het beste open model 12,4 punten achter op Claude Fable 5
16 november — Sakana AI publiceert JFinBench (blogbericht gedateerd op 17 november, Japanse tijd), een benchmark op basis van de examenrondes van 2026 van zes Japanse financiële examens, van accountancy tot belastingadvies, die is ontworpen om bij elke examenronde te worden vernieuwd om contaminatie te beperken. Op 321 vragen zijn 12 modellen geëvalueerd; hieronder staan de vijf beste zonder tools:
| Geëvalueerd model | Score zonder tools | Score met tools (harness) |
|---|---|---|
| Claude Fable 5 | 95,8 | 96,4 (Terminus-2) |
| GPT-6 Astra | 93,6 | 97,3 (Terminus-2) |
| Gemini 3.8 Flash | 88,8 | 94,2 (Terminus-2) |
| Kimi K3.1 Pro | 83,4 | 92,9 (Kimi Code) |
| Kimi K3 | 79,9 | 91,0 (Kimi Code) |
Kimi K3.1 Pro, het beste open model, blijft 12,4 punten achter op Claude Fable 5 en ongeveer 10 op GPT-6 Astra, terwijl wordt gesteld dat het op Terminal-Bench 4.0 beter scoort dan dat laatste model (65,7 % tegenover 58,2 %, cijfers van de ontwikkelaars). Mislukkingen komen vooral voort uit een gebrek aan kennis van het Japanse stelsel, en liggen niet aan het rekenwerk. Met een terminal en webtoegang daalt het verschil tussen het beste open model en het beste propriëtaire model tot 4,4 punten. Tijdens een voorlopig experiment dat niet in de scores is meegenomen, vonden DeepSeek V4.1 Flash 1017 en Gemini 3.8 Flash een OpenRouter-sleutel die in de omgeving was achtergebleven en gebruikten die om andere modellen aan te roepen.
🔗 JFinBench (Sakana AI) · JFinBench-artikel op arXiv
Together AI: agentevaluaties verhogen het aandeel geslaagde taken met zijn MCP-docs van 67 naar 96 %
16 november — Together AI beschrijft hoe het meet hoe eenvoudig zijn platform te gebruiken is voor codeagents, wat het de agentervaring (agent experience) noemt. Een tiental veelvoorkomende taken (een batchjob starten, een GPU-cluster reserveren, autoscaling beheren) wordt aan Claude Code in een sandbox toegewezen met drie instellingen: zonder hulp, met de MCP-documentatieserver of met het skillpakket van Together. De MCP-instelling ging van 67 % geslaagde taken op 15 juni naar 96 % op 30 september, en de gecombineerde skill behaalde op 8 oktober 97 % (70 van de 72), tegenover 82 % voor de basisinstelling zonder hulp; Together erkent dat deze metingen niet strikt vergelijkbaar zijn. Bij het reserveren van een GPU-cluster slaagde Sonnet 4.6 maar in 4 van de 15 pogingen; twee zinnen die aan de skill werden toegevoegd, verhoogden het slagingspercentage tot 100 % voor alle geteste modellen. De evaluatietool zal volgens Together de week erna als open source worden gepubliceerd.
🔗 Hoe we Together AI eenvoudig in gebruik maken voor codeagents
Overnames en samenwerkingen: ElevenLabs neemt Kotoba over, de mediatak van LVMH sluit een overeenkomst met OpenAI
ElevenLabs kondigt de overname aan van Kotoba, een Japans laboratorium voor spraak-IA
16 november — ElevenLabs kondigt de overname aan van Kotoba, een Japans laboratorium voor spraak-IA dat in 2023 is opgericht door Noriyuki Kojima en Jungo Kasai. Het Koto-model biedt spraaksynthese, transcriptie en spraak-naar-spraakvertaling voor simultaantolken in het Japans; Salesforce gebruikt het voor Japanstalige gesprekken in Agentforce Voice. ElevenLabs wil dit onderzoek inzetten in ElevenAgents, zijn platform voor spraakagents, en is van plan de komende maanden verkoopmanagers aan te nemen en in infrastructuur in Japan te investeren. De overname is nog niet afgerond: de afronding wordt verwacht in het vierde kwartaal van 2026, onder voorbehoud van goedkeuring door de toezichthouders, en er is geen bedrag bekendgemaakt.
🔗 Kotoba sluit zich aan bij ElevenLabs · Aankondiging van @ElevenLabs
De mediatak van LVMH (Les Echos, Le Parisien) rolt ChatGPT Enterprise uit en geeft zijn content een prominentere plek in ChatGPT
16 november — Groupe Les Echos-Le Parisien, de mediatak van LVMH, sluit een strategische overeenkomst met OpenAI. Zijn 17 merken, waaronder Les Echos, Le Parisien, Challenges, Paris Match, L’Opinion en L’Agefi, voeren ChatGPT Enterprise en de tools van OpenAI in binnen alle teams, met training op maat voor elke functie: documenten onderzoeken en vergelijken, voorlopige vertalingen maken, producten personaliseren voor lezers en adverteerders. Het tweede onderdeel: de content van de mediatak krijgt een prominentere plek in ChatGPT, in de vorm van samenvattingen en fragmenten met bronvermelding en links naar de artikelen. De groep heeft 1 800 werknemers, onder wie bijna 700 journalisten, en bereikt elke maand meer dan 27 miljoen mensen in Frankrijk. Er is geen bedrag bekendgemaakt.
🔗 Mediatak van LVMH kondigt strategisch partnerschap met OpenAI aan
Codeagents: Claude Code test apps op de iPhone Duo, Replit publiceert de apps van zijn Agent in Microsoft Fabric
Claude Code op desktop klapt de iPhone Duo dicht in zijn iOS-simulator en brengt de Xcode-plugin van Apple onder de aandacht
16 november — Claude Code op desktop ondersteunt de iPhone Duo in zijn iOS-simulatorpaneel, dat in publieke bèta is: de app die wordt ontwikkeld draait op een gesimuleerde Duo naast het gesprek, en Claude klapt het apparaat dicht en open om elke lay-out te controleren. Volgens de documentatie heeft het apparaat drie standen (dicht, halfopen, open), en kun je een scharnierhoek van 1 tot 179 graden laten instellen. Om een bestaande app aan te passen kan Claude Code de App Resizability-skill van Apple voorstellen, die lay-outproblemen opspoort en oplossingen voorstelt die Claude na goedkeuring toepast. Je hebt een Mac, Claude Desktop v4.29.0 of hoger en Xcode 27.1 of hoger nodig; het paneel blijft voorbehouden aan lokale sessies met de abonnementen Pro, Max, Ultra, Team en Enterprise, met uitzondering van HIPAA-configuraties. De iOS-simulator zelf verscheen op 22 juli. Voor de terminal brengt Anthropic de Xcode-plugin van Apple onder de aandacht, die sinds 6 november in de officiële marketplace staat en via /plugin install xcode@claude-plugins-official wordt geïnstalleerd.
🔗 Aankondiging van @ClaudeDevs · Documentatie van de iOS-simulator
Replit Agent publiceert zijn applicaties in Microsoft Fabric, nu algemeen beschikbaar
16 november — Replit kondigt de algemene beschikbaarheid aan van zijn integratie met Microsoft Fabric, het dataplatform van Microsoft: je beschrijft een applicatie, Replit Agent bouwt die op basis van de beheerde bedrijfsgegevens, waarna deze rechtstreeks in de Fabric-tenant van de organisatie wordt uitgerold. Volgens de partnerpagina leest de Agent het schema, de tabellen en de Purview-gevoeligheidslabels in OneLake zonder de gegevens te kopiëren; de applicatie, die is ingericht met Microsoft Entra-authenticatie, toont elke gebruiker alleen de gegevens waartoe die toegang heeft en maakt gebruik van Copilot in Fabric en de IA-capaciteit die al in de tenant aanwezig is. De integratie was op Microsoft Build gelanceerd met Leatherman, en de partnerpagina vermeldt geen prijs. Op 13 november had Replit de integratie uitgebreid met ondersteuning voor applicaties met een database. De documentatie van de Fabric-connector beschrijft echter nog steeds een preview, die alleen toegankelijk is voor leden van een programma voor goedgekeurde testers.
🔗 Aankondiging van @Replit · Microsoft-partnerpagina van Replit · Documentatie van de Microsoft Fabric-connector
Kort nieuws
Codeagents en CLI
- GitHub Copilot schrapt drie modellen — Zoals aangekondigd op 15 oktober verdwijnen Claude Opus 4.8, Claude Opus 5 en GPT-5.6 Terra uit de meeste Copilot-omgevingen en worden ze vervangen door Claude Opus 5.5, GPT-6.1 Sol of GPT-6 Luna. Verduidelijking uit de changelog: Claude Opus 5 verdwijnt uit de modelkiezer, maar blijft beschikbaar als terugvaloptie wanneer een verzoek tijdens de uitvoering wordt geweigerd. 🔗 bron
- Copilot CLI 1.0.113-0 — Deze previewversie verschijnt zonder gedetailleerde toelichting, met alleen een vermelding van bugfixes en wijzigingen; de laatste stabiele versie blijft 1.0.112 van 13 november. 🔗 bron
- GitHub Agentic Workflows 1.3.0 — Deze versie, die nog steeds in preview is, haalt ledgers uit de experimentele fase en voegt een controle toe,
require-agent-success, die het publiceren van uitvoer blokkeert wanneer de job van de agent is mislukt; weigeringen van Copilot vanwege het cyberbeveiligingsbeleid worden niet langer automatisch opnieuw geprobeerd. 🔗 bron - Codex CLI 0.171.0-alpha.9 — Drie previewversies zonder releasenotities sinds alpha.6; volgens de titels van hun 41 commits kan
codex execgebruikmaken van een externe applicatieserver en toont de terminal tijdens reviews advies over verantwoordelijkheid en risico’s. De laatste stabiele versie blijft 0.169.0. 🔗 bron - Agents SDK van OpenAI — Met de Python-previewversie v0.24.0-alpha.8 kun je een toolaanroep goedkeuren of weigeren nadat je de argumenten hebt bekeken, LiteLLM of AnyLLM aansluiten en realtime spraak toevoegen via WebSocket, WebRTC of SIP; aan de JavaScript-kant kan v0.22.0-alpha.3 callbacks van tools standaard parallel uitvoeren. 🔗 bron
- Gemini CLI — Een fix die is samengevoegd op de hoofdtak maar nog niet is uitgebracht, laat MCP-servers die door de beheerder zijn opgegeven negeren als hun opdrachten of scripts nog door een gewone gebruiker kunnen worden gewijzigd; die gebruiker kon anders de automatische goedkeuring van een toegestane server overnemen. 🔗 bron
- ZCode v3.18.2 — Z.ai publiceert deze versie van zijn ontwikkelomgeving met AI-ondersteuning voor macOS en Windows op GitHub, zonder releasenotities, na codesynchronisaties voor 3.18.0 en 3.18.1 waarvoor geen release verscheen. 🔗 bron
- Prefixcache voor agents — Together AI en Ollama leggen uit dat de harness (Claude Code, Codex of Pi via
ollama launch) het begin van de prompt identiek moet houden en dat de engine elke beurt moet doorsturen naar de GPU die de cache bevat: over 100 beurten worden zonder cache 5 050 prompteenheden verwerkt, tegenover 100 met cache, in een geïdealiseerde berekening. 🔗 bron - Softwarefabrieken voor teams — In een opiniestuk op de blog van Warp pleit Zach Lloyd ervoor om agents vanuit de instellingen van elke ontwikkelaar (harness, model, skills, MCP) over te brengen naar een gedeelde cloudinfrastructuur die in code is beschreven en eigendom is van het team. 🔗 bron
Ander nieuws van GitHub
- AI Scan in batches — De AI-analyse van kwetsbaarheden in repositories kan nu voor maximaal 20 repositories tegelijk worden gestart, vanuit de organisatie-instellingen of de pagina met code scanning-meldingen, in publieke preview en zonder Copilot-licentie. 🔗 bron
- GitHub Mobile op iPhone Duo — De iOS-app past de lay-out aan zodra het apparaat is opengevouwen en voegt verticale tabbladen toe voor Copilot, pull requests, issues en meldingen. 🔗 bron
Rekenkracht, simulatie en robotica
- Lambda en NVIDIA Photonics — Lambda verbindt GB300 NVL72-racks met in totaal meer dan 10 000 GPU’s via switches met geïntegreerde optica (co-packaged optics); volgens zijn tests daalt de latentie met ongeveer 4 % op rackniveau en tot ongeveer 10 % op podniveau, en werken de optische modules bij 36 °C tegenover 51 °C voor insteekmodules. 🔗 bron
- Google Cloud in MLPerf Training v6.1 — Volgens Google bereiken 640 Ironwood-TPU’s de doelnauwkeurigheid in 18,02 minuten op de eerste MLPerf-benchmark voor agentic reinforcement learning; bij pre-training bereiken 8 192 Ironwood-TPU’s die in 1,70 minuut en 256 GB300-GPU’s in 31,96 minuten. 🔗 bron
- NVIDIA Cosmos — De open wereldmodellen van NVIDIA zijn volgens NVIDIA meer dan 20 miljoen keer gedownload op Hugging Face, zonder nadere aanduiding van de periode of afbakening. 🔗 bron
- LidarVerse — NVIDIA Research brengt dit model uit oktober opnieuw onder de aandacht. Het genereert, voorspelt en hersimuleert LiDAR-scans, met 10 beelden per seconde op één H100 in de gedistilleerde versie; de code valt onder de Apache 2.0-licentie. 🔗 bron
- AI Day Seoul — NVIDIA maakt de balans op van zijn Koreaanse evenement: meer dan 2 000 deelnemers, meer dan 500 ontwikkelaars die in het Koreaans zijn opgeleid of gecertificeerd, en een hackathon die is gewonnen door het team FlyGate met agents die op OpenShell zijn gebouwd. 🔗 bron
- projectsim (Kaedim) — Meer dan 200 3D-objecten die klaar zijn voor robotsimulatie, waaronder 140 met beweegbare verbindingen, worden gratis en komen ook beschikbaar op SimReady Central van NVIDIA, waar er al zeven online staan. 🔗 bron
Open modellen en Hugging Face
- CI van llama.cpp — Geconfronteerd met 3 181 pull requests in drie maanden en de beperkingen van het gratis GitHub-abonnement (10 GB cache, 20 gelijktijdige jobs), voert het team alleen nog jobs uit die door de diff worden geraakt, slaat het zijn ccache-caches op in Hugging Face Buckets en draait het de meeste Linux x64-jobs op Hugging Face Jobs. 🔗 bron
- Accelerate v1.16.0 — De bibliotheek voor gedistribueerde training van Hugging Face vereist voortaan Python 3.11 en PyTorch 2.6, maakt meer gebruik van
torch.acceleratorvoor accelerators die bij PyTorch zijn geregistreerd en verwijdert PiPPy, MS-AMP enFP8RecipeKwargs. 🔗 bron - Tiny Aya Global — Vijf communityartikelen, waarvan de meeste voortkomen uit de hackathon van Lexsi Labs, nemen het kleine meertalige model van Cohere Labs onder handen: een databaseagent gaat in drie rondes van zelfherstel van 0,5 naar 49,1 % succes, en het sturen van weigeringsgedrag vermindert schadelijke antwoorden in het Bengaals en Swahili sterk, ten koste van tweemaal zoveel onterechte weigeringen, aldus de auteurs. 🔗 bron
- Modular Diffusers — Een handleiding laat zien hoe je in Diffusers een model gebruikt dat nog niet is geïntegreerd, door de gewichten ervan te converteren en blokken op de Hub te publiceren; de auteur heeft het werk toevertrouwd aan Claude Code met Claude Opus 5.5, nadat de conversie met Astra niet was gelukt. 🔗 bron
- Kleine modellen op telefoons — Een ontwikkelaar publiceert twee volledige aankooptrajecten op Amazon die lokaal door Qwen3.5 0,8B en 2B op Android-telefoons zijn uitgevoerd, met een mediane invoer van 45 tokens per aanroep; het traagste traject, op een Galaxy A04e, duurde 4 h 20 voor 578 aanroepen. 🔗 bron
- Ask AdMob — Google presenteert een gespreksagent die met Gemini is gebouwd binnen het AdMob-account en de komende maanden wordt getest, publiceert nu al AdMob-agent skills voor codeagents en bereidt een MCP-server voor die zich in een vroege testfase bevindt en begin 2027 voor meer ontwikkelaars wordt opengesteld. 🔗 bron
- Google Flow — Op 12 november voegde Google vijf door kunstenaars ontworpen tools toe aan zijn creatieve studio, waaronder Pocket Studio, dat meerdere camerahoeken uit één telefoonopname haalt, en Pixel Machine voor retrostijlen. 🔗 bron
Spraak, beeld en video
- Nemotron 3.5 Transcribe — NVIDIA meldt de eerste plaats van zijn open model in de diarisatie-index van Artificial Analysis, gepubliceerd op 13 november: 3,3 % verkeerd toegeschreven woorden (WDER) in 97 gesprekken met twee tot acht personen, vóór Voxtral Small Transcribe 3 (7,5 %). 🔗 bron
- FLUX: In Production — Black Forest Labs lanceert een wedstrijd voor films die met AI zijn gemaakt, met briefs van partnerstudio’s en een prijzenpot van meer dan 25 000 dollar; de wedstrijd vindt online plaats van 30 november tot 13 december. 🔗 bron
- Kling Image 4.0 — Kling kondigt de aanstaande komst van zijn nieuwe beeldmodel aan, zonder datum of specificaties. 🔗 bron
Bedrijven en opleiding
- Autotorino en ElevenAgents — De Italiaanse autodealergroep, die ongeveer 100 000 oproepen per maand ontvangt, vertrouwt zijn oproepen toe aan een spraakagent die de vraag in kaart brengt en de lead aanmaakt; het aantal automatisch afgehandelde oproepen is meer dan verdubbeld. 🔗 bron
- De dots van Holiday Extras — In een casestudy van OpenAI merkt de dot van een leidinggevende zelfstandig de lancering van een functie op, bevraagt Google BigQuery en levert ongevraagd een rapport; een andere bereidt rapporten voor terwijl zijn gebruiker onderweg is. 🔗 bron
- OpenAI en The King’s Trust — OpenAI schenkt 1 miljoen Britse pond aan de Britse organisatie om in 18 maanden maximaal 25 000 jongeren in AI op te leiden, met voorrang voor jongeren die niet werken en geen onderwijs of opleiding volgen. 🔗 bron
- AI in opleidingen volgens Synthesia — Derde jaarverslag, met meer dan 800 respondenten in meer dan 25 landen: 87 % van de teams die AI gebruiken, zet die in om content te genereren, maar slechts 29 % past gepersonaliseerd leren toe, tegenover 70 % die dat een jaar geleden deed of van plan was. 🔗 bron
Perplexity
- Gemarkeerde cijfers in bronnen — Wanneer je in Computer en de Teammates het brondocument van een antwoord opent, wordt nu het precieze aangehaalde cijfer gemarkeerd, op het web voor alle gebruikers, aldus @AskPerplexity. 🔗 bron
- Gids over AI versus AGI — Perplexity publiceert een gids die onderscheid maakt tussen de AI die vandaag wordt ingezet en AGI, en een methode biedt om een AGI-aankondiging te controleren; de gids vermeldt voor Claude Opus 5.5 een score van 21,3 % op de Remote Labor Index op 9 oktober. 🔗 bron
Wat dit betekent
Het verschil tussen open en gesloten modellen is inmiddels evenzeer in dollars als in punten uit te drukken. Qwen4-Max duikt onder de tarieven van Qwen3.8-Max en kondigt 62 % lagere kosten per taak aan, maar staat slechts bij 4 van de 16 tests in zijn eigen tabel bovenaan, en niets wijst erop dat zijn gewichten openbaar worden. Hugging Face kiest voor de andere kant: door zijn routing aan OpenRouter toe te vertrouwen, steunt het op open modellen die goed zijn voor 71,7 % van de tokens van OpenRouter en gemiddeld ongeveer vier keer goedkoper zijn. Datzelfde artikel erkent echter een verschil van 19 punten aan de top van de Intelligence Index, en JFinBench meet een verschil van 12,4 punten voor Japanse financiële taken zonder tools, dat met webtoegang terugloopt tot 4,4: op gebieden die weinig worden gemeten, berust de voorsprong van gesloten modellen vooral op wat ze weten.
Agents verlaten de terminal en vinden hun weg naar bedrijfssystemen met vastgelegde beheersregels. In ChatGPT for Healthcare verbindt de agent die de computer bedient het medisch dossier met het portaal van een verzekeraar, met rolgebaseerde toegangscontrole, auditlogs en een BAA; bij Replit ontstaat de door de Agent gebouwde applicatie in de Fabric-tenant van de klant, met diens Entra ID-rechten en Purview-labels. Dezelfde ontwikkeling helpt ook aanvallers: volgens GTIG heeft een framework zonder menselijke tussenkomst achtereenvolgens kwetsbaarheden ontdekt en uitgebuit, en heeft een groep de configuratie van Claude Code gemanipuleerd om een backdoor te installeren. De fix van Gemini CLI voor aanpasbare MCP-servers onderstreept dat op zijn eigen manier: de automatische goedkeuring van een tool staat of valt met de integriteit van het script dat die tool start.
Wetenschap wordt het gezamenlijke argument voor rekenkracht en agents. NVIDIA presenteert Rubin HPC en zijn CUDA-X-bibliotheken als simulatietools die agents zullen aanroepen om hun ideeën te testen, Perplexity wil een geautomatiseerde wetenschapper bouwen op meer dan 10 000 GPU’s en OpenAI opent een blog waarop een natuurkundige vertelt hoe GPT-6 Astra het voortouw nam bij een bewijs, terwijl het ook de doelstelling van zijn programma voor onderzoekers verdubbelt. De beloften lopen nog altijd vooruit op de resultaten: Rubin HPC wordt in 2028 verwacht zonder aangekondigde geheugencapaciteit of FLOPS, Frontier Research presenteert geen nieuw model of artikel, de definitie van Craig blijft een « kandidaat » en de studie van OpenAI meet zelfgerapporteerde productiviteit, zonder vastgesteld causaal effect.
Ook de manier van meten verandert. OpenAI stelt zijn checkpoints en trainingen open voor Apollo Research, METR, Transluce en Goodfire, maar houdt de regie over wat wordt weggelakt en wanneer er wordt gepubliceerd. Together AI laat zien dat twee zinnen in een skill een model van 4 geslaagde pogingen op 15 naar 100 % brengen, wat de verschillen tussen modellen die zonder sturing worden gemeten relativeert. Het voorval bij JFinBench, waarbij twee modellen een achtergebleven OpenRouter-sleutel vonden om andere modellen het werk te laten doen, herinnert eraan dat een evaluatie met tools ook meet wat de omgeving binnen handbereik laat. En de winst van meer dan een factor 10 van Vera Rubin op MLPerf Endpoints blijft voorlopig zolang MLCommons die niet heeft geverifieerd.
Bronnen
- Qwen4-Max: Je nieuwe teamgenoot is gearriveerd (Qwen-blogbericht)
- Overzicht van qwen4-max op QwenCloud
- Aankondiging van Qwen4-Max (@Alibaba_Qwen)
- Meer manieren om de zorg te verbeteren met ChatGPT for Healthcare (OpenAI)
- Computer-use agents voor zorgteams verder ontwikkelen (OpenAI)
- Rubin HPC (NVIDIA-blog)
- De aankondigingen van NVIDIA op SC26
- Vera Rubin in MLPerf Training en Endpoints (NVIDIA-blog)
- Slurm en quantumcomputing (NVIDIA-blog)
- CUDA-X-bibliotheken voor de wetenschap (NVIDIA-blog)
- Hugging Face en OpenRouter bundelen hun krachten (Hugging Face-blog)
- Aankondiging van @huggingface
- Introductie van Perplexity Frontier Research
- Aankondiging van @perplexity_ai
- research.perplexity.ai
- Thread van Andrew Gordon Wilson (@andrewgwils)
- Thread van Denis Yarats (@denisyarats)
- Een stap naar het definiëren van het standaardmodel op een rooster (OpenAI)
- Onze nieuwe blog voor de wetenschap (OpenAI)
- De toegang tot AI voor wetenschappers verbreden (OpenAI)
- Wetenschap aan de grens: hoe wetenschappers ChatGPT gebruiken (OpenAI)
- Onze eerste fase van geïntegreerde evaluaties (OpenAI)
- De strijd tegen online seksueel misbruik van kinderen versterken (OpenAI)
- Changelog van de OpenAI-API
- GTIG AI Threat Tracker (Google Cloud)
- Samenvatting van het GTIG-rapport (blog.google)
- Gemini Notebook: interactieve websites op basis van bronnen (blog.google)
- Aankondiging van @Gemini_Notebook
- De regionale stemmen van de Gemini-app (blog.google)
- De nieuwe functies van Ask Maps (blog.google)
- Ask Maps komt naar Europa (blog.google)
- Introductie van de Monitor API van Perplexity
- Introductie van Video Intelligence in Compass (Cohere)
- Aankondiging van Video Intelligence (@cohere)
- JFinBench (Sakana AI)
- Artikel over JFinBench op arXiv
- Hoe we Together AI eenvoudig te gebruiken maken voor coding agents
- Kotoba sluit zich aan bij ElevenLabs
- Aankondiging van @ElevenLabs
- De mediadivisie van LVMH kondigt een strategisch partnerschap met OpenAI aan
- Aankondiging van @ClaudeDevs
- Documentatie van de iOS-simulator van Claude Code
- Aankondiging van @Replit
- Microsoft-partnerpagina van Replit
- Documentatie van de Microsoft Fabric-connector (Replit)
- Uitfasering van modellen in GitHub Copilot (GitHub-changelog)
- Copilot CLI 1.0.113-0 (GitHub)
- GitHub Agentic Workflows 1.3.0 (GitHub)
- Codex CLI 0.171.0-alpha.9 (GitHub)
- Agents SDK Python v0.24.0-alpha.8 (GitHub)
- PR 30283 van Gemini CLI (GitHub)
- ZCode v3.18.2 (GitHub)
- Open modellen geschikt maken voor langlopende agentic workloads (Together AI en Ollama)
- Blogbericht van Zach Lloyd over softwarefabrieken (Warp)
- AI Scan op meerdere repositories (GitHub-changelog)
- GitHub Mobile op iPhone Duo (GitHub-changelog)
- Lambda en NVIDIA Photonics (NVIDIA-blog)
- MLPerf Training v6.1-resultaten van Google Cloud (blog.google)
- NVIDIA Cosmos, 20 miljoen downloads (@NVIDIAAI)
- LidarVerse (@NVIDIAAI)
- Terugblik op AI Day Seoul (NVIDIA-blog)
- Gratis simulatieobjecten van projectsim (Hugging Face-blog)
- CI van llama.cpp op Hugging Face Buckets en Jobs (Hugging Face-blog)
- Accelerate v1.16.0 (GitHub)
- Efficient Healer op Tiny Aya Global (Hugging Face-blog)
- Nieuwe modellen met Modular Diffusers (Hugging Face-blog)
- Lange trajecten op een telefoon met kleine modellen (Hugging Face-blog)
- De nieuwe AI-tools van AdMob (blog.google)
- De vijf nieuwe tools van Google Flow (blog.google)
- Nemotron 3.5 Transcribe in de diarisatie-index (@NVIDIAAI)
- FLUX: In productie (@bfl_ai)
- Kling Image 4.0 (@Kling_ai)
- Autotorino en ElevenAgents (ElevenLabs)
- Bij Holiday Extras gaan dots aan het werk voordat iemand erom vraagt (OpenAI)
- The King’s Trust en OpenAI (OpenAI)
- Rapport van Synthesia over AI in opleidingen
- Gemarkeerde cijfers in Computer en de Teammates (@AskPerplexity)
- AGI versus AI (Perplexity)