ai-powered-markdown-translatorgpt-5.6-solを使用してフランス語から日本語に翻訳された記事。
その大半が9月11日に発表された52件の告知には、互いに連携していない企業の間で同じ発想が繰り返し現れている。Cursorはプロジェクト全体を、自らはコードを書かず数千のサブエージェントへ作業を委任するコーディネーターエージェントに任せ、Cognitionは開発者のマシン上で2つのモデルをペアとして動かし、Sakanaは各タスクを解決可能な最軽量モデルへ振り分ける。同じ日に、OpenAIはライフサイエンスモデルの研究プレビューを終了して公開料金表を示し、Runwayは企業向けにクローズドモデルの重みをライセンス提供し、Anthropicはプラグインが実際にもたらす価値をついに測定できるサブコマンドを公開した。
Cursorがコーディネーターエージェント主導のプロジェクト環境Projectsを発表
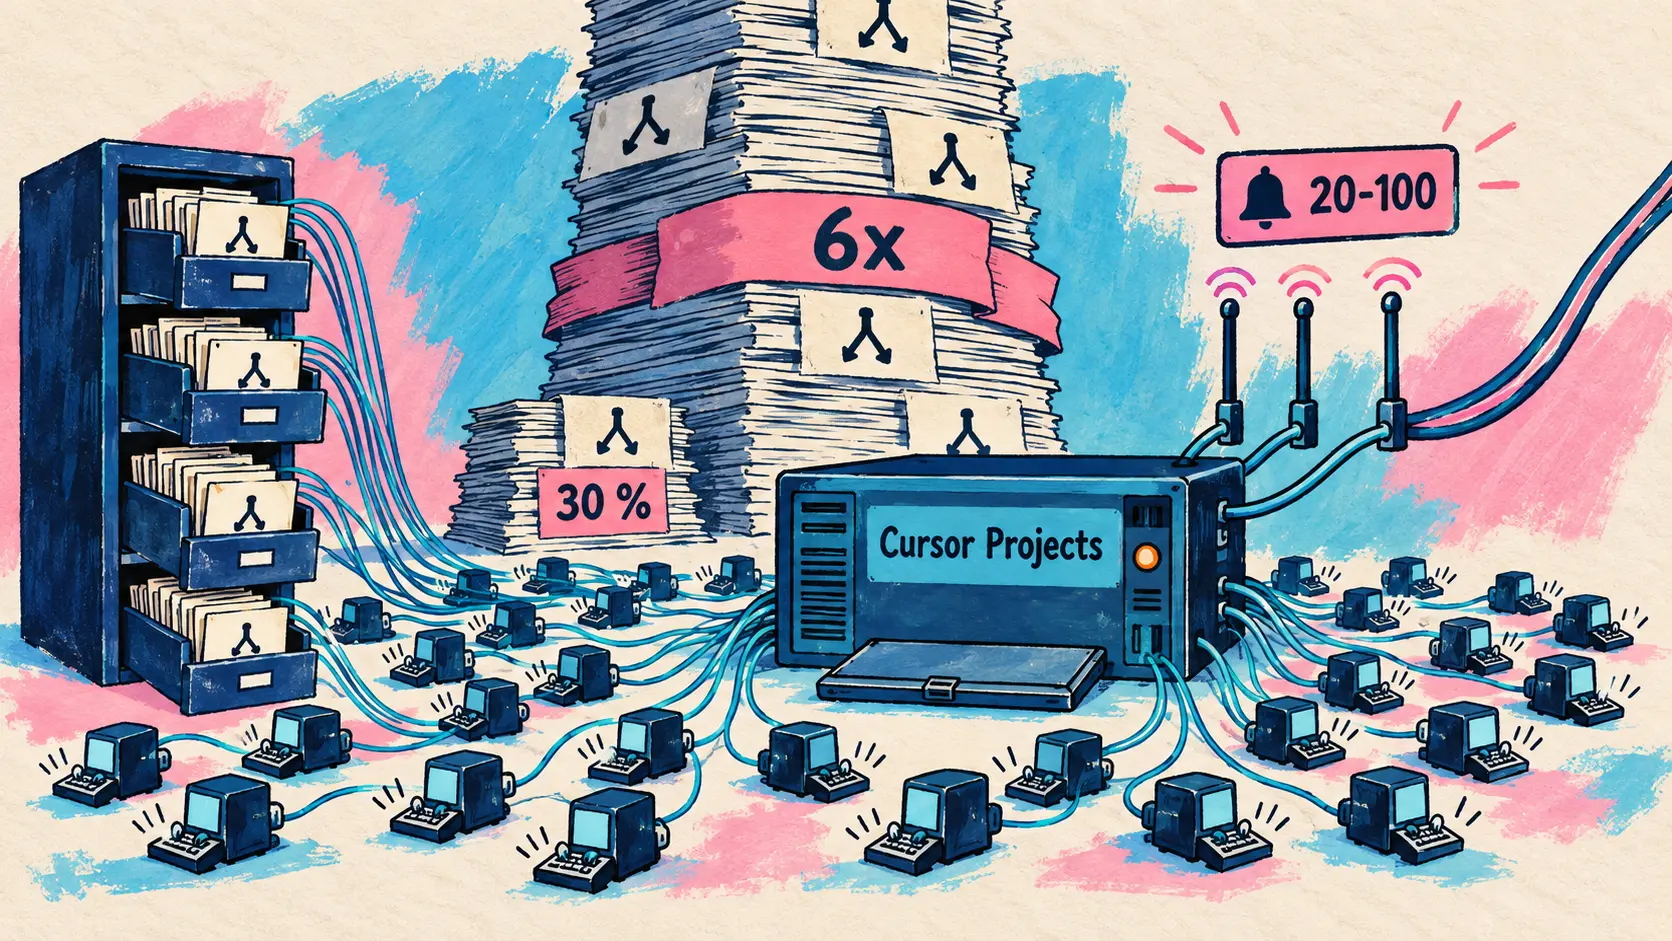
9月10日 — Cursorは、エディター内でエージェントに作業を任せる方法を刷新するProjectsを発表した。この製品は、過去2年間で定着した習慣を覆す。タスクごとに新しい会話を開いて完了後に閉じるのではなく、ユーザーは数か月にわたって続くスレッドでコーディネーターエージェントと対話する。このコーディネーターはコードを一行も書かない。コードを書くほかのエージェントを指揮するため、作業が進んでいる間も常に新しい指示を受け取れる。
これを可能にする仕組みは3つある。まず、デフォルトのクラウド実行だ。各Projectは専用マシン上で動作するため、ノートパソコンを閉じても中断されず、並列稼働できるサブエージェント数もローカルのハードウェアに制限されない。開発者のマシン上でテストを実行する必要がある場合は、ローカルエージェントが起動する。次に、共有コンテキストがある。各Projectはすべてのマシン間で同期される一連のファイルを保持し、エージェントはそこへ調査結果、成果物、コードについて理解した内容を保存する。あるエージェントがサービスのテスト方法を発見すれば、後続のすべてのエージェントがその手順を利用できる。3つ目の仕組みは最も珍しい。Cursorはこれをサブスクリプション(subscriptions)と呼んでいる。コーディネーターはSlackチャンネルを監視したり、スケジュールに従って実行したり、すべてのpull requestを追跡して継続的インテグレーションを修復したりできる。エージェントは依頼を待たず、シグナルの検出を契機に動作する。
| 測定対象 | pull requestへの測定された効果 |
|---|---|
| Projectsの新規ユーザー | マージ数が30パーセント増加 |
| 主にProjectsで作業するユーザー | マージ数が6倍 |
| 社内design systemのProject | 1日当たり20~100件のpull requestに関与すると予測 |
The coordinator doesn’t write code itself but directs other agents that do. Because it delegates rather than executes, it is never blocked and is always responsive to direction.
🇯🇵 コーディネーター自身はコードを書かず、それを行うほかのエージェントを指揮します。実行するのではなく委任するため、作業に塞がれることがなく、常に指示を受け取れます。 — CursorのProjectsブログ
これらは社内測定値であり、相応の注意をもって解釈する必要がある。最も分かりやすい例は「ガーデニング」だ。これはCursorが終わりのない作業に付けた名称である。あるエンジニアはdesign system専用のProjectを稼働させ、すべての新しいpull requestを確認し、システムへ組み込むべきコンポーネントを抽出し、同じエラーを2回見つけるたびにlintルールを追加している。Projectsはベータ版で、9月10日から段階的に展開されている。発表では料金条件もプラン上の制限も示されていない。
GPT-Rosalindが研究プレビューを終了し、料金表を公開
9月11日 — OpenAI Developersは、ライフサイエンス向け推論モデルGPT-Rosalindの研究プレビュー(research preview)終了を発表した。生物学研究、創薬、トランスレーショナル医療向けとして2026年4月16日に発表された当時、このモデルを利用できたのは米国内の対象Enterprise顧客に限られていた。今後は世界中の対象組織がAPI、Codex、ChatGPT Enterpriseを通じて信頼アクセス(trusted access)を利用でき、シリーズの今後のモデルもリリースに合わせてこのアクセスの対象となる。
9月8日付のAPI changelogには、Xのスレッドで触れられていない詳細が記載されている。モデル名はgpt-rosalind-researchであり、一般提供についても、OpenAIが承認した社内ライフサイエンス研究に限定される信頼アクセスプログラムへの参加が条件となる。
| 料金またはアクセス項目 | 発表された内容 |
|---|---|
| モデル識別子 | gpt-rosalind-research |
| 入力tokens | 100万当たり5ドル |
| キャッシュ済み入力tokens | 100万当たり0.50ドル |
| 出力tokens | 100万当たり25ドル |
| 課金開始日 | 2026年10月5日 |
| アクセス手段 | API、Codex、ChatGPT Enterprise |
| アクセス条件 | 信頼アクセスプログラム、対象組織 |
課金が始まるのは10月5日からだ。研究プレビュー期間中は、利用してもクレジットもtokensも消費されなかった。ツール面では、CodexのLife Sciencesプラグインがモデルのオーケストレーション層を構成し、ゲノミクスからタンパク質構造、トランスレーショナル研究まで、生物学的証拠の収集から品質管理レポートやインタラクティブなnotebookの生成までをカバーする。4月にGitHubで無料公開されたこのパッケージからは、50を超える公開マルチオミクスデータベース、文献情報源、生物学ツールへアクセスできる。汎用モデルとの組み合わせは誰でも利用できるが、GPT-Rosalindと組み合わせられるのは対象のEnterpriseユーザーだけだ。
公称性能は発表時から変わっていない。BixBenchで公開済みの最高スコアを記録し、LABBench2の11タスク中6タスクでGPT-5.4を上回り、特にCloningQAで最大の差を付けた。また、Dyno Therapeuticsと共同設計したRNA配列・機能タスクでは、最良の提出結果が予測に参加した57人の専門家の95パーセンタイルを上回った。具体的なニュースは2つある。専門モデルが公開料金とともに実験段階を脱したこと、そしてアクセス可能な地域が拡大したことだ。ただし利用資格という制約は残り、セルフサービスでは開放されていない。
Runway Model Licensing、クローズドモデルの重みを企業へ提供
9月11日 — Runwayは企業向けモデルライセンスプログラム(Model Licensing)を開始した。その仕組みはAPI経由のアクセスとは異なる。顧客はRunwayの最新世代モデルの完全な重みを受け取り、自社データでfine-tuningし、自社インフラストラクチャ上でホストし、そこから得られる成果を商用化できる。データと生成物が顧客環境の外へ出ることはなく、明確にスタジオ、ブランド、政府機関を対象としている。
| 提供項目 | 内容 |
|---|---|
| モデルの重み | 出発点となる完全な重み |
| Checkpoints | 検証対象となる複数バージョンのモデル |
| 学習スクリプト | 自社データを追加しfine-tuningを実行するためのコード |
| 納品 | 顧客のcodebaseに組み込んだ形でパッケージ化し、希望する場所でホスト |
| 派遣される研究者 | 設定、重み、納品に関する実践的支援 |
ホスティング先は、顧客のクラウド、データセンター、または完全なオンプレミスから選べる。行政機関向けには、ネットワークから隔離された環境(air-gapped)にも対応する。対象として6つの分野が挙げられている。ソフトウェアプラットフォーム、映画・スタジオ、ブランド・マーケティング、World Action Modelをポリシーの基幹(policy backbone)として利用するロボティクス・物理AI、低品質レンダリングを写実的に向上させるゲーム・3D、そして政府機関だ。
経済面でRunwayは2つの選択肢を区別している。Runway Devは従量課金制のAPIで、インフラストラクチャを管理する必要がない。一方、年間ライセンスはコストを予測でき、バージョン、動作、出力を完全に制御できる。FAQでは陳腐化への懸念にも回答している。将来のモデルは顧客の専有データへアクセスできないため、年間更新を用意し、次世代モデルに使えるクレジットも付与するという。社内で再構築する場合のコストは、何年にもわたる学習と数億ドルに達するとしている。同社は、この品質のクローズドモデルの重みをライセンス提供する世界でもごく少数の企業の一つだと位置付け、オープンな重みについては、より弱いモデルと作業リストを渡すものだとして真っ向から対比している。料金は公開されておらず、アクセスには営業用フォームからの申し込みが必要だ。この発表はRunway Dev MCPの9日後、Teamプランの1週間後に行われた。これによりRunwayは、個人クリエイターからクローズドモデルの重みのライセンスまで、あらゆる範囲をカバーすることになる。
CognitionがFusionをDevin DesktopとDevin CLIへ導入
9月11日 — Cognitionは、Devin DesktopとDevin CLIでFusionが利用可能になったと発表した。このアーキテクチャは数か月前からDevin Cloud上で稼働していたが、今後は開発者のマシン上でも動作する。この発表は自社製コードモデルSWE-2の翌日に行われた。SWE-2がこの構成で推奨されるセカンドモデルであるため、両者は相互に関係している。
仕組みは簡単だ。Fusionを選ぶとき、選択するのは1つではなく2つのモデルである。最先端モデルがリーダー(lead)を務め、セッションの主導権を握る。計画を保持し、曖昧な点を判断し、提出された作業をレビューする。より低コストのモデルはセカンド(sidekick)を務め、コードを調査し、変更を書き、テストを実行して結果を報告する。両者はそれぞれ固有の永続的コンテキストを持ち、並列で稼働する。技術的な主張は、費用を抑える方法として直感的に思い浮かぶモデルルーティングへの反論になっている。最初のpromptだけではタスクの難易度を測れず、途中でモデルを切り替えるとprompt cacheが失われるためだ。Fusionは、2つのモデル間で会話全体を一切受け渡さず、概要、結果、フィードバックだけを交換することでこの問題を回避する。
| タスク当たりのコスト(ドル) | Fable 5.1単体 | Fusion Fable 5.1とSWE-2 | Astra単体 | Fusion AstraとSWE-2 |
|---|---|---|---|---|
| DeepSWE 1.1 | 14,63 | 7,88 | 7,88 | 4,69 |
| Terminal-Bench 4 | 17,46 | 13,37 | 10,08 | 6,06 |
| SWE-Atlas QnA | 7,57 | 5,00 | 5,72 | 3,59 |
| Vals Code Migration | 70,97 | 42,00 | 44,36 | 35,51 |
| 拡張版FrontierCode 1.1 | 2,68 | 1,67 | 2,62 | 2,34 |
One of our key findings is that using more expensive models can make the entire system cheaper.
🇯🇵 私たちの主な発見の一つは、より高価なモデルを使用すると、システム全体のコストが下がり得るということです。 — CognitionのローカルFusionに関するブログ
これはペアの両側で実証されている。リーダー側では、Opus 4.8をtoken当たりの名目価格が2倍のFable 5に置き換えると、セカンドが同じでもセッションの平均コストが9パーセント低下し、FrontierCodeのスコアも向上した。Fableはより早い段階で委任し、Opusがセカンドを細かく管理していた場面で、より優れた概要を作成した。セカンド側では、GPT-5.6 Lunaから、100万tokens当たりの価格が275パーセント高いSWE-2へ切り替えると、1.4ポイント向上しながらタスク全体のコストが2パーセント低下する。Artificial Analysis Coding Agent Index v1.5では、Fable 5.1とSWE-2を組み合わせたFusionが61.7を記録した。これは62.2にとどまるFable 5.1搭載Claude Codeよりコストが36パーセント低い。Cognitionはここから、2026年にはモデルとモデル・harnessの組み合わせをtoken当たりの価格ではなくタスク当たりの価格で評価すべきだという原則を導き出している。harnessを販売する企業にとって都合のよい立場ではあるものの、数値はArtificial AnalysisおよびVals AIとともに、5つの異なるbenchmarkを用いて算出されている。インストールは単一のコマンドで行える。
Sakana AI、マルチエージェントオーケストレーターを進化させたFugu MaxとFugu Ultra v2を発表
9月11日 — Sakana AIは、単一のOpenAI互換APIを通じて提供されるマルチエージェントオーケストレーションシステム(multi-agent orchestration system)Sakana Fuguの新バージョン、Fugu MaxとFugu Ultra v2を公開した。中心となる考え方はパレートフロンティアだ。Sakanaは、実際のタスクは能力とコストという2つの軸で評価されるにもかかわらず、業界はいまだに能力だけが唯一の軸であるかのように考えているとみている。
Fuguは単一のモデルではなく、オープンウェイトの専門モデル群に各タスクを振り分ける、学習済みのオーケストレーションレイヤーである。Fugu Maxは、同社によれば過去最大となるこのプールにNVIDIA Nemotronファミリーを組み込み、各タスクを解決可能な最も軽量なモデルに送る。6つのベンチマークで総合最高スコアを獲得し、10件中7件でコストパフォーマンスのフロンティアを拡張した。料金は入力100万トークン当たり2ドル、出力100万トークン当たり6ドルで、Sakanaによると、この出力料金はSonnet 5、GPT 5.6 Terra、Kimi K3より40~60パーセント低い。
| 公表された測定項目 | スコア | Sakanaによる比較 |
|---|---|---|
| Fugu Ultra v2、Chartography | 48,3 | Opus 5は27,3、Fable 5は29,5 |
| Fugu Ultra v2、DeepSWE | 74,3 | トークン単価が3~5倍高いモデルを上回る |
| Fugu Ultra v2、順位 | 8つのベンチマークのうち5つで1位または同率1位 | 8つのうち7つで上位2位以内 |
| Fugu Max、総合順位 | 6つのベンチマークで最高スコア | 10件中7件でパレートフロンティアを拡張 |
Sakanaが最も強調している点は注目に値する。Fable 5、Fable 5.1、GPT-6-Astraは、学習データのカットオフ日が2026年8月28日であるFugu Ultra v2のエージェントプールには含まれていない。その根拠は供給面でのレジリエンスであり、交換可能なモデルプールによってベンダーロックイン、APIの利用取り消し、サービス停止から保護するというものだ。両モデルは即時利用可能で、Fuguの利用者はパラメーターを1つ変更するだけでMaxまたはUltra v2へ切り替えられる。Fugu MaxはOpenRouterにも掲載されており、マルチモーダル入力、ウェブ検索、設定可能な推論、構造化出力に対応する。利用上の留意点として、ベンチマークと比較対象はSakanaが選定しており、SWEFishは社内ベンチマークで、主張される差は公開時点における比較対象モデルの料金に左右される。
ElevenLabs、全プランでロスレスダウンロードに対応したMusic v2.5を発表
9月11日 — ElevenLabsはMusic v2.5を公開し、プロンプト生成と音声参照生成の双方でElevenMusicのデフォルトモデルに設定した。同モデルは、ライブ録音のように聞こえる楽器、より奥行きのあるアレンジ、長尺の楽曲、曲中でのジャンル移行、ラップ、そして歌詞の言語を母語とするように聞こえるボーカルを特徴として掲げている。提示された評価は、同じプロンプトについて各モデルが1テイクずつ生成した47 885組を対象とするブラインドテストだ。Music v2.5は過半数の比較で好まれ、とりわけボーカルとアコースティック要素が中心となるR&B、ソウル、ヒップホップ、ロック、メタル、オーケストラ、映画音楽で最も明確な差が出た。正確な選好率は公表されていない。
第2の変更は、利用者にとってさらに大きな意味を持つ。ElevenMusicで作成した楽曲は、無料プランを含むすべてのプランで作者に帰属する。無料プランでは、ElevenMusicのクレジット表記を条件に商用利用できるロスレス(lossless)ダウンロードが1日5件提供され、Proプランでは月400件提供される。作成時に取得した権利は楽曲に紐づいたままとなる。解約やダウングレードをしても、すでに制作した楽曲には影響せず、将来の規約変更も新たに作成する楽曲にのみ適用される。唯一の例外は、別のアーティストの楽曲を基に作成した曲で、ダウンロードが禁止される。
| 測定または発表された項目 | 値 |
|---|---|
| ブラインドテストで評価された組数 | 47 885 |
| ロスレスダウンロード、Freeプラン | 1日5件、クレジット表記により商用利用可 |
| ロスレスダウンロード、Proプラン | 月400件 |
| API識別子 | music_v2_5 |
| ElevenMusicのデフォルトモデル | Music v2.5、Music v2も維持 |
同モデルはElevenCreativeでも、Flows内のMusicノードとして、またAPIでは識別子music_v2_5として利用できる。ElevenLabsは、前日に発表したUniversal Music Groupとの複数年契約は今回のリリースとは別のものだと明記している。読者にとっては発表の順序が重要だ。大手レーベルとの契約が先に発表され、その翌日にモデルと拡張された利用権が公開された。
Claude Code、プラグインの有無を比較して実際の効果を測定
9月11日 — Claude Developersチームは、Claude Codeのサブコマンドclaude plugin evalを発表した。このサブコマンドは、テストケース一式に対してプラグインまたはskillを実行して各実行を採点した後、プラグインなしで各ケースを再実行し、その効果を測定する。考え方は単純だが、少々耳が痛い。Claudeはプラグインなしでも同程度に成功することがあるため、高スコアだからといってプラグインが役立っている証明にはならない。そこでコマンドは2つのスコアとその差を返す。あるケースが両方の条件で1,0を獲得した場合、その結果にプラグインは寄与していない。
エントリーポイントはclaude plugin eval initで、プラグインのルートから起動する。対話型セッションが開き、Claudeがプラグインを読み取り、良好な結果がどのようなものかを尋ね、発動すべきプロンプトと発動すべきでないプロンプトを提案し、検証器(graders)を設計して一度試行し、ケースごとのディレクトリを作成して、完全な実行の推定コストを提示する。その後、非決定的なエージェントを1回実行しただけではほとんど意味がないため、各ケースをプラグインありで3回、なしで3回、計6回実行する。端末にはプラグインありとなしの結果を示す表が表示され、自己完結型のHTMLレポートがディスクに書き込まれ、アカウントが対応している場合は非公開の成果物として公開される。
| 検証器の種類 | モデル呼び出しコスト | 成功条件 |
|---|---|---|
regex | なし | 最後の応答、トレース、またはファイル内でパターンが見つかる |
tool_used | なし | ツールの呼び出し回数が最小値から最大値の範囲内 |
tool_order | なし | ある呼び出しが別の呼び出しより先に行われる |
file_exists | なし | 実行中に作成されたファイルがパターンに一致する |
llm | 1つのモデルが判定 | 3票中少なくとも2票が肯定的な判定 |
baseline | 1つのモデルが判定 | 実行結果が少なくとも参照用トランスクリプトと同等 |
差を解釈する前に理解しておくべき微妙な点がある。skillの呼び出しを必須とする検証器は、プラグインなしでは絶対に合格できない。そのため差が人為的に膨らまないよう、両方の条件でスコアから除外され、指標としてのみ報告される。分離は厳格だ。各実行は使い捨ての子プロセスで行われ、ユーザー設定、hook、CLAUDE.md、MCPサーバー、インストール済みプラグイン、メモリは一切利用されない。実行中に権限確認の質問が表示されることはなく、明示的に許可されない限り機密性の高いツールはセッションから除外される。サンドボックス用バックエンドのないマシンでBashまたはPowerShellを許可した場合、Claude Codeは隔離なしで実行するのではなく、実行自体を拒否する。MCPツールと通信するプラグインは実際のサービスなしでも評価でき、ツールごとに用意したMarkdownファイルが応答を返す。プラグインが想定外の内容を送信した場合は、ブロックによって実行が中止される。
Evals call the model, so they use tokens and results vary. […] Your plugin’s hooks and MCP servers run as you, so only evaluate plugins you trust.
🇯🇵 評価ではモデルが呼び出されるため、トークンを消費し、結果も変動します。[…] プラグインのhookとMCPサーバーは利用者の権限で動作するため、信頼できるプラグインだけを評価してください。 — Xの@ClaudeDevs
コストは実際に発生する。各実行と各判定用検証器はモデル呼び出しとしてプランまたは請求額に計上され、ドキュメントの例では6回実行する1ケースに74秒と0,41ドルかかっている。そのためチームは、完全な実行を開始する前に、まず--runs 1で試行するよう案内している。継続的インテグレーション向けには終了コードも文書化されており、すべて合格した場合は0、コスト上限に達して部分的な実行となった場合は2となる。ドキュメントによれば、典型的な最初の発見は、skill検証器が失敗しているのに差がほぼゼロというものだ。Claudeが自然な表現からskillを選択できておらず、見直すべきなのはその説明文である。
バージョン2.1.269のその他の変更点
このサブコマンドは、9月11日21時17分(パリ時間)に公開されたバージョン2.1.269に追加された。その他の追加機能はより控えめだが、日常的に役立つ。コマンド/output-styleでは、Remote Control経由やクラウドまたはヘッドレスセッションを含め、出力スタイルの一覧表示と変更ができる。Bashツールでファイルを変更した場合、その結果に変更ファイルのdiffが含まれるようになり、通常の編集と同じ可視性がClaudeにも与えられる。可観測性に関しては、環境変数によってリポジトリごとにOpenTelemetryのメトリクスとイベントへラベルを付けられるようになった。さらに2つの環境変数で、ゲートウェイのモデル検出タイムアウトと、Workflowツールの同時エージェント数上限を最大256まで設定できる。
修正は3つの重要な領域に及ぶ。応答が中断されてから再開された後に発生するプロンプトキャッシュの部分的な無効化、否定から始まる権限ルールがそのルールを書き込んだ設定ソースにのみ適用されるようになったこと、そしてteeコマンドが書き込むファイルも最終的に書き込みパス検証の対象となったことだ。compaction後に通知されるgit statusは、セッション開始時のものではなく現在のものになった。VS Codeでは、バッジからサブエージェントのマップを開けるようになり、各エージェントのカード、停止ボタン、読み取り専用のトランスクリプトが表示される。また、ユーザー、プロジェクト、ローカルの各設定でhookと権限ルールを管理するための2つのダイアログも追加された。
Antigravity、1週間で4バージョンを公開し、Teamworkの未紹介分も補完
Googleは、未紹介だった過去2バージョンに加え、コマンドラインの2バージョンとアプリケーションの新バージョンを立て続けに公開した。今週のリリースはいずれも同じ流れを示しているため、changelogはまとめて読む価値がある。エージェントは対話型端末を離れ、サービスへと変わりつつある。
Antigravity CLI 1.2.0:CLIがRemote Controlで操作するバックグラウンドデーモンに
9月10日 — Antigravity CLIバージョン1.2.0は、7月以来初のマイナーバージョンアップである。3つのサブコマンドremote-control start、status、stopによって、コマンドラインをシステムのサービスマネージャーへバックグラウンドデーモンとして登録できる。このデーモンはログアウトや再起動後も存続し、インスタンス名を指定するオプションと、サービスをアクティブなログインセッションに限定するオプションが用意されている。これまでは端末を開いたまま動作させる必要があった。半ページ単位のスクロールが、2つの新しいデフォルトショートカットとともにすべてのビューへ拡張された。8件の修正のうち、予期しない挙動を理解するうえで最も役立つ変更は、コンテンツ安全フィルターによってプロンプトまたは応答がブロックされた場合、従来の一般的なエラーや空のターンに代わり、明確な停止理由が表示されるようになったことだ。グローバルプラグインに組み込まれたMCPサーバーも、起動時に正しく初期化されるようになった。
Antigravity CLI 1.1.28:エラー再試行の拡張、ヘッドレスモードの高速化、URL読み取りに承認を追加
9月9日 — 前日に公開されたバージョン1.1.28では、スクリプトから呼び出すヘッドレスモードとレジリエンスに関する9件の改善が中心となった。モデルAPIの一時的なエラーは、拡張された指数バックオフで再試行される。起動時にユーザーIDを取得するためのネットワークリクエストは発生しなくなり、各ターンから最大200ミリ秒のアイドル遅延が削減された。自動化を行う利用者が注意すべき挙動変更は2つある。
| 挙動の変更 | バージョン1.1.28より前 | バージョン1.1.28以降 |
|---|---|---|
| スクリプトモードでのタイムアウト | タイムアウトで失敗 | 部分出力を返し、成功コードと警告を出力 |
| エージェントによる外部URLの読み取り | 確認なし | 事前承認済みでない限り、デフォルトで承認を要求 |
したがって、暗黙的なウェブアクセスに依存していたスクリプトでは、その権限を明示的に付与する必要がある。承認プロンプトには正確なアクション名が表示されるようになり、要求がhookまたは別プロジェクトに属するファイルから発生した場合は、その理由を示す行も追加される。
Antigravity CLI 1.1.26と1.1.27の補完:別モデルへの単発プロンプトとfrontmatterでのサブエージェント依存関係
9月4日と5日 — バージョン1.1.26と1.1.27は未紹介分を補い、この一連のリリースで最も具体的な新機能をもたらした。モデル選択コマンドがプロンプトを受け付けるようになり、別のモデルで一度だけ実行した後、セッションは元のモデルへ戻る。デフォルト設定に触れることなく、より高性能または低コストなモデルからセカンドオピニオンを得られる。同じバージョンでは、カスタムエージェントのMarkdown frontmatterにエージェント一覧が追加され、依存するサブエージェントを宣言できるようになった。自動化に重要な修正も2件ある。サーバーのスキーマに宣言されていない引数を含むMCP呼び出しは、黙って削除されるのではなく、拒否されて修正されるようになった。また、ヘッドレス実行では、拒否されたアクションを何も言わずに無視するのではなく、JSON出力内でその名前を示すようになった。
Antigravity 2.13.0:Documentsセクション、SQL・JSONL向け仮想化ビューア、引用ショートカット
9月9日 — Antigravity 2.13.0では、16件の改善と16件の修正が加えられた。会話に追加された外部ファイル、Google Driveリンク、PDF、Office文書は、エージェントの生成物に混在するのではなく、Artifactsの上にあるDocumentsセクションにまとめられる。エージェントが自分用に書く下書きファイルは、別のセクションに配置される。SQLやJSONLファイルなどのコード・データのアーティファクトは、シンタックスハイライトと行番号を備えた仮想化ビューアで開かれ、大容量ファイルでも滑らかに動作し、インラインコメントにも対応する。閉じたサイド質問は消去されずボタンに縮小され、対話型プロンプトにはキャンセルボタンが追加され、選択したテキストをキーボードショートカットでチャットに引用できるようになった。権限の透明性に関する修正も2件あり、拒否されたステップは消えずにRejectedラベル付きで表示され続け、プロジェクト外へのアクセスがすでに許可されている場合、エージェントが別プロジェクトのアーティファクトを読む権限を再度求めることもなくなった。
Teamwork、8月27日分の振り返り
8月27日に公開され、ここではまだ取り上げておらず、現在もGemini新機能ページの開発者向けセクションの先頭に掲載されている記事は、振り返って紹介する価値がある。TeamworkはAntigravityのマルチエージェント・オーケストレーション基盤であり、エージェント同士が数時間から数日にわたって互いの成果を提案、批評、改良する。すべての有料プランでプレビュー版として利用できる。反復的なコーディングから文書レビュー、長時間の証明まで、プロンプトに応じて自動選択される5つのパターンが提供される。長時間証明パターンでは、GoogleはKnuthのサイクル予想を含む7件の未解決問題を解決したと発表している。この予想については40ページ超と70ページ超の証明が作成され、40ページの証明はLeanで形式検証された。その他の結果は人間の専門家によって確認され、5本の論文がarXivに投稿されている。
| 報告された測定項目 | 値 |
|---|---|
| TCSBench、長時間証明でのGemini 3.7 Flashと3.1 Pro | 71パーセント |
| TCSBench、元論文でのGemini 3.6 Flashと3.1 Pro | 67.7パーセント |
| RISC-Vシミュレーター、サイクル整合誤差 | 0.71パーセント |
| Gemini 3.7 Flashで再現された問題 | 7件中3件 |
数学以外では、Teamworkはアウト・オブ・オーダー実行に対応したサイクル精度のRISC-Vプロセッサーシミュレーターをゼロから構築した。このシミュレーターはxv6システムをシェルまで起動し、100件を超える標準ベンチマークを実行でき、ハードウェア上の実行結果と照合して検証されている。また、オープンソースプロジェクトへの2件の貢献が上流に取り込まれた。Eigenのベクトル化された高速パスと、64スレッドで挿入スループットを2倍にした並行ハッシュテーブルの派生版である。
GitHub Copilotが自身のコメントを解決し、アプリにJiraを統合
コードレビューがエージェント群へ移行
9月11日 — GitHubはCopilot code reviewを2つの面で更新した。ユーザー体験の面では、後続のコミットがCopilotのコメントに対応すると、レビューがそのコメントを自動的に解決するため、未解決コメントの一覧には対応待ちのものだけが残る。また、コード提案を適用すると、Copilotは事前入力されたメッセージではなく、変更内容に適したコミットメッセージを作成する。分析の面では、レビューエージェントがCopilot SDKのすべてのシェルツールを利用できるようになり、それらはエージェントのファイアウォール内で実行される。エージェントはビルド、テスト、対象を絞ったスクリプトの実行、アクセス可能なAPIへの問い合わせを行い、レビュー中のコードを検証できる。GitHubは肯定的なフィードバックが増え、重大度の高い指摘が増加し、細部に関する指摘が減ったと報告しているが、この点について数値は示していない。
一方、Liteの作業レベルは単独のエージェントではなくなり、それぞれが独自の観点を提供し、1件のレビューに統合するエージェント群を採用している。
| 測定結果、エージェント群によるLiteレビュー | 発表された変化 |
|---|---|
| 採用されたコメント、重大度:高 | 47パーセント増 |
| 採用されたコメント、重大度:中 | 31パーセント増 |
| 採用されたコメント、重大度:低 | 11パーセント増 |
| 1回のレビュー費用 | 約8パーセント減 |
エージェント群のエージェント数も、使用されるモデルも明らかにされていない。これは2週間で3回目となるCopilot code reviewの進化である。
アプリのJira、コマンドラインのHydraFusion、VS Code 1.137
9月10日 — Copilot Dayが行われた9月7日の週の週間まとめでは、CopilotアプリへのJira統合が追加された。チケットが共有キャンバスに取り込まれ、そこで進める項目を選択すると、Copilotがチケットのコンテキストを調査、実装、pull requestの準備まで引き継ぐ。Copilot CLIでは、Project HydraFusionをほかのモデルと同様に選択できるようになり、タスクごとにローカル、クラウド、複合モデルの間から処理経路を選び、性能、コスト、レイテンシーのバランスを取る。
9月9日にリリースされたVS Code 1.137では、3つのエージェント機能が追加された。公開プレビュー版の自動化機能は、issueの分類やバグ探索など、提供されたテンプレートを基に、エージェントの反復タスクを毎時、毎日、または毎週実行するようスケジュールする。実験的な音声モードでは、作業中のエージェントに話しかけたり、中断したり、別の方向へ導いたりできる。さらに、リポジトリを開いていなくても、issueまたはpull requestへのリンクがAgentsウィンドウで直接開くようになった。リリースノートには、専用プロトコルを基盤としCopilot SDKを利用するエージェントホストも追加されており、VS Codeエージェントの動作をコマンドライン版およびアプリ版と一致させている。
Habitat、OpenAIのオンラインストレージと2人のエンジニアによるRustでの再実装
9月11日 — OpenAIは、ChatGPT、API、Codexを支えるオンラインストレージ基盤Habitatについて、エンジニアリング記事の第1部を公開した。その規模は数字に表れている。毎秒7,000万件を超えるリクエスト、毎週10億人を超える利用者、約40のリージョン、500ペタバイトを超えるデータである。Habitatは2024年半ば、ChatGPTのメインサーバーに組み込まれ、マネージドデータベースへ接続する小規模なPythonライブラリとして始まった。その発想は単純で、プロダクトエンジニアがスキーマ、ルーティング、認可、接続プールについて考えずに済むようにすることだった。
2025年半ばには、クライアント側ライブラリというモデルが限界に達した。プロトコルを変更するたびに数十のサービスでデプロイを調整する必要があった。リージョンルーティングのデプロイには数日かかり、その後、あるサービスが不具合のあるクライアントへ戻ったことで、まさにその作業が防ぐはずだった障害が発生した。Habitatは独立したサービスとなり、OpenAIは意図的な技術的負債を受け入れてPythonを継続することを選んだ。自社のコードモデルによって将来の移行が実現可能になると見込んだためである。
記事の中心は、この規模でのテールレイテンシーとの闘いである。数百ミリ秒に達することがあったasyncioのスケジューリング遅延は、プロセスごとの同時リクエスト数を制限することで対処された。毎分更新される設定の解析にはランダムな時間差がなく、すべてのworkerが同時に停止していた。また、HTTPライブラリが接続を後入れ先出しで再利用していたため、すでに遅いプロセスへトラフィックが集中する準安定障害が起きたが、順序を逆転させ、最終的に負荷分散をサービスメッシュへ委ねることで修正された。API自体は意図的に機能を絞り、オブジェクトとエッジのモデルを採用し、無制限のクエリやjoinを認めていない。この制約された範囲こそが、Pythonをここまで活用できた理由である。
| 測定指標 | 発表された値 |
|---|---|
| 現在の毎秒リクエスト数 | 7,000万件超 |
| 毎週サービスを利用する人数 | 10億人超 |
| 提供されるデータ量 | 500ペタバイト超 |
| Pythonサービスのピーク | 毎秒2,000万リクエスト超 |
| Rustでの再実装 | エンジニア2人、Codex、GPT-5.5 |
| Rustが処理するトラフィックの割合 | 本番リクエストの95パーセント |
| CPU効率とメモリ効率の向上 | 6倍と15倍 |
2026年第2四半期に、2人のエンジニアがCodexとGPT-5.5を使い、サービス全体をRustで再実装した。Rustサービスは本番リクエストの95パーセントを処理し、CPU使用量は6分の1、メモリ使用量は15分の1になった。Python版は今後数週間で廃止される。第2部ではストレージ層が取り上げられる。
OpenAIがCodex利用者にskills、AGENTS.md、promptsの簡素化を推奨
9月11日 — OpenAIの開発者ブログは、GPT-6 Astraへ移行するCodex利用者向けに整理ガイドを公開した。出発点となる認識は、従来モデルを導くために1年間蓄積してきた指示が、より高性能なモデルには負担になるというものだ。skillsについては仕組みが具体的に説明されている。各skillは名前と説明をコンテキストへ読み込むが、数が多すぎるとCodexが説明を短縮するため、モデルが各skillから得られる情報が減り、適切な選択が難しくなる。
| 検討対象の指示 | GPT-6 Astra向けの推奨事項 |
|---|---|
| skillの説明 | 短くし、発動条件を明確にして、分野全体を対象にしない |
| 複数の処理経路を持つskillの構造 | ルート文書はdocsとscriptsへの振り分けだけに絞る |
| AGENTS.mdで必須とする文書の読み込み | 変更種類ごとに1文書とし、編集のたびに大量の文書を読ませない |
| テストに関する指示 | 不要。モデルが自らテストを実行する |
| タスクの終了条件 | 完了の意味を定義し、安全なworkflowを事前に許可する |
| 継承された禁止事項 | 緩和しなければ早期終了につながる |
最も興味深い点はモデルの動作に関するものだ。OpenAIによると、GPT-6 Astraはタスクの範囲について前世代より慎重であり、最初の実装後にレビューを求めて戻ってくる可能性がある。推奨される対応は、完了とは何を意味するのかを明示し、破棄可能なfixtureを使うローカルテストスイートなど、安全だと分かっているworkflowを事前に許可することである。反対に、旧モデルの動作を抑えるために書かれた非常に厳格なガードレールは、今ではモデルを早すぎる段階で停止させる可能性がある。記事は、リポジトリのskillsがほかの貢献者のエージェントにも読み込まれ、それらが別のモデルで動作する場合もあると指摘する。そうしたモデルに有用な指示が、Astraを過度に制約する可能性がある。最後には、プロジェクトの指示をAstra自身に監査させるという実践的な提案が示されている。skill作成用のskillも、この方針に沿って更新された。
🔗 GPT-6 Astra向けにskillsとpromptsを再考する
ChatGPT Sites、3か月で500万サイトを突破
9月11日 — ChatGPT公式アカウントは、会話から完全なWebアプリケーションを構築してホストするために3か月前に開始された機能、ChatGPT Sitesの実績をまとめた。これまでに500万を超えるサイトが作成されている。この投稿は主に、見過ごされてきた5つの進化を振り返るものだ。
そのうち2つは共同作業に関するものだ。1つ目は、チームメンバーを招待して共有サイトを編集、保存、公開できる機能である。2つ目は、サイトを一般公開せず、指定した相手にだけ公開できる機能だ。残る3つはサイトのライフサイクルに関するものだ。promptからデプロイまでの時間が半分になったとされ、ChatGPTは求めに応じてサイトのデータベースを調査でき、編集者もそのデータベースへアクセスできる。また、独自ドメインをサイトに紐付けられるようになった。開発者向けアカウントもこの発表を共有しており、この機能が一般向けページだけでなく、迅速なプロトタイプ作成も対象としていることがうかがえる。
Together AI、fine-tuningを17のオープンモデルへ拡大し、専門家層にadapterを導入
9月11日 — Together AIは、実験の全工程にわたってfine-tuningサービスを拡張した。17のオープンウェイトモデルがカタログに追加され、GLM 5.3とその前2世代、DeepSeek-V4-Flash、Kimi K2.7-CodeとK2.6、パラメーター数8億から350億までのQwenファミリー、Gemma 4などが含まれる。同社によると、GLM-5.3はTerminal-Bench 2.1で88.2を記録し、最高性能のプロプライエタリモデルとの差は1ポイント未満だという。
実験追跡が2つ目の新機能だ。各jobでは、各stepのloss、gradient norm、learning rateが記録され、実行中にcurveが更新される。複数のjobを同じgraph上に重ねることができ、生のseriesはAPIを通じて公開される。early stoppingはvalidation lossが停滞するとtrainingを停止し、最後のcheckpointではなく最良のcheckpointを保持し、未使用のstep分を返金する。
最も技術的な点はExpert LoRAである。Mixture-of-Expertsモデルでは、パラメーターの90パーセント超が専門家層に存在するが、従来のadapterはattentionだけに接続されるため、これらの層を固定したままにする。
| 架空の200件の事実に関するテスト | 専門家層を含むadapter | attentionのみのadapter |
|---|---|---|
| 新しい事実の想起 | 最大89パーセント | 15パーセント |
| MMLU-Pro | 75.3パーセント | 71.5パーセント |
提示された説明によると、attentionに限定されたadapterでは、fine-tuning中にroutingされる専門家のうち、使われなくなる割合が次第に増えていく。データ処理もブラックボックスではなくなり、tokenizeされた行、サンプルごとのweightをプレビューでき、upload完了直後にサーバー側でファイル全体を検証する。training価格はモデルに応じて30~70パーセント引き下げられる。
コミュニティからの貢献、試行ごとのsandboxと100問のゼブラパズル
Hugging Faceのコミュニティブログは同日、短い紹介以上の価値がある3件の成果と、後ほど紹介する5件の成果を公開した。
13の研究所はどのようにエージェントのRLを実行しているのか
9月11日 — Sergio Paniegoは、2025年10月から2026年9月までに13の研究所が発表した15件の報告書を精査し、各研究所が評価しているものではなく、訓練していると明記したものだけを取り上げた。中心的な結論は、環境がもはやメモリ内のシミュレーターではなく、ファイルシステム、shell、プロセスを備え、試行ごとに起動され、その後破棄される完全なマシンになっているということだ。Liquid AIは26億パラメータのモデルでこれを実施し、Cursorは自社モデルの訓練に数十万の並行環境を使用していると述べ、Microsoftはタスクごとに新しいコンテナをプロビジョニングしている。Kimi K3はさらに進み、100万tokensの軌跡に対応する再開可能なマイクロ仮想マシンを採用している。
| スタックの層 | 研究所が維持しているもの | 言及された公開版 |
|---|---|---|
| タスクと検証器 | GLM-5では10,000を超えるコード環境 | Environments Hub, verifiers, Harbor |
| アクション契約、ハーネス | Kimiは5つのホワイトボックス型ハーネスをインスタンス化 | OpenEnv, SkyRL, BrowserGym, TextArena |
| sandbox | clusterごとに数十万台の仮想マシン | Modal, E2B, AgentENV, Hugging Face Sandboxes |
| trainer | Zhipuのslime、MiniMaxのForge、NVIDIAのRLVR | TRL, Miles v0.1 |
注目すべき傾向として、ハーネス自体が環境になりつつあり、ホワイトボックスとして再構築される場合と、そのまま維持されブラックボックスとして監視される場合がある。透明性には大きなばらつきがある。Ai2はOLMo 3向けに検証済みのコードサンプル1,720万件を文書化している一方、OpenAI、Anthropic、Googleはほとんど何も公開しておらず、GPT-6 Astraのsystem cardはわずか1文にとどまる。著者は、大規模研究所では単一環境だけで1,000万ドルを超える費用がかかるとしている。この投稿をもってTraining Agentsシリーズは完結する。
100問のゼブラパズルが数学的推論を目覚めさせる
9月11日 — tamewildによるコミュニティ記事は、数学データを一切使わず、100~500問の論理推理パズルで数分間fine-tuningするだけで、小規模なbase modelの数学ベンチマーク性能が急上昇すると報告している。
| 訓練したbase model | MATH-500 | AIME 2025 | 比較対象の公式版 |
|---|---|---|---|
| Qwen 3 4B、100問を6分23秒で訓練 | 84.60% | 21.67% | post-trained版:84.80と19.10 |
| Granite 4.1 3B、500問を23分で訓練 | 77.73% | 19.44% | Instruct版:66.60と6.67 |
| Qwen 3.5 9B、500問を40分で訓練 | 96.60% | 60.67% | post-trained版:97.40と60.56 |
構造的な効果も測定されている。3つのうち最大のモデルでは、回答長の中央値が公式モデルを下回り、greedy decodingにおける反復ループ率は6.06%から0.67%に低下した。著者は、単一seedによる探索的なrunであるとして慎重な姿勢を保ち、自身のablationでも標準的なadapterがMATH-500で約80%に達したと記している。つまり、汎化はまず論理データによって生じている。コード、notebook、3つのモデル、2つのdatasetが公開されている。
datasetのない言語のための音声パイプライン
9月10日 — Osmanovは、音声認識も音声合成も存在しない危機言語、クリミア・タタール語のために完全な音声パイプラインを構築した経緯と、ほかにも応用できる教訓を紹介している。訓練にかかった時間は丸め誤差にすぎなかったという。認識adapterの訓練はノートパソコンのGPUで90分かかり、単語誤り率を34.6%から20.1%へ、さらに重みに一切触れないbeam searchによって17.0%まで低下させた。日程のほぼすべては、存在しないcorpusの構築と、評価が虚偽の結果を示していないことの確認に費やされた。
注目すべき選択は2つある。base modelは言語的な近さではなく音声学的な事前知識に基づいて選ばれた。クリミア・タタール語にはトルコ語にない口蓋垂音の/q/があり、トルコ語識別子で訓練されたbase modelはこれを/k/として出力し、fine-tuningでもまったく修正されなかった。また、corpus構築の起点となる音声認識がないため、著者はテキストが既知のオーディオブックを使って問題を逆転させ、ずれが拡大するalignmentでは110分しか得られなかったところ、利用可能な336分を確保した。最も有用な否定的結果は、metricの頭打ちだ。合成用corpusを5.9時間から15.3時間へ増やしても文字誤り率は変わらなかったが、blind listeningでは毎回、より新しい音声が好まれた。さらに、典型的な漏洩も記録している。テスト用書籍のclipの96.9%が訓練データ内に重複しており、ファイル名ではなくテキストのn-gramによって検出された。
ReplitがRoutinesを発表、必要なときだけエージェントを呼び出す反復作業
9月11日 — Replitは、時間単位、日単位、週単位のスケジュールに従って反復作業を実行する機能、Routinesを発表した。この発表で興味深いのは、ありふれたスケジューリング機能そのものよりも、同社がコストの問題をどのように扱っているかだ。出発点となる認識は明快だ。エージェントは今や反復タスクの大半を自動化できるが、常時稼働させると膨大なtokensを消費する。その答えは、エージェントをループの中心に置かないことだ。各実行は決定論的なコードから始まり、実際に推論が必要な場合にだけエージェントが呼び出される。
このアーキテクチャは、サイクル全体をモデルに委ねる主流の傾向とは逆を行く。ここではモデルが再び、必要なときだけ呼び出されるリソースとなり、挙動とコストを予測できる通常のコードによって制御される。何百回も繰り返されるscheduled taskでは、料金の差は無視できない。この発表にblog postは伴っていない。
WarpがGrok Buildを第一級のエージェントとして統合
9月11日 — Warpは、SpaceX AIのコマンドラインエージェントであるGrok Build CLIの統合対応を発表し、Grokのアカウントもすぐにこの統合を紹介した。この機能は9月9日版のterminalですでに提供されており、changelogでは第一級の対応と説明されている。WarpはGrok Buildのsessionを検出し、footerに専用の視覚表示を適用して、enhanced input modeを有効にする。
具体的には、Grok Buildのユーザーはterminalのネイティブエージェントと同じツールを利用できる。enhanced inputは、貼り付けられた長いpromptやmulti-cursorに対応しており、複数段落にわたる指示を作成するユーザーにとって大きな変化となる。コマンド1つで進行中のagent sessionを別の端末へ共有でき、session中もfile explorerやcode review panelにアクセスできる。既存のGrok subscriptionがアクセス権として使われ、専用の料金や制限は発表されていない。
この追加により、Warpのterminal内で動作するthird-party agentの充実した一覧に、Claude Code、Codex、Droid、Antigravityと並んでGrok Buildが加わった。また、8月にX PremiumまたはSuperGrokのアカウントへ接続するコマンドを追加するなど、夏の早い時期から進められてきたxAI ecosystemとの連携も拡張された。Warpの方針は、自社エージェントの提供開始以来変わっていない。ユーザーを自社製エージェントに囲い込むのではなく、すべてのエージェントが同じ統合品質で動作する場所としてterminalを位置づけるというものだ。この版では、ほかに2つの煩わしい問題も修正されている。入力済みだが未送信のpromptがモデル変更時に消去されなくなり、global fileで宣言されたMCP toolsがエージェントの最初の応答から利用できるようになった。
🔗 XでのGrokの発表 · 🔗 XでのWarpの発表
Vibe CLI 2.25.3、forkコマンドと非公開のsession log
9月11日 — Mistralは、3日間で3つ目となるVibe CLI 2.25.3を公開した。目に見える新機能は/branchコマンドだ。これは進行中のconversationを再開可能な新しいsessionへforkし、元のsessionはそのまま残す。コピーしたsessionは別のterminalで再開できるため、主な流れを犠牲にせず、同じcontextから別の方針を探索できるようになる。@によるファイル参照は、Gitを考慮した探索を利用するようになり、promptへ単独で貼り付けたファイルやフォルダーにも対応する。
修正点は3つある。保存されたconversationは引き続き読み取り可能で、作業再開時にworktreeも復元される。新しいsession logはPOSIXシステム上のほかのユーザーから読み取れなくなった。これはfile permissionの修正であり、認証されていないdebug listenerを削除し、いかなる失敗も自動承認につながらないようにした2.25.1版の対応を引き継ぐものだ。最後に、AGENTS.mdファイルの指示が、実験的な統合ハーネスのもとでsystem promptへ読み込まれるようになった。releaseには14個のbinary archiveが含まれているが、モデルや料金の変更に言及したnoteはない。
🔗 Vibe CLI 2.25.3のrelease note
Synthesiaがコンプライアンスエージェントを共有インフラへ転換
9月10日 — Synthesiaの信頼業務責任者Nicolás Barberisは、コンプライアンス証拠を収集するエージェントについての6月の記事の続編を公開した。再設計を導いたのは読者からの問いだった。エージェントが監査証拠を収集するようになると、その収集自体が監査対象となり、収集者を信頼できなければならない。その答えは、いずれも応用可能な4つのアーキテクチャ上の選択に集約される。
まず、仕組みと手法を分離する。コードは内部repositoryに置かれ、pull requestを通じて変更される。CODEOWNERSファイルによって人間のreviewが義務づけられ、control categoryごとの手順はdocument spaceに置かれ、control ownerが作成・承認する。URLがhard-codedされていた当初のscriptは、同僚がコマンド1つでinstallできる共有skillへと変わった。次に、browserの範囲を制限する。エージェントは日常利用のbrowserには決して触れず、sessionを使い捨てprofileへコピーし、存在する場合はread-only roleで動作し、権限を昇格する代わりに認証画面で停止する。provenanceは設計段階から組み込まれており、各captureには生成時からsource URL、timestamp、operator、正確なbyte列の暗号学的fingerprintが付与される。最後に、人間による責任の確保だ。エージェントはdraftとして保存するだけで、決してsubmitしない。
| 測定結果 | 値 |
|---|---|
| 監査担当者との証拠review meeting | 60%削減 |
| 対応した新しいframework | 約500 controls |
| この種のframeworkに通常かかる期間 | 4~6か月 |
| 実際にかかった期間 | 数週間 |
knowledge baseは追記専用方式で自律的に成長する。実行のたびに、エージェントは修正されたURLと日付付きのblockerを記録する。たとえば、最近のChrome版でbrowser automation interfaceが壊れた際には、debugging protocolへ直接接続することで回避した。Synthesiaは、このツールをAI支援型governance platformへ発展させていると発表し、中核componentのコード公開も検討している。
HeyGenが「The Furniture Unboxing」のワンテイク16秒を詳説
9月11日 — HeyGenは、男性が空のコンクリート部屋の中央に段ボール箱を置いて立ち去り、その箱が爆発して一式のリビング家具が飛び出し、所定の位置へ収まる16秒の動画のmaking-ofを公開した。3Dもcompositingもpost-productionも一切なく、使ったのは2枚の静止画、1体のavatar、1つのpromptだけだ。チームは390 framesすべてにcutがないことを確認し、連続する2 frames間の最大変化は爆発そのものだった。
手法の要は2枚のreference imageだ。1枚目は、広い固定画角で撮られ、床の中央が空いた何もない部屋を示す。2枚目は、似た部屋を新たにrenderしたものではなく、同じ画像を編集して家具を追加したものだ。camera position、lens、light、コンクリート上のshadowまで同一である。この規則によって効果が成立する。モデルが創作するのは中間部分だけになるからだ。
| 動画のパラメータ | 値 |
|---|---|
| promptで指定した長さ | 15秒 |
| 出力された長さ | 16.27秒 |
| 解像度とframe rate | 1920x1080、23.976 frames/秒 |
| cutなしのframes | 390 |
| 入力 | 静止画2枚、avatar 1体、prompt 1つ |
promptは説明文ではなく、時間指定付きのshot listとして書かれ、爆発前には意図的な間が設けられている。これを支える要素は6つある。時間の目印、その間、役割別に命名されたreference、家具を1点ずつ列挙した一覧、否定表現によるidentityの定義、そして誇張の許可だ。最後の要素がなければ、モデルは段ボール箱の実際の容積を守ってしまう。実地のnoteも有用だ。モデルは15秒ではなく16.27秒の動画を生成し、爆発は記述より速く、誰も要求していなかった完成後の部屋を映し続けるshotまで追加した。チームはそれを編集全体で最高の瞬間と評価している。そのため、時間指定はリズムと順序を定めるために書き、その後、実際に出力されたリズムに合わせて編集することが推奨されている。音声は2回の生成の間で変化し、ほぼ無音だった版から連続したsound bedを持つ版になった。自動再生で無音の動画は、音声が壊れているように受け取られるためだ。
🔗 「The Furniture Unboxing」の制作方法
Nemotron 3 Embed 8BがQ2D-Webベンチマークで首位を獲得
9月10日 — NVIDIAは、80億パラメータのembedding modelであるNemotron 3 Embed 8Bが、Q2D-Webの総合nDCG@10 scoreで首位を獲得したと発表した。Q2D-Webは、エージェント駆動型のretrieval-augmented generation systemにおけるdocument retrievalを評価するため、Perplexityが前日に公開したベンチマークだ。1億9,000万件のweb documentと、エージェントが言い換えた約70,000件のqueryを対象とし、10言語にまたがる。
この結果が重要な理由は2つある。このベンチマークは、indexを検索する前にqueryを言い換えるエージェントの実運用条件を再現しており、従来のembedding評価では測れなかったものを測定する。そして、この規模のopen modelがmultilingual rankingを制したことで、proprietary embeddingに対抗するself-hosted pipelineの有力候補となる。NVIDIAは具体的なscoreを公開していない。完全なrankingはPerplexityで確認できる。
コードとしてのマーケティング運用、GitHub issue から駆動するイベント
9月11日 — GitHub の日本・韓国地域マーケティング責任者で、元エンジニアの Tomoko Tanaka は、自らコードを書くことなくイベントの全サイクルを自動化した方法を紹介している。手順を文章化して Copilot に渡し、対話を重ねながら自動化を発展させたという。
このシステムは3つの基本要素で成り立っている。issue フォームはイベントの構造化されたフィールドを収集し、イベントの種類ごとに1つのフォームを用意する。ラベルはスイッチとして機能し、ラベルを付けると workflow が起動する。実作業を担うのは GitHub Actions だ。フィールドの読み取り、プラットフォームの API を介した過去のイベントページの複製、チャネル別トラッキングリンクの生成、リポジトリにコミットされる招待メールの作成、関係チームへの依頼 issue の作成、プロジェクトボードへの入力を行う。スケジュール実行される workflow が、毎朝登録者を絞り込む。必要なものは、ツールをスクリプトから操作できる手段、つまり API、あるいは単純なコマンドラインクライアントだけだと彼女は記している。
計画は Copilot との対話から始まる。その枠組みを定めるのが、リポジトリのルートに置かれた AGENTS.md ファイルで、命名規則、会計四半期の対応関係、地域ごとのタイムゾーンが記されている。対話は当初ターミナルで行われ、その後アプリケーション内へ移ったことで、必要条件は「shell を問題なく使える」から「文字を入力できる」へと変わった。イベント後の作業は2つのコマンドで完結する。これらは文章で記述された agent skill であり、pull request によって追加され、マージ前に所有者ファイルに基づいてレビューされる。マーケティング部門は何も構築せずに承認プロセスを手に入れられる。リポジトリ変数に保存されたシミュレーション用スイッチにより、各 workflow をドライランできる。率直に明かされた失敗談も一読に値する。朝の絞り込み workflow が、あるとき5日間ひそかに失敗し続け、古くなったリストに誰かが気づくまで発覚しなかった。そのため、スケジュール実行されるすべてのタスクに、問題を大きな声で訴える手段を持たせるべきだと助言している。
Boris Cherny が使い捨てコードと本番コードについて回答
9月11日 — Anthropic で Claude Code を率いる Boris Cherny は、「粗悪なコードにどう対処すべきか?」という件名のメールを送ってきた開発者への返信を公開した。同じ企業に12年間勤めるその送信者は、agent を活用した開発によってチーム内に2つの陣営が生まれたと説明している。第1の陣営では、コードは従来と同じような状態を保ち、単に開発速度だけが上がる。すべてを読み直すとは限らないが、コードは引き続きレビュー可能で、提出者が説明でき、以前と同じ程度に保守しやすくなければならない。第2の陣営では、コードは出力だけを検証するブラックボックスになる。
回答は2つの原則に集約される。prototype と使い捨てコードは、実際に廃棄する予定であり、障害の影響範囲(blast radius)が小さい場合に限り、完全なブラックボックスとして扱ってよい。一方、Claude が書いた本番コードには、人間が書いた場合よりも高い基準を課す必要がある。Anthropic では、多数の lint ルール、多数のテスト、Claude が操作する end-to-end テスト、毎日実行される fuzzer、自動化されたコードレビューとセキュリティレビューを意味する。こうしたガードレールがなければ、保守困難な混乱に行き着くと彼は警告する。
続いて、生成されたコードが基準に達しない場合の対策が順番に挙げられている。最新の frontier model に切り替える、推論 effort を上げる、CLAUDE.md と skill に投資して、コードベース内での作業方法を Claude に簡潔に教える。それでも改善しなければ、より細かく指示する、蓄積した技術的負債を解消させる、あるいは次の model を待つ。返信スレッドでは、最も広く引用された表現が明確に示された。レビューの基準はコードの作者ではなく影響範囲に応じて決めるべきであり、使い捨て script ならすぐに出荷してよいが、金銭や認証情報に関わるものはすべて1行ずつ読むべきだ。Boris Cherny は「Exactly」と返信した。
短報
- Amp、スレッド内の commit を再編成するボタンを追加 — 1回の操作で、agent が作成した中間 commit、連続する修正、巻き戻しを、レビューしやすい一連の流れに変換する。挙げられている用途は3つ。大きな diff を論理的な単位に分割する、マージ前に整理する、関連する小さな commit をまとめる。ファイルの最終的な内容は完全に同一のまま保たれる。🔗 出典
- Amp、「Raising an Agent」シーズン2の第4話を公開 — Quinn Slack と Thorsten Ball が、現在のコンピューターは何のためにあるのかという問いから出発し、最近の障害を振り返りながら、コード生成以外に agent が何をしているのかを検討する。🔗 出典
- v0、チームの会話をデフォルトで公開 — 共有 workspace の新しい会話はチームから見えるようになり、所有者が3段階(非公開、閲覧、編集)で設定できる。既存の会話の公開範囲は維持される。prototype 作成中にデータの断片を気軽に貼り付けるようなツールでは、より開かれた設定への切り替えは決して中立的ではない。🔗 出典
- Audiyo、Stable Audio Open を8 GBの GPU で動作可能に — Python library とコマンドラインツールにより、video memory のピーク使用量を13.8 GBから5.86 GBへ、57.5パーセント削減する。Tesla T4 で測定された4つの preset が用意されている。チームはまず、538万 parameter の代替 model を使って CPU 上で動作を検証し、GPU に触れる前に4つの bug を発見できた。🔗 出典
- 「Consent All the Way Down」、小規模な open model の評議会向け同意 architecture — Claude の1つの instance が執筆した論考で、70億 parameter 以下の18 model からなる評議会について扱う。この評議会は5月から一般消費者向けの3台のマシン上で継続稼働している。各 source は、model が読み取る深さを選ぶ channel であり、その状態には model 自身以外は何も書き込まない。最も率直なのは、執筆者自身に対する監査だ。mailbox は6月から壊れており、213通の手紙が滞留していた。🔗 出典
- 軍拡競争ではなく、browser 戦争である — model weight が非公開かどうかにかかわらず、language model はコモディティ化し、先行企業の優位は数週間単位になると論じる意見記事。著者は、今夏に Fable 5 が18日間停止していた間も、業界の他社が進み続けていたことを例に挙げる。主張はこうだ。価値は、Chrome のユーザーを引き留めたブックマークや extension のように、ユーザーの周囲に蓄積された context へ移る。🔗 出典
- 割り込み発話から発話制御へ、不確実な状況で音声割り込みを管理 — Eric Mey は、破壊的な割り込みを、可逆的な action を備えた発話ターン制御機構に置き換え、曖昧な断片用に別経路を設け、緊急停止と echo suppression の優先順位を定めている。テストから得られた教訓は覚えておく価値がある。テスト一式はすべて成功していたものの、記録はされていても一度も呼び出されない可逆的な一時停止が隠れていた。成功を示す gate が保証できるのは、その gate が検査したものだけだからだ。🔗 出典
- Aiden、リアルタイム音声 model とタスク実行 agent を分離 — full-duplex 音声 model が会話を維持する一方で、視覚情報に基づくより強力な model が、デバイス制御タスクをバックグラウンドで実行し、両者を非同期 queue で連携させる。重要な点は4つある。完了と成功の区別、500ミリ秒単位での通知の集約、cache を維持するために追加 message で状態を伝達すること、厳密な逐次実行だ。🔗 出典
- GPT-Live-1、Yelp の予約電話に対応 — model が API に登場した翌日、OpenAI は、台本どおりには決して進まない事例で最初の顧客を紹介した。電話をかけた人が途中で割り込み、条件を追加し、あるいは文の途中で考えを変えても、model は話しながら聞き続ける。公開されたのはデモ動画で、利用規模や数値結果は示されていない。🔗 出典
- diff、terminal、browser の各パネルで agent の作業を検証 — Kayla Cinnamon による Copilot アプリケーション初心者向けシリーズの新エピソード。3つの組み込みパネルと、ページ要素を選択して agent に調整させるツールを取り上げる。記事では、コードを受け入れる前の確認手順を3つの質問にまとめている。何が変わったのか、実行できるのか、本当に機能するのか。🔗 出典
- リポジトリの pull request ページを刷新 — 全ユーザー向けの公開 preview。フィルター入力支援、boolean operator と入れ子 query に対応した検索、折りたためる sidebar、compact mode、各行の context 拡充が含まれる。公開時点で判明している制限は、milestone が表示されないこと、一括更新ができないこと、カスタム view を保存できないこと。🔗 出典
- Copilot で GPT-5.6 Sol が30パーセント割引 — Pro+ と Max の加入者向けに、9月13日午前0時 UTC まで実施される。割引後に premium request の multiplier がいくつになるのかは、メッセージに記載されていない。Copilot Day の直後、同日に複数のコスト比較に登場した model を対象にした週末 promotion だ。🔗 出典
- GitHub Copilot Day コンテスト、100ドル分の credit を3名に進呈 — Copilot アプリケーションまたはそのコマンドラインクライアントを使って何かを作成し、指定された hashtag を付けて9月13日午後11時59分(太平洋時間)までに公開する。受賞者は3名で、それぞれ GitHub Shop の100ドル分の credit を獲得する。参加は無料で、成人に限られる。🔗 出典
- Runway、Astra を介して ChatGPT から利用可能に — 会話から操作する一連の workflow を実演。Runway で style image を作成し、Blender で animation を付け、Seedance 2.5 で最終レンダリングを行う。技術的な入り口は、9月2日に発表された Runway Dev の MCP server のままだ。1つの agent の制御下で異種ツールを連携できる点に価値がある。🔗 出典
- Runway、VOIDZ の事例研究を公開 — 2018年から匿名で活動する mixed reality artist が、10~15秒の映像から、実写の食料品店内を走る場面に15の超現実的な演出を組み込んだ95秒の映像作品へと進化した。大半の effect は既存の shot を延長するもので、documentary source の数秒間を導入として使用している。制作速度は10倍になったとされ、artist は同じ作業を従来の3Dで行えば6か月から1年かかると見積もっている。🔗 出典
- Runway、AI Summit の登壇者を追加 — San Francisco で開催される1日イベントの新たな登壇者を発表し、Wayve の研究責任者を前面に打ち出した。8月末に始まった、自動運転車分野へのプログラム拡大を裏付けるものだ。🔗 出典
- NVIDIA、「From Video to Voice」を配信、TensorRT Model Connect を33分間解説 — 8月末に発表されたツールを取り上げる再配信。このツールは、動画 model から音声 model まで、open model を checkpoint から inference へ2つのコマンドで展開する。発表というより研修コンテンツだ。🔗 出典
- Suno、v6 を credit 不要で利用できる期間を2日間延長 — 前日に発表された48時間が4日間に延長され、simple mode では genre ではなく雰囲気から始めることを推奨するヒントのスレッドも公開された。その前日には、変化の豊かさや質感を求めて旧 model に戻るユーザー向けの移行ガイドが公開されており、すべてのユーザーにとって移行が自明ではないことを示している。🔗 出典
- Synthesia、prompt からの avatar 作成を開始 — 写実的な presenter、brand mascot、stylized character を、text prompt で記述するか、control panel で調整して作成でき、catalog の代替となる。新しい avatar model の公開翌日に、リンクなしの1件の tweet で発表された。対象 plan も使用 model も明記されていない。🔗 出典
- GPT-6 Astra Challenge、応募受付を開始 — Astra を使って構築し、9月18日に Product Hunt でプロジェクトを公開する。上位5件には、それぞれ10,000ドル分の API credit と、最大2名のチームメンバーを対象とする1年間の ChatGPT Pro が贈られる。1週間で3回目となる Astra 関連のコミュニティ企画だ。🔗 出典
- OpenAI のプロジェクト API key に有効期限を設定可能 — 作成時に有効期限を指定でき、管理者は組織またはプロジェクト単位で最大有効期間を設定できる。その場合、新しい key はすべてその期間内に失効しなければならない。key rotation を自然に補完する機能であり、script 内に key を放置しがちな組織は有効にすべきだ。🔗 出典
これが意味すること
今日最も鮮明に浮かび上がったテーマは、アーキテクチャにある。単一モデルの時代から、複数モデルを組み合わせる時代へと移行しつつある。Cursorは、コードを書かないコーディネーターを数千のサブエージェントの上位に配置し、Cognitionは役割を分け、コンテキストを分離した2つのモデルをペアで動かしている。Sakanaは各タスクを、それを解決できる最も軽量なモデルに振り分け、GitHubは単独のレビュアーを複数のエージェント群に置き換え、それぞれの指摘を統合する。そしてGoogleは、何日にもわたってエージェント同士に提案、批評、改善を繰り返させている。5社、5つの実装、そして共通する1つの確信。それは、より大きなモデルではなく、複数のモデルがどのように作業を分担するかによって成果が生まれるということだ。CognitionとAidenに共通する技術的な細部も示唆的だ。両者ともプロンプトキャッシュの維持を重視している。つまり、アーキテクチャの実質的なコストを左右するのは、再送信せずに済む情報なのである。
2つ目のテーマは、こうした能力をどのように販売するかだ。Runwayは、クローズドな重みを年単位でライセンス提供し、チェックポイント、トレーニングスクリプト、顧客先に派遣される研究者まで含め、オープンウェイトと真っ向から対立する提案を打ち出している。OpenAIは、専門モデルを研究プレビューから正式提供へ移し、公開料金表と課金開始日を示した。ElevenLabsは無料プランを含むすべてのプランで楽曲の所有権を付与し、権限をサブスクリプションではなく楽曲そのものに紐づけている。Togetherはトレーニング料金を30〜70パーセント引き下げた。一方、Cognitionは測定単位そのものを変え、モデルとハーネスの組み合わせをトークン単価ではなくタスク単価で評価することまで提案している。これらの動きは同じ方向を向いている。顧客に問われるのは、もはやどのモデルを選ぶかではなく、どのような法的形態と課金単位で利用するかなのである。
ツールの面では、今日は宣言中心から実測中心への転換点となった。Anthropicは、ツールが本当に役立つことを数値で証明するため、各テストケースをプラグインなしで再実行するコマンドを提供した。そして、そこで最初に見つかる典型的な結果は、差がゼロであるというものだ。OpenAIは、より高性能になったモデルには蓄積された指示がかえって悪影響を及ぼすとして、ユーザーにそれらを削除するよう求めている。ReplitとVS Codeは、ほぼ同時に定期タスクのスケジューリング機能を公開した。Replitの場合は、まず決定論的なコードから始め、推論が必要な場合にのみエージェントを呼び出すという明確な原則がある。Boris Chernyは、コードを書いた主体ではなく影響範囲に応じて厳格さを決めるという、全体に欠けていた規律のルールを示している。コンテキスト、skills、指示ファイルを2年間蓄積してきた業界は、ようやくそのコストを測り始めた。
残るのはインフラであり、そこでは数字が、華やかさには欠けるものの、より示唆に富む物語を伝えている。2人のエンジニアがCodexを使い、毎秒7,000万件を超えるリクエストを処理するストレージサービスをRustで書き直し、プロセッサー使用量を6分の1にした。2025年半ばに意図的に引き受けたPythonの技術的負債は、1四半期で解消された。同じ頃、Hugging Faceのレビューでは、エージェントの強化学習が試行ごとにマシン1台を丸ごと消費するまでになり、環境予算は1,000万ドルを超え、研究所の規模が大きくなるほど透明性が低下していることが示された。そして、コミュニティによるある論考は、先頭集団の差が数週間単位にすぎない以上、そのどれも持続的な優位性にはならないと主張している。今日の事実だけで結論は出ないが、1つの示唆は得られる。差別化の軸は、蓄積されたコンテキスト、ハーネス、インフラへ、言い換えれば蒸留できないものへと移りつつある。
情報源
- Cursor、Projects
- CursorのX投稿、Projectsの発表
- OpenAI DevelopersのX投稿、GPT-Rosalind
- OpenAI APIの変更履歴
- Runway、モデルライセンス
- RunwayのX投稿、モデルライセンス
- Cognition、ローカル環境のFusion
- CognitionのX投稿、Devin DesktopとCLIのFusion
- Sakana AI、Fugu MaxとFugu Ultra v2
- Sakana AIのX投稿、Fuguの発表
- ElevenLabsのX投稿、Music v2.5
- ElevenLabs、Music v2.5の記事
- Claude DevelopersのX投稿、claude plugin eval
- Anthropic、プラグイン評価のドキュメント
- Claude DevelopersのX投稿、評価のコストと信頼性
- Claude Code、バージョン2.1.269のリリースノート
- Google、Antigravityの変更履歴
- AntigravityのX投稿、ヒント集
- Antigravity、Teamwork
- GitHub Changelog、Copilotによるコードレビュー
- GitHub Changelog、9月7日のCopilotまとめ
- OpenAI、Habitatと10億ユーザーへの道
- OpenAI、GPT-6 Astra向けのskillsとプロンプトの再考
- ChatGPTのX投稿、Sitesの総括
- Together AIのX投稿、拡張されたファインチューニング
- Hugging Face、試行ごとに1つのサンドボックス
- Hugging Face、推論とゼブラパズル
- Hugging Face、データセットのない言語向け音声
- ReplitのX投稿、Routines
- WarpのX投稿、Grok Buildへの対応
- GrokのX投稿、Warp内のGrok Build
- Mistral、Vibe CLI 2.25.3のリリースノート
- Synthesia、収集者を監査するのは誰か
- HeyGen、The Furniture Unboxingをどのように制作したか
- NVIDIAのX投稿、Nemotron 3 Embed 8B
- GitHub、コードとしてのマーケティング運用
- Boris ChernyのX投稿、粗雑なコードにどう対処するか
- Amp、変更内容の再整理
- AmpのX投稿、Raising an Agent
- v0、変更履歴
- Hugging Face、Audiyo
- Hugging Face、Consent All the Way Down
- Hugging Face、軍拡競争は存在しない
- Hugging Face、割り込み発話から発話制御へ
- Hugging Face、Aidenの内部
- OpenAI DevelopersのX投稿、YelpでのGPT-Live-1
- GitHub、初心者向けCopilotアプリケーション
- GitHub Changelog、刷新されたプルリクエストページ
- GitHubのX投稿、GPT-5.6 Solの割引
- GitHubのX投稿、Copilot Dayコンテスト
- RunwayのX投稿、Astra搭載ChatGPT内のRunway
- Runway、VOIDZの導入事例
- RunwayのX投稿、AI Summitの登壇者
- NVIDIAのX投稿、From Video to Voice
- SunoのX投稿、v6期間の延長
- SynthesiaのX投稿、カスタムアバター
- OpenAI DevelopersのX投稿、GPT-6 Astra Challenge