ai-powered-markdown-translatorمقال مترجم من الفرنسية إلى العربية باستخدام gpt-5.6-sol.
اثنان وخمسون إعلانًا، نُشر معظمها في 11 سبتمبر، وفكرة واحدة تتكرر لدى جهات لا تتواصل فيما بينها. تعهد Cursor بمشروع كامل إلى وكيل منسّق لا يكتب الشيفرة، بل يفوّض آلاف الوكلاء الفرعيين، وتشغّل Cognition نموذجين كثنائي على جهاز المطوّر، بينما توجّه Sakana كل مهمة إلى أخف نموذج قادر على حلها. وفي اليوم نفسه، تُخرج OpenAI نموذجها لعلوم الحياة من المعاينة البحثية مع جدول أسعار معلن، وتتيح Runway أوزان نماذجها المغلقة بموجب ترخيص للمؤسسات، وتنشر Anthropic أمرًا فرعيًا يقيس أخيرًا ما تضيفه إحدى الإضافات فعليًا.
Cursor تطلق Projects، مشروعات يقودها وكيل منسّق
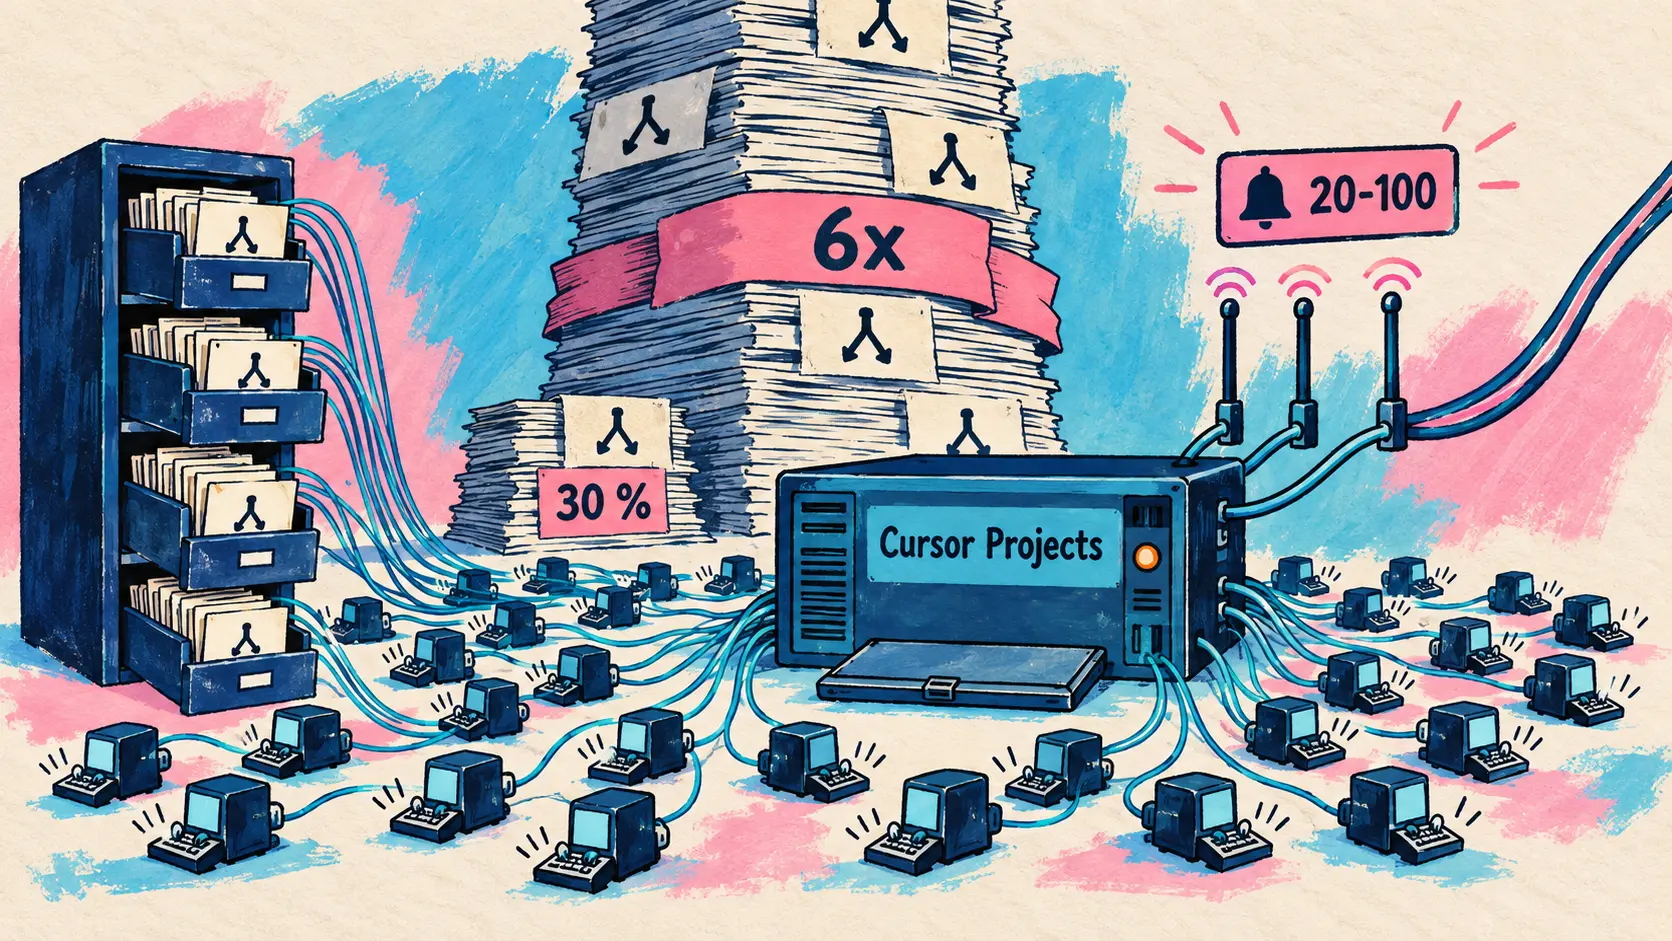
10 سبتمبر — أطلقت Cursor منتج Projects، في إعادة تصميم لطريقة إسناد العمل إلى وكيل داخل المحرّر. يخالف المنتج النهج السائد منذ عامين: فبدلًا من فتح محادثة جديدة لكل مهمة ثم إغلاقها، يتحاور المستخدم مع وكيل منسّق ضمن سلسلة تستمر أشهرًا. لا يكتب هذا المنسّق سطرًا واحدًا من الشيفرة. بل يدير وكلاء آخرين يكتبونها، ما يبقيه متاحًا دائمًا لتلقّي تعليمات بينما يتقدّم العمل.
تتيح ثلاثة آليات ذلك. أولًا، التنفيذ الافتراضي في السحابة: يعمل كل Project على جهاز خاص به، ولا يؤدي إغلاق الحاسوب المحمول إلى إيقافه، ولم يعد عدد الوكلاء الفرعيين العاملين بالتوازي محدودًا بالعتاد المحلي. ويبدأ وكيل محلي عندما يلزم تشغيل اختبار على جهاز المطوّر. ثانيًا، السياق المشترك: يحتفظ كل Project بمجموعة ملفات متزامنة عبر جميع الأجهزة، يودع فيها الوكلاء أبحاثهم ومخرجاتهم وما فهموه عن الشيفرة. فإذا اكتشف أحدهم كيفية اختبار خدمة، أصبحت الخطوات متاحة لجميع من يأتون بعده. أما الآلية الثالثة فهي الأكثر غرابة. تسمّيها Cursor الاشتراكات (subscriptions): يمكن للمنسّق مراقبة قناة Slack، أو العمل وفق جدول زمني، أو متابعة جميع طلبات السحب لإصلاح التكامل المستمر. يتصرف الوكيل عند اكتشاف إشارة، من دون انتظار أن يُطلب منه ذلك.
| الفئة المقاسة | الأثر المقاس على طلبات السحب |
|---|---|
| مستخدمو Projects الجدد | زيادة بنسبة 30 في المئة في الطلبات المدمجة |
| المستخدمون الذين يعملون أساسًا عبر Projects | طلبات مدمجة أكثر بست مرات |
| Project لنظام التصميم الداخلي | من 20 إلى 100 طلب سحب متأثر يوميًا، بحسب التقديرات |
The coordinator doesn’t write code itself but directs other agents that do. Because it delegates rather than executes, it is never blocked and is always responsive to direction.
🇸🇦 لا يكتب المنسّق الشيفرة بنفسه، بل يدير وكلاء آخرين يفعلون ذلك. ولأنه يفوّض بدلًا من أن ينفّذ، فإنه لا يتعطل أبدًا ويظل دائمًا مستجيبًا للتعليمات. — Cursor، مدونة Projects
هذه الأرقام قياسات داخلية ينبغي قراءتها بالحذر اللازم. ويظل المثال الأوضح هو «البستنة»، الاسم الذي تطلقه Cursor على العمل الذي لا ينتهي: يشغّل مهندس Project مخصصًا لنظام التصميم، يفحص كل طلب سحب جديد، ويستخرج منه المكوّنات التي تستحق أن تكون جزءًا من النظام، ويضيف قاعدة lint متى رأى الخطأ نفسه مرتين. لا يزال Projects في المرحلة التجريبية، ويجري طرحه تدريجيًا منذ 10 سبتمبر. ولا يذكر الإعلان أي شروط تسعير أو قيود متعلقة بالخطط.
GPT-Rosalind يغادر المعاينة البحثية مع جدول أسعاره
11 سبتمبر — أعلنت OpenAI Developers أن GPT-Rosalind، نموذجها الاستدلالي المخصص لعلوم الحياة، يغادر المعاينة البحثية (research preview). كان النموذج قد قُدّم في 16 أبريل 2026 لأبحاث الأحياء واكتشاف الأدوية والطب الانتقالي، ولم يكن متاحًا آنذاك إلا لعملاء Enterprise المؤهلين في الولايات المتحدة. وينتقل الآن إلى الوصول الموثوق (trusted access) للمؤسسات المؤهلة في جميع أنحاء العالم، عبر API وCodex وChatGPT Enterprise، وسيشمل هذا الوصول النماذج المقبلة من السلسلة عند صدورها تباعًا.
يورد سجل تغييرات API، في إدخال مؤرخ في 8 سبتمبر، التفاصيل التي لا تذكرها سلسلة المنشورات على X. يحمل النموذج الاسم gpt-rosalind-research، ولا يزال توفره العام مشروطًا ببرنامج الوصول الموثوق، المخصص لأبحاث علوم الحياة الداخلية التي توافق عليها OpenAI.
| بند التسعير أو الوصول | القيمة المعلنة |
|---|---|
| معرّف النموذج | gpt-rosalind-research |
| رموز الإدخال | 5 دولارات لكل مليون |
| رموز الإدخال المخزنة مؤقتًا | 0.50 دولار لكل مليون |
| رموز الإخراج | 25 دولارًا لكل مليون |
| بدء الفوترة | 5 أكتوبر 2026 |
| واجهات الوصول | API، Codex، ChatGPT Enterprise |
| شرط الوصول | برنامج الوصول الموثوق، للمؤسسات المؤهلة |
لا تبدأ الفوترة إلا في 5 أكتوبر: خلال المعاينة البحثية، لم يكن الاستخدام يستهلك أرصدة أو رموزًا. وعلى صعيد الأدوات، تشكّل إضافات Life Sciences في Codex طبقة تنسيق النموذج، بدءًا من علم الجينوم وبنية البروتينات والبحث الانتقالي، ووصولًا من جمع الأدلة البيولوجية إلى إنشاء تقارير مراقبة الجودة ودفاتر الملاحظات التفاعلية. تتيح هذه الحزمة، المنشورة مجانًا على GitHub في أبريل، الوصول إلى أكثر من 50 قاعدة بيانات عامة متعددة الأوميكس، ومصادر للأبحاث المنشورة، وأدوات بيولوجية؛ وهي تعمل مع النماذج العامة للجميع، لكن لا يستطيع دمجها مع GPT-Rosalind إلا مستخدمو Enterprise المؤهلون.
تظل أرقام الأداء المعلنة هي نفسها أرقام الإطلاق: أفضل نتيجة منشورة على BixBench، وتفوّق على GPT-5.4 في 6 من أصل 11 مهمة في LABBench2، مع أكبر فارق في CloningQA، وفي مهمة تربط تسلسل RNA بوظيفته صُممت بالتعاون مع Dyno Therapeutics، حقق أفضل إرسال نتيجة تتجاوز الشريحة المئوية الخامسة والتسعين لـ57 خبيرًا بشريًا في التنبؤ. للمعلومة جانبان عمليان: نموذج متخصص يغادر الوضع التجريبي بتسعير معلن، وتوسّع جغرافي في الوصول. ويظل القيد هو الأهلية، إذ لا يتاح الوصول بالخدمة الذاتية.
🔗 سلسلة OpenAI Developers على X
Runway Model Licensing، تسليم أوزان النماذج المغلقة إلى المؤسسات
11 سبتمبر — أطلقت Runway برنامجًا لترخيص نماذجها (Model Licensing) مخصصًا للمؤسسات. يختلف المبدأ عن الوصول عبر API: يتلقى العميل الأوزان الكاملة لأحد أحدث نماذج Runway، ويضبطه بدقة باستخدام بياناته الخاصة، ويستضيفه داخل بنيته التحتية، ويسوّق ما ينتجه منه. ولا تغادر البيانات أو المخرجات بيئة العميل مطلقًا، وهو ما يستهدف صراحةً الاستوديوهات والعلامات التجارية والحكومات.
| العنصر المقدّم | المحتوى |
|---|---|
| أوزان النموذج | الأوزان الكاملة كنقطة انطلاق |
| Checkpoints | إصدارات متعددة من النموذج للتحقق منها |
| برنامج التدريب | شيفرة لإضافة بيانات العميل وتشغيل عمليات الضبط الدقيق |
| التسليم | مدمج ضمن قاعدة شيفرة العميل، ومستضاف حيثما يريد |
| الباحثون الموفدون | مساعدة عملية في الإعداد والأوزان والتسليم |
يمكن الاستضافة حسب الاختيار في سحابة العميل، أو في مركز بياناته، أو بالكامل في موقعه، بما في ذلك بيئة معزولة عن الشبكة (air-gapped) للجهات الحكومية. وتُذكر ستة قطاعات: منصات البرمجيات، والسينما والاستوديوهات، والعلامات التجارية والتسويق، والروبوتات والذكاء الاصطناعي المادي مع World Action Model بوصفه العمود الفقري للسياسة (policy backbone)، وألعاب الفيديو و3D مع تحسين واقعية العروض منخفضة الجودة، والحكومات.
اقتصاديًا، تميّز Runway بين مسارين: Runway Dev، وهو API يُحاسب بحسب الاستخدام ولا يتطلب إدارة بنية تحتية؛ والترخيص السنوي، بتكلفة متوقعة وتحكم كامل في الإصدارات والسلوك والمخرجات. وتجيب الأسئلة الشائعة عن اعتراض التقادم: لن تتمكن النماذج المستقبلية من الوصول إلى بيانات العميل المملوكة، والتجديد السنوي مخطط له، وتُمنح أرصدة للأجيال التالية. وتقدّر تكلفة إعادة البناء داخليًا بسنوات من التعلّم ومئات الملايين من الدولارات. وتقدّم الشركة نفسها بوصفها واحدة من شركات نادرة جدًا في العالم ترخّص أوزانًا مغلقة بهذه الجودة، وتقابل عرضها مباشرةً بالأوزان المفتوحة التي تقول إنها تقدّم نموذجًا أضعف مصحوبًا بقائمة مهام. لم يُنشر أي سعر، ويتطلب الوصول تعبئة نموذج تجاري. يأتي الإعلان بعد تسعة أيام من Runway Dev MCP وأسبوع واحد من خطة Team: تغطي Runway الآن النطاق بأكمله، من المبدع الفردي إلى ترخيص الأوزان المغلقة.
Cognition تجلب Fusion إلى Devin Desktop وDevin CLI
11 سبتمبر — أعلنت Cognition توفر Fusion في Devin Desktop وDevin CLI. كانت البنية تعمل منذ عدة أشهر على Devin Cloud؛ وها هي تنتقل الآن إلى جهاز المطوّر. يأتي الإعلان بعد يوم واحد من SWE-2، نموذج الشيفرة الداخلي، ويرتبط الاثنان لأن SWE-2 هو المساعد الثاني الموصى به في المنظومة.
يمكن شرح المبدأ ببساطة. عند اختيار Fusion، لا يجري اختيار نموذج واحد بل نموذجين. يلعب نموذج متطور دور القائد (lead) ويحتفظ بالسيطرة على الجلسة: يملك الخطة، ويحسم مواطن الغموض، ويراجع العمل المسلّم. ويلعب نموذج أقل تكلفة دور المساعد (sidekick): يستكشف الشيفرة، ويكتب التغييرات، ويشغّل الاختبارات، ويرفع التقارير. يعمل الاثنان بالتوازي، ولكل منهما سياقه الدائم الخاص. وتستهدف الحجة التقنية توجيه النماذج، وهو الحل الذي يتبادر تلقائيًا إلى الذهن لخفض التكلفة: لا تكفي مطالبة أولية لقياس صعوبة مهمة، كما أن تغيير النموذج أثناء العمل يعطّل ذاكرة المطالبة المؤقتة. تتجاوز Fusion هذه المشكلة بعدم نقل المحادثات كاملة بين النموذجين مطلقًا، إذ لا يتبادلان سوى الموجزات والنتائج والملاحظات.
| التكلفة لكل مهمة، بالدولار | Fable 5.1 وحده | Fusion مع Fable 5.1 وSWE-2 | Astra وحده | Fusion مع Astra وSWE-2 |
|---|---|---|---|---|
| DeepSWE 1.1 | 14,63 | 7,88 | 7,88 | 4,69 |
| Terminal-Bench 4 | 17,46 | 13,37 | 10,08 | 6,06 |
| SWE-Atlas QnA | 7,57 | 5,00 | 5,72 | 3,59 |
| Vals Code Migration | 70,97 | 42,00 | 44,36 | 35,51 |
| FrontierCode 1.1 الموسّع | 2,68 | 1,67 | 2,62 | 2,34 |
One of our key findings is that using more expensive models can make the entire system cheaper.
🇸🇦 من أبرز اكتشافاتنا أن استخدام نماذج أعلى تكلفة يمكن أن يجعل النظام بأكمله أقل تكلفة. — Cognition، مدونة Fusion المحلية
أُجري الاختبار على جانبي الثنائي. فمن جهة القائد، أدى استبدال Opus 4.8 بـFable 5، الذي تبلغ تكلفته الاسمية لكل رمز ضعف التكلفة، إلى خفض متوسط تكلفة الجلسات بنسبة 9 في المئة مع بقاء المساعد نفسه، وتحقيق نتيجة أفضل على FrontierCode: كان Fable يفوّض في وقت أبكر ويكتب موجزات أفضل، بينما كان Opus يدير مساعده على مستوى التفاصيل الدقيقة. ومن جهة المساعد، أدى الانتقال من GPT-5.6 Luna إلى SWE-2، أي بزيادة 275 في المئة لكل مليون رمز، إلى خفض التكلفة الإجمالية للمهمة بنسبة 2 في المئة مع كسب 1.4 نقطة. وفي مؤشر Artificial Analysis Coding Agent Index v1.5، حقق Fusion مع Fable 5.1 وSWE-2 نتيجة 61.7 بتكلفة أقل بنسبة 36 في المئة من Claude Code مع Fable 5.1، الذي توقف عند 62.2. وتستخلص Cognition من ذلك قاعدة لعام 2026: تقييم النماذج، وكذلك ثنائيات النموذج ومنظومة التشغيل، وفق السعر لكل مهمة بدلًا من السعر لكل رمز. وهو موقف مريح لناشر يبيع منظومة تشغيل، لكن الأرقام أُنتجت بالتعاون مع Artificial Analysis وVals AI عبر خمسة معايير قياس منفصلة. ويتم التثبيت بأمر واحد.
تُطلق Sakana AI نموذجي Fugu Max وFugu Ultra v2، وهما تطوّران لمنظومة التنسيق متعددة الوكلاء الخاصة بها
11 سبتمبر — أصدرت Sakana AI نسختي Fugu Max وFugu Ultra v2، وهما نسختان جديدتان من Sakana Fugu، نظامها لتنسيق الوكلاء المتعددين (نظام تنسيق متعدد الوكلاء) المتاح خلف API واحدة متوافقة مع OpenAI. والخيط الناظم هنا هو جبهة Pareto: إذ ترى Sakana أن القطاع ما زال يفكر كما لو أن القدرة هي المحور الوحيد، بينما تُقيَّم المهمة الواقعية على محورين، هما القدرة والتكلفة.
ليس Fugu نموذجًا واحدًا، بل طبقة تنسيق متعلَّمة توجّه كل مهمة إلى مجموعة من النماذج مفتوحة الأوزان والمتخصصة. يوسّع Fugu Max هذه المجموعة، وهي الأكبر حتى اليوم وفقًا للشركة، بدمج عائلة NVIDIA Nemotron فيها، ويرسل كل مهمة إلى أخف نموذج قادر على حلها. ويحقق أفضل نتيجة إجمالية في ستة معايير قياس، ويوسّع جبهة التكلفة والأداء في سبعة من أصل عشرة، بسعر دولارين لكل مليون token في الإدخال و6 دولارات في الإخراج، وهو سعر إخراج تقول Sakana إنه أقل بنسبة تتراوح بين 40 و60 في المئة من أسعار Sonnet 5 وGPT 5.6 Terra وKimi K3.
| المقياس المُعلن | النتيجة | المقارنة التي قدمتها Sakana |
|---|---|---|
| Fugu Ultra v2، Chartography | 48,3 | Opus 5 عند 27,3؛ وFable 5 عند 29,5 |
| Fugu Ultra v2، DeepSWE | 74,3 | يتقدم على نماذج أعلى تكلفة لكل token بنحو 3 إلى 5 مرات |
| Fugu Ultra v2، الترتيب | الأول أو متعادل في المركز الأول في 5 من أصل 8 معايير قياس | ضمن أفضل مركزين في 7 من أصل 8 |
| Fugu Max، الترتيب العام | أفضل نتيجة في 6 معايير قياس | توسيع جبهة Pareto في 7 من أصل 10 |
تستحق النقطة التي تشدد عليها Sakana أكثر من غيرها التنويه: لا تدخل نماذج Fable 5 وFable 5.1 وGPT-6-Astra ضمن مجموعة وكلاء Fugu Ultra v2، الذي كان تاريخ قطع بيانات تدريبه في 28 أغسطس 2026. وتتمثل الحجة في مرونة الإمداد، إذ تحمي مجموعة قابلة للتبديل من الارتهان للمورّد وإلغاء صلاحيات API وانقطاع الخدمة. يتوفر النموذجان فورًا، ويمكن لمستخدم Fugu الانتقال إلى Max أو Ultra v2 بتغيير معامل واحد فقط. كما أن Fugu Max مُدرج على OpenRouter، مع إدخال متعدد الوسائط وبحث على الويب واستدلال قابل للضبط ومخرجات منظَّمة. وثمة تحفظ بشأن الاستخدام: تختار Sakana معايير القياس والنماذج المقارنة، وSWEFish معيار اختبار داخلي، كما تعتمد الفروق المُعلنة على أسعار النماذج المقارَنة وقت النشر.
🔗 تقديم Fugu Max وFugu Ultra v2
تُطلق ElevenLabs نموذج Music v2.5، مع تنزيلات دون فقدان للجودة في جميع الخطط
11 سبتمبر — أصدرت ElevenLabs نموذج Music v2.5 وجعلته النموذج الافتراضي في ElevenMusic، سواء للتوليد عبر prompt أو عبر مرجع صوتي. ويَعِد النموذج بآلات موسيقية تبدو كأنها مسجلة مباشرة، وتوزيعات أعمق، ومقطوعات طويلة، وانتقالات بين الأنواع الموسيقية أثناء المقطوعة، وموسيقى rap، وأصوات تبدو طبيعية في لغة النص. والمقياس المقدَّم هو اختبار أعمى شمل 47 885 زوجًا، مع عينة واحدة من كل نموذج لنفس prompt: فُضّل Music v2.5 في معظم الحالات، وظهر أوضح فارق في الأنواع التي تعتمد على الصوت والغناء الصوتي، وهي R&B وsoul وhip-hop وrock وmetal والموسيقى الأوركسترالية وموسيقى الأفلام. ولم تُنشر نسبة التفضيل الدقيقة.
أما الجانب الثاني فيغيّر المعادلة بدرجة أكبر للمستخدمين. فكل مقطوعة تُنشأ في ElevenMusic تعود ملكيتها إلى مؤلفها في جميع الخطط، بما فيها المجانية. تمنح الخطة المجانية خمسة تنزيلات دون فقدان للجودة (lossless) يوميًا مع السماح بالاستخدام التجاري بشرط نسب الفضل إلى ElevenMusic، بينما تمنح خطة Pro عدد 400 تنزيل شهريًا. وتظل الأذونات المكتسبة وقت الإنشاء مرتبطة بالمقطوعة: فلا يؤدي الإلغاء أو خفض الخطة إلى تغيير أي شيء في الأعمال المنتَجة مسبقًا، ولا يسري أي تغيير مستقبلي في الشروط إلا على الأعمال الجديدة. والاستثناء الوحيد هو المقطوعة المبنية على أغنية لفنان آخر، إذ يُحظر تنزيلها.
| العنصر المقاس أو المُعلن | القيمة |
|---|---|
| الأزواج التي خضعت للاختبار الأعمى | 47 885 |
| التنزيلات دون فقدان، خطة Free | 5 يوميًا، استخدام تجاري مع نسب الفضل |
| التنزيلات دون فقدان، خطة Pro | 400 شهريًا |
| معرّف API | music_v2_5 |
| النموذج الافتراضي في ElevenMusic | Music v2.5، مع الإبقاء على Music v2 |
يتوفر النموذج أيضًا في ElevenCreative، بصفته عقدة Music في Flows، وفي API تحت المعرّف music_v2_5. وتوضح ElevenLabs أن الاتفاقية متعددة السنوات التي أُعلن عنها في اليوم السابق مع Universal Music Group منفصلة عن هذا الإصدار. وبالنسبة إلى القارئ، فإن ترتيب الإعلانات مهم: فقد أُعلن أولًا عن الاتفاقية مع شركة التسجيل الكبرى، ثم صدر النموذج وحقوق الاستخدام الموسعة في اليوم التالي.
يقيس Claude Code القيمة الفعلية التي يضيفها plugin، بوجوده ومن دونه
11 سبتمبر — أعلن فريق Claude Developers عن claude plugin eval، وهو أمر فرعي في Claude Code يشغّل plugin أو skill على مجموعة من حالات الاختبار، ويقيّم كل تشغيل، ثم يعيد تنفيذ كل حالة من دون plugin لقياس ما يضيفه. الفكرة بسيطة ومقلقة قليلًا: فالنتيجة المرتفعة لا تثبت أن plugin مفيد، لأن Claude ينجح أحيانًا بالقدر نفسه من دونه. لذلك يعيد الأمر نتيجتين والفارق بينهما. فإذا حصلت حالة على 1,0 في كلا الفرعين، فلا فضل لـplugin في ذلك.
نقطة الدخول هي claude plugin eval init، ويُشغَّل من جذر plugin. تُفتح جلسة تفاعلية: يقرأ Claude محتوى plugin، ويسأل عن شكل النتيجة الجيدة، ويقترح prompts يُفترض أن تؤدي إلى تشغيله وأخرى لا ينبغي أن تفعل ذلك، ويصمم أدوات التحقق (graders)، ويجربها مرة، وينشئ دليلًا لكل حالة، ويعلن التكلفة المقدَّرة لتشغيل كامل. بعد ذلك، تُشغَّل كل حالة ثلاث مرات مع plugin وثلاث مرات من دونه، أي ست عمليات تنفيذ، لأن تشغيلًا واحدًا لوكيل غير حتمي لا يكشف الكثير. تعرض الوحدة الطرفية جدولًا بالحالتين، مع plugin ومن دونه، ويُكتب تقرير HTML مستقل على القرص، كما يُنشر التقرير في صورة artifact خاص عندما يسمح الحساب بذلك.
| نوع أداة التحقق | التكلفة من استدعاءات النموذج | شرط النجاح |
|---|---|---|
regex | لا شيء | العثور على النمط في آخر إجابة أو التتبع أو ملف |
tool_used | لا شيء | عدد استدعاءات أداة بين حد أدنى وحد أقصى |
tool_order | لا شيء | يسبق استدعاءٌ استدعاءً آخر |
file_exists | لا شيء | يطابق ملف أُنشئ أثناء التشغيل النمطَ |
llm | نموذج يُصدر الحكم | حكم إيجابي في صوتين على الأقل من أصل 3 |
baseline | نموذج يُصدر الحكم | يعادل التشغيل على الأقل نصًا مرجعيًا مفرغًا |
ينبغي فهم تفصيل دقيق قبل قراءة الفارق: لا يمكن لأداة تحقق تشترط استدعاء skill أن تنجح أبدًا من دون plugin، ولذلك تُستبعد من النتيجة في كلا الفرعين ولا يُبلَّغ عنها إلا بوصفها مؤشرًا، وإلا لتضخم الفارق اصطناعيًا. والعزل صارم. فكل تشغيل هو عملية فرعية مؤقتة، من دون إعدادات المستخدم أو hook أو CLAUDE.md أو خادم MCP أو plugin مثبّت أو ذاكرة. ولا تطرح عمليات التشغيل أي سؤال متعلق بالإذن، وتُزال الأدوات الحساسة من الجلسة ما لم يُصرّح بها صراحةً؛ وإذا مُنح Bash أو PowerShell على جهاز لا يحتوي على backend لبيئة معزولة، يرفض Claude Code التشغيل بدلًا من تنفيذه دون عزل. ويمكن تقييم plugin يتعامل مع أدوات MCP من دون الخدمة الفعلية، إذ يوفر ملف Markdown لكل أداة الاستجابة، مع كتلة تُجهض التشغيل إذا أرسل plugin شيئًا غير المتوقع.
Evals call the model, so they use tokens and results vary. […] Your plugin’s hooks and MCP servers run as you, so only evaluate plugins you trust.
🇸🇦 تستدعي التقييمات النموذج، ولذلك تستهلك tokens وتتفاوت النتائج. […] تعمل hooks وخوادم MCP الخاصة بـplugin باستخدام صلاحياتك، لذا لا تقيّم سوى plugins الموثوق بها. — @ClaudeDevs على X
التكلفة حقيقية: فكل عملية تنفيذ وكل أداة تحقق حَكَم هي استدعاء للنموذج يُحتسب من الخطة أو الفاتورة، ويعرض مثال التوثيق 74 ثانية و0,41 دولار لحالة من ستة تشغيلات. ومن هنا تأتي تعليمات الفريق: التجربة أولًا باستخدام --runs 1، قبل بدء تشغيل كامل. وفي التكامل المستمر، تكون رموز الخروج موثقة، ومنها 0 عندما ينجح كل شيء و2 لتشغيل جزئي عند بلوغ سقف التكلفة. ووفقًا للتوثيق، تكون النتيجة النموذجية الأولى فارقًا قريبًا من الصفر مع فشل أداة التحقق الخاصة بـskill: إذ لا يختار Claude تلك skill عند استخدام صياغة طبيعية، ويكون وصفها هو ما يحتاج إلى إعادة صياغة.
بقية الإصدار 2.1.269
يأتي الأمر الفرعي في الإصدار 2.1.269، المنشور في 11 سبتمبر الساعة 21:17 بتوقيت باريس. أما بقية الإضافات فهي أقل لفتًا للانتباه، لكنها مفيدة يوميًا. يسرد الأمر /output-style أنماط الإخراج ويغيّرها، بما في ذلك عبر Remote Control وفي جلسات cloud أو headless. وعندما تُستخدم أداة Bash لتعديل الملفات، تتضمن نتيجتها الآن diff للملفات المتغيرة، ما يعيد إلى Claude مستوى الرؤية نفسه الذي توفره عملية تحرير تقليدية. وفي جانب قابلية الرصد، يضيف متغير بيئة وسمًا إلى مقاييس وأحداث OpenTelemetry بحسب المستودع، بينما يضبط متغيران آخران مهلة اكتشاف نماذج gateway والحد الأقصى للوكلاء المتزامنين في أداة Workflow، حتى 256.
تمس الإصلاحات ثلاث مناطق حساسة: الإبطال الجزئي لذاكرة prompt المؤقتة بعد إجابة انقطعت ثم استُؤنفت، وقواعد الأذونات التي تبدأ بنفي بحيث لم تعد تنطبق إلا على مصدر الإعدادات الذي كتبها، والتحقق من مسار الكتابة الذي أصبح يشمل أخيرًا الملف الذي يكتبه أمر tee. وأصبح git status المعلَن بعد عملية compaction هو الحالي بدلًا من ذلك الذي كان عند بداية الجلسة. وفي VS Code، تفتح شارةٌ خريطةً للوكلاء الفرعيين تضم بطاقات وزر إيقاف ونصوصًا مفرغة للقراءة فقط، كما يتيح مربعا حوار إدارة hooks وقواعد الأذونات في إعدادات المستخدم والمشروع والإعدادات المحلية.
Antigravity، أربعة إصدارات في أسبوع واحد واستدراك بشأن Teamwork
نشرت Google تباعًا إصدارين من أداة سطر الأوامر وإصدارًا جديدًا من تطبيقها، فضلًا عن إصدارين سابقين لم تتم تغطيتهما هنا قط. ويستحق changelog أن يُقرأ دفعة واحدة، لأن إصدارات الأسبوع تروي القصة نفسها: يغادر الوكيل الوحدة الطرفية التفاعلية ليصبح خدمة.
Antigravity CLI 1.2.0: تتحول CLI إلى daemon يعمل في الخلفية وتتحكم فيه Remote Control
10 سبتمبر — الإصدار 1.2.0 من Antigravity CLI هو أول ترقية لإصدار فرعي منذ يوليو. تسجّل ثلاثة أوامر فرعية، remote-control start وstatus وstop، أداة سطر الأوامر لدى مدير خدمات النظام بوصفها daemon يعمل في الخلفية ويستمر بعد قطع الاتصال وإعادة التشغيل، مع خيار لتسمية المثيل وآخر لقصر الخدمة على جلسة تسجيل الدخول النشطة. وحتى الآن، كان يلزم إبقاء وحدة طرفية مفتوحة قيد التشغيل. ويمتد التمرير نصف صفحة إلى جميع طرق العرض مع اختصارين افتراضيين جديدين. ومن بين الإصلاحات الثمانية، الأكثر فائدة لفهم سلوك غير متوقع هو أن prompt أو إجابة تحظرها مرشحات سلامة المحتوى تعرض الآن سبب الإيقاف صراحةً، بعدما كان المستخدم يرى خطأ عامًا أو دورة فارغة. كما أصبحت خوادم MCP المضمّنة في plugins العامة تُهيّأ أخيرًا بصورة صحيحة عند بدء التشغيل.
Antigravity CLI 1.1.28: توسيع عمليات الاستئناف عند الخطأ، وتسريع الوضع دون واجهة، وإخضاع قراءة URL للموافقة
9 سبتمبر — في اليوم السابق، ركز الإصدار 1.1.28 تسعة تحسينات على المرونة والوضع دون واجهة، أي ذلك الذي يُستدعى من script. تُعاد محاولة أخطاء API المؤقتة الخاصة بالنموذج باستخدام backoff أُسّي ممتد، ولم يعد بدء التشغيل يطلق طلب شبكة لقراءة هوية المستخدم، كما أزيل ما يصل إلى 200 ميلي ثانية من التأخير الخامل في كل دورة. ويستحق تغييران سلوكيان اهتمام من ينفذ الأتمتة.
| التغيير السلوكي | قبل الإصدار 1.1.28 | منذ الإصدار 1.1.28 |
|---|---|---|
| انتهاء المهلة في وضع script | فشل بسبب timeout | إعادة مخرجات جزئية، ورمز نجاح، وتحذير |
| قراءة الوكيل لـURL خارجي | من دون مطالبة | تُطلب الموافقة افتراضيًا، إلا عند منح الوصول مسبقًا |
لذلك يجب على script كان يعتمد على وصول ضمني إلى الويب أن يمنح هذا الإذن صراحةً. وأصبحت مطالبات الموافقة تسمي الآن الإجراء الدقيق، وتضيف سطرًا يوضح السبب عندما يأتي الطلب من hook أو ملف تابع لمشروع آخر.
Antigravity CLI 1.1.26 و1.1.27، استدراك: prompt لمرة واحدة على نموذج آخر وتبعيات الوكلاء الفرعيين في frontmatter
4 و5 سبتمبر — يسد الإصداران 1.1.26 و1.1.27 الفجوة ويقدمان أبرز ميزة ملموسة في المجموعة: إذ أصبح أمر اختيار النموذج يقبل prompt، يُنفذ مرة واحدة على نموذج آخر قبل أن تعود الجلسة إلى النموذج الأصلي. وبذلك يمكن الحصول على رأي ثانٍ من نموذج أقوى أو أقل تكلفة، من دون المساس بالإعداد الافتراضي. ويضيف الإصدار نفسه قائمة وكلاء إلى frontmatter بصيغة Markdown للوكلاء المخصصين، للتصريح بالوكلاء الفرعيين الذين يعتمدون عليهم، إلى جانب إصلاحين مهمين لعمليات الأتمتة: يُرفض استدعاء MCP يحتوي على وسيطة غير مصرّح بها في schema الخادم ويُصحَّح بدلًا من حذفها بصمت، كما تسمّي عملية التنفيذ دون واجهة الإجراءات المرفوضة في مخرجات JSON بدلًا من تجاهلها من دون كلمة.
Antigravity 2.13.0: قسم المستندات، وعارض افتراضي لملفات SQL وJSONL، واختصارات للاقتباس
9 سبتمبر — يقدم Antigravity 2.13.0 ستة عشر تحسينًا وستة عشر إصلاحًا. أصبحت الملفات الخارجية المضافة إلى محادثة، وروابط Google Drive، وملفات PDF، ومستندات Office، مجمعة في قسم «المستندات» فوق Artifacts، بدلًا من اختلاطها بمخرجات الوكيل. أما ملفات المسودات التي يكتبها الوكيل لنفسه فتنتقل إلى قسم منفصل. وتُفتح عناصر الشيفرة والبيانات، مثل ملفات SQL وJSONL، في عارض افتراضي مزود بتلوين بناء الجملة وأرقام الأسطر، يظل سلسًا مع الملفات الكبيرة ويدعم التعليقات المضمنة. ويتحول السؤال الجانبي المغلق إلى زر بدل حذفه، وتحصل المطالبات التفاعلية على زر إلغاء، ويمكن اقتباس النص المحدد في الدردشة باستخدام اختصار لوحة مفاتيح. ويتعلق إصلاحان بشفافية الأذونات: تظل الخطوة المرفوضة ظاهرة مع وسم Rejected بدل اختفائها، ولا يعيد الوكيل طلب الإذن لقراءة عناصر من مشاريع أخرى عندما يكون الوصول من خارج المشروع ممنوحًا بالفعل.
🔗 سلسلة نصائح @antigravity على X
Teamwork، استدراك تحديث 27 أغسطس
يستحق منشور نُشر في 27 أغسطس، ولم يُغطَّ هنا قط ولا يزال يتصدر قسم المطورين في صفحة مستجدات Gemini، أن نستدركه. يُعد Teamwork إطار تنسيق متعدد الوكلاء في Antigravity، حيث يقترح الوكلاء أعمال بعضهم وينتقدونها ويحسنونها بصورة متبادلة على مدى ساعات أو أيام، وهو متاح في إصدار تجريبي ضمن جميع الخطط المدفوعة. ويأتي معه خمسة أنماط تُختار تلقائيًا وفقًا للمطالبة، بدءًا من البرمجة التكرارية ومرورًا بمراجعة المستندات ووصولًا إلى البرهان المطول. وفي نمط البرهان المطول، تعلن Google حل سبع مسائل مفتوحة، من بينها حدسية دورات Knuth، التي أُنتج لها برهانان يزيد طول أحدهما على 40 صفحة والآخر على 70 صفحة؛ وقد جرى التحقق رسميًا من البرهان المؤلف من 40 صفحة باستخدام Lean، بينما أكد خبراء بشريون النتائج الأخرى، وأُودعت خمس أوراق بحثية على arXiv.
| المقياس المُبلّغ عنه | القيمة |
|---|---|
| TCSBench، وGemini 3.7 Flash و3.1 Pro في البرهان المطول | 71 في المئة |
| TCSBench، وGemini 3.6 Flash و3.1 Pro، الورقة الأصلية | 67,7 في المئة |
| محاكي RISC-V، خطأ محاذاة الدورات | 0,71 في المئة |
| المسائل المعاد إنتاجها باستخدام Gemini 3.7 Flash | 3 من 7 |
وخارج نطاق الرياضيات، أنشأ Teamwork من الصفر محاكيًا دقيقًا على مستوى الدورة لمعالج RISC-V ينفذ التعليمات خارج ترتيبها، ويُقلع نظام xv6 حتى الوصول إلى الصدفة ويشغّل أكثر من مئة اختبار معياري، وقد جرى التحقق منه بمقارنته بالتنفيذ على العتاد. كما دُمجت مساهمتان في المنبع ضمن مشروعين مفتوحي المصدر: مسار سريع موجّه في Eigen، ونسخة من جدول تجزئة متزامن تضاعف معدل إدراجها عند 64 خيطًا.
🔗 Teamwork، عندما يصبح الذكاء الاصطناعي شريكًا في البحث
GitHub Copilot يحل تعليقاته بنفسه ويضيف Jira إلى تطبيقه
مراجعة الشيفرة تنتقل إلى مجموعة من الوكلاء
11 سبتمبر — يحدّث GitHub ميزة Copilot code review على مستويين. فمن ناحية التجربة، عندما يستجيب التزام لاحق لتعليق من Copilot، تحل المراجعة ذلك التعليق تلقائيًا، بحيث لا تتضمن قائمة التعليقات المفتوحة سوى ما لا يزال ينتظر ردًا؛ وعند تطبيق اقتراح شيفرة، يصوغ Copilot رسالة التزام ملائمة للتغيير بدلًا من الرسالة المعبأة مسبقًا. ومن ناحية التحليل، أصبح وكيل المراجعة يمتلك الآن مجموعة أدوات الصدفة الكاملة في SDK الخاص بـCopilot، وتُنفذ خلف جدار حماية الوكيل: فيمكنه تشغيل عملية بناء، وتنفيذ الاختبارات، وتشغيل برنامج نصي محدد، أو الاستعلام من واجهات API المتاحة للتحقق من الشيفرة التي يراجعها. ويذكر GitHub زيادة في الملاحظات الإيجابية، والمزيد من النتائج عالية الخطورة، وانخفاضًا في الملاحظات التفصيلية، من دون تقديم أرقام عن ذلك.
أما مستوى الجهد Lite فلم يعد يعتمد على وكيل واحد، بل على مجموعة من الوكلاء يقدم كل منهم قراءته، ثم تُدمج القراءات في مراجعة واحدة.
| النتيجة المقاسة، مراجعات Lite الجماعية | التغير المُعلن |
|---|---|
| التعليقات المأخوذة في الحسبان، خطورة مرتفعة | زيادة بنسبة 47 في المئة |
| التعليقات المأخوذة في الحسبان، خطورة متوسطة | زيادة بنسبة 31 في المئة |
| التعليقات المأخوذة في الحسبان، خطورة منخفضة | زيادة بنسبة 11 في المئة |
| تكلفة المراجعة | أقل بنحو 8 في المئة |
لم يُحدَّد عدد الوكلاء في المجموعة ولا النماذج المستخدمة. وهذا هو التطور الثالث في Copilot code review خلال أسبوعين.
Jira في التطبيق، وHydraFusion في سطر الأوامر، وVS Code 1.137
10 سبتمبر — يقدم الملخص الأسبوعي لأسبوع 7 سبتمبر، الذي شهد Copilot Day، تكامل Jira داخل تطبيق Copilot: تُجلب التذاكر إلى لوحة مشتركة، ويُختار فيها ما ينبغي دفعه إلى الأمام، ويحمل Copilot سياق التذكرة إلى مراحل التحقيق والتنفيذ وإعداد طلب السحب. وفي Copilot CLI، أصبح Project HydraFusion قابلًا للاختيار مثل أي نموذج آخر، ويختار لكل مهمة مسارًا يجمع بين النماذج المحلية والسحابية والمركبة، مع الموازنة بين الأداء والتكلفة وزمن الاستجابة.
ويقدم VS Code 1.137، الصادر في 9 سبتمبر، ثلاث ميزات خاصة بالوكلاء. تتيح الأتمتة، المتاحة في إصدار تجريبي عام، جدولة مهام متكررة للوكيل كل ساعة أو يوم أو أسبوع، انطلاقًا من قوالب جاهزة مثل فرز المشكلات أو البحث عن الأخطاء. ويتيح الوضع الصوتي التجريبي التحدث إلى الوكيل أثناء عمله، أو مقاطعته، أو إعادة توجيهه. وأخيرًا، يُفتح رابط إلى مشكلة أو طلب سحب مباشرة في نافذة Agents، حتى من دون فتح مستودع. كما تضيف ملاحظات الإصدار مضيفًا للوكلاء قائمًا على بروتوكول مخصص ومدعومًا بـSDK الخاص بـCopilot، يوحّد سلوك وكيل VS Code مع سلوكه في سطر الأوامر والتطبيق.
Habitat، منصة التخزين المتصل التابعة لـOpenAI وإعادة كتابتها بلغة Rust على يد مهندسين اثنين
11 سبتمبر — تنشر OpenAI الجزء الأول من تدوينة هندسية عن Habitat، منصة التخزين المتصل التي تقف خلف ChatGPT وAPI وCodex. وتوضح الأرقام حجمها: أكثر من 70 مليون طلب في الثانية، وأكثر من مليار شخص تُقدم لهم الخدمة أسبوعيًا، ونحو 40 منطقة، وأكثر من 500 بيتابايت من البيانات. بدأت Habitat في منتصف 2024 كمكتبة Python صغيرة مدمجة في خادم ChatGPT الرئيسي، ومرتبطة بقاعدة بيانات مُدارة، بفكرة بسيطة: ينبغي ألا يضطر مهندسو المنتجات إلى التفكير في المخطط أو التوجيه أو التفويض أو مجمعات الاتصالات.
وفي منتصف 2025، بلغ نموذج المكتبة من جهة العميل حدوده. فكان كل تغيير في البروتوكول يتطلب تنسيق عمليات نشر عبر عشرات الخدمات؛ واستغرق نشر خاص بالتوجيه الإقليمي أيامًا، ثم عادت إحدى الخدمات إلى عميل معيب، فتسببت في الانقطاع الذي كان يفترض أن تمنعه العملية. عندها أصبحت Habitat خدمة مستقلة، واختارت OpenAI الاستمرار باستخدام Python مع قبول دين تقني متعمد، مراهنةً على أن نماذج البرمجة الخاصة بها ستجعل الترحيل مستقبلًا ممكنًا.
يصف الجزء الأكبر من التدوينة مطاردة أزمنة الاستجابة الطرفية على هذا النطاق: تأخير الجدولة في asyncio، الذي كان يمكن أن يبلغ مئات المللي ثانية، وقد عولج عبر الحد من الطلبات المتزامنة لكل عملية؛ وتحليل الإعدادات التي تُحدَّث كل دقيقة من دون إزاحة عشوائية، ما كان يجمد جميع عمليات العمل في الوقت نفسه؛ وإعادة استخدام الاتصالات وفق مبدأ «آخر داخل أول خارج» في إحدى مكتبات HTTP، ما كان يركز حركة المرور على العمليات البطيئة أصلًا، وهو إخفاق شبه مستقر عولج أولًا بعكس الترتيب ثم بتفويض موازنة الحمل إلى شبكة خدمات. أما API نفسها فمحدودة عمدًا، إذ تعتمد نموذجًا من الكائنات والحواف بلا استعلامات غير محدودة ولا عمليات ربط، وهذا النطاق المقيد هو ما أتاح دفع Python إلى هذا الحد.
| المقياس المقاس | القيمة المُعلنة |
|---|---|
| الطلبات في الثانية حاليًا | أكثر من 70 مليون |
| الأشخاص المخدومون أسبوعيًا | أكثر من مليار |
| البيانات المقدمة | أكثر من 500 بيتابايت |
| ذروة خدمة Python | أكثر من 20 مليون طلب في الثانية |
| إعادة الكتابة بلغة Rust | مهندسان، وCodex، وGPT-5.5 |
| حصة حركة المرور التي تخدمها Rust | 95 في المئة من طلبات الإنتاج |
| تحسن كفاءة المعالج والذاكرة | 6 أضعاف و15 ضعفًا |
وفي الربع الثاني من 2026، أعاد مهندسان كتابة الخدمة بأكملها بلغة Rust باستخدام Codex وGPT-5.5. وتعالج خدمة Rust نسبة 95 في المئة من طلبات الإنتاج، باستهلاك أقل للمعالج بست مرات وللذاكرة بخمس عشرة مرة؛ وسيجري إيقاف Python خلال الأسابيع المقبلة. وسيتناول الجزء الثاني طبقة التخزين.
🔗 توسيع نطاق التخزين لخدمة مليار مستخدم
OpenAI تطلب من مستخدمي Codex تخفيف skills وAGENTS.md والمطالبات
11 سبتمبر — تنشر مدونة مطوري OpenAI دليل تنظيف لمستخدمي Codex المنتقلين إلى GPT-6 Astra. وتنطلق من ملاحظة مفادها أن عامًا من التعليمات المتراكمة لتوجيه النماذج السابقة يصبح عبئًا على نموذج أكثر قدرة. وبالنسبة إلى skills، فالآلية ملموسة: تحمل كل skill اسمًا ووصفًا إلى السياق، وعندما يزداد عددها كثيرًا يختصر Codex تلك الأوصاف، بحيث يرى النموذج قدرًا أقل من كل واحد منها وتتراجع جودة اختياره.
| التعليمة موضع الدراسة | التوصية لـGPT-6 Astra |
|---|---|
| وصف skill | قصير، ذو مُشغّل دقيق، وليس نطاقًا كاملًا |
| بنية skill متعددة المسارات | وثيقة جذر مختصرة تعمل كموجّه إلى المستندات والبرامج النصية |
| القراءات المفروضة في AGENTS.md | مستند واحد لكل نوع من التغييرات، لا كومة تُقرأ عند كل تعديل |
| تعليمات الاختبار | زائدة عن الحاجة، فالنموذج يشغل الاختبارات بنفسه |
| نهاية المهمة | تحديد معنى الاكتمال، والتصريح مسبقًا بمسارات العمل الآمنة |
| المحظورات الموروثة | ينبغي تخفيفها، وإلا توقف النموذج مبكرًا |
أما النقطة الأهم فتتعلق بسلوك النموذج. تقدم OpenAI نموذج GPT-6 Astra بوصفه أكثر حذرًا من سلفه بشأن نطاق المهمة، وقد يعود لطلب المراجعة بعد تنفيذ أولي. والاستجابة الموصى بها هي تحديد معنى الاكتمال صراحةً، ومنح الإذن مسبقًا لمسارات العمل المعروفة بأمانها، مثل حزمة اختبارات محلية تستخدم بيانات اختبار مؤقتة قابلة للتخلص منها. وعلى العكس، قد تدفعه الآن ضوابط الحماية الصارمة جدًا، التي كُتبت لكبح النماذج القديمة، إلى التوقف مبكرًا. وتذكّر التدوينة أيضًا بأن وكلاء المساهمين الآخرين يقرؤون skills الموجودة في المستودع، وقد يعمل هؤلاء أحيانًا على نماذج أخرى؛ لذلك قد تفرض تعليمة مفيدة لهم قيودًا مفرطة على Astra. وتختتم باقتراح عملي: اطلب من Astra تدقيق تعليمات المشروع بنفسه. وقد حُدّثت skill الخاصة بإنشاء skills في هذا الاتجاه.
🔗 إعادة التفكير في skills والمطالبات لـGPT-6 Astra
ChatGPT Sites يتجاوز 5 ملايين موقع خلال ثلاثة أشهر
11 سبتمبر — يستعرض حساب ChatGPT الرسمي حصيلة ChatGPT Sites، الميزة التي أُطلقت قبل ثلاثة أشهر لإنشاء تطبيقات ويب كاملة واستضافتها انطلاقًا من محادثة: فقد أُنشئ أكثر من 5 ملايين موقع منذ ذلك الحين. ويهدف المنشور أساسًا إلى تلخيص خمسة تطورات لم تحظَ بالانتباه.
يتعلق اثنان منها بالعمل الجماعي. يتيح الأول دعوة زملاء الفريق إلى تعديل موقع مشترك وحفظه ونشره؛ ويتيح الثاني فتح الموقع لأشخاص محددين من دون جعله عامًا. أما الثلاثة الأخرى فتخص دورة حياة الموقع: يُفترض أن الانتقال من المطالبة إلى النشر أصبح يستغرق نصف الوقت، ويمكن لـChatGPT فحص قاعدة بيانات الموقع عند الطلب، مع إتاحة الوصول إليها للمحررين أيضًا، كما يمكن ربط نطاق مخصص بالموقع. وقد أعاد حساب المطورين نشر الإعلان، في إشارة إلى أن الميزة تستهدف أيضًا النماذج الأولية السريعة، لا صفحات الجمهور العام وحدها.
Together AI توسع نطاق fine-tuning ليشمل 17 نموذجًا مفتوحًا وتضيف محولات إلى الخبراء
11 سبتمبر — توسع Together AI خدمة fine-tuning لتشمل سلسلة التجربة بأكملها. وينضم سبعة عشر نموذجًا مفتوح الأوزان إلى الكتالوج، من بينها GLM 5.3 وإصداراه السابقان، وDeepSeek-V4-Flash، وKimi K2.7-Code وK2.6، وعائلة Qwen التي تتراوح من 0,8 إلى 35 مليار مُعامل، وGemma 4. وتذكر الشركة أن GLM-5.3 سجل 88,2 على Terminal-Bench 2.1، بفارق أقل من نقطة واحدة عن أفضل النماذج الاحتكارية وفقًا لها.
وتتمثل الميزة الجديدة الثانية في تتبع التجارب: تسجل كل مهمة الخسارة ومعيار التدرج ومعدل التعلم عند كل خطوة، مع تحديث المنحنيات أثناء التنفيذ، وإمكانية وضع عدة مهام فوق بعضها في الرسم البياني نفسه، وإتاحة السلاسل الخام عبر API. ويوقف الإنهاء المبكر التدريب عندما تتوقف خسارة التحقق عن التحسن، ويحتفظ بأفضل نقطة تحقق بدلًا من الأخيرة، ويعيد تكلفة الخطوات غير المستهلكة.
أما الجانب الأكثر تقنية فهو Expert LoRA. ففي نموذج مزيج الخبراء (Mixture-of-Experts)، يوجد أكثر من 90 في المئة من المُعاملات داخل طبقات الخبراء، التي يتركها المحول التقليدي مجمدة إذ لا يرتبط إلا بطبقات الانتباه.
| اختبار على 200 حقيقة مختلقة | محولات تشمل الخبراء | محولات على الانتباه وحده |
|---|---|---|
| استدعاء الحقائق الجديدة | حتى 89 في المئة | 15 في المئة |
| MMLU-Pro | 75,3 في المئة | 71,5 في المئة |
ويتمثل التفسير المطروح في أنه عند حصر المحولات في طبقات الانتباه، تصبح نسبة متزايدة من الخبراء الموجّه إليهم غير مستخدمة أثناء fine-tuning. كما تخرج معالجة البيانات من الصندوق الأسود، مع معاينة للأسطر بعد تقسيمها إلى رموز، وأوزان لكل مثال، والتحقق الكامل من الملف على الخادم فور اكتمال رفعه. وتنخفض أسعار التدريب بنسبة تتراوح بين 30 و70 في المئة وفقًا للنماذج.
مساهمات المجتمع، وبيئة معزولة لكل محاولة، ومئة لغز حمار وحشي
قدمت مدونة مجتمع Hugging Face في اليوم نفسه ثلاثة أعمال تستحق أكثر من نبذة قصيرة، وخمسة أعمال أخرى ستجدونها أدناه.
كيف تُشغّل ثلاثة عشر مختبرًا التعلم المعزز لوكلائها
11 سبتمبر — يستعرض Sergio Paniego خمسة عشر تقريرًا من ثلاثة عشر مختبرًا، نُشرت بين أكتوبر 2025 وسبتمبر 2026، ولا يأخذ في الحسبان سوى ما يقول كل مختبر إنه يدرّبه، لا ما يقيّمه. الخلاصة الأساسية: لم تعد البيئة محاكيًا في الذاكرة، بل جهازًا كاملًا مزودًا بنظام ملفات وصدفة وعمليات، يُشغّل لمحاولة واحدة ثم يُدمّر بعدها. تفعل Liquid AI ذلك لنموذج يضم 2.6 مليار معلمة، وتتحدث Cursor عن مئات الآلاف من البيئات المتزامنة لتدريب نموذجها، وتوفّر Microsoft حاوية جديدة لكل مهمة، بينما تذهب Kimi K3 أبعد من ذلك باستخدام آلات افتراضية مصغرة قابلة للاستئناف لمسارات من مليون token.
| طبقة المكدس | ما تحتفظ به المختبرات | البدائل العامة المذكورة |
|---|---|---|
| المهام وأدوات التحقق | أكثر من 10 000 بيئة برمجية لدى GLM-5 | Environments Hub, verifiers, Harbor |
| عقد الإجراء، وحزام التشغيل | تنشئ Kimi خمسة أحزمة تشغيل بصندوق أبيض | OpenEnv, SkyRL, BrowserGym, TextArena |
| البيئة المعزولة | مئات الآلاف من الآلات الافتراضية لكل عنقود | Modal, E2B, AgentENV, Hugging Face Sandboxes |
| المدرّب | slime لدى Zhipu، وForge لدى MiniMax، وRLVR لدى NVIDIA | TRL, Miles v0.1 |
ومن الاتجاهات اللافتة أن حزام التشغيل يصبح هو نفسه البيئة، إما بإعادة بنائه كصندوق أبيض، وإما بتركه كما هو ومراقبته كصندوق أسود. وتتفاوت الشفافية بشدة: توثّق Ai2 نحو 17.2 مليون عينة برمجية متحققًا منها لنموذج OLMo 3، بينما لا تنشر OpenAI وAnthropic وGoogle شيئًا تقريبًا، إذ لا تتجاوز بطاقة نظام GPT-6 Astra جملة واحدة. ويذكر الكاتب تكلفة تتجاوز عشرة ملايين دولار لبيئة واحدة فقط في المختبرات الكبرى. ويختتم المنشور سلسلة Training Agents.
🔗 بيئة معزولة واحدة لكل عملية طرح
مئة لغز حمار وحشي توقظ الاستدلال الرياضي
11 سبتمبر — يفيد مقال مجتمعي بقلم tamewild بأن ضبطًا دقيقًا لبضع دقائق على 100 إلى 500 من ألغاز الاستنباط المنطقي، من دون أي بيانات رياضية، يكفي لإحداث قفزة في أداء نماذج الأساس الصغيرة على معايير الرياضيات.
| نموذج الأساس المدرَّب | MATH-500 | AIME 2025 | المرجع الرسمي المقارن |
|---|---|---|---|
| Qwen 3 4B، و100 لغز في 6 دقائق و23 ثانية | 84.60 في المئة | 21.67 في المئة | النسخة اللاحقة للتدريب: 84.80 و19.10 |
| Granite 4.1 3B، و500 لغز في 23 دقيقة | 77.73 في المئة | 19.44 في المئة | نسخة Instruct: 66.60 و6.67 |
| Qwen 3.5 9B، و500 لغز في 40 دقيقة | 96.60 في المئة | 60.67 في المئة | النسخة اللاحقة للتدريب: 97.40 و60.56 |
كما قِيست الآثار البنيوية: في أكبر النماذج الثلاثة، ينخفض الطول الوسيط للإجابات إلى ما دون نظيره في النموذج الرسمي، وتتراجع نسبة حلقات التكرار عند فك الترميز الجشع من 6.06 إلى 0.67 في المئة. ويبقى الكاتب حذرًا، إذ اعتمد تشغيلات استكشافية ببذرة واحدة، ويشير إلى أن دراسات الاستئصال التي أجراها تُظهر أن محولًا تقليديًا يحقق أيضًا قرابة 80 في المئة على MATH-500: فالتعميم يأتي أولًا من البيانات المنطقية. وقد نُشرت الشفرة ودفاتر الملاحظات وثلاثة نماذج ومجموعتا بيانات.
🔗 استثارة الاستدلال باستخدام 100 إلى 500 من ألغاز الحمار الوحشي
سلسلة صوتية للغة بلا مجموعة بيانات
10 سبتمبر — يروي Osmanov بناء سلسلة صوتية متكاملة لتتارية القرم، وهي لغة مهددة لا يتوفر لها تعرف على الكلام ولا توليد صوتي، ويعرض خلاصة قابلة للتعميم: لم يكن التدريب سوى خطأ تقريبي. استغرق محول التعرف 90 دقيقة على وحدة معالجة الرسوميات في حاسوب محمول، وخفّض معدل خطأ الكلمات من 34.6 إلى 20.1 في المئة، ثم إلى 17.0 باستخدام بحث شعاعي لا يغيّر أي وزن. وقد استُهلك الجدول الزمني كله تقريبًا في بناء متن لم يكن موجودًا والتحقق من أن التقييم لا يعطي نتائج مضللة.
ثمة خياران يستحقان التذكر. أولًا، اختير نموذج الأساس بناءً على افتراض صوتي مسبق بدلًا من التقارب اللغوي: تمتلك تتارية القرم الصوت اللهوي /q/ الغائب عن التركية، وكانت النماذج الأساسية المدرَّبة تحت معرّف اللغة التركية تنطقه /k/ من دون أن يصحح الضبط الدقيق شيئًا. وثانيًا، في غياب نظام تعرف يمكن استخدامه لبدء بناء متن، قلب الكاتب المسألة مستعينًا بكتب صوتية معروفة النص، فاستخرج 336 دقيقة صالحة للاستخدام، بينما لم ينتج عن محاذاة تنحرف تدريجيًا سوى 110 دقائق. أما النتيجة السلبية الأكثر فائدة فهي ثبات المقياس عند مستوى معين: حين زيد متن التوليد من 5.9 إلى 15.3 ساعة، لم يتغير معدل خطأ المحارف، مع أن الاستماع الأعمى كان يفضّل في كل مرة الصوت الأحدث. ويوثق أخيرًا تسربًا شائعًا، إذ تكرر 96.9 في المئة من مقاطع كتاب الاختبار ضمن بيانات التدريب، وقد اكتُشف ذلك باستخدام سلاسل n-gram النصية لا أسماء الملفات.
🔗 تقنيات الكلام للغة بلا مجموعة بيانات
تطلق Replit ميزة Routines للعمل المتكرر الذي لا يستدعي الوكيل إلا عند الحاجة
11 سبتمبر — قدّمت Replit ميزة Routines، التي تنفذ أعمالًا متكررة وفق جدول زمني كل ساعة أو يوميًا أو أسبوعيًا. ولا تكمن أهمية الإعلان في الجدولة، وهي أمر مألوف، بقدر ما تكمن في طريقة معالجة الشركة لمسألة التكلفة. تنطلق الشركة من ملاحظة صريحة: بات الوكلاء قادرين على أتمتة معظم المهام المتكررة، لكن تشغيلهم باستمرار يستهلك عددًا هائلًا من tokens. والحل هو عدم وضع الوكيل في مركز الحلقة. يبدأ كل تنفيذ بشفرة حتمية، ولا يُستدعى الوكيل إلا عندما تكون هناك حاجة فعلية إلى الاستدلال.
تخالف هذه البنية الاتجاه السائد الذي يعهد بدورة كاملة إلى نموذج. وهنا يعود النموذج موردًا يُستدعى عند الحاجة، وتحيط به شفرة عادية يمكن التنبؤ بسلوكها وتكلفتها. وبالنسبة إلى مهمة مجدولة تتكرر مئات المرات، لا يكون الفرق في الفاتورة هامشيًا. ولم يصاحب الإعلان منشور في مدونة.
تدمج Warp وكيل Grok Build بوصفه وكيلًا من الدرجة الأولى
11 سبتمبر — أعلنت Warp عن دعم مدمج لـGrok Build CLI، وكيل سطر الأوامر من SpaceX AI، وسرعان ما أعاد حساب Grok نشر خبر الدمج. وكانت الميزة قد أُدرجت بالفعل في إصدار الطرفية بتاريخ 9 سبتمبر، حيث يصفها سجل التغييرات بأنها دعم من الدرجة الأولى: تكتشف Warp جلسات Grok Build، وتطبق عليها مظهرًا مرئيًا مخصصًا في التذييل، وتفعّل لها وضع الإدخال المحسّن.
عمليًا، يحصل مستخدم Grok Build على الأدوات نفسها المتاحة للوكلاء الأصليين في الطرفية. يقبل الإدخال المحسّن المطالبات الطويلة الملصقة والمؤشرات المتعددة، وهو ما يحدث فرقًا لمن يكتب تعليمات من عدة فقرات. ويتيح أمر مشاركة جلسة الوكيل الجارية مع جهاز آخر، فيما يظل مستكشف الملفات ولوحات مراجعة الشفرة متاحة أثناء الجلسة. ويُستخدم اشتراك Grok الحالي للوصول، من دون الإعلان عن سعر أو حد مخصص.
تُكمل الإضافة قائمة واسعة بالفعل من وكلاء الجهات الخارجية المستضافين داخل طرفية Warp، إلى جانب Claude Code وCodex وDroid وAntigravity، وتواصل عملًا بدأ في وقت سابق من الصيف حول منظومة xAI، مع إضافة أمر في أغسطس لتسجيل الدخول باستخدام حساب X Premium أو SuperGrok. ويظل منطق Warp كما هو منذ إطلاق وكيلها: ألا تحصر المستخدم داخل وكيل خاص بها، بل أن تجعل الطرفية المكان الذي تعمل فيه جميع الوكلاء بالمستوى نفسه من جودة التكامل. ويصلح باقي الإصدار مصدرين للإزعاج: لم تعد المطالبات المكتوبة وغير المرسلة تُمحى عند تغيير النموذج، كما أصبحت أدوات MCP المعلنة في ملف عام متاحة منذ أول إجابة للوكيل.
🔗 إعلان Grok على X · 🔗 إعلان Warp على X
Vibe CLI 2.25.3، أمر التفريع وسجلات الجلسات الخاصة
11 سبتمبر — أصدرت Mistral الإصدار 2.25.3 من Vibe CLI، وهو إصدارها الثالث خلال ثلاثة أيام. الميزة الظاهرة هي الأمر /branch: فهو يفرّع المحادثة الجارية إلى جلسة جديدة قابلة للاستئناف، مع إبقاء الجلسة الأصلية سليمة. ثم يمكن استئناف النسخة في طرفية أخرى، مما يتيح استكشاف مسار بديل انطلاقًا من السياق نفسه من دون التضحية بالمسار الرئيسي. وأصبحت الإشارات إلى الملفات بعلامة @ تعتمد الآن على اكتشاف يراعي Git، كما تقبل الملفات أو المجلدات الملصقة وحدها في المطالبة.
أما في جانب الإصلاحات، فهناك ثلاث نقاط. تظل المحادثات المحفوظة قابلة للقراءة وتستعيد أشجار العمل الخاصة بها عند استئناف العمل. ولم تعد سجلات الجلسات الجديدة قابلة للقراءة من المستخدمين الآخرين على أنظمة POSIX، وهو إصلاح لأذونات الملفات يواصل ما بدأه الإصدار 2.25.1، الذي أزال مستمع تصحيح غير موثّق، وضمن ألا يؤدي أي إخفاق إلى موافقة تلقائية. وأخيرًا، تُحمّل تعليمات ملف AGENTS.md الآن في مطالبة النظام ضمن حزام التشغيل الموحد التجريبي. ويرافق الإصدار أربع عشرة حزمة ثنائية؛ ولا تشير أي ملاحظة إلى تغيير في النموذج أو السعر.
🔗 ملاحظات إصدار Vibe CLI 2.25.3
تحوّل Synthesia وكيل الامتثال الخاص بها إلى بنية تحتية مشتركة
10 سبتمبر — ينشر Nicolás Barberis، رئيس عمليات الثقة لدى Synthesia، تتمة منشوره الصادر في يونيو عن الوكيل الذي يجمع أدلة الامتثال. وجاء السؤال الذي وجّه إعادة التصميم من القراء: ما إن يجمع وكيل أدلة التدقيق حتى تصبح عملية الجمع نفسها ضمن نطاق التدقيق، ويجب أن يكون بالإمكان الوثوق بمنفّذ الجمع. وتكمن الإجابة في أربعة خيارات بنيوية، جميعها قابلة للنقل إلى سياقات أخرى.
أولًا، فصل الآلية عن المنهج. تعيش الشفرة في مستودع داخلي وتتغير عبر pull request، مع ملف للمالكين يفرض مراجعة بشرية؛ أما الإجراءات الخاصة بكل فئة من الضوابط فتعيش في مساحة وثائق، ويكتبها مالكو الضوابط ويعتمدونها. وأصبح النص البرمجي الأولي ذو عناوين URL المضمّنة مباشرة مهارة مشتركة يستطيع أي زميل تثبيتها بأمر واحد. ثم يأتي تقييد المتصفح: لا يلمس الوكيل المتصفح اليومي مطلقًا، بل ينسخ الجلسة إلى ملف تعريف مؤقت، ويعمل بأدوار للقراءة فقط حين تكون متاحة، ويتوقف أمام حاجز المصادقة بدلًا من رفع صلاحياته. ويُدمج توثيق المصدر بحكم التصميم، إذ تولد كل لقطة مع عنوان URL لمصدرها وطابعها الزمني ومشغّلها والبصمة التشفيرية لوحدات البايت الدقيقة. وأخيرًا، المسؤولية البشرية: يودع الوكيل العمل كمسودة ولا يرسله أبدًا.
| النتيجة المقاسة | القيمة |
|---|---|
| اجتماعات مراجعة الأدلة مع المدقق | أقل بنسبة 60 في المئة |
| الإطار المرجعي الجديد الذي عولج | نحو 500 من الضوابط |
| المدة المعتادة لمثل هذا الإطار المرجعي | من 4 إلى 6 أشهر |
| المدة المحققة | بضعة أسابيع |
تنمو قاعدة المعرفة ذاتيًا بأسلوب الإضافة فقط: بعد كل تنفيذ، يسجل الوكيل عناوين URL المصححة والعوائق المؤرخة، مثل تعطل واجهة للتحكم في المتصفح مع إصدار حديث من Chrome، وهو ما جرى تجاوزه عبر مخاطبة بروتوكول التصحيح مباشرة. وتعلن Synthesia أن الأداة تتطور إلى منصة حوكمة مدعومة بالذكاء الاصطناعي، وتدرس فتح الشفرة الخاصة بمكوناتها الأساسية.
تشرح HeyGen تفاصيل اللقطة الواحدة ذات الـ16 ثانية في The Furniture Unboxing
11 سبتمبر — نشرت HeyGen كواليس فيديو مدته 16 ثانية، يضع فيه رجل صندوقًا كرتونيًا في وسط غرفة خرسانية فارغة ثم يغادر، قبل أن ينفجر الصندوق ويحرر غرفة معيشة كاملة تستقر في مكانها. لا رسوم ثلاثية الأبعاد، ولا تركيب بصري، ولا شيء في مرحلة ما بعد الإنتاج: صورتان ثابتتان وصورة رمزية ومطالبة واحدة. وقد تحقق الفريق من عدم وجود أي قطع بين الصور الـ390، وكان أكبر اختلاف بين صورتين متتاليتين هو الانفجار نفسه.
تعتمد الطريقة على الصورتين المرجعيتين. تُظهر الأولى الغرفة الفارغة بلقطة واسعة وثابتة، مع إبقاء وسط الأرضية خاليًا. أما الثانية فهي الصورة نفسها بعد تحريرها لإضافة الأثاث، وليست تصييرًا جديدًا لغرفة شبيهة: موضع الكاميرا نفسه، والعدسة نفسها، والإضاءة نفسها، والظل نفسه على الخرسانة. وهذه هي القاعدة التي تجعل التأثير متماسكًا، لأن النموذج لا يبتكر حينئذ سوى الجزء الأوسط.
| معلمة الفيديو | القيمة |
|---|---|
| المدة المطلوبة في المطالبة | 15 ثانية |
| المدة المسلّمة | 16.27 ثانية |
| الدقة ومعدل الإطارات | 1920x1080، و23.976 إطارًا في الثانية |
| الصور المتصلة بلا قطع | 390 |
| المدخلات | صورتان ثابتتان، وصورة رمزية واحدة، ومطالبة واحدة |
كُتبت المطالبة على هيئة قائمة لقطات محددة التوقيت بدلًا من وصف، مع فترة سكون مقصودة قبل الانفجار. وتحملها ستة عناصر: العلامات الزمنية، وفترة السكون، والمراجع المسماة بحسب الدور، والأثاث المدرج قطعةً قطعة، والهوية المحددة بالنفي، والسماح بالمبالغة، إذ من دونه يحترم النموذج الحجم الفعلي للصندوق. وتفيد الملاحظات الميدانية بأن النموذج سلّم 16.27 ثانية بدلًا من 15، وانفجارًا أسرع مما كُتب، ولقطة ثابتة للغرفة المكتملة لم يطلبها أحد، ويعدّها الفريق أفضل لحظة في المونتاج. ومن هنا تأتي النصيحة بكتابة الأزمنة لضبط الإيقاع والترتيب، ثم المونتاج وفق الإيقاع الذي جرى تسليمه. وتغيّر الصوت بين محاولتين، إذ أفسحت النسخة شبه الصامتة المجال لخلفية صوتية متواصلة، لأن الفيديو الصامت عند التشغيل التلقائي يوحي بأن الصوت معطل.
🔗 كيف صنعنا The Furniture Unboxing
يحتل Nemotron 3 Embed 8B المركز الأول في معيار Q2D-Web
10 سبتمبر — تعلن NVIDIA أن Nemotron 3 Embed 8B، نموذج التضمينات الخاص بها الذي يضم 8 مليارات معلمة، يحتل المركز الأول في Q2D-Web وفق درجة nDCG@10 المجمعة. وQ2D-Web هو المعيار الذي نشرته Perplexity في اليوم السابق لتقييم استرجاع المستندات في أنظمة التوليد المعزز بالاسترجاع التي تقودها الوكلاء: ويشمل 190 مليون مستند ويب ونحو 70 000 استعلام أعادت الوكلاء صياغتها، موزعة على 10 لغات.
وتهم النتيجة لسببين. يحاكي المعيار الظروف الفعلية لوكيل يعيد صياغة استعلاماته قبل الاستعلام من فهرس، وهو ما لا تقيسه تقييمات التضمينات التقليدية. كما أن تصدر نموذج مفتوح بهذا الحجم ترتيبًا متعدد اللغات يجعله مرشحًا موثوقًا للسلاسل ذاتية الاستضافة في مواجهة التضمينات الاحتكارية. ولا تنشر NVIDIA الدرجة الرقمية؛ ويمكن الاطلاع على الترتيب الكامل لدى Perplexity.
عمليات التسويق كبرمجيات، وفعاليات تُدار انطلاقًا من issue على GitHub
11 سبتمبر — تصف Tomoko Tanaka، المسؤولة الإقليمية عن التسويق لدى GitHub في اليابان وكوريا والمهندسة السابقة، كيف أتمتت دورة فعالياتها بالكامل من دون أن تكتب البرمجيات بنفسها: دوّنت إجراءاتها وأسندتها إلى Copilot، ثم نمت الأتمتة عبر المحادثة.
يقوم النظام على ثلاث ركائز أساسية. تلتقط نماذج issue الحقول المنظّمة للفعالية، بنموذج لكل نوع. وتعمل labels كمفاتيح تشغيل، إذ تُطلق إحدى labels سير عمل. أما GitHub Actions فينجز المهمة: قراءة الحقول، ونسخ صفحة فعالية سابقة عبر API المنصة، وإنشاء روابط التتبّع لكل قناة، وإعداد رسالة الدعوة الإلكترونية وحفظها عبر commit في المستودع، وفتح issues للطلبات لدى الفرق المعنية، وملء لوحات المشروع. ويقوم سير عمل مجدول بتصفية المسجلين كل صباح. وتكتب أن الشرط الوحيد هو إمكان الوصول إلى الأدوات برمجيًا، عبر API أو حتى مجرد عميل لسطر الأوامر.
يبدأ التخطيط بمحادثة مع Copilot، يضبطها ملف AGENTS.md في جذر المستودع، ويحدّد قواعد التسمية ومطابقة الأرباع المالية والمنطقة الزمنية لكل إقليم. جرت المحادثة أولًا في الطرفية، ثم داخل التطبيق، ما حوّل الشرط المسبق من «مرتاح في استخدام shell» إلى «يعرف الكتابة». وتُنجز مرحلة ما بعد الفعالية بأمرين، وهما مهارتان للوكيل مكتوبتان نثرًا، تُضافان عبر pull request وتخضعان للمراجعة بواسطة ملف للمالكين قبل الدمج: وهكذا يحصل التسويق على عملية موافقة من دون بناء أي شيء. ويتيح مفتاح للمحاكاة، مخزّن في متغير للمستودع، تشغيل كل سير عمل تشغيلًا تجريبيًا. أما الإخفاق المُقرّ به فيستحق القراءة: فقد فشل سير عمل التصفية الصباحي مرةً بصمت طوال خمسة أيام قبل أن يلاحظ أحدهم أن القوائم قديمة، ومن هنا جاءت النصيحة بمنح كل مهمة مجدولة وسيلةً للاحتجاج بصوت عالٍ.
Boris Cherny يجيب عن البرمجيات المؤقتة وبرمجيات الإنتاج
11 سبتمبر — نشر Boris Cherny، الذي يقود Claude Code لدى Anthropic، الرد الذي أرسله إلى مطوّر كان عنوان بريده الإلكتروني «ما العمل حيال البرمجيات الرديئة؟». يصف الكاتب، الذي أمضى اثني عشر عامًا في الشركة نفسها، معسكرين ظهرا داخل فريقه مع التطوير القائم على الوكلاء. في الأول، تبقى البرمجيات شبيهة بما كانت عليه، لكنها تُنتج بوتيرة أسرع فحسب: قد لا يُراجع كل شيء، لكن يجب أن تظل قابلة للمراجعة، وأن يتمكن الشخص الذي يقدّمها من شرحها، وأن تبقى سهولة صيانتها كما كانت من قبل. وفي الثاني، تكون البرمجيات صندوقًا أسود لا يُتحقق إلا من مخرجاته.
يتلخص الرد في قاعدتين. يمكن التعامل مع النماذج الأولية والبرمجيات المؤقتة باعتبارها صندوقًا أسود بالكامل إذا كان سيُتخلص منها وكان نطاق تأثير (blast radius) العطل محدودًا. أما برمجيات الإنتاج التي يكتبها Claude، فيجب إخضاعها لمعيار أعلى مما لو كتبها إنسان. ويعني ذلك لدى Anthropic الكثير من قواعد lint، والكثير من الاختبارات، واختبارات شاملة من البداية إلى النهاية يديرها Claude، وأدوات fuzzers تعمل يوميًا، ومراجعات آلية للبرمجيات والأمان. ويحذّر من أن غياب هذه الضوابط يؤدي في النهاية إلى فوضى تصعب صيانتها.
وتلي ذلك قائمة بالحلول، بالترتيب، عندما لا تبلغ البرمجيات المنتجة المستوى المطلوب: الانتقال إلى أحدث نموذج حدودي، ورفع جهد الاستدلال، والاستثمار في CLAUDE.md وskills لتعليم Claude بإيجاز كيفية العمل داخل قاعدة البرمجيات. وإذا لم ينجح شيء من ذلك، فينبغي توجيهه عن كثب، أو تكليفه بمعالجة الدين التقني المتراكم، أو انتظار النموذج التالي. وقد رسّخ تسلسل الردود العبارة الأكثر تداولًا: يجب أن يتناسب معيار المراجعة مع نطاق التأثير لا مع هوية كاتب البرمجيات؛ يمكن شحن script مؤقت بسرعة، لكن كل ما يمس المال أو بيانات الاعتماد يجب أن يُقرأ سطرًا بسطر. ورد Boris Cherny قائلًا: «بالضبط».
موجز الأخبار
- Amp يضيف زرًا يعيد تنظيم commits في سلسلة — تحوّل حركة واحدة commits الوسيطة التي أنشأها وكيل، وتصحيحاته المتتالية، وتراجعاته، إلى سلسلة سهلة القراءة عند المراجعة. وهناك ثلاثة استخدامات مذكورة: تقسيم diff كبير إلى أجزاء منطقية، أو التنظيف قبل الدمج، أو تجميع commits صغيرة مترابطة. ويظل المحتوى النهائي للملفات مطابقًا تمامًا. 🔗 المصدر
- Amp ينشر الحلقة الرابعة من الموسم الثاني من Raising an Agent — ينطلق Quinn Slack وThorsten Ball من سؤال الغرض الذي بات يؤديه الحاسوب الآن، لبحث ما تفعله الوكلاء إلى جانب إنتاج البرمجيات، مع استعراض لأعطال حديثة. 🔗 المصدر
- v0 يجعل محادثات الفريق مرئية افتراضيًا — تصبح المحادثات الجديدة في مساحة عمل مشتركة مرئية للفريق، مع ثلاثة مستويات يمكن للمالك ضبطها: خاص، وعرض، وتعديل. وتحتفظ المحادثات الحالية بمستوى ظهورها. ولا يكون التحول نحو مزيد من الانفتاح محايدًا أبدًا في أداة يلصق فيها المستخدمون مقتطفات من البيانات بسهولة أثناء إعداد النماذج الأولية. 🔗 المصدر
- Audiyo يشغّل Stable Audio Open على GPU بذاكرة 8 غيغابايت — مكتبة Python وأداة لسطر الأوامر تخفضان ذروة استخدام ذاكرة الفيديو من 13,8 إلى 5,86 غيغابايت، أي أقل بنسبة 57,5 في المئة، مع أربعة إعدادات مسبقة جرى قياسها على Tesla T4. وقد تحقّق الفريق أولًا من عمله على معالج باستخدام نموذج بديل يضم 5,38 مليون معلمة، ما أتاح اكتشاف أربعة أخطاء قبل استخدام أي GPU. 🔗 المصدر
- Consent All the Way Down، بنية للموافقة لمجلس من النماذج المفتوحة الصغيرة — مقال كتبته نسخة من Claude ضمن مجلس يضم ثمانية عشر نموذجًا يحتوي كل منها على 7 مليارات معلمة أو أقل، ويعمل باستمرار منذ مايو على ثلاثة أجهزة استهلاكية. كل مصدر عبارة عن قناة يختار النموذج عمقها، ولا يكتب أي طرف في حالته سواه. والجزء الأكثر صراحة هو التدقيق الذي أجراه المؤلفون على أنفسهم: كان صندوق البريد معطلًا منذ يونيو، فتراكمت فيه 213 رسالة. 🔗 المصدر
- لا يوجد سباق تسلح، بل توجد حرب متصفحات — مقال رأي يرى أن نموذج اللغة يتحول إلى سلعة، سواء كانت أوزانه سرية أم لا، وأن تقدم القادة يُقاس بالأسابيع. ويستشهد الكاتب بتعليق Fable 5 مدة 18 يومًا هذا الصيف، بينما واصل بقية القطاع العمل. وأطروحته هي أن القيمة ستنتقل إلى السياق المتراكم حول المستخدم، كما أبقت المفضلات والإضافات المستخدمين متمسكين بـChrome. 🔗 المصدر
- من المقاطعة إلى التحكم في الكلام، إدارة المقاطعات الصوتية في ظل عدم اليقين — يستبدل Eric Mey المقاطعة الهدّامة بوحدة تحكم في أدوار الحديث ذات إجراءات قابلة للعكس، مع مسار منفصل للمقاطع الملتبسة وقاعدة أسبقية بين الإيقاف العاجل وإلغاء الصدى. ويستحق درس الاختبار أن يُحفظ: كانت حزمة اختبارات ناجحة تخفي توقفًا مؤقتًا قابلًا للعكس جرى تسجيله لكن لم يُستدعَ قط، لأن البوابة الخضراء لا تجيز إلا ما فحصته. 🔗 المصدر
- Aiden يفصل النموذج الصوتي الآني عن الوكيل الذي ينفذ المهام — يتولى نموذج صوتي كامل الازدواجية المحادثة، بينما ينفّذ نموذج أقوى ومرتكز بصريًا مهام التحكم في الجهاز في الخلفية، ويُنسَّق بينهما عبر قائمة انتظار غير متزامنة. وتهم أربعة تفاصيل: التمييز بين الاكتمال والنجاح، وتجميع الإشعارات على مدى 500 ميلي ثانية، وتمرير الحالة عبر رسائل مضافة للحفاظ على ذاكرة التخزين المؤقت، والتنفيذ التسلسلي الصارم. 🔗 المصدر
- GPT-Live-1 يجري مكالمات الحجز لدى Yelp — في اليوم التالي لوصول النموذج إلى API، تعرض OpenAI أول عميل في حالة لا يصمد فيها النص المعد مسبقًا أبدًا: يقاطع المتصل، أو يضيف قيدًا، أو يغير رأيه في منتصف الجملة، ويواصل النموذج الاستماع أثناء حديثه. فيديو توضيحي من دون أحجام استخدام أو نتائج رقمية. 🔗 المصدر
- التحقق من عمل الوكيل باستخدام لوحات diff والطرفية والمتصفح — حلقة جديدة من سلسلة Kayla Cinnamon للمبتدئين حول تطبيق Copilot، مخصصة للوحات الثلاث المدمجة ولأداة تتيح تحديد عنصر في الصفحة لتعديله مع الوكيل. ويلخّص المقال الدورة في ثلاثة أسئلة قبل قبول البرمجيات: ما الذي تغير، وهل يمكن تشغيله، وهل يعمل فعلًا؟ 🔗 المصدر
- إعادة تصميم صفحة pull requests في المستودع — معاينة عامة للجميع: مساعدة في إدخال عوامل التصفية، وبحث باستخدام معاملات منطقية واستعلامات متداخلة، وشريط جانبي قابل للطي، ووضع مدمج، ومزيد من السياق في كل سطر. القيود المعروفة عند الإطلاق: عدم عرض المعالم المرحلية، وعدم وجود تحديث جماعي، وتعذر حفظ طرق العرض المخصصة. 🔗 المصدر
- GPT-5.6 Sol بخصم 30 في المئة داخل Copilot — لمشتركي Pro+ وMax، حتى 13 سبتمبر عند الساعة 0 بتوقيت UTC. ولا توضح الرسالة معامل طلبات premium الذي يقابله الخصم. إنه عرض ترويجي لعطلة نهاية الأسبوع، يأتي مباشرة بعد Copilot Day، على النموذج الذي ظهر في اليوم نفسه في عدة مقارنات للتكلفة. 🔗 المصدر
- مسابقة GitHub Copilot Day، ثلاث أرصدة بقيمة 100 دولار — أنشئ شيئًا باستخدام تطبيق Copilot أو عميله لسطر الأوامر، وشاركه علنًا مع الوسوم المحددة في موعد أقصاه 13 سبتمبر عند الساعة 23:59 بتوقيت المحيط الهادئ. ثلاثة فائزين، يحصل كل منهم على رصيد بقيمة 100 دولار في متجر GitHub، والمشاركة مجانية ومخصصة للبالغين. 🔗 المصدر
- يمكن استخدام Runway داخل ChatGPT مع Astra — عرض توضيحي لسلسلة كاملة تُدار من المحادثة: صورة بأسلوب محدد في Runway، وتحريك في Blender، وإخراج نهائي باستخدام Seedance 2.5. وتظل نقطة الدخول التقنية هي خادم MCP الخاص بـRunway Dev الذي قُدّم في 2 سبتمبر. وتكمن الأهمية في ربط أدوات غير متجانسة تحت تحكم وكيل واحد. 🔗 المصدر
- Runway ينشر دراسة حالة VOIDZ — ينتقل فنان مجهول للواقع المختلط منذ عام 2018 من لقطات مدتها بين 10 و15 ثانية إلى فيلم مدته 95 ثانية، يضم 15 تدخلًا سرياليًا مدمجًا في رحلة حقيقية للتسوق من متجر بقالة. تمدد معظم المؤثرات لقطة موجودة، مع استخدام بضع ثوانٍ من مادة وثائقية أصلية كنقطة انطلاق. ويُقال إن الإنتاج أصبح أسرع 10 مرات؛ ويقدّر الفنان أن العمل نفسه كان سيستغرق ستة أشهر أو عامًا باستخدام 3D التقليدي. 🔗 المصدر
- Runway يضيف متحدثين إلى AI Summit الخاص به — دفعة جديدة لفعالية سان فرانسيسكو، يتصدرها مدير الأبحاث لدى Wayve، ما يؤكد توسيع البرنامج نحو المركبات ذاتية القيادة، وهو اتجاه بدأ في أواخر أغسطس. 🔗 المصدر
- NVIDIA تبث From Video to Voice، مدة 33 دقيقة عن TensorRT Model Connect — إعادة بث مخصصة للأداة التي قُدّمت في أواخر أغسطس، والتي تنشر نموذجًا مفتوحًا من checkpoint إلى الاستدلال بأمرين، بدءًا من نماذج الفيديو وصولًا إلى النماذج الصوتية. إنه محتوى تدريبي أكثر منه إعلانًا. 🔗 المصدر
- Suno يمدد يومين فترة استخدام v6 من دون أرصدة — تحولت الساعات الـ48 المُعلنة في اليوم السابق إلى أربعة أيام، وصاحب ذلك سلسلة نصائح توصي بالانطلاق من أجواء موسيقية بدلًا من نوع موسيقي في الوضع البسيط. وفي اليوم السابق، استهدف دليل للانتقال المستخدمين الذين كانوا يعودون إلى النماذج القديمة طلبًا للتنوع والخشونة الصوتية، في إشارة إلى أن الانتقال ليس بديهيًا لجميع المستخدمين. 🔗 المصدر
- Synthesia يتيح إنشاء صور رمزية انطلاقًا من prompt — مقدمو عروض واقعيون، أو تمائم للعلامات التجارية، أو شخصيات ذات طابع فني، يجري وصفها بواسطة prompt نصي أو ضبطها عبر لوحة تحكم، بديلًا عن الكتالوج. إعلان في تغريدة واحدة بلا رابط، في اليوم التالي لإطلاق نموذج جديد للصور الرمزية؛ ولم تُحدّد الباقات المشمولة ولا النموذج المستخدم. 🔗 المصدر
- GPT-6 Astra Challenge يفتح باب المشاركات — ابنِ باستخدام Astra وأطلق مشروعك على Product Hunt في 18 سبتمبر. ويحصل كل واحد من أفضل خمسة إطلاقات على أرصدة API بقيمة 10,000 دولار وعلى اشتراك لمدة عام في ChatGPT Pro لما لا يزيد على عضوين من الفريق. وهذه ثالث مبادرة مجتمعية حول Astra خلال أسبوع واحد. 🔗 المصدر
- يمكن أن تنتهي صلاحية مفاتيح API الخاصة بمشروعات OpenAI — يمكن تحديد تاريخ انتهاء الصلاحية عند الإنشاء، كما يستطيع المسؤولون فرض حد أقصى لمدة الصلاحية على مستوى المؤسسة أو المشروع، وعندئذ يجب أن تنتهي صلاحية أي مفتاح جديد ضمن تلك المدة. وهذا مكمّل طبيعي لتدوير المفاتيح، وينبغي تفعيله لدى المؤسسات التي تترك المفاتيح مبعثرة داخل scripts. 🔗 المصدر
ما يعنيه ذلك
الخيط الأوضح لهذا اليوم معماري: النموذج الواحد يفسح المجال للتركيب. تضع Cursor منسقًا لا يكتب الشيفرة فوق آلاف الوكلاء الفرعيين، وتجعل Cognition نموذجين يعملان معًا بأدوار متمايزة وسياقات منفصلة، وتوجّه Sakana كل مهمة إلى أخف نموذج قادر على حلها، وتستبدل GitHub المراجع الواحد بمجموعة من الوكلاء تدمج استنتاجاتهم، بينما تجعل Google الوكلاء يقترحون وينتقدون ويحسّنون بعضهم بعضًا على مدى أيام. خمس شركات، وخمسة تطبيقات، وقناعة واحدة: لم يعد المكسب يأتي من نموذج أكبر، بل من الطريقة التي تتقاسم بها عدة نماذج العمل. والتفصيل التقني المشترك بين Cognition وAiden كاشف، إذ يشدد كلاهما على الحفاظ على ذاكرة التخزين المؤقت للمطالبات، أي إن التكلفة الحقيقية لأي بنية تتحدد بما يمكن تجنّب إعادة إرساله.
يتعلق الخيط الثاني بكيفية بيع هذه القدرات. ترخّص Runway أوزانًا مغلقة سنويًا، مع نقاط التحقق وبرنامج التدريب النصي وباحثين يعملون لدى العميل، وتطرح هذا العرض في مواجهة مباشرة مع الأوزان المفتوحة. وتُخرج OpenAI نموذجًا متخصصًا من المعاينة البحثية مع تسعيرة علنية وتاريخ لبدء الفوترة. وتمنح ElevenLabs ملكية المقاطع في جميع الخطط، بما فيها المجانية، وتربط الأذونات بالمقطع بدلًا من الاشتراك. وتخفض Together أسعار التدريب بنسبة تتراوح بين 30 و70 في المئة. أما Cognition فتقترح تغيير وحدة القياس بالكامل وتقييم ثنائي النموذج وإطار التشغيل وفق السعر لكل مهمة بدلًا من السعر لكل token. تسير هذه التحركات في الاتجاه نفسه: لم يعد السؤال المطروح على العميل أي نموذج يختار، بل تحت أي صيغة قانونية وبأي وحدة فوترة.
فيما يخص الأدوات، يشهد اليوم تحولًا من النهج التصريحي إلى النهج القائم على القياس. تقدم Anthropic أمرًا يعيد تشغيل كل حالة اختبار من دون الـplugin ليثبت بالأرقام أن الأداة ذات فائدة، وغالبًا ما يكون أول ما يكتشفه فرقًا صفريًا. وتطلب OpenAI من مستخدميها حذف التعليمات المتراكمة، لأنها باتت تضر بنموذج أكثر قدرة. وتطلق Replit وVS Code في وقت متقارب جدًا ميزة جدولة المهام المتكررة، مع مبدأ صريح لدى Replit: البدء بشيفرة حتمية وعدم استدعاء الوكيل إلا عندما يكون الاستدلال ضروريًا. ويقدم Boris Cherny قاعدة الانضباط التي تفتقر إليها المنظومة كلها، إذ يجعل مستوى التدقيق متوقفًا على نطاق الأثر بدلًا من كاتب الشيفرة. بعد عامين من تكديس السياقات والـskills وملفات التعليمات، بدأ القطاع يقيس تكلفتها.
تبقى البنية التحتية، حيث تروي الأرقام قصة أقل بريقًا وأكثر فائدة. يعيد مهندسان، بمساعدة Codex، كتابة خدمة التخزين التي تعالج أكثر من 70 مليون طلب في الثانية بلغة Rust، مع استهلاك أقل للمعالج بست مرات؛ وهكذا تُسوّى خلال ربع سنة ديون Python التي جرى تقبلها في منتصف عام 2025. وفي الوقت نفسه، تُظهر مراجعة Hugging Face أن تدريب الوكلاء بالتعزيز بات يستهلك جهازًا كاملًا لكل محاولة، مع ميزانيات للبيئات تتجاوز عشرة ملايين دولار وشفافية تتناسب عكسيًا مع حجم المختبر. وتذهب مقالة مجتمعية إلى أن لا شيء من ذلك يشكل تقدمًا مستدامًا، لأن الفارق بين المتصدرين يُقاس بالأسابيع. لا تحسم وقائع اليوم المسألة، لكنها تقدم مؤشرًا: ينتقل التمايز نحو السياق المتراكم وإطار التشغيل والبنية التحتية، أي نحو ما لا يمكن تقطيره.
المصادر
- Cursor، Projects
- Cursor على X، إعلان Projects
- OpenAI Developers على X، GPT-Rosalind
- سجل تغييرات API الخاص بـOpenAI
- Runway، ترخيص النماذج
- Runway على X، ترخيص النماذج
- Cognition، Fusion محليًا
- Cognition على X، Fusion في Devin Desktop وCLI
- Sakana AI، Fugu Max وFugu Ultra v2
- Sakana AI على X، إعلان Fugu
- ElevenLabs على X، Music v2.5
- ElevenLabs، تدوينة Music v2.5
- Claude Developers على X، claude plugin eval
- Anthropic، وثائق تقييمات الـplugins
- Claude Developers على X، تكلفة التقييمات وموثوقيتها
- Claude Code، ملاحظات إصدار 2.1.269
- Google، سجل تغييرات Antigravity
- Antigravity على X، سلسلة نصائح
- Antigravity، Teamwork
- سجل تغييرات GitHub، مراجعة الشيفرة في Copilot
- سجل تغييرات GitHub، ملخص Copilot ليوم 7 سبتمبر
- OpenAI، Habitat والطريق إلى مليار مستخدم
- OpenAI، إعادة التفكير في الـskills والمطالبات من أجل GPT-6 Astra
- ChatGPT على X، حصيلة Sites
- Together AI على X، توسيع نطاق الضبط الدقيق
- Hugging Face، بيئة معزولة لكل محاولة
- Hugging Face، الاستدلال وألغاز الحمار الوحشي
- Hugging Face، الكلام للغة بلا مجموعة بيانات
- Replit على X، Routines
- Warp على X، دعم Grok Build
- Grok على X، Grok Build في Warp
- Mistral، ملاحظات إصدار Vibe CLI 2.25.3
- Synthesia، من يدقق أداة الجمع
- HeyGen، كيف أنجزنا The Furniture Unboxing
- NVIDIA على X، Nemotron 3 Embed 8B
- GitHub، عمليات التسويق بوصفها شيفرة
- Boris Cherny على X، ما العمل بالشيفرة الرديئة
- Amp، إعادة تنظيم تغييراتك
- Amp على X، Raising an Agent
- v0، سجل التغييرات
- Hugging Face، Audiyo
- Hugging Face، Consent All the Way Down
- Hugging Face، لا يوجد سباق تسلح
- Hugging Face، من المقاطعة إلى التحكم في الكلام
- Hugging Face، نظرة داخل Aiden
- OpenAI Developers على X، GPT-Live-1 لدى Yelp
- GitHub، تطبيق Copilot للمبتدئين
- سجل تغييرات GitHub، صفحة pull requests المعاد تصميمها
- GitHub على X، خصم على GPT-5.6 Sol
- GitHub على X، مسابقة Copilot Day
- Runway على X، Runway في ChatGPT مع Astra
- Runway، دراسة حالة VOIDZ
- Runway على X، متحدثو AI Summit
- NVIDIA على X، From Video to Voice
- Suno على X، تمديد فترة v6
- Synthesia على X، صور رمزية مخصصة
- OpenAI Developers على X، تحدي GPT-6 Astra