ai-powered-markdown-translatorمقال مترجم من الفرنسية إلى العربية باستخدام gpt-6.1-sol.
يصل GPT-6 وIntelligent UI إلى جميع مستخدمي ChatGPT: GPT-6 Sol للاشتراكات المدفوعة بدءًا من 7 أكتوبر، وGPT-6 Luna لاشتراكي Free وGo بدءًا من 8 أكتوبر. وتستكمل Anthropic عائلتها 5.5 بإطلاق Claude Haiku 5.5، بسعر يبدأ من 0,10 دولار لكل مليون tokens في الإدخال، بينما يفتح حدث Windows الذي تنظمه Microsoft باب الطلب المسبق على حواسيب RTX Spark ويعلن أن GitHub Copilot سيتمكن قريبًا من إسناد مهامه إلى نموذج محلي. وتنشر OpenAI أيضًا 722 مخطوطة لنتائج رياضية أنتجها نموذج داخلي.
ChatGPT ينتقل إلى GPT-6 وIntelligent UI للجميع، ويقرأ الملفات الصوتية ويستعد لإطلاق College Planner
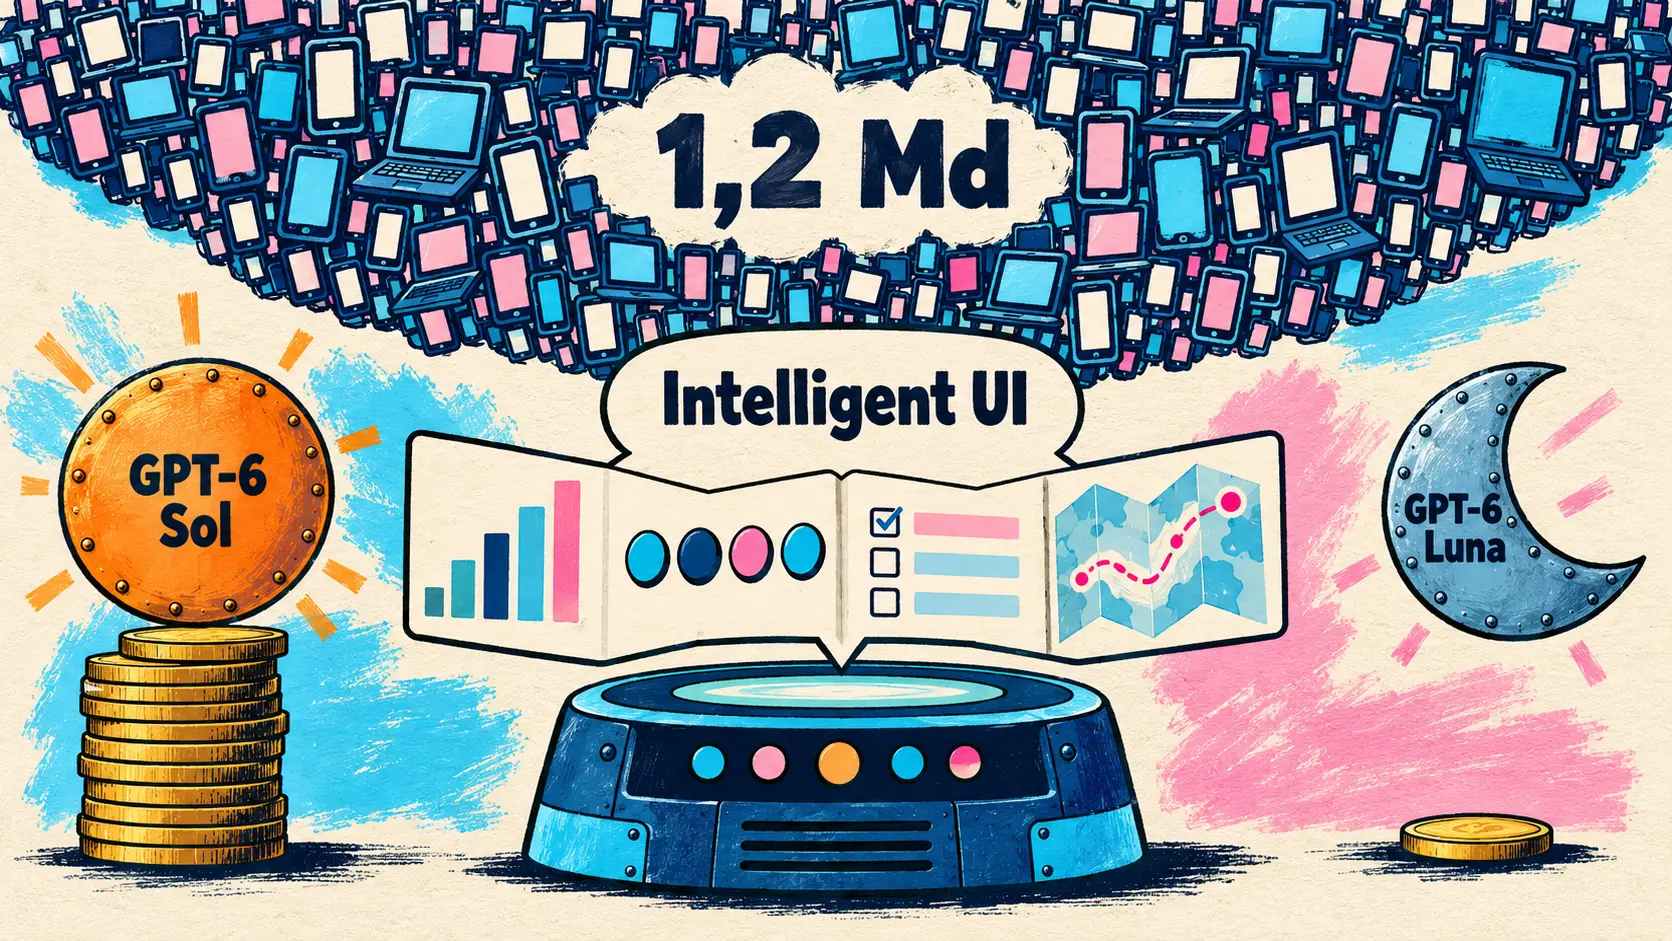
7 أكتوبر — توسّع OpenAI إتاحة GPT-6 لتشمل جميع مستخدمي ChatGPT. لا يتعلق الأمر بنموذج أساسي جديد: فقد كان GPT-6 Sol وGPT-6 Luna متاحين بالفعل للعملاء المشتركين في الخطط المدفوعة منذ سبتمبر (وتناولناهما هنا في 22 سبتمبر). وهذه المرة، تصل إصدارات أكتوبر من هذين النموذجين، المضبوطة للمحادثات اليومية، إلى علامة التبويب Chat: GPT-6 Sol لاشتراكات Plus وPro وBusiness وEnterprise بدءًا من 7 أكتوبر، وGPT-6 Luna لاشتراكي Free وGo بدءًا من 8 أكتوبر. وتحل هذه الإصدارات محل GPT-5.6 Sol وGPT-5.6 Luna في ChatGPT، بينما يظل Codex وChatGPT Work على إصدارات سبتمبر. وتقول OpenAI إنها تخاطب بذلك أكثر من 1,2 مليار شخص يستخدمون ChatGPT كل أسبوع.
أبرز المستجدات هو Intelligent UI. يؤلف GPT-6 إجاباته من النصوص والعناصر المرئية والعناصر التفاعلية (الرسوم البيانية والأزرار والنماذج والمخططات التفاعلية والخرائط)، ويمكنه إنشاء أداة صغيرة عند الطلب، مثل حاسبة للادخار أو أداة لتقسيم الفاتورة أو لعبة؛ وعندما يكفي نص بسيط، يكتفي ChatGPT به. وتعتمد OpenAI في ذلك على مكتبة من المكونات الأصلية وعلى مترجم يعرض الواجهة أثناء توليدها. ويعمل Intelligent UI من مستوى الجهد Instant إلى Extra High، من دون حصة استخدام منفصلة، لكنه لا يعمل مع مستوى الجهد Pro، الذي يتولاه GPT-6 Pro (المشغّل بواسطة GPT-6 Astra)، ولا في تطبيقات سطح المكتب القديمة لنظامي macOS وWindows.
التغيير الثاني: يستطيع ChatGPT البدء بالإجابة أثناء التفكير أو استخدام الأدوات، ثم استكمال إجابته من دون prompt جديد. وبحسب تقييمات داخلية أجرتها OpenAI، يبدأ GPT-6 Instant الإجابة في وقت أبكر بنسبة 44 % في المتوسط مقارنةً بـGPT-5.6 Instant عند التعامل مع الأسئلة التي تتطلب بحثًا على الويب، ويبدأ GPT-6 Extra High خلال المدة نفسها التي يستغرقها GPT-5.6 Medium، مع نتيجة إجمالية أفضل من GPT-5.6 Extra High.
| الاشتراك أو إعداد مستوى الجهد | النموذج المستخدم في ChatGPT | الموعد والتفاصيل |
|---|---|---|
| Plus وPro وBusiness وEnterprise | GPT-6 Sol (Instant, Medium, High, Extra High) | الإتاحة عالميًا بدءًا من 7 أكتوبر |
| Free وGo | GPT-6 Luna | بدءًا من 8 أكتوبر |
| مستوى الجهد Pro (اشتراكا Pro بسعر 100 و200 دولار، وBusiness وEnterprise) | GPT-6 Pro، المشغّل بواسطة GPT-6 Astra | من دون Intelligent UI |
| ChatGPT Work وCodex | إصدارات سبتمبر من GPT-6 Sol وGPT-6 Luna | لا تغيير |
في جانب السلامة، تصنّف بطاقة النظام المنشورة في اليوم نفسه هذه الإصدارات ضمن مستوى القدرة «High» في الأمن السيبراني وكذلك في الأحياء والكيمياء وفق Preparedness Framework، من دون بلوغ هذا المستوى في التحسين الذاتي؛ وتتبنى هذه الإصدارات ضوابط الحماية الخاصة بـGPT-5.6، مع مقاومة أفضل لمحاولات تجاوز القيود (jailbreaks)، بما فيها المحاولات الممتدة عبر عدة جولات من المحادثة. وفي API، تشير اللقطة chat-latest الآن إلى نموذج ChatGPT الجديد هذا، وتوصي OpenAI بعائلة GPT-6 للاستخدام في بيئات الإنتاج.
GPT-6 and Intelligent UI, now rolling out in ChatGPT for everyone. Intelligent UI in ChatGPT delivers fast, interactive answers that make everyday questions more visual, complex topics easier to grasp, and interactive tools for your task available on the spot.
🇸🇦 يجري الآن إتاحة GPT-6 وIntelligent UI في ChatGPT للجميع. وفي ChatGPT، يقدم Intelligent UI إجابات سريعة وتفاعلية تجعل الأسئلة اليومية أكثر وضوحًا بصريًا، والموضوعات المعقدة أسهل فهمًا، وتوفر فورًا أدوات تفاعلية ملائمة لمهمتك. — @OpenAI على X
🔗 GPT-6 وIntelligent UI للجميع · بطاقة النظام، تحديث أكتوبر · GPT-6 والنماذج الأخرى في ChatGPT
الملفات الصوتية في ChatGPT
6 أكتوبر — يقبل ChatGPT الآن الملفات الصوتية كمرفقات. ويمكن إرفاق تسجيل بمحادثة للحصول على تفريغ نصي أو ملخص أو إجابات عن محتواه، أو لتحويل اجتماع أو مقابلة أو درس إلى ملاحظات منظمة، وحتى إلى مسودة رسالة بريد إلكتروني للمتابعة. وتقتصر هذه الميزة على الاشتراكات ومساحات العمل المدفوعة، بما فيها Enterprise: فلا يتاح الوصول إليها عبر اشتراك Free «في الوقت الحالي». والصيغ المقبولة هي WAV وMP3 وOGG وFLAC وAAC وM4A وPCM، وكذلك WebM وMP4 إذا كان محتواهما صوتيًا فقط، بحد أقصى 512 Mo لكل ملف. وتنبه OpenAI إلى أن التفريغ النصي قد يحتوي على أخطاء، وأن تحديد المتحدثين لا يزال غير موثوق بما يكفي، وأن الأداء يختلف باختلاف اللغات.
🔗 ملاحظات إصدار ChatGPT · رفع الملفات والصوت إلى ChatGPT
ChatGPT for Teens: أول أرقام الاستخدام وCollege Planner قادم
7 أكتوبر — تقدم OpenAI أول حصيلة مرحلية عن ChatGPT for Teens، وهي التجربة المطبقة افتراضيًا على الحسابات التي حُدّد أن أصحابها دون 18 عامًا. وبحسب الشركة، استخدم نحو 1,2 مليون مراهق Learning Visualizations خلال أسبوع، واستخدم أكثر من 180 000 مراهق Study Mode؛ ويقضون فيها أقل من 15 دقيقة يوميًا في المتوسط، ولا تتجاوز نسبة من يستخدمونها لأكثر من ثلاث ساعات متواصلة 2 %. أما الميزة الجديدة المعلنة، College Planner، فستصل «قريبًا»، أولًا في الولايات المتحدة لطلاب المرحلة الثانوية من الصف 10 إلى الصف 12 الذين يستهدفون الدراسة في جامعة تقدم برامج مدتها أربع سنوات: وستجمع خطة واحدة متطلبات التقديم والمواعيد النهائية والمهام وإجراءات المساعدات المالية، بما فيها المنح الدراسية. وتدعم OpenAI أيضًا College Advising Corps، وكذلك Digital Wellness Lab في Boston Children’s Hospital لمدة ثلاث سنوات، من دون الإفصاح عن المبلغ.
🔗 مساعدة المراهقين على التعلم والتخطيط وصياغة مستقبل الذكاء الاصطناعي
Claude Haiku 5.5 أقل تكلفة بنحو 75 % من Haiku 4.5 بحسب Anthropic
7 أكتوبر — بعد خمسة عشر يومًا من إطلاق Opus 5.5 وتسعة أيام من إطلاق Sonnet 5.5، تستكمل Anthropic عائلة Claude 5.5 بإطلاق Claude Haiku 5.5 (claude-haiku-5-5). ويستهدف النموذج المهام ذات الحجم الكبير والحساسة للتكلفة (التلخيص وضغط السياق واستعلامات قواعد البيانات والتصنيف)، ودور الوكيل الفرعي لـOpus 5.5 وSonnet 5.5 في البرمجة، والاستخدامات التي تهم فيها السرعة، مثل دعم العملاء المباشر أو التحكم في متصفح: فهو أسرع نماذج Anthropic عند السرعة القياسية، بينما تظل نماذج Opus في Fast Mode أسرع. وهو أيضًا أول نموذج Haiku مزود بإعداد لمستوى الجهد (medium افتراضيًا)، مع سياق يبلغ 1 مليون tokens ومخرجات تصل إلى 128 000 tokens.
يعتمد التسعير على شريحتين. حتى 100 000 tokens في prompt، تبلغ تكلفة Haiku 5.5 0,10 دولار لكل مليون tokens في الإدخال و0,50 دولار في الإخراج، أي أقل بنسبة 90 % من Haiku 4.5؛ وبعد هذا الحد، ترتفع إلى 0,50 و2,50 دولار، أي أقل بنسبة 50 %. أما التوفير «بنحو 75 %» الذي تبرزه الشركة فهو متوسط حسبته Anthropic: فقد كانت 90 % من الطلبات المرسلة إلى Haiku 4.5 دون هذا الحد، كما أن آلية التقسيم الجديدة إلى tokens (tokenizer) تحتسب نحو 30 % من tokens الإضافية للنص نفسه.
| نوع السعر (لكل مليون tokens) | Haiku 5.5 حتى 100 000 tokens في prompt | Haiku 5.5 بعد 100 000 tokens | Haiku 4.5 |
|---|---|---|---|
| tokens الإدخال | 0,10 دولار | 0,50 دولار | 1 دولار |
| tokens الإخراج | 0,50 دولار | 2,50 دولار | 5 دولارات |
| قراءات ذاكرة التخزين المؤقت | 0,01 دولار | 0,05 دولار | 0,10 دولار |
| عمليات الكتابة في ذاكرة التخزين المؤقت | 0,125 دولار | 0,625 دولار | 1,25 دولار |
في الاختبارات المعيارية التي نشرتها Anthropic، يظهر فارق كبير مقارنةً بـHaiku 4.5، ويتفوق Haiku 5.5 على GPT-6 Luna من OpenAI في جميع الاختبارات التي يرد فيها النموذجان. لكنه يظل خلف Sonnet 5.5، الذي لا تزال Anthropic توصي به، إلى جانب Opus 5.5، لمهام البرمجة المعقدة باستخدام الوكلاء.
| الاختبار المعياري المُقيّم (أرقام Anthropic) | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| Terminal-Bench 4.0 (البرمجة باستخدام الوكلاء) | 39,2 % | 0,0 % | 16,4 % | 70,6 % |
| OSWorld 2.1، مجموعة فرعية دون اتصال بالإنترنت | 72,4 % | 15,7 % | 48,9 % | 83,9 % |
| Humanity’s Last Exam، من دون أدوات | 45,9 % | 10,2 % | — | 56,9 % |
| FrontierCode 1.1, Main | 46,4 % | — | 42,4 % | 52,1 % (مستوى الجهد Xhigh) |
| Chartography، من دون أدوات | 46,4 % | 6,4 % | 29,1 % | 61,6 % |
شارك ستة عملاء شهاداتهم عن تجاربهم المبكرة: تذكر HubSpot نتيجة 92,8 % على مجموعة اختبارات CRM لديها، وهي أفضل نتيجة حققتها حتى الآن، وتذكر AlphaSense نتيجة 0,84 مقابل 0,76 لـHaiku 4.5 على 400 طلب، وتشير Box إلى تحسن بمقدار 11 نقطة مع زمن استجابة أقل بنحو النصف. ويتطلب الانتقال من Haiku 4.5 بعض العمل: إذ يسرد الدليل أحد عشر تغييرًا، منها إلغاء budget_tokens، والمعلمات temperature وtop_p وtop_k، والتعبئة المسبقة، ويؤتمت الأمر /claude-api migrate في Claude Code جزءًا منها. وفي جانب السلامة، تصف Anthropic ضوابط حماية سيبرانية أكثر تقييدًا من تلك الموجودة في Haiku 4.5، لكنها أقل تقييدًا قليلًا من ضوابط نماذجها الحديثة الأخرى: يُسمح بمهام دفاعية أكثر مما يسمح به Sonnet 5.5، بينما تظل اختبارات الاختراق محظورة.
يترافق الإطلاق مع خفض للأسعار: تنخفض تكلفة قراءات ذاكرة التخزين المؤقت في Sonnet 5.5 من 0,20 إلى 0,10 دولار لكل مليون tokens بدءًا من 7 أكتوبر، مما يجعل النموذج أقل تكلفة بنحو 20 % في معظم المهام التي ينفذها الوكلاء، بحسب Anthropic. ويتوفر Haiku 5.5 الآن عبر API الخاصة بـClaude، وAmazon Web Services وGoogle Cloud وMicrosoft Azure، وكذلك في Claude Code.
Introducing Claude Haiku 5.5: the cheapest, fastest, and most capable small model we’ve ever released. On average, it costs around 75% less to run than Claude Haiku 4.5.
🇸🇦 نقدم Claude Haiku 5.5: النموذج الصغير الأقل تكلفة والأسرع والأفضل أداءً الذي أصدرناه على الإطلاق. وفي المتوسط، تقل تكلفة تشغيله بنحو 75 % عن Claude Haiku 4.5. — @claudeai على X
🔗 إعلان Claude Haiku 5.5 · دليل الانتقال إلى Haiku 5.5
Haiku 5.5 في Cursor: 48,4 % على CursorBench
7 أكتوبر — يتيح Cursor نموذج Claude Haiku 5.5 منذ يوم إطلاقه، ويمكن تفعيله من إعدادات النماذج. وبحسب Cursor، تبلغ تكلفته عُشر تكلفة Claude Haiku 4.5 في الطلبات القصيرة. وفي CursorBench، وهو التصنيف الذي ينشره Cursor على موقعه، يحتل Haiku 5.5 بمستوى الجهد Max المرتبة 10 بنسبة نجاح 48,4 % وتكلفة 1,12 دولار لكل مهمة، متقدمًا مباشرةً على Sonnet 5.5 بمستوى الجهد High، الذي أعاد Cursor حساب تكاليفه في 7 أكتوبر لمراعاة سعره الجديد، وكذلك على Opus 5 بمستوى الجهد Max. ومع ذلك، فهو يعمل أكثر: 325 934 tokens و163 خطوة لكل مهمة في المتوسط، مقابل 37 391 tokens و41 خطوة لـSonnet 5.5 بمستوى الجهد High.
| الإعداد الذي اختبره Cursor | المرتبة في التصنيف | نتيجة CursorBench | التكلفة لكل مهمة |
|---|---|---|---|
| Opus 5.5، مستوى الجهد Max | 1 | 57,8 % | 13,43 دولارًا |
| Haiku 5.5، مستوى الجهد Max | 10 | 48,4 % | 1,12 دولار |
| Sonnet 5.5، مستوى الجهد High | 11 | 47,8 % | 1,20 دولار |
| Opus 5، مستوى الجهد Max | 13 | 46,6 % | 11,95 دولارًا |
| Haiku 5.5، مستوى الجهد Low | 54 | 30,9 % | 0,08 دولار |
🔗 إعلان Cursor على X · تصنيف CursorBench
رصيد API شهري يتراوح بين 100 و500 دولار لخطتَي Max وTeam
7 أكتوبر — أُعلن في التدوينة نفسها التي تناولت Haiku 5.5 عن رصيد شهري يمكن استخدامه على Claude Platform لمشتركي Max وTeam، مع إتاحته تدريجيًا على مدار بضعة أيام. ويُستخدم لبناء الأدوات والتطبيقات والوكلاء الخاصة بالمستخدم عبر API؛ ووفقًا لـ @ClaudeDevs، يعمل مع جميع النماذج، بما فيها Haiku 5.5، سواء في شيفرة المستخدم الخاصة أو في أدوات الجهات الخارجية.
| الخطة المعنية | رصيد API الشهري |
|---|---|
| Max 5x | 100 دولار |
| Max 20x | 200 دولار |
| Team، مقعد Standard | 20 دولارًا لكل مقعد |
| Team، مقعد Premium | 100 دولار لكل مقعد |
| الحد الأقصى لفريق Team | 500 دولار في رصيد مشترك |
| Free وPro وEnterprise | غير مؤهلة |
في Team، تُجمع أرصدة المقاعد في رصيد مشترك: فثلاثة مقاعد Standard ومقعدان Premium تمنح، مثلًا، 260 دولارًا شهريًا. ويغطي الرصيد جميع نماذج API الخاصة بـ Claude، بما فيها API Message Batches، إضافة إلى Playground في Console وClaude Managed Agents وClaude Agent SDK. ولا يغطي الاستخدام التفاعلي لـ Claude Code (في الطرفية أو IDE أو تطبيق سطح المكتب أو الويب)، ولا الاستخدام الإضافي الذي يتجاوز حدود الخطة، ولا نماذج Claude المقدَّمة عبر Amazon Bedrock أو Google Cloud Vertex AI أو Microsoft Foundry، ولا يغيّر حدود استخدام Claude أو Claude Code أو Cowork.
للحصول عليه، يجب أن يكون الاشتراك في خطة مؤهلة نشطًا منذ سبعة أيام على الأقل، ثم ربط مؤسسة في Claude Console من إعدادات الفوترة في claude.ai، دون إضافة وسيلة دفع. ويمكن ربط مؤسسة واحدة فقط، ولا يمكن تغييرها إلا عبر الدعم. ويتجدد الرصيد مع كل دورة فوترة، ولا يُرحَّل إلى الدورة التالية، ويُستهلك قبل الأرصدة المشتراة؛ وعند نفاده، تتوقف الاستدعاءات حتى وصول الرصيد التالي، إلا إذا كانت المؤسسة قد اشترت أرصدة أو فعّلت إعادة الشحن التلقائي، ولا تُحمَّل أي رسوم على اشتراك Claude. وفي مايو، كانت Anthropic قد أعلنت عن رصيد شهري للاستخدام البرمجي بدءًا من 15 يونيو؛ وتوضح صفحة المساعدة أن الرصيد الجديد لا يطابق «أرصدة Agent SDK» تلك، التي تقول إنها غير متاحة.
🔗 صفحة المساعدة: أرصدة API الشهرية لخطتَي Max وTeam · إعلان @ClaudeDevs
الذكاء الاصطناعي المحلي على Windows: NVIDIA تفتح الطلبات المسبقة لأجهزة PC RTX Spark وتستعرض DGX Station for Windows لأول مرة
7 أكتوبر — تستغل NVIDIA وMicrosoft فعالية Windows AI and Surface، المقامة في سان فرانسيسكو والتي تتضمن حوارًا بين Jensen Huang وSatya Nadella، لإطلاق RTX Spark تجاريًا، وهي شريحة لأجهزة PC العاملة بنظام Windows أُعلن عنها في Build يوم 2 يونيو. وفُتحت الطلبات المسبقة للحواسيب المحمولة منذ 7 أكتوبر، على أن تتوفر في 16 أكتوبر؛ وستلحق بها أجهزة PC صغيرة في نوفمبر. وتُعدّ Acer وASUS وDell وHP وLenovo وMicrosoft وMSI وGigabyte أجهزة تعتمد عليها، وتعرض Microsoft جهاز Surface Laptop Ultra مبنيًا حول هذه الشريحة. ولا تذكر تدوينة NVIDIA أي سعر.
تجمع RTX Spark بين GPU Blackwell RTX وCPU Grace، مع اتصال بينهما بسرعة 600 Go/s، لتوفير بيتافلوب واحد من حسابات الذكاء الاصطناعي بصيغة FP4 وذاكرة موحدة تصل إلى 128 Go. وتبرز NVIDIA تشغيل النماذج الكبيرة محليًا، دون إرسال البيانات إلى السحابة أو وجود عدّاد للاستخدام، وباستخدام منظومة CUDA نفسها الموجودة على خوادمها. وتستهدف الشريحة أيضًا صناع المحتوى (NVFP4 وترميز AV1 و4:2:2 عبر العتاد) واللاعبين، مع تشغيل الألعاب بدقة 1440p وبأكثر من 100 إطار في الثانية بفضل DLSS 5.
وللشركات، تستعرض NVIDIA لأول مرة DGX Station for Windows، التي أُعلن عنها أيضًا في Build في يونيو، وتصفها بأنها أول حاسوب مكتبي فائق للذكاء الاصطناعي في منظومة Windows: ما يتيح تشغيل نماذج تضم نحو تريليون معلمة محليًا دون مغادرة Windows، مع بقاء أدوات Linux متاحة عبر WSL. ولا يوجد موعد أو سعر، بل مجرد تسجيل لتلقي إشعار عند توفرها. ومن جانبها، تتيح Microsoft للجميع Microsoft Execution Containers (MXC)، وهي البنية التحتية التي تُشغّل الوكلاء في الخلفية تحت تحكم Windows.
| العنصر المقارَن | RTX Spark | DGX Station for Windows |
|---|---|---|
| الشريحة | GPU Blackwell RTX (حتى 6 144 نواة) وCPU Grace (حتى 20 نواة) | الشريحة الفائقة GB300 Grace Blackwell Ultra Desktop |
| الذاكرة | حتى 128 Go، موحدة | 748 Go، متسقة |
| حسابات الذكاء الاصطناعي بصيغة FP4 | 1 بيتافلوب | حتى 20 بيتافلوب |
| التوفر المعلن | الحواسيب المحمولة متاحة للطلب المسبق، وتتوفر في 16 أكتوبر؛ وأجهزة PC الصغيرة في نوفمبر | عرض أولي، دون موعد أو سعر |
🔗 تدوينة NVIDIA حول فعالية Windows
التطوير محليًا على Windows: سيوجّه Copilot الطلبات إلى MAI Code 1.1 Flash، وبيئته المعزولة تصبح متاحة للجميع، وReplit يُعدّ تطبيقًا لسطح المكتب
7 أكتوبر — سيتمكن GitHub Copilot قريبًا من الاختيار تلقائيًا بين نموذج يعمل على جهاز المطور ونموذج في السحابة. ووفقًا لتدوينة Microsoft وGitHub المنشورة على مدونة Microsoft Command Line، ستتوفر آلية التوجيه هذه «بحلول نهاية الشهر»: فهي غير متاحة بعد. ويقدمها GitHub بوصفها الخطوة التالية في Project HydraFusion، أداة التنسيق التي توزّع المهام بالفعل بين عدة نماذج، ويبرز توفير أرصدة الذكاء الاصطناعي دون تحديد مقدار هذا التوفير.
من المقرر إتاحة طريقتين للاستخدام في Copilot CLI وتطبيق GitHub Copilot وVS Code. سيختار وضع Auto، في كل جولة، بين الاستدلال المحلي والاستدلال السحابي حسب سياق المهمة وحالة ذاكرة التخزين المؤقت؛ وسيتمكن المطور أيضًا من تحديد نموذج محلي بنفسه، سواء MAI Code 1.1 Flash عبر موفر Windows ML أو أي نموذج متاح عبر نقطة وصول محلية (endpoint) متوافقة مع API الخاصة بـ OpenAI. وتذكّر التدوينة بأن الاستدلال المحلي لا يجعل الجلسة تعمل دون اتصال.
يعمل العرض التجريبي على Surface Laptop Ultra مزود بـ RTX Spark. وتُشغّل Microsoft AI عليه نسخة محلية من MAI Code 1.1 Flash، وهو مزيج من الخبراء (mixture-of-experts) متخصص في الشيفرة، يضم 137 مليار معلمة، منها 6,8 مليارات نشطة. وبعد تكميمه إلى نحو 3,3 بت لكل وزن، يبلغ حجمه 53 Go، أي أقل بنسبة 80 % من النسخة السحابية، مع ذروة استهلاك للذاكرة تبلغ 75,5 Go عند سياق بحجم 256 000 tokens.
| معيار الأداء المقيَّم (اختبارات Microsoft بتاريخ 5 أكتوبر) | MAI Code 1.1 Flash | النسخة المكمَّمة على الجهاز | GPT OSS 120B (نسخة GGUF من Unsloth) |
|---|---|---|---|
| SWE-Bench Verified (500 مهمة) | 72,6 % | 70,80 % | 32,0 % |
| Terminal-Bench 2.1 (89 مهمة) | 62,9 % | 66,29 % | 23,6 % |
توضح Microsoft أن هذه الاختبارات أُجريت على بيئة تشغيل llama.cpp لنظام Windows ARM64، وأن النتائج تختلف بحسب الجهاز والإعدادات. ويتوفر بالفعل مكوّن أول في الطرفية: فمنذ الإصدار التجريبي 1.0.94-0 من Copilot CLI، يكتشف الأمر /model نماذج نسخة Ollama محلية. ولا يُضاف شيء دون تأكيد، ويجب أن يكون Ollama والنموذج مثبتَين مسبقًا، ولا تُعرض إلا النماذج التي تدعم استدعاء الأدوات والبث المتواصل (streaming).
🔗 إتاحة النماذج المحلية والأدوات المعزولة على Windows وGitHub Copilot · اكتشاف النماذج المحلية في GitHub Copilot CLI
بيئة Copilot المعزولة المحلية تصبح متاحة للجميع
7 أكتوبر — تخرج البيئة المعزولة المحلية لـ GitHub Copilot من مرحلة المعاينة العامة التي بدأت في 2 يونيو: وتصبح متاحة للجميع في Copilot CLI وتطبيق GitHub Copilot وجلسات VS Code التي تستخدم Agent Host، دون تكلفة إضافية. وتعمل الأدوات والأوامر التي يشغّلها Copilot حينها بوصول مقيّد إلى الملفات والشبكة وبيانات اعتماد Git وGitHub CLI وإمكانات أخرى للنظام، وفق سياسات يحددها المطور أو مؤسسته؛ ويمكن للشركة فرض إعدادات لا يستطيع المطورون تخفيفها، أيًا كان النموذج المستخدم. والمحرك، Microsoft eXecution Container (MXC)، هو مكتبة مفتوحة المصدر من فريق Windows تعتمد على ProcessContainer في Windows، وSeatbelt في macOS، وbubblewrap في Linux، دون آلة افتراضية. وحدوده موثّقة: فأدوات الملفات المدمجة يتحكم فيها Copilot نفسه لا النظام، وتبقى خوادم MCP البعيدة خارج البيئة المعزولة المحلية.
🔗 العزل المحلي لـ GitHub Copilot أصبح متاحًا للجميع
Replit يبني التطبيقات محليًا على Windows
7 أكتوبر — يعلن Replit، بالتعاون مع Microsoft، عن نسخة تجريبية من تطبيق لسطح المكتب يبني التطبيقات ويشغّلها مباشرة على حاسوب المستخدم بنظام Windows. وكان Replit يقدم بالفعل تطبيقًا لسطح المكتب: وتتمثل الإضافة الجديدة في البناء المحلي، حيث تعمل كل عملية build في بيئتها المعزولة الخاصة، المبنية على Microsoft Execution Containers وOpenShell، بيئة التشغيل المفتوحة المصدر من NVIDIA. ويتطلب الوصول المبكر الانضمام إلى قائمة انتظار، دون موعد أو سعر، ولا تُذكر أي نسخة لنظام macOS. وقد عرض Replit هذه النسخة التجريبية على المسرح خلال فعالية Windows في 7 أكتوبر.
🔗 إعلان Replit على X · قائمة انتظار النسخة التجريبية
OpenAI تنشر 722 مخطوطة لنتائج رياضية أنتجها نموذج داخلي
6 أكتوبر — تنشر OpenAI دفعة واحدة مجموعة واسعة من النتائج الرياضية التي أنتجها نموذج داخلي متقدم غير متاح للعامة. ويضم مستودع GitHub المسمى openai/math، الذي أُعلن عنه مساء 6 أكتوبر، 722 مخطوطة موزعة على 372 عائلة مصنفة بحسب التخصص: وقد ترافق النتيجة الرئيسية فيه حجج تكميلية أو نتائج مترتبة عليها أو براهين بديلة.
تأتي الغالبية العظمى من النتائج من إجراء واحد: نحو 4 000 مسألة طُرحت على النموذج، بمتوسط يعادل ثلاث ساعات من تفكير ChatGPT Pro لكل نتيجة. وتوضح OpenAI أنها وسّعت تقييماتها لتشمل مسائل بحثية مفتوحة بعد بلوغ سقف تقييماتها الرياضية الحالية. ويستثنى عملان من هذا الإجراء: منطقة خالية من الأصفار لدالة زيتا لريمان، عدّل إنسان صياغتها لتسهيل قراءتها، وبرهان لحالة خاصة من حدسية هودج، وهي حالة الأصناف الأبيلية CM.
| المؤشر المنشور من OpenAI | القيمة المعلنة |
|---|---|
| المخطوطات المنشورة | 722 |
| عائلات النتائج | 372 |
| المسائل المطروحة على النموذج | نحو 4 000 |
| متوسط الحساب لكل نتيجة | نحو ثلاث ساعات من التفكير باستخدام ChatGPT Pro |
| ملخصات الاستدلال المنشورة | 10 |
لم تُتحقق جميع النتائج بالطريقة نفسها. فقد صيغت براهين كثيرة صوريًا بلغة Lean، وهي لغة تتيح التحقق من البرهان بالحاسوب، ولكن ليس جميعها: وتحذر OpenAI من أن «بعض النتائج غير المصاغة صوريًا قد تتضمن أخطاء»، وتعد بتصحيحها بسرعة، وستضيف صيغًا صورية جديدة تباعًا. وتتناول ملخصات استدلال النموذج العشرة موضوعات مثل أسّ اللاعقلانية للعدد π، وحدسيات مالر، وحدسية كابلانسكي بشأن التناهي المباشر في مميزة اثنين، أو تماثل عوامل الزمر الحرة.
أُعدّ النشر نفسه بالتعاون مع المجموعة الاستشارية المستقلة المعنية بالرياضيات والذكاء الاصطناعي التابعة لـ Institute for Advanced Study: بروتوكولات للمراجعة والاستشهاد، وتصحيحات تُنشر كإصدارات جديدة، مع الاحتفاظ بالسجل السابق. وتعلن OpenAI أيضًا تمويل ورش عمل ومؤتمرات وبرامج مخصصة لهذه النتائج، وتقول إنها تعمل على إتاحة وصول «مسؤول» للعلماء إلى النموذج الذي أنتجها، دون جدول زمني.
We’re releasing a broad range of new mathematical results produced by an internal frontier model. We’ve been consulting with the independent Advisory Group on Mathematics and Artificial Intelligence at the Institute for Advanced Study, and we have drawn on their advice and public recommendations to inform how we release these results.
🇸🇦 ننشر مجموعة واسعة من النتائج الرياضية الجديدة التي أنتجها نموذج داخلي متقدم. وقد استشرنا المجموعة الاستشارية المستقلة المعنية بالرياضيات والذكاء الاصطناعي التابعة لـ Institute for Advanced Study، واستندنا إلى نصائحها وتوصياتها العامة لتحديد كيفية نشر هذه النتائج. — @OpenAI على X
🔗 مشاركة تقدم الذكاء الاصطناعي في الرياضيات · مستودع openai/math على GitHub
Perplexity تنشر pplx-embed-v2-late، تضمينات متعددة المتجهات للنصوص والصور
7 أكتوبر — تنشر Perplexity Research نموذجَي pplx-embed-v2-late للتضمينات ذات التفاعل المتأخر (late interaction)، بحجمَي 0.6B و9B من المعلمات، والمتاحَين على Hugging Face بموجب ترخيص MIT. بينما يضغط التضمين الكثيف كل مستند في متجه واحد، تحتفظ هذه النماذج من نوع ColBERT بمتجه ذي 128 بُعدًا لكل رمز، وتقيّم كل زوج من الاستعلام والمستند باستخدام MaxSim: يُطابق كل رمز في الاستعلام مع أقرب رمز إليه في المستند. وهي تبحث في النصوص والصور والصفحات المعروضة بصريًا (PDF، والشرائح، والمستندات الممسوحة ضوئيًا) دون المرور عبر OCR، مما يحافظ على الجداول والأشكال وتخطيط الصفحة.
يشترك الحجمان في فضاء تضمينات واحد، لأن المعرفة تُقطَّر إليهما رمزًا برمز من نموذج معلّم داخلي بحجم 18B، مشتق من نموذج أساسي بحجم 27B. لذلك يمكن البحث في مجموعة مستندات فُهرست باستخدام 9B باستعلامات رُمّزت باستخدام 0.6B: على ViDoRe v3 للصور، يحقق هذا الإعداد 63,5 %، مقابل 62,3 % عند استخدام 0.6B في الطرفين، دون تكلفة إضافية للاستعلام. وهكذا يعمل 0.6B، الذي خُفّض حجمه بالتقليم انطلاقًا من Qwen3.5-0.8B، بوصفه مُرمِّزًا خفيفًا للاستعلامات، حتى على الجهاز نفسه.
| معيار التقييم المستخدم (قياسات Perplexity) | نتيجة 9B | نتيجة 0.6B | مرجع المقارنة |
|---|---|---|---|
| 72 مهمة متخصصة (nDCG@10) | 81,3 % | 78,0 % | يتقدم 9B على النموذج التالي بفارق 1,6 نقطة |
| Q2D-Web، البحث على الويب (Recall@1000) | 74,8 % | 73,6 % | nemotron-embed-8b : 69,3 % |
| ViDoRe v3 للصور (nDCG@10) | 65,2 % | 62,3 % | وحده EVIE يتقدم على 9B |
| BrowseComp+ (وكيل GPT-OSS-120B) | 64,0 % | — | أفضل نموذج ColBERT يليه: أقل بمقدار 4,9 نقاط |
| MADQA (وكيل Gemini 3.5 Flash) | 92,4 % | 90,1 % | Mixedbread Agentic Search : 93,4 % |
لا يتفوق 9B في كل المجالات، وتصرّح Perplexity بذلك: يتقدم عليه EVIE من Tencent على ViDoRe v3 للصور، وgemini-embedding-2 على MIRACL-Vision وعلى معيار التقييم الداخلي PPLX-Q2I، كما يحقق Mixedbread Agentic Search نتيجة أفضل على MADQA، وهو فارق ترى Perplexity أنه يقع ضمن فاصل الثقة لديها. وتقرّ الشركة أيضًا بأن متطلبات التخزين وتكلفة التقييم تزداد مع طول المستندات. وقد أعلنت عن تقرير تقني «في وقت لاحق من هذا العام»، وتعتزم Perplexity إتاحة تضميناتها ذات التفاعل المتأخر والكثيفة والسياقية تدريجيًا على منصة API الخاصة بها، دون تحديد موعد.
🔗 تدوينة Perplexity Research · pplx-embed-v2-late-9b على Hugging Face
وكلاء البرمجة: Claude Code 2.1.293، وCodex CLI 0.161.0، وCursor على iOS، وAntigravity 2.21.0، وWarp Factories
تتطور خمس أدوات لوكلاء البرمجة: يعتمد Claude Code نموذج Haiku 5.5، ويتصل Codex CLI بخوادم MCP من الطرفية، ويمكن التحكم في Cursor من iPhone، ويجمع Antigravity إجراءات وكيله، ويضيف Warp دعمًا لأدوات Microsoft.
Claude Code 2.1.293 يعتمد Haiku 5.5 افتراضيًا
7 أكتوبر — صدر الإصدار 2.1.293 من Claude Code بعد دقائق من إعلان Haiku 5.5، ويجعله نموذج Haiku الافتراضي على API الخاصة بـ Anthropic. ويضيف حقل agentType إلى حمولة subagentStatusLine لتمييز الوكلاء الفرعيين المخصصين، وخيار isDeferred الذي يكشف منذ البداية مخطط الأدوات التي تعلنها mods. ويتمثل الجزء الأكبر من التحديث في 38 إصلاحًا من أصل 56 بندًا: كان Claude قد ينسب، بعد ضغط السياق، إجراءاته الأخيرة السابقة للضغط إلى ما بعده، ثم يحذف عملًا مكتملًا أو يعيد تنفيذه؛ وأصبحت القواعد المقيدة بمسار وملفات CLAUDE.md المتداخلة تُحمَّل أيضًا عندما يقرأ Claude ملفًا باستخدام cat أو grep في Bash؛ كما أُزيل تسرّب للذاكرة في اتصالات MCP عبر HTTP. وأُلغي تغييران حديثان (رسالة الرفض في الوضع التلقائي من الإصدار 2.1.281، وإصلاح للجلسات السحابية من الإصدار 2.1.290)، ورُفع حد قواعد القنوات في Claude Tag من 20 إلى 50.
🔗 Claude Code 2.1.293 على GitHub
Codex CLI 0.161.0 يجعل Daybreak مشروطًا بتفعيل خيار
7 أكتوبر — يمثل Codex CLI 0.161.0 أول إصدار مستقر منذ الإصدار 0.160.1 الصادر في 5 أكتوبر. يتيح الأمر /mcp login <name> الاتصال بخادم MCP دون مغادرة جلسة الطرفية الحالية، وتضيف المحادثات الصوتية إمكانية اختيار الميكروفون ومكبر الصوت وقنوات الإدخال. وأصبحت Daybreak، مجموعة OpenAI للأمن السيبراني، مشروطة بتفعيل خيار: يظل مفتاح التبديل /daybreak وحالة Daybreak في سطر الحالة مخفيَين ما لم يفعّله المستخدم باستخدام --enable cli_daybreak (أو features.cli_daybreak=true)، وبدون هذا التفعيل يُستبعَد التوجيه التلقائي إلى Cyber. ويختار codex exec --cyber-access-program برنامج وصول إلى Cyber لجولة واحدة فقط. وفي Amazon Bedrock، يصل دعم تعدد الوكلاء V2 ومستوى جهد الاستدلال Ultra إلى النماذج المتوافقة، ويقبل Bedrock Mantle مناطق AWS GovCloud. وتتناول الإصلاحات الأذونات واستئناف المحادثات واكتشاف قاعدة بيانات SQLite تالفة.
🔗 Codex CLI 0.161.0 على GitHub
Cursor يتيح التحكم من iOS في وكلاء الحاسوب
6 أكتوبر — يعرض تطبيق Cursor على iOS الآن الوكلاء الذين يعملون محليًا على الحاسوب: يمكن الاطلاع على ما يفعله كل منهم والرد عليه، وتذكر تغريدة الإعلان أيضًا إطلاق مهام جديدة. يظل الوكلاء على الجهاز ويتصل التطبيق به: لذا يجب أن يبقى الحاسوب قيد التشغيل ومتصلًا بالإنترنت، ويمنع إعداد «إبقاء هذا الحاسوب نشطًا» دخوله في وضع السكون، عندما يكون موصولًا بالطاقة وشاشته مفتوحة. الميزة مفعّلة افتراضيًا، باستثناء مؤسسات Enterprise، حيث يجب على المسؤول تفعيلها؛ ويُؤكَّد الاقتران في تطبيق سطح المكتب، ولا يلزم استخدام الوكلاء السحابيين. كان تطبيق iOS الذي صدر في أواخر يونيو يركز على الوكلاء السحابيين: أما الآن فأصبح الوصول إلى الوكلاء المحليين ممكنًا من الهاتف.
Antigravity 2.21.0 يجمع إجراءات وكيله
6 أكتوبر — ينتقل تطبيق Antigravity من Google إلى الإصدار 2.21.0، مع 9 تحسينات و14 إصلاحًا. يتيح البحث المتقدم العثور على محادثة انطلاقًا من محتواها، باستخدام ⌘+K (أو Ctrl+K على Windows). ويتحول تبويب المهام المجدولة (المهام المجدولة) إلى «الأتمتة»: يمكن تشغيل عملية أتمتة فورًا باستخدام «تشغيل الآن»، أو طلب إرشاد الوكيل لإنشاء عملية جديدة باستخدام «إنشاء باستخدام موجّه». وأصبحت تعديلات الملفات وأوامر الطرفية وعمليات القراءة التي ينفذها الوكيل بين ردّين تُجمع في سطر واحد قابل للطي، مع ملخص قصير. ومن بين الإصلاحات، كانت قراءة الوكيل لفيديو MP4 أو MOV مبتور قد تتسبب في فشل بقية المحادثة بأكملها، وكان ملف إعدادات محفوظ باستخدام «المفكرة» في Windows أو PowerShell يتوقف عن العمل. وينبّه سجل التغييرات إلى أن وصول إصدار إلى جميع المستخدمين قد يستغرق بضعة أيام.
Warp Factories يضيف دعمًا لـ Microsoft Teams وAzure DevOps
7 أكتوبر — يضيف Warp دعمًا لـ Microsoft Teams وAzure DevOps Services إلى Warp Factories، منصته لمصانع البرمجيات (software factories). في Teams، تؤدي الإشارة إلى تطبيق Warp في قناة أو سلسلة محادثة مُهيّأة إلى إسناد المهمة إلى المصنع مع سياق المحادثة؛ ويعرض تقدمه في السلسلة نفسها ويعيد إليها طلبات السحب للمراجعة. وفي Azure DevOps، يمكن الإشارة إلى المصنع من عنصر عمل (work item) أو طلب سحب، أو تشغيل عمليات تنفيذ استجابةً للأحداث المتعلقة بهما؛ ويحصل كل مصنع على هوية خاصة به لعمليات Git، مع وصول يقتصر على المستودعات المختارة. والتكاملان متاحان لجميع عملاء Warp Factories. ويقدّم Warp هذا الدعم الأصلي المزدوج بوصفه الأول في القطاع؛ وكان Devin يتكامل بالفعل مع Teams وAzure DevOps Server.
API والمنصات: مجموعتا أدوات computer use وbrowser use في SDK الخاصة بـ Claude، وGrok 4.7 على Microsoft Foundry
إعلانان للمطورين الذين يبنون باستخدام نماذج مستضافة: تبسّط Anthropic التحكم في حاسوب أو متصفح، ويصل Grok 4.7 إلى الإتاحة العامة لدى Microsoft.
مجموعتا أدوات computer use وbrowser use في SDK الخاصة بـ Claude
7 أكتوبر — تتضمن SDK الخاصة بـ Claude للغتي Python وTypeScript، في إصدار تجريبي، مجموعتَي الأدوات (toolsets) computer use وbrowser use. حتى الآن، كانت API تشير إلى ما يريد Claude النقر عليه أو كتابته، وكان على المطور كتابة حلقة خاصة به لتحويل كل إجراء إلى أمر. وأصبحت SDK تتولى هذه الحلقة: ينشئ المطور فئة فرعية من BetaAbstractBrowserToolset20260801 أو BetaAbstractComputerToolset20260801، ويكتب دالة لكل إجراء، ثم توجّه SDK الاستدعاءات وتطبق سياسات URL والملفات المقدمة وتطلب الموافقات وتبني النتائج التي تُعاد إلى النموذج. ولا توفر Anthropic متصفحًا أو مشغّلًا جاهزًا للاستخدام: يُربط بها نظام الأتمتة الخاص بالمطور أو مشغّل من Browser Use أو Browserbase أو E2B أو Daytona، وقد نُشر مثال بسيط باستخدام Chrome DevTools Protocol في مستودع claude-quickstarts. ويكون تنفيذ JavaScript وإرسال الملفات معطلَين افتراضيًا، ولا يُفحص أي عنوان في غياب سياسة URL.
🔗 سلسلة منشورات @ClaudeDevs على X · توثيق مجموعات أدوات SDK
Grok 4.7 متاح للجميع على Microsoft Foundry
7 أكتوبر — أصبح Grok 4.7، نموذج SpaceXAI الذي صدر في 21 سبتمبر، متاحًا على Microsoft Foundry، وفقًا لما أعلنه @SpaceXAI ليلًا. تصنّفه وثائق Microsoft ضمن الإتاحة العامة، بين النماذج التي تبيعها Azure مباشرةً: يقبل النصوص والصور كمدخلات، ويوفر سياقًا من 500 000 رمز (للمدخلات والمخرجات معًا)، واستدعاء الأدوات، والوصول عبر Chat Completions أو Responses API، وجهد استدلال من low إلى xhigh، مع high افتراضيًا. وتلتزم Microsoft بتوفير نماذج Grok ضمن الإتاحة العامة، بدءًا من Grok 4.7، لمدة لا تقل عن ستة أشهر؛ ولا يزال Grok 4.6 مدرجًا هناك في إصدار معاينة. ولم تكن صفحة أسعار Azure قد أدرجت Grok 4.7 بعد مساء 7 أكتوبر. وبعد Amazon Bedrock (28 سبتمبر) وGoogle Cloud في إصدار معاينة (1 أكتوبر)، أصبح Grok 4.7 متاحًا لدى مزودي الخدمات السحابية الثلاثة الكبار.
🔗 نشر نماذج Grok واستخدامها في Microsoft Foundry
النماذج المفتوحة: Open d1 من Liquid AI، وBolmo من Ai2 في Nature مع Bwen 8B وBlama 8B
إصداران بأوزان مفتوحة، أحدهما لاتخاذ القرارات سريعًا عند أطراف الشبكة، والآخر لقراءة النص بايتًا بايتًا.
Open d1، نماذج اتخاذ القرار المفتوحة من Liquid AI
7 أكتوبر — تفتح Liquid AI عائلة نماذج اتخاذ القرار لديها عبر Open d1: نموذجان بأوزان مفتوحة، d1-3B (للنصوص والصور) وd1-omni-600M (للنصوص مع الصور أو الصوت)، والأخير في إصدار بحثي مبكر. وهي لا تولّد نصوصًا: بل تمنح، في تمريرة واحدة، احتمالًا لكل إجابة مسموح بها. ووفقًا لـ Liquid AI، يحقق d1-3B نتيجة 48,57 على Decision Index 0.2.1، وهي الأفضل بين النماذج التي تقل عن 10 مليارات معلمة، متقدمًا على Decider 35B-A3B (47,11)، ومتوسطًا قدره 82,9 على سبع مجموعات بيانات عامة. ويتراوح زمن استجابته لسؤال واحد، وفق قياسات أُجريت مع NVIDIA، من 8 ms على RTX 4090 إلى 50 ms على Jetson Orin Nano، مما يتيح استهداف أطراف الشبكة (edge). ولم تُنشر أي اختبارات أداء للرؤية أو الصوت. والأوزان متاحة على Hugging Face بموجب ترخيص Liquid AI الخاص (lfm1.0)، مع نسخ GGUF؛ أما d1 الذي صدر في 29 سبتمبر فكان الوصول إليه متاحًا عبر API فقط.
🔗 تدوينة Liquid AI على Hugging Face
Bolmo من Ai2 في Nature، مع Bwen 8B وBlama 8B
7 أكتوبر — تنشر Ai2 في Nature، عبر الإنترنت في 7 أكتوبر، المنهجية وراء Bolmo، عائلتها من النماذج المفتوحة بالكامل التي تقرأ البايتات مباشرةً بدلًا من أجزاء الكلمات. تتجنب قراءة البايتات جوانب القصور في مفردات ثابتة (الإملاء، والسلاسل غير المعتادة، وبعض أنظمة الكتابة)، لكنها كانت تتطلب حتى الآن تدريبًا كاملًا من الصفر. أما التحويل إلى بايتات (byteifying) فينطلق من نموذج قائم على أجزاء الكلمات وذي أداء جيد بالفعل، ثم يحوّله من خلال تدريب إضافي قصير. يعود إصدارا Bolmo 1B و7B، المشتقان من Olmo، إلى ديسمبر؛ وتقدّم Ai2 أيضًا Bwen 8B (المشتق من Qwen 3 8B، بترخيص Apache-2.0) وBlama 8B (المشتق من Llama 3 8B، بترخيص llama3)، اللذين توجد مستودعاتهما منذ 26 أغسطس، إضافةً إلى نقاط تحقق «المرحلة 1» التي يُدرَّب فيها مستوى البايتات الجديد وحده. ووفقًا لـ Ai2، يقترب النموذجان من أداء النموذجين الأصليين، ويتفوق Bwen 8B على Bolmo 7B، دون نشر أرقام.
SynthID Detector متاح للجميع لفحص الصور والفيديو والصوت
7 أكتوبر — تتيح Google للجميع SynthID Detector، الأداة التي تكتشف العلامات المائية غير المرئية SynthID في المحتوى المُنشأ بالذكاء الاصطناعي. وقد قُدّمت العام الماضي في نسخة أولية مخصصة للعاملين في الإعلام، وهي متاحة الآن على synthid.com في جميع أنحاء العالم وباللغة الإنجليزية. يمكن رفع صورة أو فيديو أو ملف صوتي إليها. ويشمل الفحص محتوى Google ومحتوى شركائها OpenAI وNVIDIA وKakao، وقريبًا Apple. وتنبه البوابة إلى أنها ليست كاشفًا عامًا للمحتوى المُنشأ بالذكاء الاصطناعي: فقد تظهر نتيجة «لم يُكتشف» لمحتوى صادر عن نموذج لا يستخدم SynthID، أو لمحتوى خضع لتعديلات كبيرة. وتقول Google إنها وضعت علامات مائية على أكثر من 180 مليار صورة وفيديو و240 000 سنة من الصوت منذ 2023، مقابل 100 مليار و60 000 سنة أُعلن عنها في يوليو، وأنها تجري أكثر من مليون فحص يوميًا في Search وتطبيق Gemini وChrome.
🔗 Google توسّع إتاحة SynthID Detector للمحتوى المُنشأ بالذكاء الاصطناعي
الأمن: مُصنِّف GitHub للأسرار المسرّبة
7 أكتوبر — تبدأ GitHub تشغيل مُصنِّف ModernBERT خضع لضبط دقيق، مخصص للأسرار المسرّبة ومطوّر بالتعاون مع Microsoft Applied Sciences: يقرأ الشيفرة المحيطة بقيمة ما لتحديد بيانات الاعتماد المحتملة، بما فيها كلمات المرور التي لا تتبع تنسيقًا يمكن التعرف عليه. ويقيّم دفعة من القيم المرشحة في أقل من 2 ms، ويمكنه، وفقًا لـ GitHub، «أكثر من مضاعفة» عدد الأسرار التي يُمنع دفعها. وتنتقل تنبيهات كلمات المرور المكتشفة بالذكاء الاصطناعي إلى هذا النموذج بدءًا من الآن، دون تكلفة إضافية. ومن المقرر أن تصل حماية عمليات الدفع بالذكاء الاصطناعي، المتاحة في معاينة خاصة، «في وقت لاحق من هذا الشهر» إلى المؤسسات المؤهلة، وأن تدخل فحوص أمر /security-review في Copilot «قريبًا» مرحلة المعاينة الخاصة، وكلاهما مقابل أرصدة الذكاء الاصطناعي. ويذكّر مقال Erin Havens، مسؤولة منتج الأمن لدى GitHub، بأن طلب سحب واحدًا من كل ثلاثة يتضمن وكيل ذكاء اصطناعي، وأن حماية عمليات الدفع لا توقف سوى نحو 30 % من الأسرار الجديدة المكتشفة.
🔗 يجب أن تتوسع حماية الأسرار مع توسّع البرمجيات
البنية التحتية: GitHub يعيد بناء Git لمواكبة نشاط الوكلاء
6 أكتوبر — يعيد GitHub بناء بنيته التحتية لـ Git لمواكبة وتيرة التطوير القائم على الوكلاء. بحسب التدوينة الهندسية لبرايان سيلينزا، ارتفع إجمالي نشاط Git من 218,2 إلى 473,3 مليار حدث شهريًا بين سبتمبر 2025 وأغسطس 2026؛ وبلغ عدد commits التي أنشأها المطورون والوكلاء 7,38 مليار في سبتمبر 2026، أي أكثر من خمسة أضعاف العدد قبل عام، وارتفع عدد pushes إلى 4,9 أضعاف. تنسخ البنية الحالية، Spokes، كل مستودع على عدة خوادم وتُقرّ كل تحديث بتصويت الأغلبية، لذا فإن إضافة نسخ لخدمة القراءات تُبطئ الكتابات. تفصل البنية الجديدة بين التخزين والحوسبة، وتضع البيانات المرجعية في Azure Blob Storage، مع عمليات خفيفة (workers) تخدم القراءات من ذاكرة مؤقتة. في اختبارات الأداء الداخلية، يقيس GitHub زيادة في معدل نقل الكتابات تصل إلى 35 ضعفًا، من دون تحديد موعد للانتقال.
🔗 بناء بنية Git التحتية للتطوير على نطاق الوكلاء
الذكاء الاصطناعي الصوتي: ElevenLabs يوقّع مذكرة تفاهم مع ولاية هندية
7 أكتوبر — بمناسبة فعالية Summit في بنغالورو، وقّعت ElevenLabs أول مذكرة تفاهم (MOU) لها مع حكومة ولاية هندية، لتنفيذ مشروع تجريبي للذكاء الاصطناعي الصوتي. لم تسمِّ الشركة الولاية، ولم تحدد جدولًا زمنيًا أو نطاقًا أو مبلغًا: اقتصر الإعلان على تغريدة، من دون تدوينة. ويوضح الرقم المصاحب له حجم الرهان: خلال العام الماضي، أجرى ElevenAgents أكثر من 100 مليون محادثة في الهند، كان أكثر من 70 % منها بالهندية والكنادية والتاميلية والتيلوغوية. وجمعت فعالية Summit أكثر من 500 من قادة الشركات والمطورين والشركاء.
البحث: PivotOPD، طريقة NVIDIA لتدارك الخطأ الحاسم الذي يرتكبه الوكيل
7 أكتوبر — يعرض باحثو NVIDIA طريقة PivotOPD لتدريب الوكلاء الذين ينفذون عدة جولات متتابعة من الإجراءات. وقد لاحظوا أن 59 % من حالات فشل ثلاثة نماذج Qwen3 على ALFWorld تتضمن «خطأً محوريًا» يُرتكب مبكرًا، ويواصل الوكيل بعده السير في الاتجاه الخاطئ. توسّع PivotOPD التقطير وفق السياسة (on-policy distillation): عند كل خطأ محوري، يحدد نموذج معلّم الإجراء الصحيح، ثم إجراءً للتدارك في الجولات التالية، فيتعلم النموذج المتعلّم تجنب الخطأ والتعافي منه. وبالمقارنة مع 13 طريقة مرجعية، تحقق أفضل متوسط على ALFWorld وWebShop وSearch-based QA باستخدام نماذج متعلّمة من Qwen3 بحجمي 1.7B و8B، وتتدارك 72,7 % من الأخطاء المحورية الـ 72 التي أُعيد تنفيذها، مقابل 20,3 % للتقطير القياسي. وينتقل التحسن إلى البرمجة: يرتفع أداء نموذج متعلّم من Nemotron-3.5 من 62,8 % إلى 66,0 % على SWE-Bench Verified. الورقة منشورة على arXiv؛ ومن المعلن أن الشيفرة ستُنشر قريبًا.
التحسين: mPDLP يوزّع مسائل البرمجة الخطية الضخمة على عدة GPU في cuOpt
7 أكتوبر — تضيف NVIDIA إلى cuOpt، مكتبتها المفتوحة المصدر للتحسين، المحلّل mPDLP للبرمجة الخطية، الذي يعمل بصورة موزعة على عدة GPU متصلة عبر NVLink، لمعالجة مسائل التخطيط الكبيرة، مثل سلاسل الإمداد والشبكات الكهربائية. ومن خلال تجميع المتغيرات والقيود المترابطة على GPU واحد، يحدّ من تبادل البيانات ويخفض ذروة استهلاك الذاكرة لكل GPU بمعامل يصل إلى 6. على عقدة DGX B200، يصل التسريع إلى 11,4 ضعفًا في حسابات PDLP و4,2 أضعاف من البداية إلى النهاية؛ وبالمقارنة مع D-PDLP، يكون mPDLP أسرع بمقدار 1,2 إلى 2,5 ضعف على معظم المسائل الكبيرة، لكنه أبطأ في الحالات الثلاث الأكبر وفي المسائل الصغيرة. تحلّ Kinaxis مسألة سلسلة إمداد تضم أكثر من 135 مليون متغير بسرعة أعلى بمقدار 3,3 أضعاف على ثمانية H100، وتحلّ PSR نموذجًا للطاقة يضم 185 مليون متغير بسرعة أعلى بأكثر من 5 أضعاف على ثمانية B200.
الروبوتات: روبوتات تجمع صواني اختبار GB300
7 أكتوبر — يروي مختبر الروبوتات في سياتل التابع لـ NVIDIA كيف يعلّم الروبوتات تجميع صواني اختبار GB300، التي تفحص الوحدات قبل شحنها. واختيرت عمليتان بالتعاون مع Foxconn، الشركة التي تصنع هذه الأنظمة: وضع قضيب توزيع كهربائي وتثبيته بالبراغي في 16 نقطة، وتوصيل أربعة موصلات مثبتة على كابلات مرنة. والشرط المتفق عليه مع Foxconn هو تحقيق نجاح بنسبة 99,5 %، في مدة لا تتجاوز ضعف الوقت الذي يستغرقه عامل ماهر، ومن دون اصطدام. تقترب الروبوتات من هذا الهدف لكنها لا تبلغه: نجاح يتجاوز 95 % في 160 ثانية للقضيب، مقابل زمن مستهدف قدره 124 ثانية، ونجاح بنسبة 90 إلى 95 % للموصلات، بمعدل 40 ثانية لكل كابل. يجمع الفريق بين سلسلة تقليدية للإدراك والتحكم، وتقدير الوضعية باستخدام DOPER، والتعلم المعزز في Isaac Lab، مع تصحيحات على الروبوت الفعلي. وتعد NVIDIA بنشر DOPER ومنسّقها TALOS، من دون تحديد موعد.
🔗 تدوينة مدونة NVIDIA التقنية عن صواني GB300
أخبار موجزة
- تطبيق ChatGPT على iOS، الإصدار 1.2026.272 — يعرض معاينات الصفحات مباشرةً داخل الإجابات، ويفتح روابط مهام Codex داخل التطبيق، ويعيد في Codex Mobile تصميم محدد الموافقات ويسرّع تدفق المحادثات الطويلة. 🔗 المصدر
- Radisson Hotel Group — بحسب دراسة حالة من OpenAI، تحقق إضافته في ChatGPT، التي بُنيت خلال ستة أسابيع بالتعاون مع Accenture Song، معدل تحويل يعادل نحو 1,5 ضعف معدل بحثه العضوي خلال يوليو وأغسطس 2026، وتُعزى 54 % من أحداث الدفع والحجز في حملته الإعلانية داخل ChatGPT إلى مجرد مشاهدة الإعلانات. 🔗 المصدر
- Jump Trading — تسند شركة التداول الكمي إلى وكلاء GPT-6 Astra تحليلات قد تستمر عدة أيام، وتجمع بين مصادر بيانات عديدة، مع مراجعة بشرية في نهاية العملية؛ ولا تنشر دراسة الحالة من OpenAI أي أرقام للمكاسب. 🔗 المصدر
- امتدادات إضافات ChatGPT — في سلسلة المنشورات المصاحبة لشرحها بالفيديو، تذكر OpenAI Developers شركات Adobe وCanva وFigma وShopify وInstacart وAtlassian ضمن مستخدميها، إلى جانب tldraw وMagicPath؛ وقد قُدمت هذه الامتدادات في 29 سبتمبر، وتتيح تشغيل إضافة من الشريط الجانبي، وتدير إشارات @، وتضيف عارضات ملفات. 🔗 المصدر
- Every وClaude Managed Agents — بنى فريق Every على Claude Managed Agents وكيلًا للشركة يستخدمه الجميع في Slack لمشاركة مهاراتهم مع كل نموذج جديد، ثم أتاحه لمشتركيه؛ وتنشر Anthropic مقابلة بالفيديو، من دون أرقام. 🔗 المصدر
- Zed 1.23 والإصدار التمهيدي 1.24.1 — ينتقل الإصدار 1.23 إلى القناة المستقرة مع معاينة ملفات JSONL وNDJSON، ويتيح الإصدار التمهيدي 1.24.1 سحب تبويب طرفية إلى Agent Panel، ويدعم نماذج Amazon Bedrock المخصصة مع الأدوات والصور والتفكير، وينشئ وسوم Git، ويقلّص حجم الملف التنفيذي على Linux بنحو 23 %. 🔗 المصدر
- Puck، الوكيل الفوقي في Amp — يدعم الآن عدة محادثات منفصلة: يفتح الزر + محادثة جديدة، ويتيح النقر على اسم المحادثة الانتقال بينها، وتُحفظ المحادثات التي بقيت غير نشطة ثلاثة أيام في مكان منفصل. 🔗 المصدر
- Copilot CLI 1.0.93 — أصبح الإصدار مستقرًا، ويطبق تغييرات إعدادات خوادم MCP بين جولتين من دون إعادة تشغيل الجلسة، ويتيح للجميع بيئة الأوامر المعزولة عبر /sandbox و—sandbox؛ كما أصبح Copilot SDK 1.0.17 مستقرًا. 🔗 المصدر
- مقاييس استخدام Copilot — كانت تحصي نشاط الوكلاء بأقل من حجمه الفعلي منذ أن بدأت عدة بيئات IDE تمرّر جلساتها عبر Copilot SDK؛ ويتطلب الإصلاح تحديثًا، مع توفر VS Code 1.139.0 الآن، وVisual Studio 18.12 في أكتوبر، وJetBrains في نهاية أكتوبر، وEclipse وXcode بحلول نوفمبر، ولن تُستعاد البيانات المفقودة. 🔗 المصدر
- Gemini CLI v0.65.0-nightly.20261007 — يفتتح هذا الإصدار الليلي سلسلة 0.65.0 بخمسة إصلاحات، منها اثنان لمنع فقدان البيانات: تصبح إعدادات المشروع للقراءة فقط داخل مجلد غير موثوق، حيث كان
gemini mcp addقد يُفرغ.gemini/settings.json، ولم يعد الخروج فورًا من جلسة مستأنفة يحذف سجلها. 🔗 المصدر - Transformers.js 4.3.1 — في اليوم التالي لإطلاق EmbeddingGemma 2، تحسب المكتبة تضميناته متعددة الوسائط، ذات 740 مليون معامل و768 بُعدًا، مباشرةً في المتصفح باستخدام WebGPU أو WASM، أو ضمن Node.js. 🔗 المصدر
- RL Environment Explorer — يقدم أديتيا إس كيه، من Hugging Face، هذه المساحة التابعة لـ FineEnvs لتصفح بيئات التعلم المعزز على Hub وعرضها وتشغيلها، بما فيها OpenEnv وHarbor وMiMo وVerifiers وNeMo Gym: أكثر من 12 مليون مدخل للمهام، يأتي معظمها من بضعة بيئات OpenEnv كبيرة. 🔗 المصدر
- Seb-9B — ينشر ستاس فيريتيننيكوف نموذج اتخاذ القرار المحلي هذا بترخيص Apache-2.0، ويدعم النص وJSON والصور وما يصل إلى 20 خيارًا، ويحقق متوسطًا قدره 0,792 على 17 مجموعة اختبارات عامة، مقابل 0,786 لـ Jev 1.13؛ وقد أجرى المؤلف جميع القياسات، ويوضح أن بيانات تدريبه تضمنت قسم التدريب في أحد الاختبارات المرجعية، من دون حالات الاختبار الخاصة به. 🔗 المصدر
- Nemotron في أولمبيادات 2026 — تفصّل NVIDIA الوصفة المشتركة، من ضبط دقيق بإشراف وتعلم معزز وحلقة تولّد وتتحقق وتصحح، التي حققت 535,4 من 600 في IOI 2026 بمشاركة غير رسمية، و30 من 42 في IMO 2026، حيث عتبة الذهب 29، وتنشر معيار Nemotron-IMO-Bench الذي يضم 200 مسألة. 🔗 المصدر
- Instadocs: AI Gone Wild — تعلن Netflix عرض هذا الفيلم الوثائقي في 12 أكتوبر، وهو يعيد بناء أحداث الهجوم السيبراني الذي تعرضت له Hugging Face في يوليو، والذي نفذته، بحسب Netflix، وكلاء مستقلة أنشأها باحثون من OpenAI. 🔗 المصدر
- Runway في دليل تطبيقات ChatGPT — بعد تثبيت الإضافة وربط حساب Runway، تُسند إليه إشارة @Runway في محادثة مهمة توليد صور أو فيديوهات؛ ولا يحدد Runway السعر أو التكلفة بالأرصدة. 🔗 المصدر
- Face Swap من Luma — تستبدل الميزة وجه شخصية في لقطة موجودة لإجراء تعديلات متتابعة من دون البدء من جديد؛ ويقتصر الإعلان على تغريدتين، من دون صفحة للمنتج أو سعر أو تفاصيل عن النموذج. 🔗 المصدر
- DSX Air — توضح NVIDIA كيفية اختبار تغييرات مصنع للذكاء الاصطناعي على هذا التوأم الرقمي: تطبق الوكلاء التعديل، وتتحقق من الإعدادات والأمان والعزل، ثم تقدم تقريرًا، بينما يظل الانتقال إلى بيئة الإنتاج خاضعًا لموافقة بشرية؛ وهي تدوينة تشرح الطريقة، من دون أرقام. 🔗 المصدر
- cuPhoton — يطبق شرح من NVIDIA مجموعة الأدوات المفتوحة المصدر هذه على تحليل الصور الفلكية باستخدام GPU، من قراءة ملفات FITS إلى مراجعة الأجرام المرشحة؛ وتتعلق المكاسب المعلنة، التي تصل إلى 14 900 ضعف، بعمليات محددة وليس بالمعالجة من البداية إلى النهاية. 🔗 المصدر
- Cosmos وSynthID — تحمل المحتويات التي تولدها نماذج NVIDIA Cosmos على build.nvidia.com العلامة المائية SynthID، ويمكن الآن للجميع التحقق منها باستخدام أداة الكشف التي أتاحتها Google. 🔗 المصدر
- حزمة SDK بلغة TypeScript من SpaceXAI، الإصدار 0.2.3 — تضيف مستوى خدمة
fast، يمكن استخدامه بالتبادل معpriority، والمعرّفgrok-imagine-video-1.5-liteلنموذج فيديو أخف غير مذكور في ملاحظات الإصدار: بحسب بيانات صفحة النماذج، لا يقبل الصوت ضمن المدخلات، وتقل تكلفته لكل ثانية بأربع مرات عنgrok-imagine-video-1.5بدقة 480p. 🔗 المصدر - دليل المقارنة بين RAG وLLM — تنشر Perplexity دليلًا تعليميًا يعرض RAG وLLM بوصفهما متكاملين، ويميز بين ثلاثة أنواع من RAG، هي البسيط والقائم على وحدات والمتقدم، ويوضح متى يكفي LLM وحده؛ من دون أي ميزة أو رقم جديد. 🔗 المصدر
ماذا يعني ذلك
تصبح النماذج الصغيرة المنتج واسع الانتشار. ابتداءً من 8 أكتوبر، يتولى GPT-6 Luna الرد على مستخدمي ChatGPT المجانيين، وتحدد Anthropic سعر Haiku 5.5 عند 0,10 دولار لكل مليون رمز من المدخلات عندما يقل طول الطلب عن 100 000 رمز، مع خفض سعر قراءة ذاكرة Sonnet 5.5 المؤقتة إلى النصف. تستوعب هذه النماذج معظم حجم الاستخدام: المحادثات اليومية والوكلاء الفرعيون والملخصات وضغط السياق. لكن ترتيب Cursor يذكّر بأن سعر الرمز لا يوضح الصورة كاملة: عند مستوى الجهد Max، يستهلك Haiku 5.5 ما يقارب تسعة أضعاف عدد الرموز لكل مهمة مقارنةً بـ Sonnet 5.5 عند مستوى الجهد High، مقابل تكلفة أقل قليلًا فقط لكل مهمة، تبلغ 1,12 دولار مقابل 1,20. ومن جهته، يشجع رصيد API الشهري في باقتي Max وTeam المشتركين على تجربة هذه النماذج في شيفراتهم الخاصة.
يعود الذكاء الاصطناعي أيضًا إلى محطة العمل. تصل الحواسيب المحمولة RTX Spark في 16 أكتوبر، ويعد DGX Station for Windows بقدرة تصل إلى 20 بيتافلوب على مكتب، ومن المفترض أن يسند Copilot بنفسه بعض المهام إلى MAI Code 1.1 Flash محليًا بحلول نهاية الشهر. ويبني Replit التطبيقات الآن على جهاز المستخدم. تثير الوكلاء التي تنفذ الشيفرة على حاسوب شخصي مسألة أمنية، ويتكرر المكوّن نفسه في كل مكان: Microsoft Execution Containers (MXC)، المتاح عمومًا على Windows، يعزل أوامر Copilot وعمليات بناء Replit على حد سواء. ومن جانبه، ينشر GitHub مصنّفًا مخصصًا للأسرار المكشوفة، ويعيد بناء بنيته التحتية لـ Git، لأن طلب pull request واحدًا من كل ثلاثة يتضمن بالفعل وكيلًا، ولأن عدد commits ارتفع إلى أكثر من خمسة أضعاف خلال عام.
تصبح الإجابة أيضًا واجهة. مع Intelligent UI، يجيب ChatGPT برسوم بيانية أو نماذج أو أداة صغيرة تُبنى عند الطلب، ويبدأ الرد قبل أن ينتهي من التفكير. ومن جهة المطورين، تدعم حزم SDK الخاصة بـ Claude حلقة computer use وbrowser use، ويتيح Cursor متابعة الوكلاء التي تعمل على الحاسوب والرد عليها من iPhone. في الحالات الثلاث، لم يعد النص سوى جزء من التفاعل: يعرض الذكاء الاصطناعي وينقر ويقدم تقارير، ويشرف المستخدم.
وأخيرًا، يقيس ناشرو كثير من أرقام اليوم هذه الأرقام بأنفسهم: اختبارات أداء Haiku 5.5 لدى Anthropic، واختبارات MAI Code 1.1 Flash لدى Microsoft، وQ2D-Web لدى Perplexity التي صممته، ونتائج Open d1 لدى Liquid AI، وزيادة معدل نقل الكتابات إلى 35 ضعفًا في اختبارات GitHub الداخلية. وتحذر OpenAI نفسها من أن النتائج غير المصاغة صياغة رسمية في مخطوطاتها البالغ عددها 722 قد تتضمن أخطاء، كما أن مكاسب السرعة في GPT-6 تأتي من تقييمات داخلية. تظل هذه القياسات مفيدة لتحديد موقع المنتجات بعضها من بعض؛ وستتيح التقييمات الخارجية، مثل ترتيب CursorBench، حيث يقيس مطور أدوات نموذجًا لشركة أخرى، التحقق منها بالمقارنة.
المصادر
- GPT-6 وواجهة المستخدم الذكية للجميع (OpenAI)
- الإعلان عن إتاحة GPT-6 للجميع (@OpenAI)
- بطاقة النظام لـGPT-6 Sol وGPT-6 Luna، تحديث أكتوبر
- GPT-6 ونماذج أخرى في ChatGPT
- ملاحظات إصدار ChatGPT
- رفع الملفات والمقاطع الصوتية إلى ChatGPT
- مساعدة المراهقين على التعلّم والتخطيط وتشكيل مستقبل الذكاء الاصطناعي (OpenAI)
- الإعلان عن Claude Haiku 5.5 (Anthropic)
- إطلاق Claude Haiku 5.5 (@claudeai)
- دليل الانتقال إلى Haiku 5.5
- Haiku 5.5 في Cursor (@cursor_ai)
- ترتيب CursorBench
- أرصدة API الشهرية لخطتي Max وTeam (دعم Claude)
- الإعلان عن رصيد API (@ClaudeDevs)
- RTX Spark وDGX Station لنظام Windows (مدونة NVIDIA)
- إتاحة النماذج المحلية والأدوات المعزولة في Windows وGitHub Copilot (Microsoft Command Line)
- اكتشف النماذج المحلية في GitHub Copilot CLI
- العزل المحلي لـGitHub Copilot متاح الآن للجميع
- الإصدار التجريبي من تطبيق Replit لسطح المكتب (@Replit)
- قائمة انتظار تطبيق Replit لسطح المكتب
- مشاركة تقدّم الذكاء الاصطناعي في الرياضيات (OpenAI)
- مستودع openai/math
- الإعلان عن النتائج الرياضية (@OpenAI)
- التضمينات متعددة الوسائط تتجاوز المتجه الواحد (Perplexity Research)
- pplx-embed-v2-late-9b على Hugging Face
- Claude Code 2.1.293
- Codex CLI 0.161.0
- التحكّم عن بُعد في الوكلاء المحليين (سجل تغييرات Cursor)
- سجل تغييرات Antigravity
- Warp Factories وMicrosoft Teams وAzure DevOps (مدونة Warp)
- مجموعات أدوات computer use وbrowser use في حزم SDK (@ClaudeDevs)
- توثيق مجموعات أدوات Claude SDK
- نشر نماذج Grok واستخدامها في Microsoft Foundry
- Open d1 (Liquid AI على Hugging Face)
- Bolmo في Nature (Ai2)
- توسّع Google نطاق SynthID Detector للمحتوى المُولَّد بالذكاء الاصطناعي
- يجب أن تتوسّع حماية الأسرار مع توسّع البرمجيات (GitHub)
- بناء بنية تحتية لـGit لتطوير البرمجيات على نطاق عمل الوكلاء (GitHub)
- مذكرة تفاهم مع ولاية هندية (@ElevenLabs)
- PivotOPD (NVIDIA Research)
- mPDLP في cuOpt (مدونة NVIDIA التقنية)
- الآلات التي تصنع الآلات (مدونة NVIDIA التقنية)
- سجل تغييرات ChatGPT وCodex، وChatGPT لنظام iOS 1.2026.272
- تتيح Radisson Hotel Group اكتشاف الفنادق داخل ChatGPT (OpenAI)
- كيف توسّع Jump Trading نطاق الأبحاث الكمية باستخدام ChatGPT (OpenAI)
- امتدادات إضافات ChatGPT (@OpenAIDevs)
- Every وClaude Managed Agents (@claudeai)
- Zed v1.24.1-pre
- الكثير والكثير من وكلاء Puck (Amp)
- Copilot CLI 1.0.93
- حدّث بيئة IDE لاستعادة ظهور نشاط الوكلاء في مقاييس استخدام Copilot
- Gemini CLI v0.65.0-nightly.20261007
- Transformers.js 4.3.1
- RL Environment Explorer (@adithya_s_k)
- مقارنة مباشرة لـSeb-9B (مدونة Hugging Face)
- Nemotron في IOI وIMO 2026 (مدونة Hugging Face)
- Instadocs: الذكاء الاصطناعي المنفلت (@netflix)
- Runway في ChatGPT (@runwayml)
- Face Swap (@LumaLabsAI)
- التحقّق من تغييرات مصانع الذكاء الاصطناعي باستخدام التوائم الرقمية ووكلاء الذكاء الاصطناعي (مدونة NVIDIA التقنية)
- تحليل أسرع للصور العلمية باستخدام NVIDIA cuPhoton
- Cosmos وSynthID (@NVIDIAAI)
- حزمة SDK بلغة TypeScript من SpaceXAI 0.2.3
- RAG مقابل LLM (Perplexity)